
Benutzerhandbuch
MiniMax H3 Max Bild-zu-Video-Prompts: Vollständige, direkt kopierbare Rezepte und echte Ergebnisse
Drei direkt kopierbare MiniMax H3 Max Bild-zu-Video-Prompts, ausgeführt auf hiapi, jeweils mit dem exakten Eingangsbild und dem echten Clip, den wir damit gerendert haben – eine filmische Enthüllung, ein atmosphärischer Push-in und eine Verwandlung vom ersten zum letzten Frame, plus Request-Struktur und Preis pro Sekunde.
MiniMax H3 Max ist ein Videomodell, das ein Standbild in einen Kurzfilm animiert und dabei eine passende Umgebungs-Tonspur erzeugt. Du gibst ihm ein Endbild, beschreibst Kamerabewegung, Dynamik und gewünschten Klang, und es rendert eine 5–15-sekündige Einstellung, die auf diesem Frame endet. Optional kannst du auch ein Startbild angeben, und das Modell interpoliert eine deterministische Verwandlung zwischen Start und Ende.
Dieser Leitfaden liefert drei direkt kopierbare Prompt-Rezepte für den Bild-zu-Video-Weg, jeweils mit dem exakten Eingangsbild, dem vollständigen Prompt und dem echten Clip, den wir damit gerendert haben – hier ist nichts simuliert. Jeder Prompt und jedes Bild unten wurde von uns auf hiapi verfasst und generiert; du kannst die Struktur direkt übernehmen.
So funktioniert MiniMax H3 Max Bild-zu-Video tatsächlich
Es ist ein asynchroner Task-Aufruf. Du sendest einen POST-Request an https://api.hiapi.ai/v1/tasks, pollst die zurückgegebene taskId, bis der Status success lautet, und lädst dann das Video von der Ausgabe-URL herunter (der Link ist zeitlich begrenzt, speichere die Datei also sofort).
Der verwirrende Punkt: Im Bild-zu-Video-Weg ist last_frame_image ein Pflichtfeld – es ist die Einstellung, auf der der Clip endet. first_frame_image ist optional, wenn du den Anfang bis zum Ende vollständig kontrollieren willst. Bevor du Prompts schreibst, lohnt es sich, ein paar Regeln zu kennen:
- Das Frame-Bild bestimmt das Seitenverhältnis. Wenn du ein Frame-Bild übergibst, sende nicht zusätzlich
aspect_ratio– die API lehnt beides zusammen ab. Schneide das Eingangsbild auf die gewünschte Videoform zu. resolutionist wahlweise480P,768Poder1080P.durationist eine ganzzahlige Sekundenzahl zwischen 5 und 15.- Audio wird durch den Prompt gesteuert. Beschreibe die Umgebungsgeräusche („soft rain on glass, distant city hum“), und das Modell fügt eine passende Tonspur hinzu; wenn du keinen Dialog willst, schreibe „no speech“.
Ein minimaler Request-Body sieht so aus:
{
  "model": "minimax-h3-max/image-to-video",
  "input": {
    "prompt": "Slow push-in toward the sign; neon reflections ripple on wet pavement. Ambient rain, no speech.",
    "last_frame_image": "https://your-cdn.example.com/ending-frame.jpg",
    "resolution": "480P",
    "duration": 5
  }
}
Wenn du auch die Eröffnungseinstellung kontrollieren willst, füge "first_frame_image": "https://.../start.jpg" hinzu (Rezept 3). Der Rest dieses Artikels dreht sich darum, wie man den prompt schreibt, damit Bewegung, Komposition und Klang wirklich lesbar werden.
Rezept 1 — Filmische Enthüllung aus einem einzigen Key-Visual-Frame
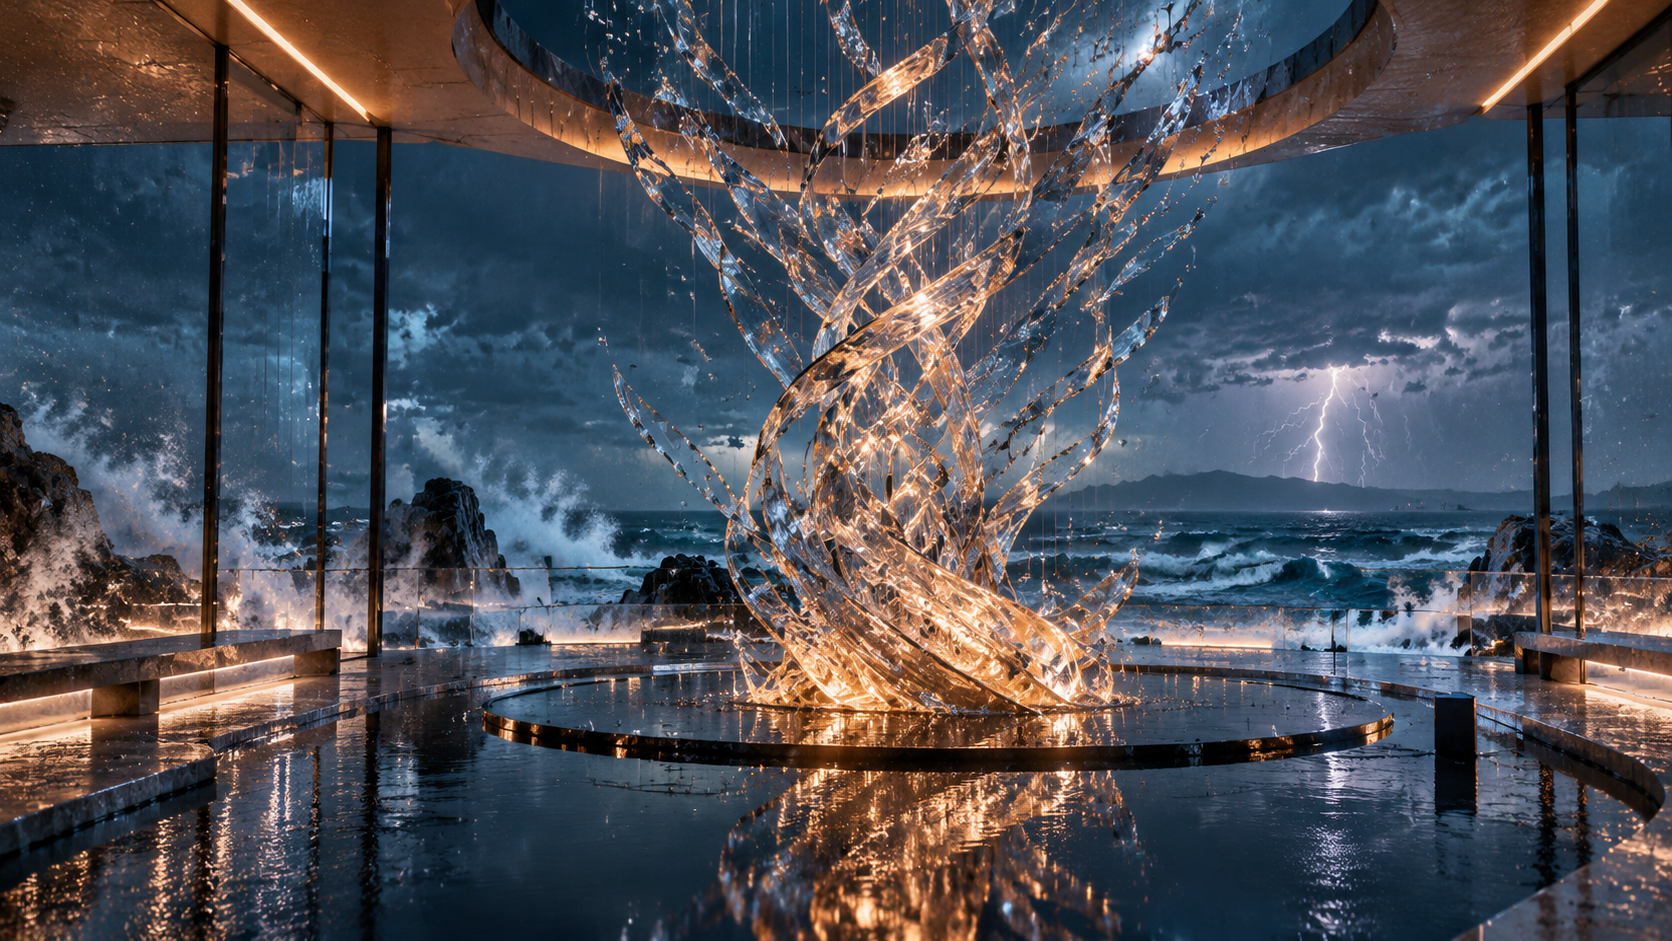
Verwende dieses Rezept, wenn du eine „Killer-Einstellung“ hast und die Kamera dorthin bringen willst. Du gibst nur den End-Frame an und lässt den Prompt die Bewegung dorthin choreografieren.
Eingangsbild (als last_frame_image):
Gerenderter Clip (768P, 5 Sekunden):
Prompt (direkt kopierbar):
Beginne tief, nur wenige Zentimeter über einem spiegelglatten, pechschwarzen Wasserbecken, gleite dann nach vorn und schwenke nach oben in eine langsame, weite orbitale Enthüllung: zur blauen Stunde schwebt ein gläserner Pavillon über einer stürmischen See. Eine kinetische Kristallskulptur entfaltet sich in einer sanften Spirale und bricht warmes bernsteinfarbenes Licht durch kalten türkisfarbenen Nebel; Regen zieht Streifen über das Glas, ferner Blitz flackert am Horizont. Physikalisch korrekte Reflexionen und Brechungen, volumetrisches Licht, kontrollierte natürliche Bewegung, stabile Geometrie, nahtlose zeitliche Konsistenz, hochwertige kommerzielle Anmutung, subtiles Filmkorn, keine Menschen, keine Logos, kein Text, keine Schnitte, kein Flackern. Umgebungsklang: tiefes Meeresrauschen, leises Ticken von Regen auf Glas, feines Resonieren des Kristalls, kein Dialog.
Warum es funktioniert:
- Eine durchgehende Einstellungsbeschreibung. „Beginne tief … gleite nach vorn … schwenke nach oben in eine langsame, weite orbitale Enthüllung“ gibt dem Modell einen einzigen, eindeutigen Pfad statt konkurrierender Bewegungen.
- Der End-Frame ist der Anker, der Prompt beschreibt also nur die Reise dorthin – die Skulptur kann sich „entfalten“, und genau das erzeugt sichtbare Bewegung zwischen dem vom Modell erfundenen Ausgangszustand und dem Frame, den du lieferst.
- Eine knappe Negativliste („keine Schnitte, kein Flackern, kein Text“) verhindert, dass die luxuriöse 768P-Anmutung zu einem Montage-Flackern verkommt.
- Gerendert in 768P, weil es die Key-Visual-Einstellung ist; das Titelbild dieses Artikels ist ein direkt daraus entnommener Frame.
Rezept 2 — Atmosphärischer Push-in mit Umgebungsklang
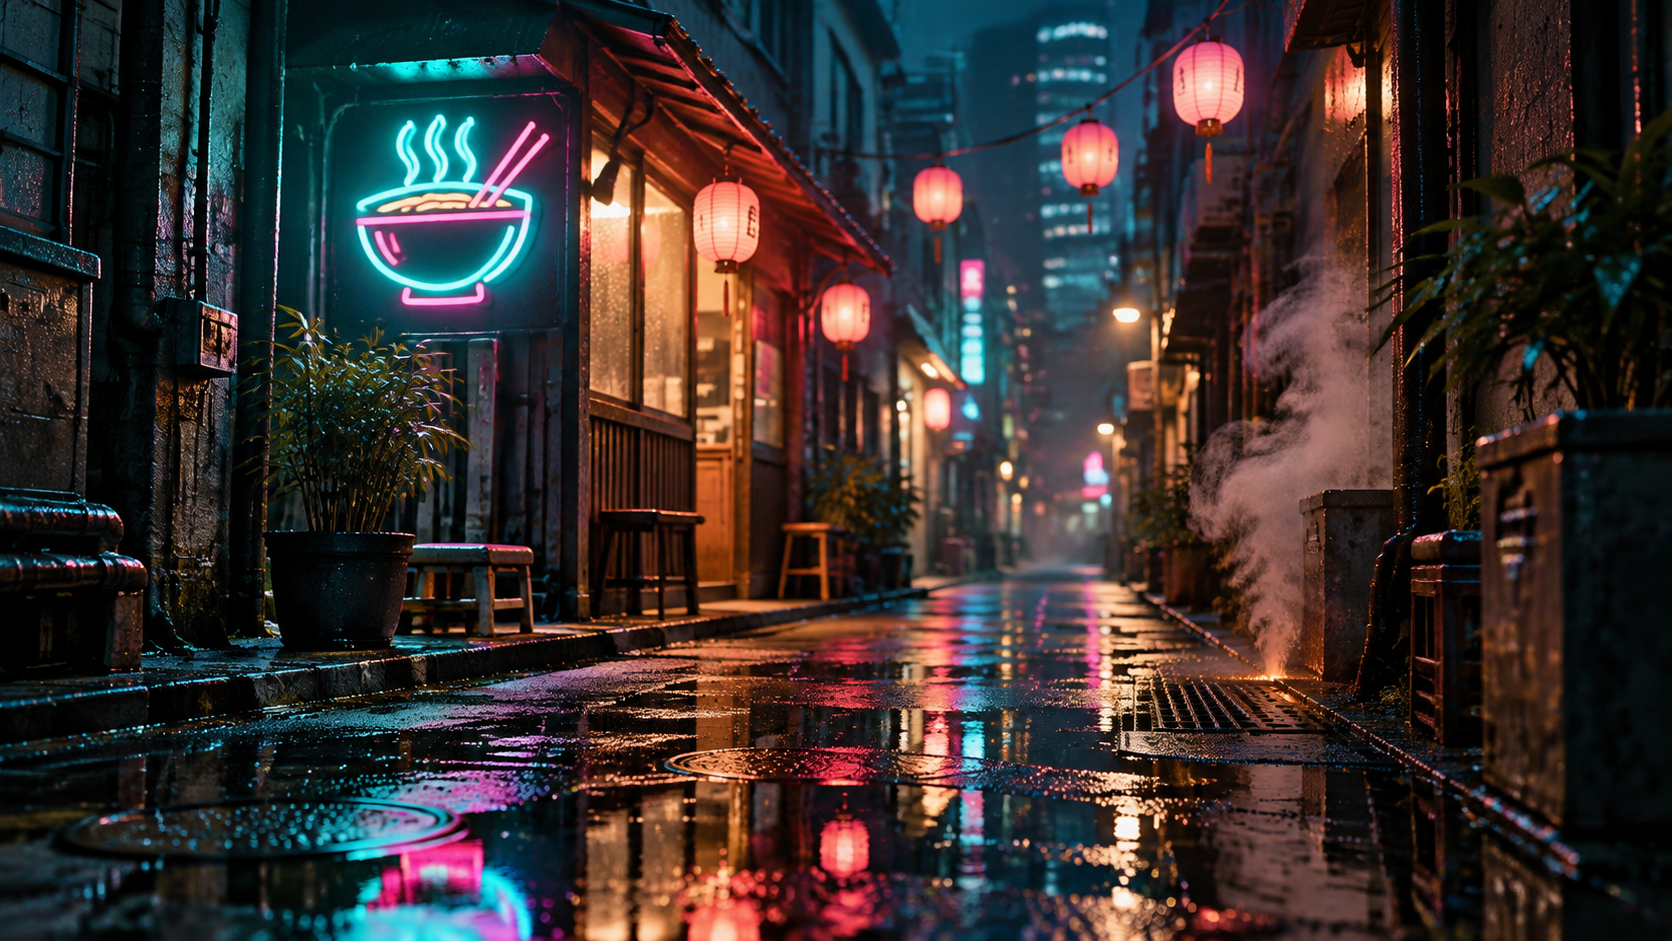
Das Arbeitspferd für den Alltag: eine langsame Dolly-Fahrt, die eine statische Szene zum Leben erweckt, wobei die Tonspur genauso wichtig ist wie die Bewegung. Auch hier reicht ein End-Frame.
Eingangsbild (als last_frame_image):
Gerenderter Clip (480P, 5 Sekunden):
Prompt (direkt kopierbar):
Eine langsame, stetige Dolly-Fahrt bei Mitternacht vorwärts durch eine regennasse Neongasse, Pfützen unter den Füßen kräuseln sich, die Kamera schwebt allmählich auf ein ramen-laden-Schild in türkisfarbenem und magentafarbenem Leuchten zu. Dampf steigt aus Straßenschächten, Papierlaternen schwanken leicht, Neonreflexionen schimmern auf dem nassen Pflaster. Filmisches Teal-and-Orange-Grading, geringe Schärfentiefe, leichter Dunst, realistische 35-mm-Anmutung, kontrollierte Bewegung, stabile Geometrie, keine Menschen, kein lesbarer Text, keine Schnitte. Umgebungsklang: stetiger Regen, fernes Stadtbrummen, leises Zischen von Dampf, kein Dialog.
Warum es funktioniert:
- Eine langsame Bewegung + viele kleine Bewegungen. Die Kamera tut nur eine Sache (vorwärts fahren), während sich kräuselnde Pfützen, aufsteigender Dampf und schwankende Laternen Mikrobewegung liefern, die Realismus erzeugt, ohne das Bild abdriften zu lassen.
- Die Audiobeschreibung leistet echte Arbeit. „stetiger Regen, fernes Stadtbrummen, leises Zischen von Dampf“ ist genau der Punkt, der eine nasse Straße zu einem Ort macht. Das ist das größte Upgrade gegenüber Bildmodellen.
- 480P ist beim Iterieren der richtige Standardwert – bei $0.072/Sekunde kostet ein 5-Sekunden-Test etwa 36 Cent, sodass du die Formulierung günstig verfeinern kannst, bevor du dich für 768P oder 1080P für das finale Ergebnis entscheidest.
Rezept 3 — Interpolation von erstem und letztem Frame (die Signatur-Kontrolle)
Genau hier unterscheidet sich H3 Max von Modellen im Stil von „lass mein Foto lebendig werden“: Gib ihm sowohl Start- als auch End-Frame, und es rendert eine kontrollierte Verwandlung zwischen beiden. Ideal für Vorher-Nachher-Transformationen, die einen exakten Anfang und ein exaktes Ende brauchen.
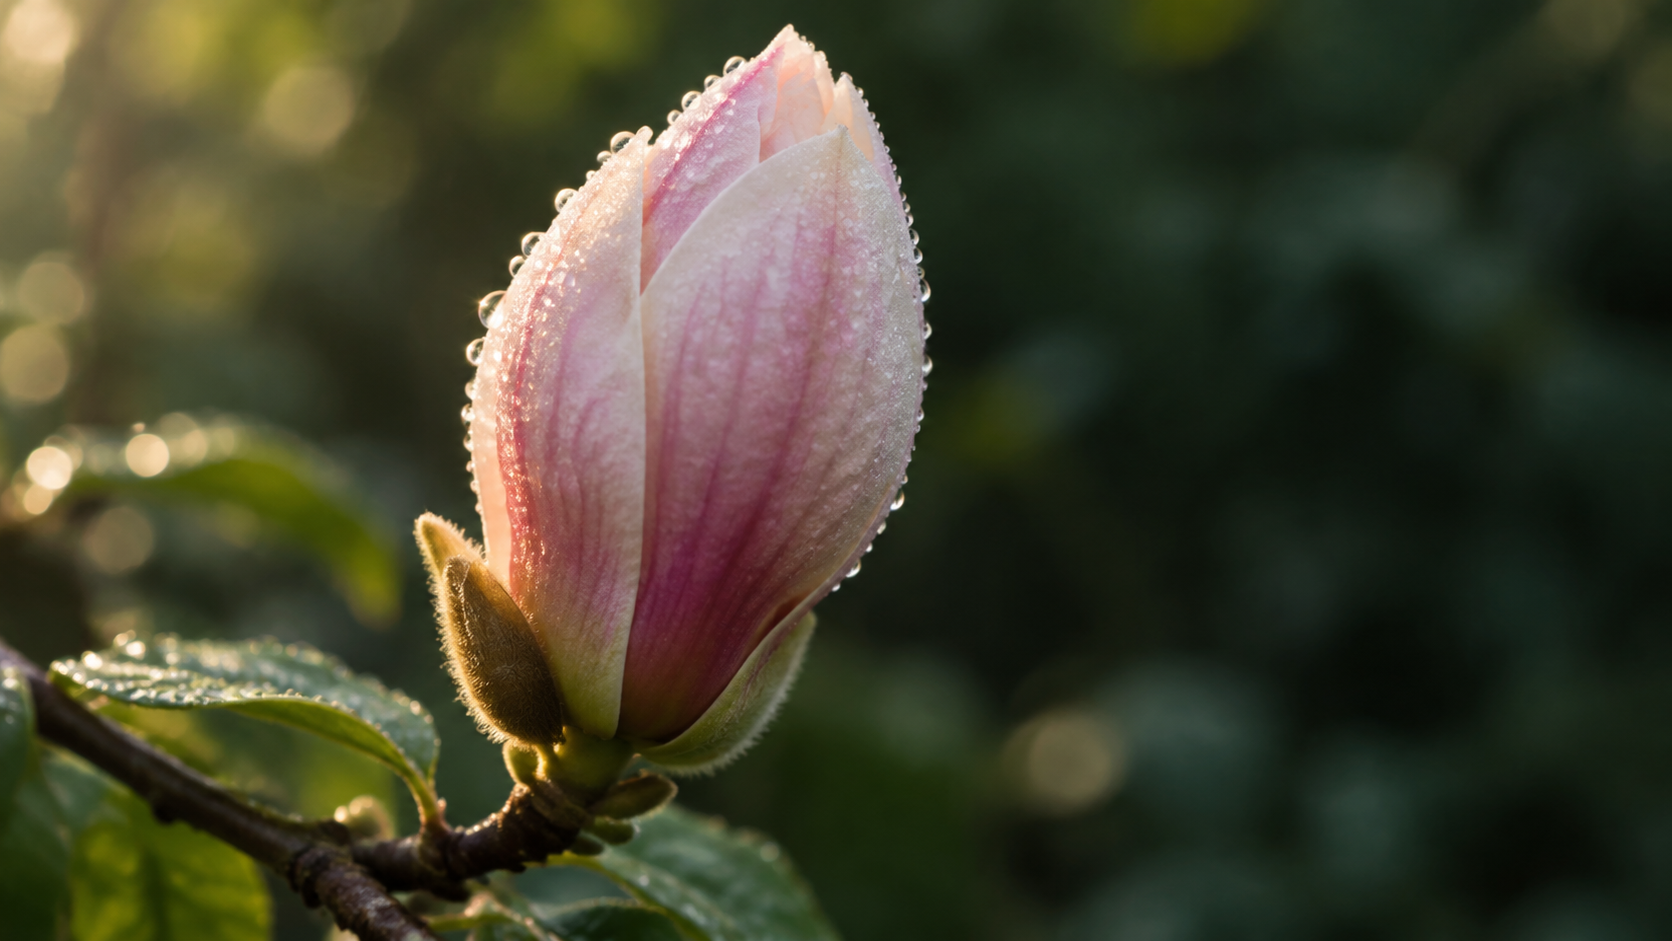
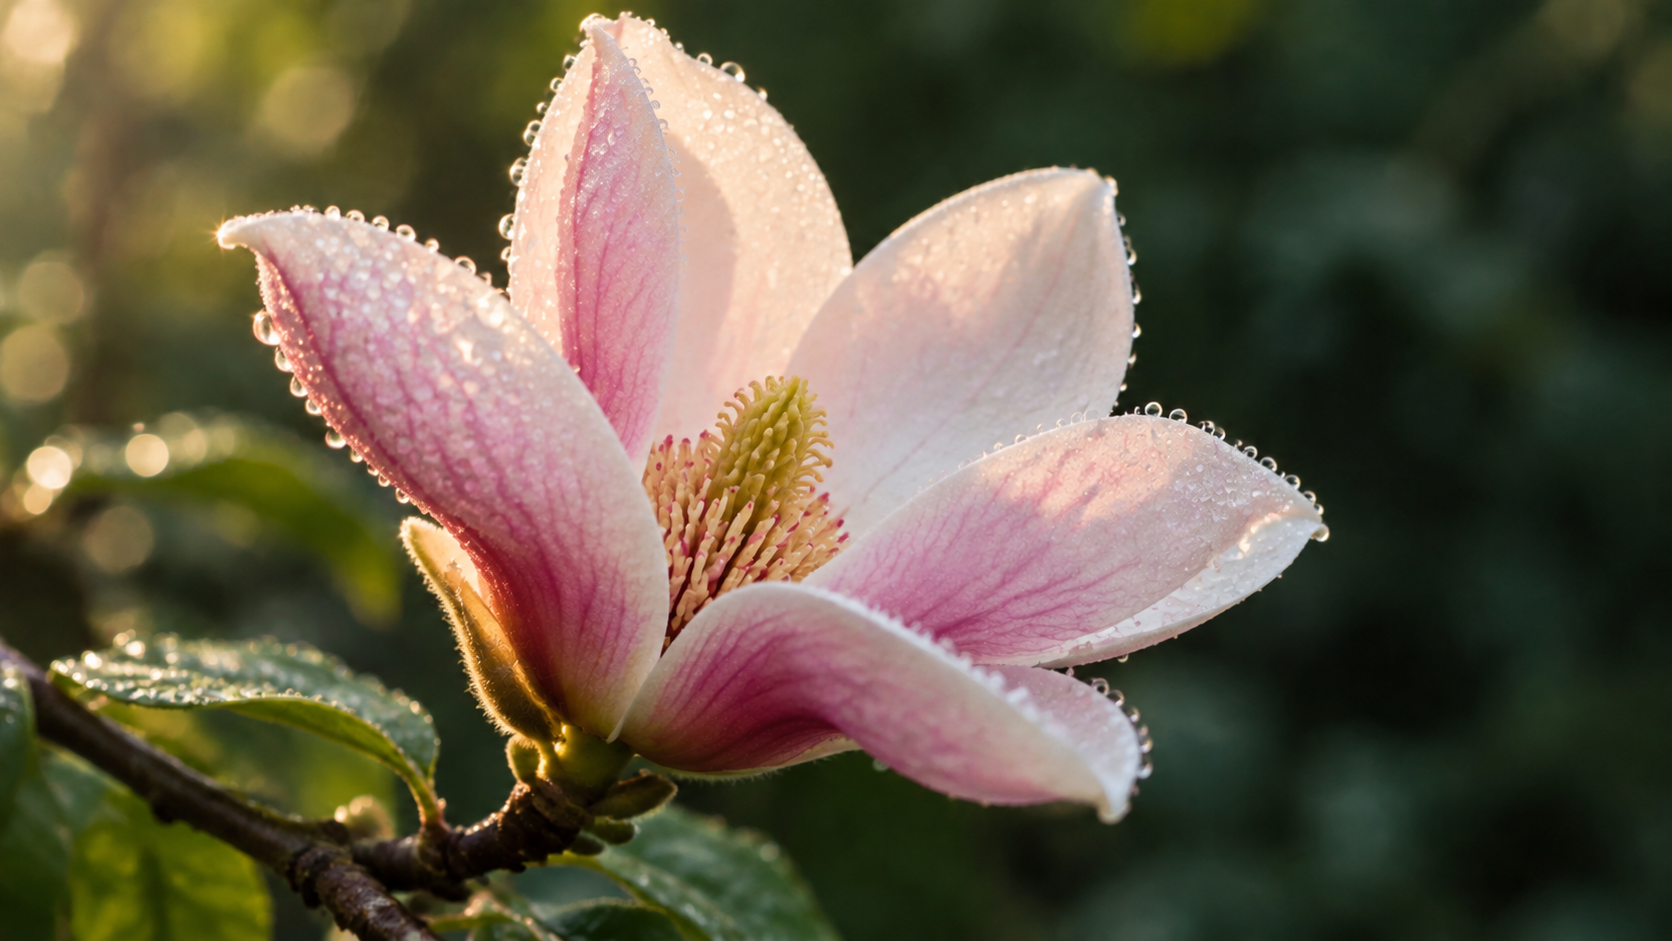
Wir haben das Eröffnungsframe generiert und dann dasselbe Frame in seinen „danach“-Zustand bearbeitet, sodass Komposition, Licht und Hintergrund exakt gleich bleiben – nur das Motiv verändert sich.
Erstes Frame (first_frame_image) → letztes Frame (last_frame_image):
Gerenderter Clip (480P, 5 Sekunden):
Prompt (direkt kopierbar):
Makro-Zeitraffer einer Magnolie, die im Morgengrauen erblüht: taufrische Blütenblätter entfalten sich langsam aus einer straffen Knospe zu einer vollständig geöffneten Blüte und geben ein helles Zentrum aus Staubgefäßen frei, weiches Morgenlicht als Konturlicht wärmt die Szene, der Zweig wiegt sich im sanften Wind kaum merklich. Komposition und Hintergrund bleiben durchgehend identisch, realistische botanische Details, gleichmäßige kontinuierliche Bewegung, stabiler Fokus, keine Menschen, kein Text, keine Schnitte. Umgebungsklang: sanftes Vogelgezwitscher im Morgengrauen, Wind in den Blättern, kein Dialog.
Warum es funktioniert:
- Zwei Frames = deterministische Endpunkte. Du musst nicht darauf hoffen, dass das Modell irgendwo Plausibles landet; du hast klar gesagt, wo es beginnt und wo es aufhört. Der Prompt beschreibt nur noch, wie es dazwischen voranschreitet („langsam entfalten … gleichmäßige kontinuierliche Bewegung“).
- Konsistente Frames. Weil unser End-Frame eine Bearbeitung des Erst-Frames ist (gleicher Zweig, Winkel, Licht), sieht die Interpolation aus wie eine Blüte, die aufblüht, und nicht wie ein Schnitt zwischen zwei Fotos. Nicht zusammenpassende Frames erzeugen harte Verzerrungen.
- „Komposition und Hintergrund bleiben durchgehend identisch“ sagt dem Modell, dass sich einzig die Blüte ändern darf – das verhindert, dass die Kamera wandert.
Feinabstimmungs-Hinweise
- Schreibe eine Einstellung, keine Bildunterschrift. Schreibe Kamerabewegung, Motivbewegung, Licht und Klang in dieser Reihenfolge. Eine Bildunterschrift („eine blühende Blume“) gibt dem Modell nichts Animierbares.
- Kalkuliere nach Auflösung und iteriere bei 480P. Die Prompt-Formulierung muss selten über 480P hinaus bewertet werden; wenn sie sitzt, rendere das finale Ergebnis mit 768P oder 1080P neu.
- Halte die Dauer beim Anpassen bei 5 Sekunden. Längere Clips kosten linear mehr und geben der Bewegung mehr Raum zum Abdriften. Erweitere erst auf 10–15 Sekunden, wenn Bewegung und Audio korrekt klingen.
- Kämpfe nicht gegen das Seitenverhältnis. Schneide das Eingangsbild vor dem Upload auf 16:9, 9:16 oder 1:1 zu; der Clip übernimmt diese Form, und
aspect_ratiozusammen mit einem Frame-Bild zu senden, erzeugt einen Fehler. - Negativ-Prompts sind wichtig für die Feinheit. „keine Schnitte, kein Flackern, kein Text, keine Menschen“ entfernt zuverlässig Artefakte, die KI-Video wie KI aussehen lassen.
Preis
MiniMax H3 Max Bild-zu-Video wird nach den angefragten Videosekunden abgerechnet, gestaffelt nach Auflösung (Stand 2026-10):
| Auflösung | Preis pro Sekunde | 5-Sekunden-Clip |
|---|---|---|
| 480P | $0.072 | $0.36 |
| 768P | $0.115 | $0.575 |
| 1080P | $0.229 | $1.145 |
Die drei Clips in diesem Leitfaden – einer in 768P und zwei in 480P, alle 5 Sekunden – kosten zusammen etwa $1.30 an Videokosten. Prüfe die tagesaktuellen Zahlen auf der hiapi-Preisseite, bevor du ein Budget für Stapelverarbeitung planst; der Sekundentarif ist die Zahl, die sich ändert.
Häufige Fragen
Muss ich beide Frames angeben?
Nein. Im Bild-zu-Video-Weg ist last_frame_image Pflicht, first_frame_image optional. Nur mit dem End-Frame (Rezepte 1 und 2) eignet es sich für „diese Einstellung erreichen“, während man für eine kontrollierte Verwandlung von Anfang bis Ende (Rezept 3) zwei Frames verwendet.
Welche Auflösungen und Dauern werden unterstützt?
resolution ist 480P, 768P oder 1080P; duration ist eine ganzzahlige Sekundenzahl zwischen 5 und 15.
Erzeugt es Ton? Ja – beschreibe die Umgebungsgeräusche im Prompt, und das Modell fügt eine passende Tonspur hinzu. Mit „no speech“ bleibt es dialogfrei. Die drei Clips hier bringen alle ihre eigene Umgebungs-Tonspur mit.
Wie stelle ich das Seitenverhältnis ein?
Es wird durch das Eingangsbild bestimmt. Schneide das Frame auf die gewünschte Form zu; sende nicht gleichzeitig das Feld aspect_ratio und ein Frame-Bild.
Ich möchte nur Text-zu-Video, ohne Eingangsbild. Verwende stattdessen den MiniMax H3 Max Text-zu-Video-Weg – dieselbe Prompt-Disziplin, kein Frame nötig. Wenn du H3 Max mit anderen Video-APIs vergleichst, erklärt unser Vergleich Seedance 2.5 vs. 2.0, wie man sekundenbasiert abgerechnete Videomodelle auswählt.
Jetzt generieren
Nimm ein Key-Visual-Frame, schreibe es als Einstellung mit Kamerabewegung und Audiobeschreibung und sende es an die MiniMax H3 Max Bild-zu-Video-API. Beginne mit 480P, um die Formulierung zu verfeinern, und rendere dein finales Ergebnis dann in höherer Auflösung neu. Vollständige Details zu Request und Polling findest du in der hiapi-Dokumentation.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte