
Guida all'uso
Prompt image-to-video di MiniMax H3 Max: soluzioni complete pronte da copiare e output reali
Tre prompt image-to-video di MiniMax H3 Max pronti da copiare, eseguiti su hiapi, ciascuno con il frame di input esatto e la clip reale che abbiamo renderizzato con esso — una rivelazione cinematografica, un push-in atmosferico e una trasformazione dal primo all'ultimo frame, oltre alla struttura della richiesta e al prezzo al secondo.
MiniMax H3 Max è un modello video che anima un'immagine statica in una breve clip e genera in sincrono una traccia audio ambientale. Gli fornisci un frame finale, descrivi il movimento di camera, la dinamica e il suono desiderato, e renderizza un'inquadratura di 5–15 secondi che termina su quel frame. Puoi anche fornire opzionalmente un frame iniziale, e il modello interpolerà tra inizio e fine una trasformazione deterministica.
Questa guida presenta tre soluzioni di prompt pronte da copiare per il percorso image-to-video, ciascuna con il frame di input esatto, il prompt completo e la clip reale che abbiamo renderizzato con esso — qui non c'è nulla di simulato. Ogni prompt e immagine qui sotto è stata scritta e generata da noi su hiapi, e puoi riutilizzarne direttamente la struttura.
Come funziona davvero il image-to-video di MiniMax H3 Max
È una chiamata a un task asincrono. Invii un POST a https://api.hiapi.ai/v1/tasks, interroghi il taskId restituito finché lo stato non diventa success, poi scarichi il video dall'URL di output (il link ha una scadenza, quindi salva subito il file).
La parte che confonde di più: nel percorso image-to-video, last_frame_image è un campo obbligatorio — è l'inquadratura su cui termina la clip. first_frame_image è opzionale, quando vuoi controllare completamente l'inizio e la fine puoi fissare il frame iniziale. Prima di scrivere il prompt, ci sono alcune regole da conoscere:
- L'immagine del frame determina le proporzioni. Quando passi un'immagine frame, non inviare anche
aspect_ratio— l'API rifiuta entrambi contemporaneamente. Ritaglia l'immagine di input nella forma video che desideri. resolutionpuò essere480P,768Po1080P.durationè un numero intero di secondi tra 5 e 15.- L'audio è guidato dal prompt. Descrivi i suoni ambientali ("soft rain on glass, distant city hum") e il modello aggiungerà una traccia audio corrispondente; se non vuoi dialoghi, scrivi "no speech".
Un corpo di richiesta minimo è il seguente:
{
  "model": "minimax-h3-max/image-to-video",
  "input": {
    "prompt": "Slow push-in toward the sign; neon reflections ripple on wet pavement. Ambient rain, no speech.",
    "last_frame_image": "https://your-cdn.example.com/ending-frame.jpg",
    "resolution": "480P",
    "duration": 5
  }
}
Quando vuoi controllare anche l'inquadratura di apertura, aggiungi "first_frame_image": "https://.../start.jpg" (soluzione 3). Tutto il resto qui sotto riguarda come scrivere il prompt affinché movimento, composizione e suono risultino davvero leggibili.
Soluzione 1 — Rivelazione cinematografica da un singolo frame hero
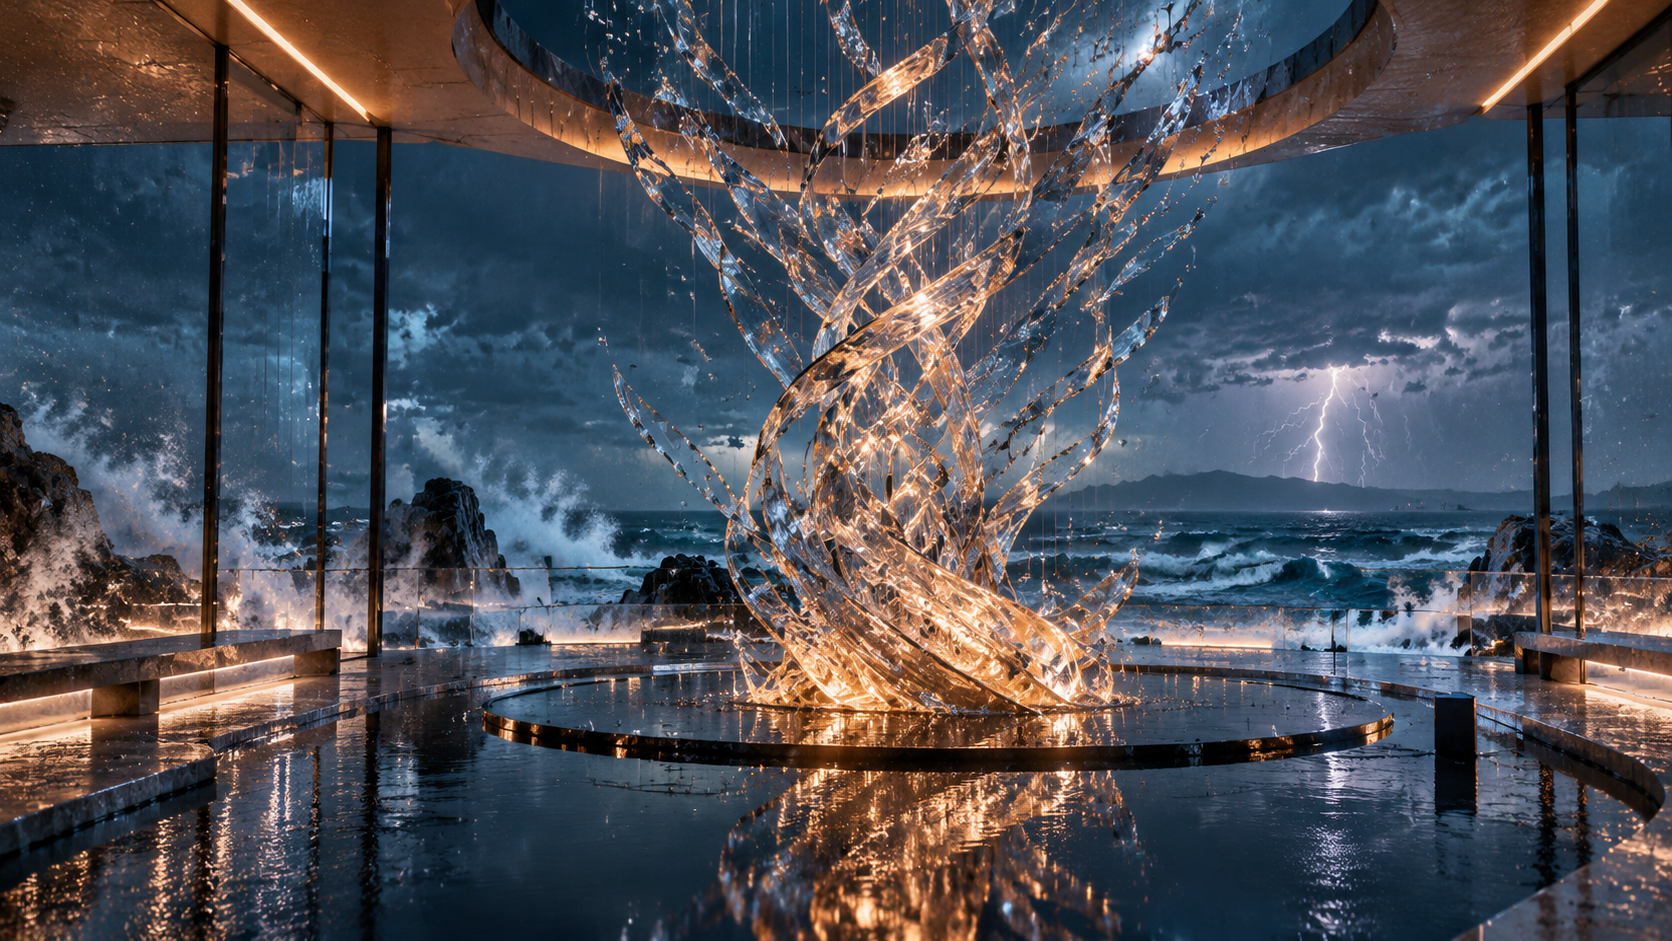
Usa questa soluzione quando hai un'immagine "da copertina" e vuoi che la camera arrivi fino ad essa. Fornisci solo il frame finale e lascia che il prompt coreografi il movimento che vi conduce.
Frame di input (come last_frame_image):
Clip renderizzata (768P, 5 secondi):
Prompt (pronto da copiare):
Parti dal basso, a pochi centimetri sopra una piscina d'acqua nera come uno specchio, poi scivola in avanti e inclinati verso l'alto in una lenta e ampia rivelazione orbitale: ora blu, un padiglione di vetro sospeso su un mare in tempesta. Una scultura di cristallo dinamica si apre in una spirale dolce, rifrangendo una calda luce ambrata attraverso una fredda nebbia ciano; la pioggia lascia strisce sul vetro, lontani lampi balenano all'orizzonte. Riflessi e rifrazioni fisicamente accurati, luce volumetrica, movimento naturale controllato, geometria stabile, coerenza temporale senza cuciture, finitura commerciale di alto livello, grana sottile della pellicola, nessuna persona, nessun logo, nessun testo, nessun taglio, nessuno sfarfallio. Audio ambientale: basso rombo del mare, pioggia che picchietta sul vetro, sottile risonanza del cristallo, nessun dialogo.
Perché funziona:
- Una descrizione continua del movimento di camera. "Parti dal basso… scivola in avanti… inclinati verso l'alto in una lenta e ampia rivelazione orbitale" dà al modello un percorso unico e chiaro, invece di movimenti in competizione.
- Il frame finale è l'ancora, quindi il prompt deve descrivere solo il viaggio verso di esso — la scultura può "aprirsi", ed è proprio questo a generare movimento visibile tra lo stato iniziale inventato dal modello e il frame che hai fornito.
- Una lista negativa compatta ("nessun taglio, nessuno sfarfallio, nessun testo") impedisce che la finitura lussuosa a 768P degeneri in un montaggio.
- Renderizzato a 768P, perché è l'inquadratura hero; la copertina di questo articolo è un frame estratto direttamente da essa.
Soluzione 2 — Push-in atmosferico con audio ambientale
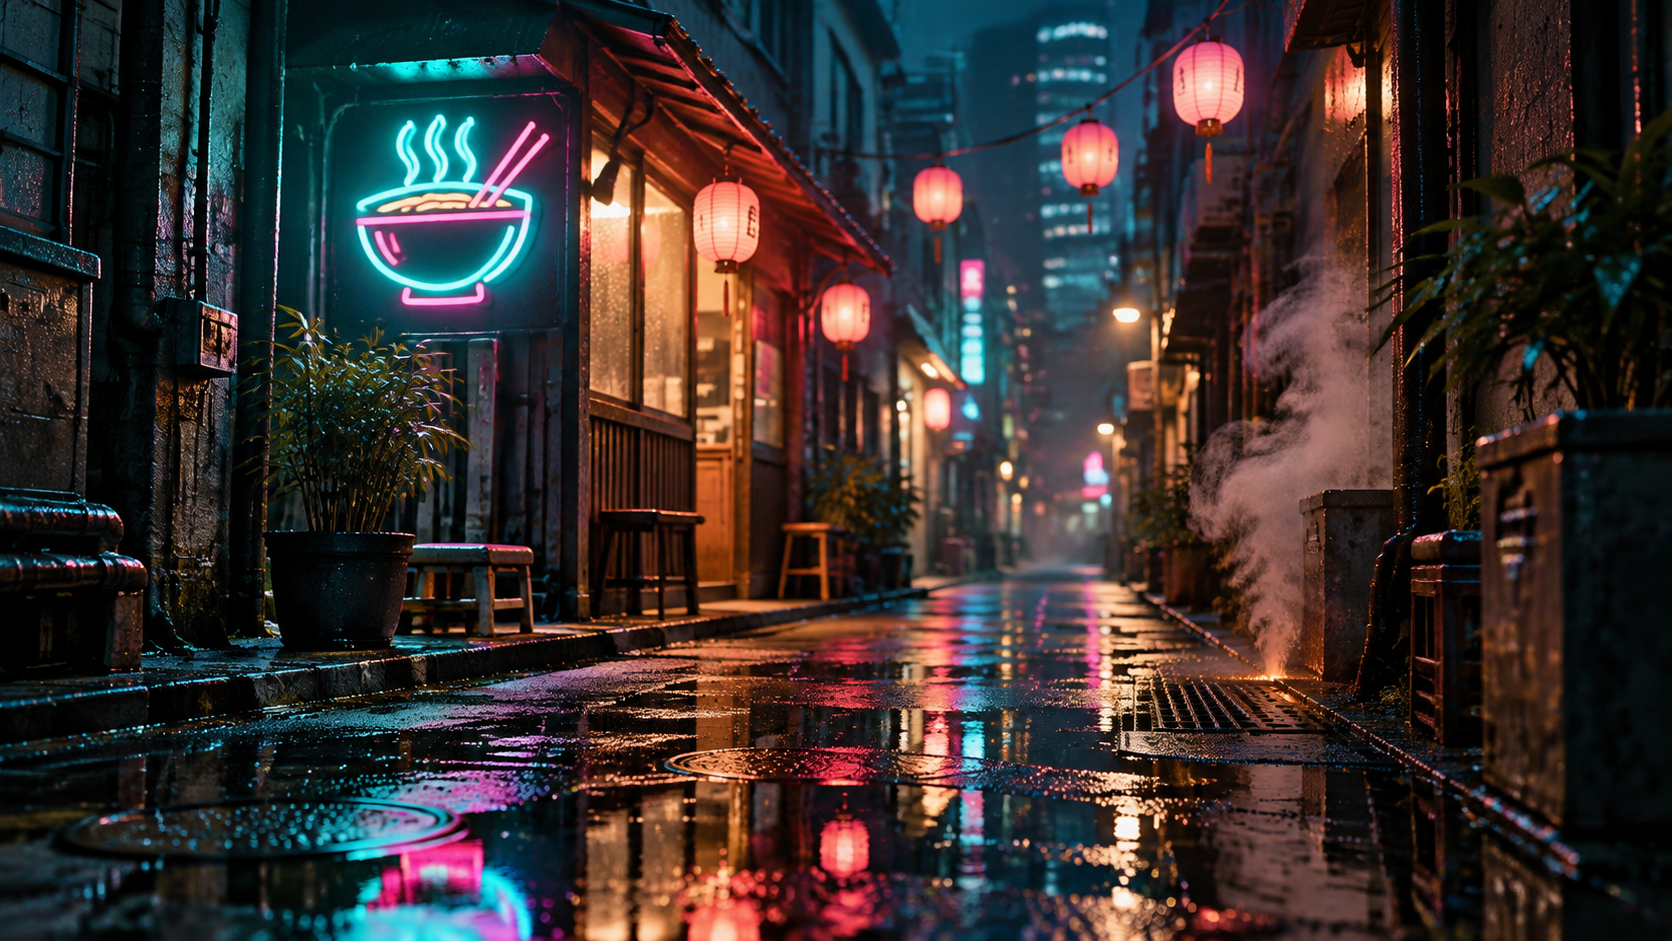
La soluzione di uso quotidiano: un lento movimento di carrello che dà vita a una scena statica, dove la traccia audio conta quanto il movimento. Anche qui serve solo un frame finale.
Frame di input (come last_frame_image):
Clip renderizzata (480P, 5 secondi):
Prompt (pronto da copiare):
Mezzanotte, un lento e costante movimento di carrello avanza lungo un vicolo al neon intriso di pioggia, le pozzanghere sotto i piedi increspano, la camera scivola lentamente verso un'insegna di un negozio di ramen che emette una luce turchese e magenta. Il vapore sale dai condotti di aerazione sul marciapiede, le lanterne di carta ondeggiano debolmente, i riflessi al neon brillano sull'asfalto bagnato. Color grading cinematografico teal-and-orange, profondità di campo ridotta, leggera foschia, texture realistica da 35mm, movimento controllato, geometria stabile, nessuna persona, nessun testo leggibile, nessun taglio. Audio ambientale: pioggia costante, lontano brusio urbano, debole sibilo di vapore, nessun dialogo.
Perché funziona:
- Un movimento lento + molti micro-movimenti. La camera fa una sola cosa (avanza), mentre le pozzanghere che si increspano, il vapore che sale e le lanterne che ondeggiano forniscono micro-movimento, creando realismo senza far vagare l'inquadratura.
- La descrizione audio qui fa davvero la differenza. "Pioggia costante, lontano brusio urbano, debole sibilo di vapore" è proprio ciò che trasforma la strada bagnata in un luogo. È il più grande salto di qualità rispetto ai modelli di immagini.
- In fase di iterazione, 480P è il default giusto — a $0,072/secondo, un test da 5 secondi costa circa 36 centesimi, quindi puoi ritoccare la formulazione a basso costo prima di decidere di produrre a 768P o 1080P.
Soluzione 3 — Interpolazione primo + ultimo frame (controllo deterministico)
È proprio qui che H3 Max si distingue dai modelli "fai animare la mia foto": forniscigli insieme il primo e l'ultimo frame, e renderizzerà tra i due una trasformazione controllata. Perfetto per trasformazioni prima/dopo che richiedono un inizio preciso e una fine precisa.
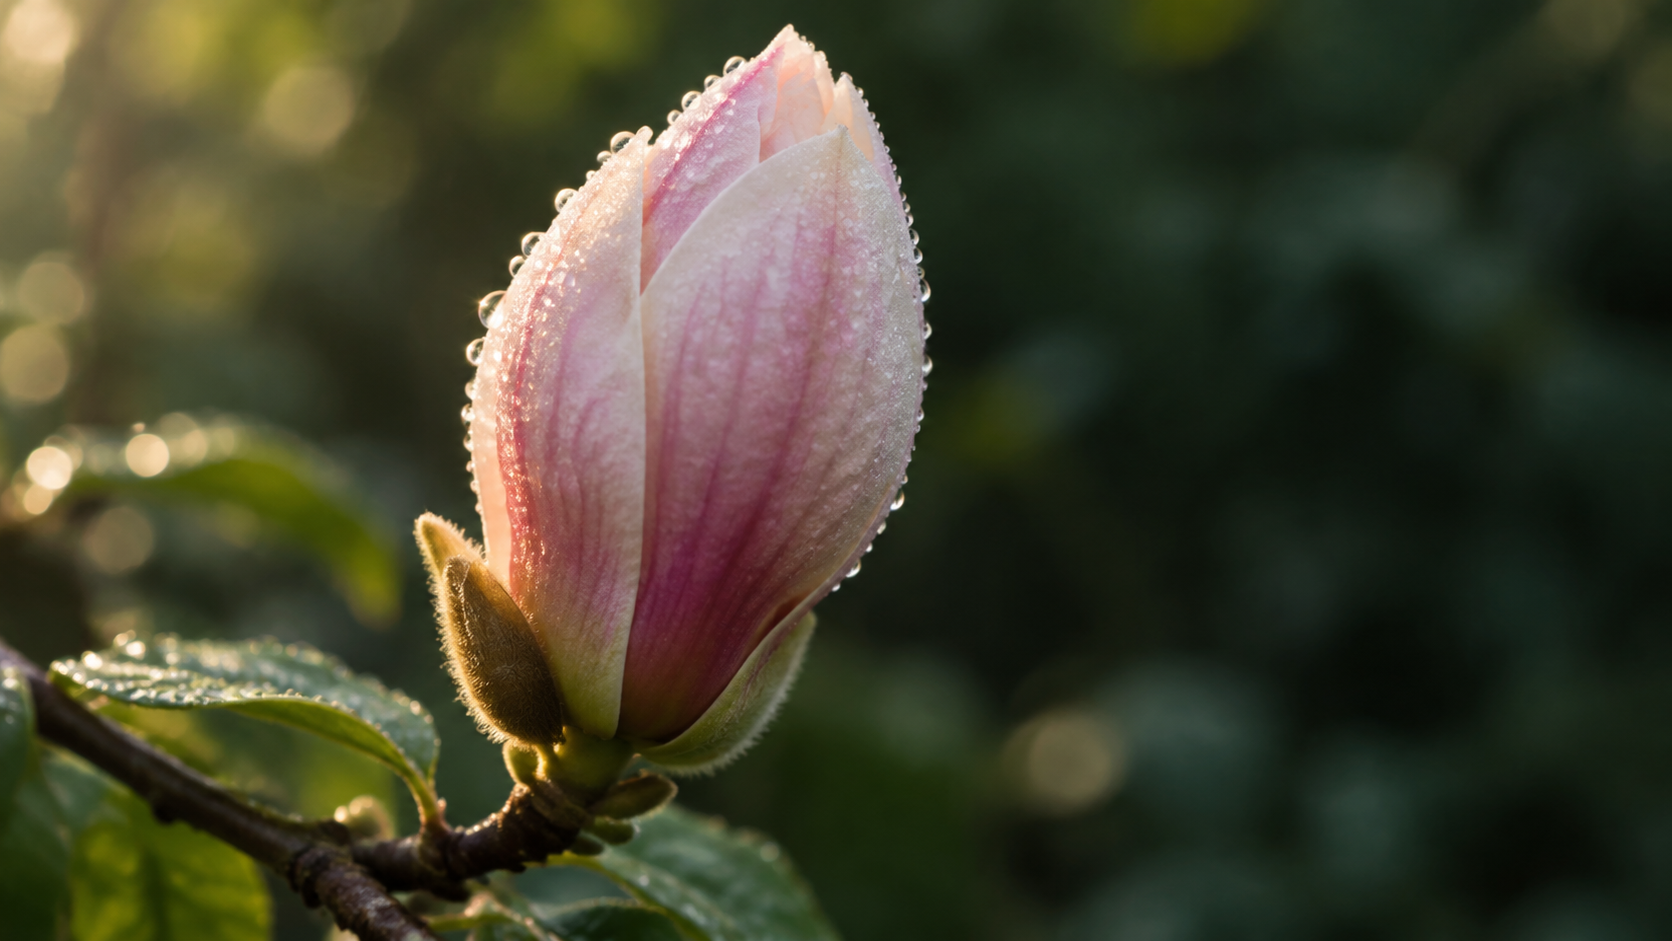
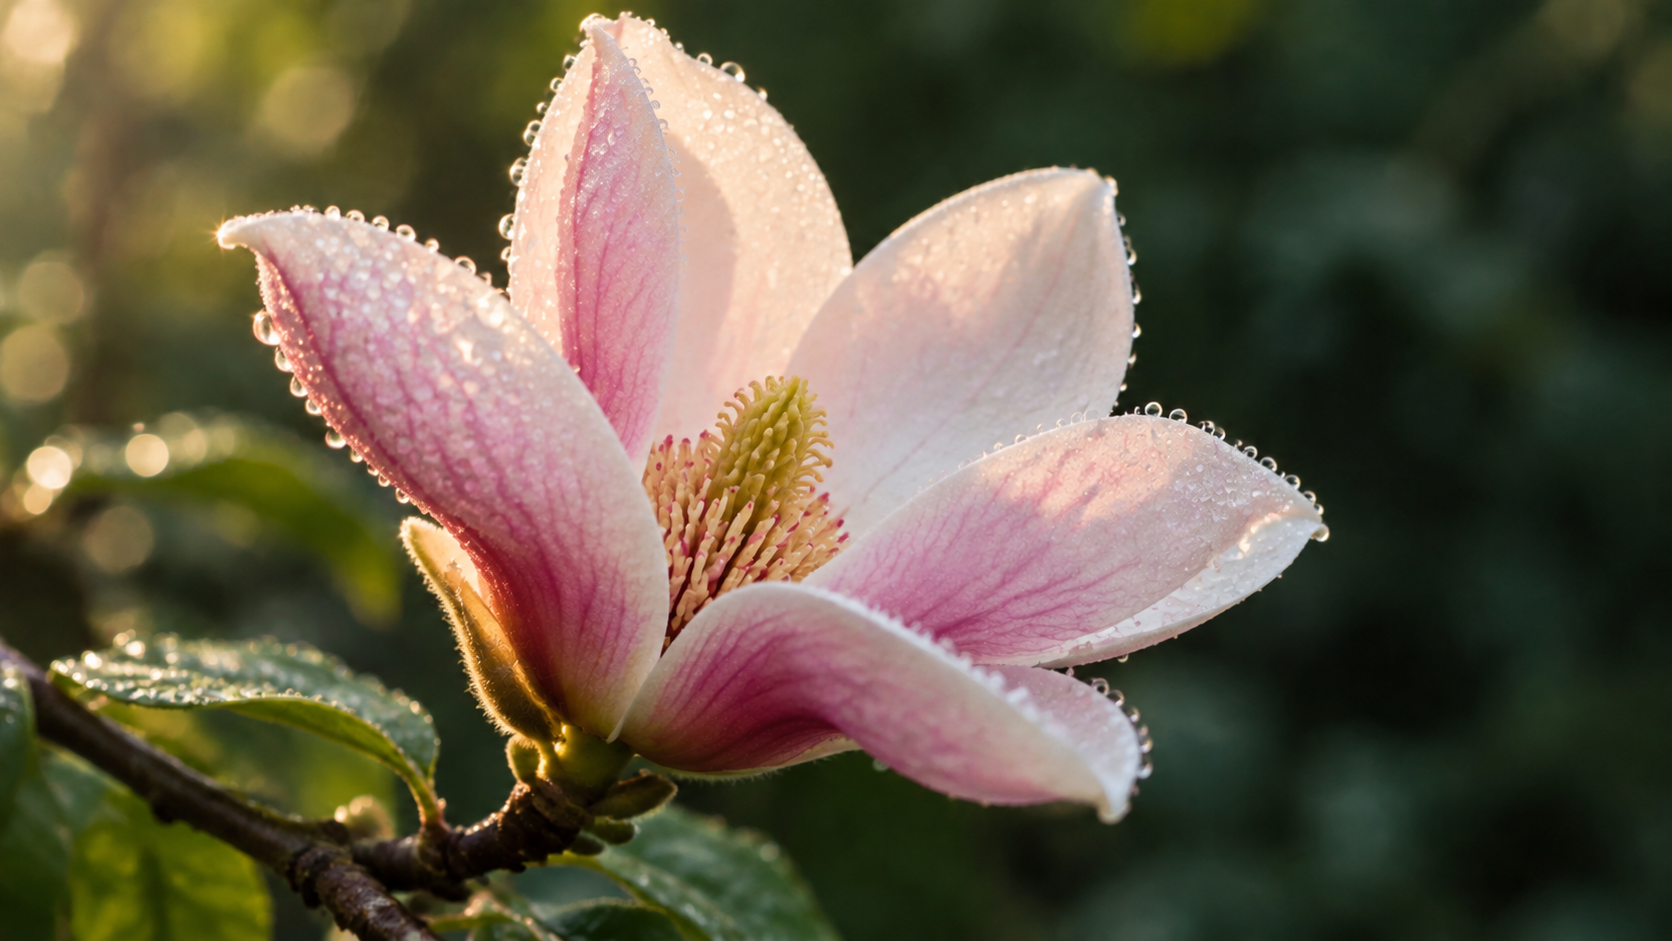
Abbiamo generato il frame di apertura, poi abbiamo modificato lo stesso frame nel suo stato "dopo", mantenendo composizione, luce e sfondo esattamente identici — l'unica cosa che cambia è il soggetto.
Primo frame (first_frame_image) → ultimo frame (last_frame_image):
Clip renderizzata (480P, 5 secondi):
Prompt (pronto da copiare):
Macro time-lapse di una magnolia che sboccia all'alba: i petali coperti di rugiada si aprono lentamente da un bocciolo compatto fino al fiore completamente sbocciato, rivelando il centro pallido degli stami, una morbida luce di contorno mattutina riscalda l'intera scena, il ramo oscilla impercettibilmente nella brezza. Mantieni la stessa composizione e lo stesso sfondo per tutta la durata, dettagli botanici realistici, movimento fluido e continuo, messa a fuoco stabile, nessuna persona, nessun testo, nessun taglio. Audio ambientale: morbidi cinguettii dell'alba, brezza tra le foglie, nessun dialogo.
Perché funziona:
- Due frame = estremi deterministici. Non devi sperare che il modello arrivi a una posizione plausibile; gli hai detto chiaramente dove iniziare e dove fermarti. Il prompt deve solo descrivere come procedere tra i due ("aprirsi lentamente… movimento fluido e continuo").
- Mantieni la coerenza tra i frame. Poiché il nostro ultimo frame è una versione modificata del primo (stesso ramo, angolazione, luce), l'interpolazione sembra un fiore che sboccia, non un taglio tra due foto. Frame non corrispondenti producono deformazioni fastidiose.
- "Mantieni la stessa composizione e lo stesso sfondo per tutta la durata" dice al modello che l'unica cosa che può cambiare è il fiore — e questo impedisce alla camera di vagare.
Punti chiave per la messa a punto
- Scrivi come un'inquadratura, non come una didascalia. Descrivi in ordine il movimento di camera, il movimento del soggetto, la luce e il suono. Una didascalia ("un fiore che sboccia") non dà al modello nulla da animare.
- Fai il budget in base alla risoluzione, itera a 480P. La formulazione del prompt raramente richiede più di 480P per essere valutata; dopo aver bloccato il testo, renderizza di nuovo il prodotto finale a 768P o 1080P.
- Mantieni 5 secondi durante le regolazioni. Clip più lunghe costano linearmente di più e danno al movimento più spazio per vagare. Estendi a 10–15 secondi solo quando movimento e audio risultano corretti.
- Non combattere con le proporzioni. Ritaglia il frame di input in 16:9, 9:16 o 1:1 prima di caricarlo; la clip eredita quella forma, e inviare
aspect_ratioinsieme al frame dà errore. - I prompt negativi contano per la raffinatezza. "Nessun taglio, nessuno sfarfallio, nessun testo, nessuna persona" eliminano in modo affidabile gli artefatti che fanno sembrare un video AI un video AI.
Prezzo
Il image-to-video di MiniMax H3 Max si fattura in base ai secondi di video richiesti, con differenza per risoluzione (a partire da 2026-10):
| Risoluzione | Prezzo al secondo | Clip da 5 secondi |
|---|---|---|
| 480P | $0.072 | $0.36 |
| 768P | $0.115 | $0.575 |
| 1080P | $0.229 | $1.145 |
Quindi le tre clip di questa guida — una a 768P e due a 480P, tutte da 5 secondi — ammontano a circa $1,30 di costo video. Prima di pianificare un budget in scala, consulta i numeri in tempo reale sulla pagina dei prezzi di hiapi; la tariffa al secondo è il numero che cambia.
Domande frequenti
Devo fornire entrambi i frame?
No. Nel percorso image-to-video, last_frame_image è obbligatorio, first_frame_image è opzionale. Con il solo frame finale (soluzioni 1 e 2) si ottiene bene l'effetto "arrivare a questa inquadratura", mentre per una trasformazione controllata dall'inizio alla fine (soluzione 3) si usano entrambi i frame.
Quali risoluzioni e durate sono supportate?
resolution è 480P, 768P o 1080P; duration è un numero intero di secondi tra 5 e 15.
Genera l'audio? Sì — descrivi i suoni ambientali nel prompt e il modello aggiungerà una traccia audio corrispondente. Aggiungi "no speech" per mantenere l'assenza di dialoghi. Le tre clip qui hanno tutte una traccia audio ambientale.
Come si imposta il rapporto d'aspetto?
Lo determina il frame di input. Ritaglia il frame nella forma desiderata; non inviare il campo aspect_ratio insieme all'immagine frame.
Voglio solo text-to-video, senza immagine di input. Usa il percorso text-to-video di MiniMax H3 Max — stessa disciplina nel prompt, nessun frame necessario. Se stai confrontando H3 Max con altre API video, il nostro confronto tra Seedance 2.5 e 2.0 spiega come scegliere un modello video fatturato al secondo.
Inizia a generare
Prendi un frame hero, scrivilo come un'inquadratura con movimento di camera e descrizione audio, poi invialo alla API image-to-video di MiniMax H3 Max. Inizia a regolare la formulazione a 480P, poi renderizza di nuovo il prodotto finale a risoluzione più alta. I dettagli completi di richiesta e polling sono nella documentazione di hiapi.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori