
使用指南
Veo 3.1 Lite 图生视频:通过 hiapi API 将照片变成短视频
分步图生视频工作流、真实定价,以及一个可直接运行的 API 示例。
太长不看
- 这是什么:一个真实、端到端的工作流,用 hiapi API 上的 veo-3.1-lite/image-to-video 把单张静态照片变成带原生音频的竖屏短视频片段。本页的每一张图片、每一个提示词、每一次 API 调用,都是所示请求的真实输出。
- 为什么短视频内容适合用图生视频:你可以在静态图片中完全掌控构图、品牌呈现和产品取景,然后让模型添加动态和环境音——而不必指望文生视频提示词恰好生成你想要的镜头。
- 经核实的 API 事实:该任务恰好接受五个输入字段——
prompt、image_url(单个公开 URL,不是数组)、duration(4、6 或 8 秒)、resolution(720p或1080p)以及generate_audio(布尔值)。schema 是严格的——任何其他字段都会被拒绝。 - 真实成本:一段 4 秒 720p 带原生音频的片段花费 $0.40($0.10/秒);关闭音频后降至 $0.24($0.06/秒)。当前费率见 pricing。
- 真实渲染时间:下面嵌入的 4 秒片段,从提交任务到可下载文件大约用了 55 秒。
为什么图生视频适合短视频内容
TikTok 和 Reels 风格的片段成败取决于第一帧——也就是人们决定是否点击的缩略图。文生视频在构图上是一场赌博:你描述一个场景,然后指望模型按你需要的方式取景。图生视频则把这一切反过来。你先用一张静态图锁定确切的镜头——产品摆放、光线、宽高比——然后只把动态交给模型:镜头保持不动时,什么该飘动、冒热气、泛起涟漪或微微移动。
这种分工正是 veo-3.1-lite/image-to-video 的用途:给它一张照片和一段动态提示词,它就会返回一个原生支持 9:16、带同步音频的 MP4,你完全不用碰视频编辑器。
演示:一张静态照片,然后动起来
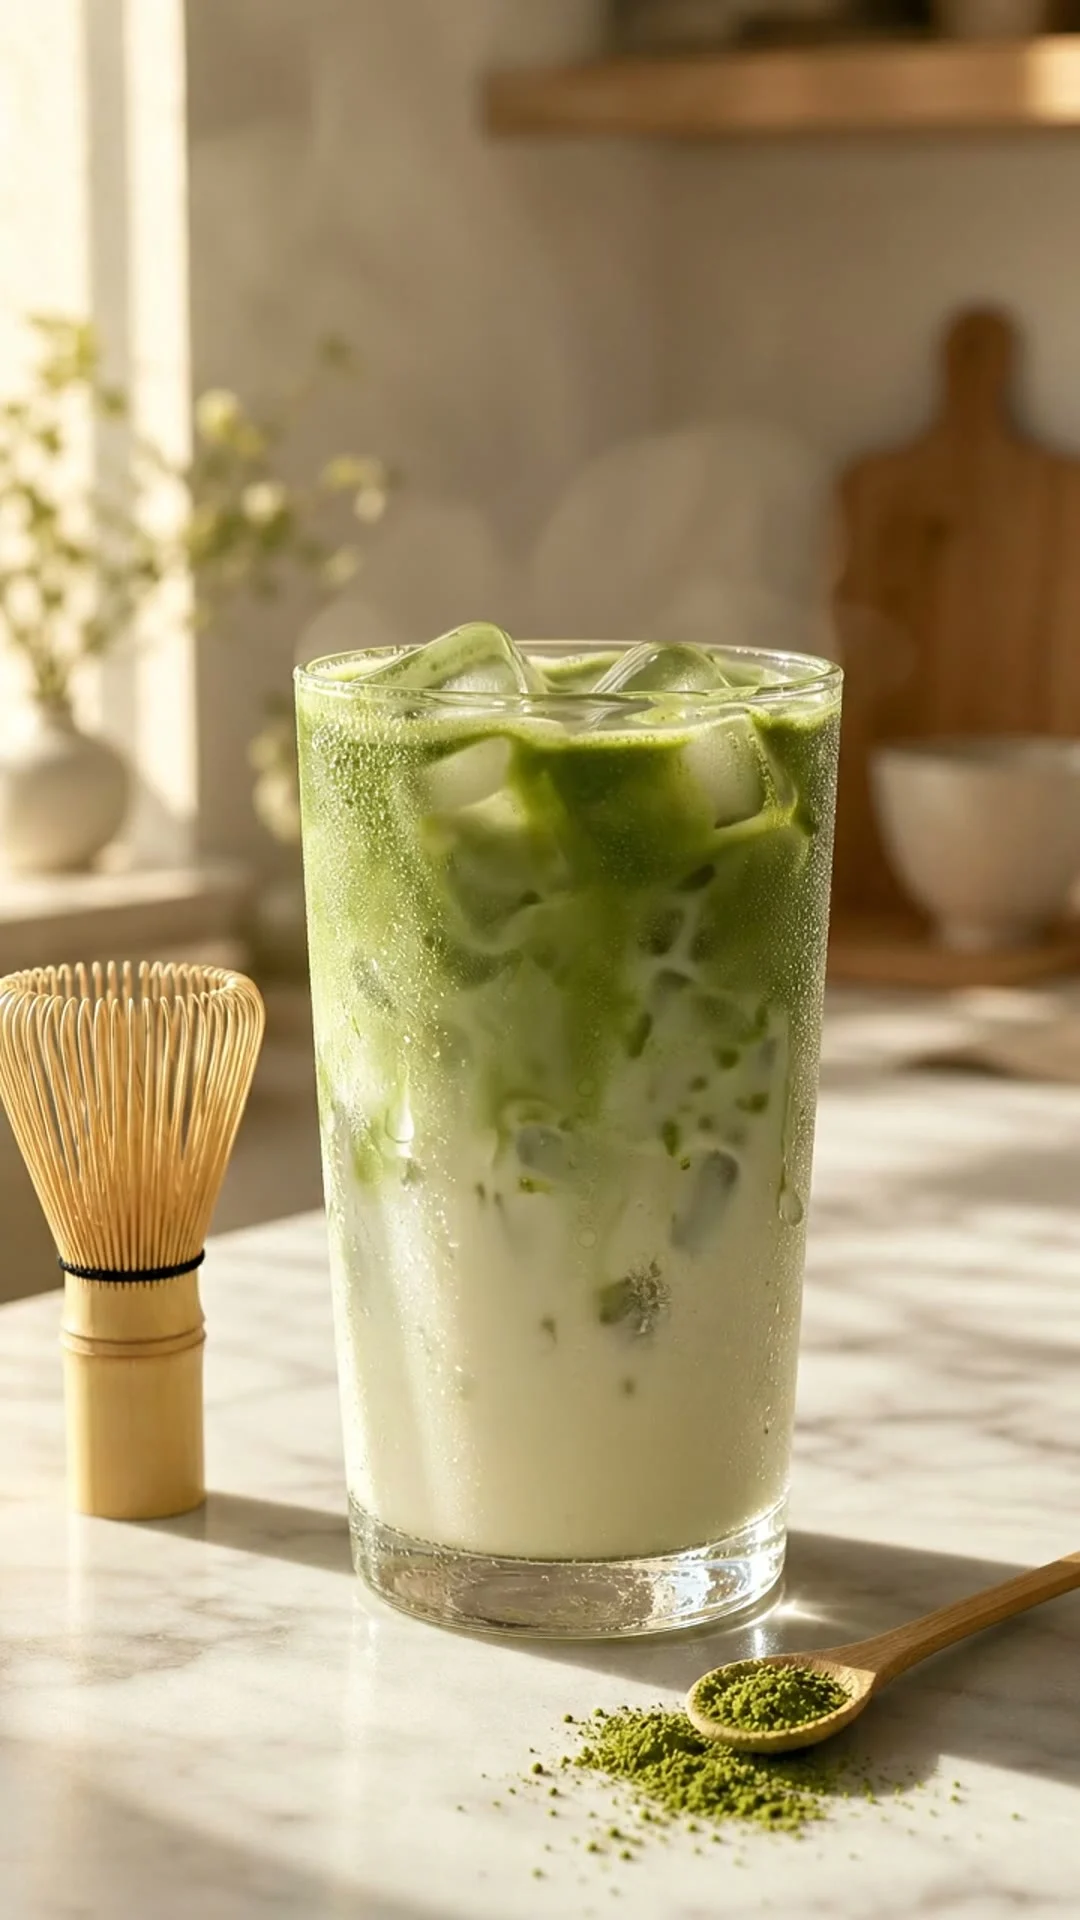
为了让内容更具体,我们用简单的主体自己跑通了整个流程:一杯冰抹茶拿铁,按照饮品食谱或咖啡馆账号面向竖屏信息流会采用的拍摄方式来构图。
第 1 步——源照片
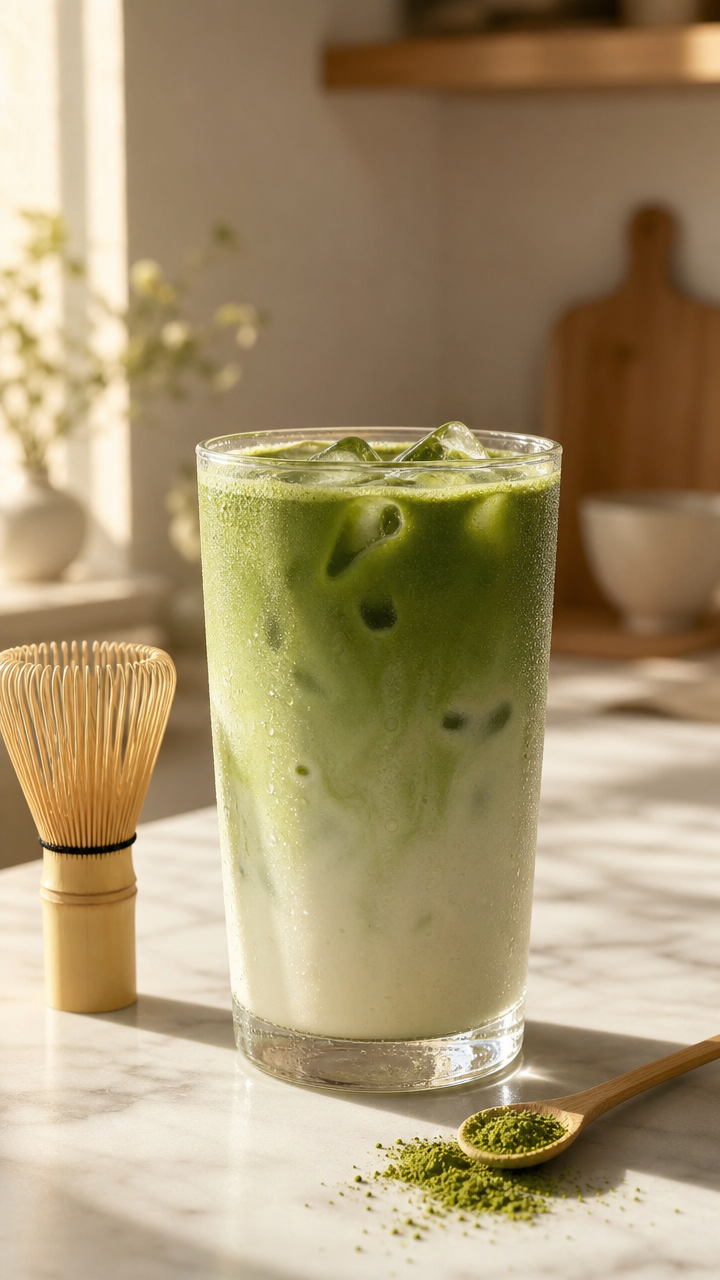
这张静态图是用 gpt-image-2/text-to-image 以 9:16 宽高比生成的,使用了以下这段精确的提示词:
A vertical 9:16 studio product photograph of an iced matcha latte in a clear glass
on a white marble countertop, visible ice cubes and vivid green matcha layered against
milk, soft warm morning sunlight streaming in from the left casting a long soft shadow,
a small bamboo matcha whisk and a light wooden scoop with loose matcha powder resting
beside the glass, fine condensation droplets on the glass exterior, a blurred
cream-and-beige kitchen background with shallow depth of field, warm natural color
grade, high-resolution commercial beverage photography, no text, no watermark,
no hands, no logos
只要是一个公开 URL,任何静态图片都可以——真实产品照、截图,或者像这里这样由 AI 生成的静态图。
第 2 步——让它动起来
这就是真实输出——一段 4 秒、720p、9:16 的 MP4,带同步音频,由上面的静态图和以下动态提示词生成:
Camera holds a slow, steady static shot with no camera movement or zoom. Gentle
wisps of steam rise from the iced matcha latte, fine condensation droplets slowly
trickle down the glass, and the ice cubes shift subtly with a soft clink. Warm
morning sunlight flickers gently as if from a light breeze outside a nearby window.
Soft ambient cafe background sound with a faint ceramic clink and quiet room tone.
注意,这段提示词几乎没有描述主体本身——照片已经定义了这些。它只描述了什么该动、什么该被听到,这正是对已经构图好的镜头使用图生视频而非文生视频的全部意义。
发起 API 调用
在底层,hiapi 上的每个模型——图像或视频——都走同一套异步任务模式:提交、轮询、下载。对于 veo-3.1-lite/image-to-video,请求如下所示:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "veo-3.1-lite/image-to-video",
    "input": {
      "prompt": "Camera holds a slow, steady static shot with no camera movement or zoom. Gentle wisps of steam rise from the iced matcha latte...",
      "image_url": "https://your-cdn.example.com/still.jpg",
      "duration": 4,
      "resolution": "720p",
      "generate_audio": true
    }
  }'
这会立即返回一个 taskId。轮询它,直到状态变为 success,然后从 output[0].url 获取文件——该链接会过期,所以请立即下载,而不是直接链接到它:
import subprocess, json, time

def animate_still(token, image_url, prompt, duration=4, resolution="720p", audio=True):
    def curl(args):
        r = subprocess.run(
            ["curl", "-s", "--max-time", "60", *args,
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, check=True,
        )
        return json.loads(r.stdout)

    payload = {
        "model": "veo-3.1-lite/image-to-video",
        "input": {
            "prompt": prompt,
            "image_url": image_url,
            "duration": duration,
            "resolution": resolution,
            "generate_audio": audio,
        },
    }
    task = curl(["-X", "POST", "https://api.hiapi.ai/v1/tasks",
                 "-H", "Content-Type: application/json",
                 "-d", json.dumps(payload)])
    task_id = task["data"]["taskId"]

    while True:
        status = curl([f"https://api.hiapi.ai/v1/tasks/{task_id}"])["data"]
        if status["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if status["status"] != "success":
        raise RuntimeError(status.get("error"))
    return status["output"][0]["url"]  # download immediately — this link expires
这与 hiapi 上任何基于任务的模型所记录的模式相同,也是我们用来渲染上面这段片段的模式。
schema 实际接受什么
我们对照实时端点手动验证过,所以请把它当作事实而非猜测:
prompt——字符串,描述动态(如果generate_audio开启,还包括声音)。image_url——单个公开 URL。不是平台上其他一些 i2v 模型使用的数组——在这里传列表会失败。duration——整数,只能是4、6或8秒。不接受其他值。resolution——"720p"或"1080p"。generate_audio——布尔值。开启或关闭原生同步音频。- schema 是严格的:发送未识别的字段,请求会被直接拒绝,而不是被静默忽略。
一段片段实际要花多少钱
定价按输出秒数计算,取决于分辨率和是否启用音频(截至 2026 年 9 月——大规模预算前请查看实时定价页):
720p带音频:$0.10/秒——4 秒片段为 $0.40。720p不带音频:$0.06/秒——同样片段降至 $0.24。1080p带音频:$0.14/秒。1080p不带音频:$0.10/秒。
对于短视频内容日历,这笔账才是真正的杠杆:一批十段 4 秒 720p 带音频的片段大约花费 $4.00;同一批不带音频则为 $2.40。如果声音设计对帖子很重要(咖啡馆环境噪声、产品的触感咔嗒声、脚步声),就保持音频开启——这是演示片段与仿佛实地拍摄的作品之间的差别。
如果你需要每段超过 8 秒,或想在更长时长下独立控制镜头运动,hiapi 还提供 veo-3.1-fast(更高保真度,$0.25/秒起)和旗舰级 veo-3.1 档位($0.57/秒起)——两者都支持文生视频和图生视频。不过对于大多数短视频社交剪辑,lite 是正确的默认选择:成本只是零头,输出已经针对竖屏、10 秒以内的片段调校好了。
对于同一个短视频问题的另一种思路——更长的片段、对首帧/尾帧更多的手动控制——我们也算过用 seedance-2.0-mini 搭建短视频工作流的账,它以照片生成原生音频为代价,换取最长 15 秒的时长和更低的每秒费率。
常见问题
veo-3.1-lite/image-to-video 接受多张参考图吗?
不接受。image_url 只接受一个公开 URL。如果你需要一个能融合多张参考图的模型,那是另一种调用——在假设它与此处相同之前,请查看该模型自己的页面以了解其确切的输入 schema。
单次调用能获得超过 8 秒的片段吗?
在 lite 上不能。duration 字段只接受 4、6 或 8。如需更长的单段视频,请看平台视频 API 集合中的其他视频模型,其中多个支持超过 15 秒的时长。
输出已经带原生音频吗,还是我需要在后期加声音?
如果 generate_audio 为 true,返回的 MP4 已带有同步的 AAC 音轨——无需单独的音频设计环节。如果你打算自己为片段配乐,或不需要环境音,就把它设为 false。
我到底需要视频模型吗,还是 gpt-image-2 的输出已经可以直接发布?
很多短视频信息流会混排静态和动态内容,所以 gpt-image-2/text-to-image 生成的静态图本身就是一个不错的帖子。图生视频适用于平台(或当下场景)需要动态的时候——产品细节、微妙的对比前后、循环——而无需重新拍摄。
如果我传入无效的 duration(比如 5)会怎样?
请求会在创建任何任务之前被拒绝——你会立即收到 schema 错误,而不是浪费一次渲染。
准备好尝试了吗?veo-3.1-lite/image-to-video 模型页有一个实时 playground,你可以在写任何一行代码之前先放入自己的照片和提示词。


