
사용 가이드
Veo 3.1 Lite 이미지 투 비디오: hiapi API로 사진을 짧은 영상으로 만들기
단계별 이미지 투 비디오 워크플로, 실제 가격, 그리고 바로 실행 가능한 API 예제.
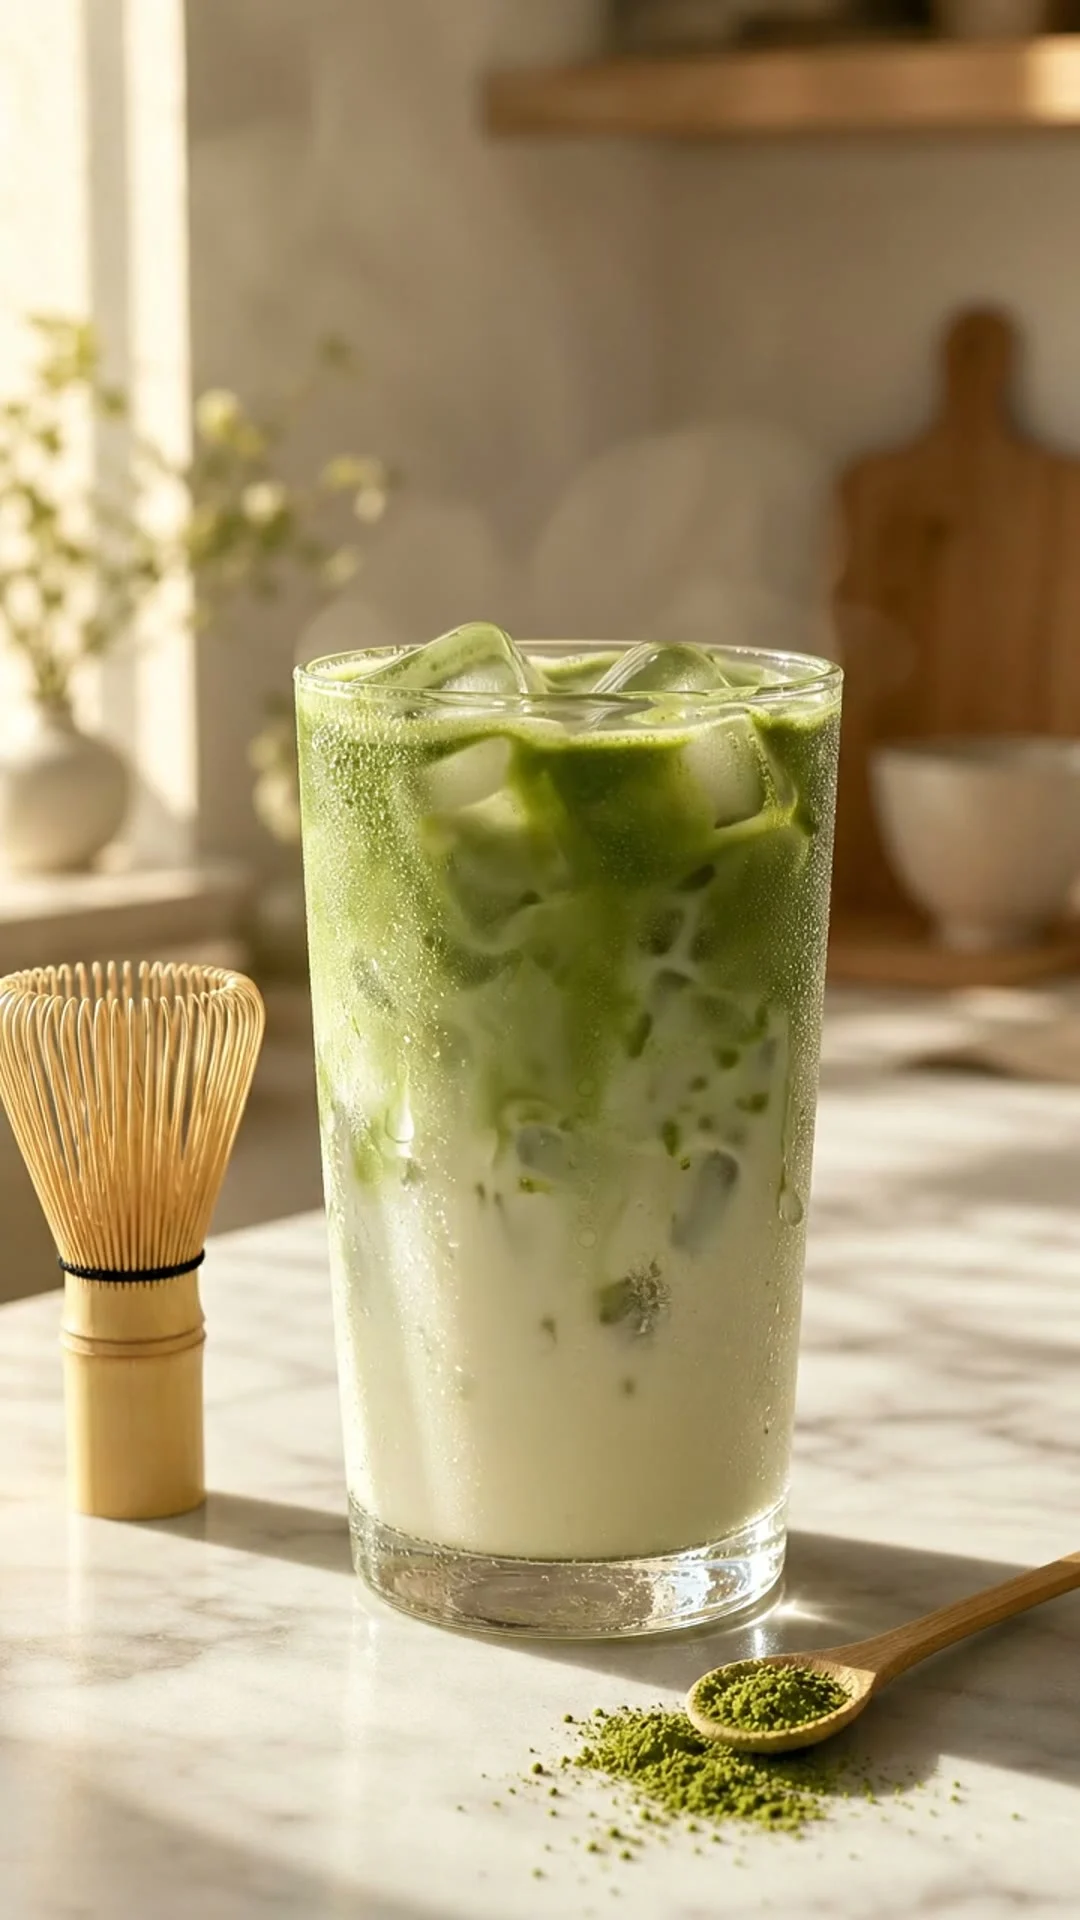
핵심 요약
- 무엇인가: hiapi API의 veo-3.1-lite/image-to-video를 사용해 단일 정지 사진을 네이티브 오디오가 포함된 세로형 짧은 영상 클립으로 변환하는 실제 엔드투엔드 워크플로입니다. 이 페이지의 모든 이미지, 모든 프롬프트, 모든 API 호출은 표시된 요청의 실제 출력입니다.
- 짧은 영상 콘텐츠에 이미지 투 비디오가 적합한 이유: 정지 이미지에서 구도, 브랜드 노출, 제품 프레이밍을 완전히 제어한 다음, 모델이 움직임과 환경음을 추가하도록 할 수 있습니다—텍스트 투 비디오 프롬프트가 원하는 샷을 우연히 생성해 주기를 바랄 필요가 없습니다.
- 검증된 API 사실: 이 작업은 정확히 다섯 개의 입력 필드—
prompt,image_url(배열이 아닌 단일 공개 URL),duration(4, 6 또는 8초),resolution(720p또는1080p),generate_audio(불리언)—만 받습니다. 스키마는 엄격하며 다른 필드는 거부됩니다. - 실제 비용: 4초 720p 네이티브 오디오 포함 클립은 $0.40($0.10/초)입니다. 오디오를 끄면 $0.24($0.06/초)로 낮아집니다. 현재 요금은 pricing에서 확인하세요.
- 실제 렌더링 시간: 아래에 삽입된 4초 클립은 작업 제출부터 다운로드 가능한 파일까지 약 55초가 걸렸습니다.
짧은 영상 콘텐츠에 이미지 투 비디오가 적합한 이유
TikTok과 Reels 스타일의 클립은 첫 프레임—사람들이 클릭할지 결정하는 썸네일—에 성패가 달려 있습니다. 텍스트 투 비디오는 구도에서 도박입니다. 장면을 묘사한 다음 모델이 필요한 방식으로 프레이밍해 주기를 바라야 합니다. 이미지 투 비디오는 이를 뒤집습니다. 먼저 정지 이미지로 정확한 샷—제품 배치, 조명, 화면 비율—을 고정한 다음, 움직임만 모델에 맡깁니다. 카메라가 고정된 상태에서 무엇이 흩날리고, 김이 피어오르고, 잔물결이 일고, 살짝 움직여야 하는지를요.
이런 역할 분담이 바로 veo-3.1-lite/image-to-video의 용도입니다. 사진과 동작 프롬프트를 주면 9:16을 네이티브로 지원하고 동기화된 오디오가 포함된 MP4를 반환하므로, 영상 편집기를 전혀 건드릴 필요가 없습니다.
데모: 정지 사진 하나, 그리고 움직이게 하기
내용을 더 구체적으로 만들기 위해 간단한 피사체로 전체 흐름을 직접 실행했습니다. 아이스 말차 라떼 한 잔으로, 음료 레시피나 카페 계정이 세로형 피드에 맞춰 촬영할 방식으로 구도했습니다.
1단계—원본 사진
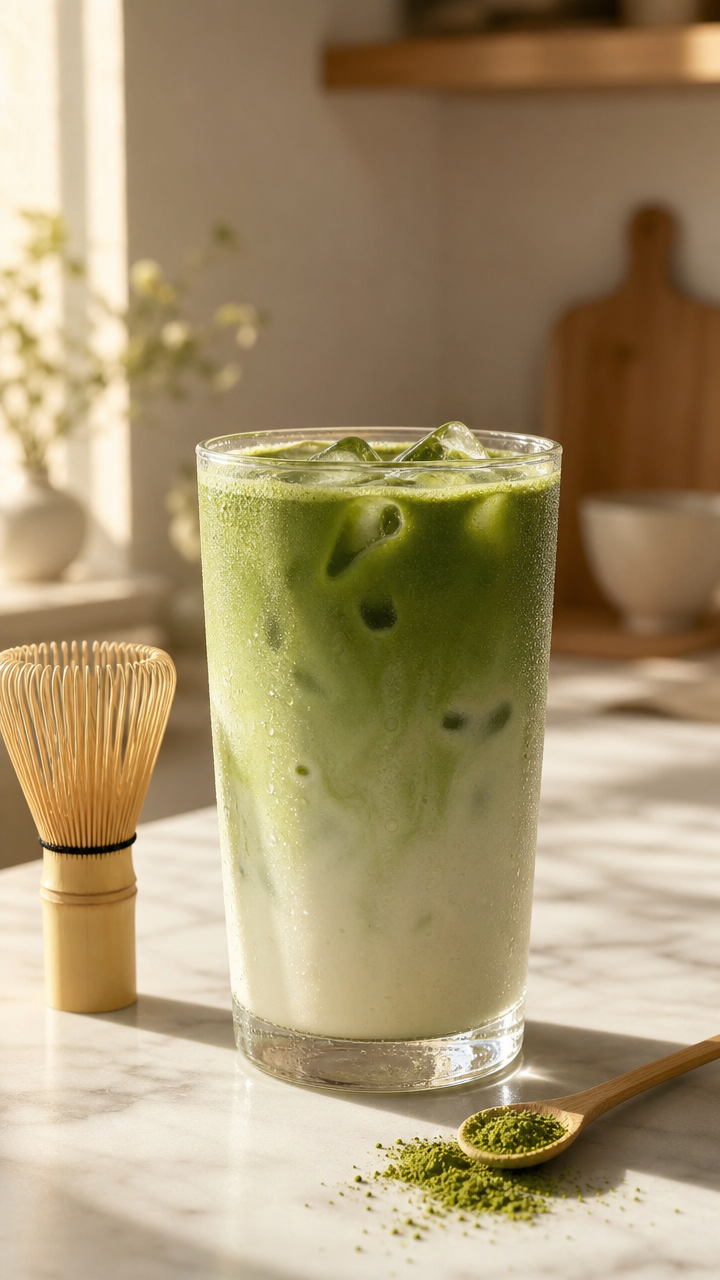
이 정지 이미지는 gpt-image-2/text-to-image로 9:16 화면 비율로 생성했으며, 다음 프롬프트를 정확히 사용했습니다:
A vertical 9:16 studio product photograph of an iced matcha latte in a clear glass
on a white marble countertop, visible ice cubes and vivid green matcha layered against
milk, soft warm morning sunlight streaming in from the left casting a long soft shadow,
a small bamboo matcha whisk and a light wooden scoop with loose matcha powder resting
beside the glass, fine condensation droplets on the glass exterior, a blurred
cream-and-beige kitchen background with shallow depth of field, warm natural color
grade, high-resolution commercial beverage photography, no text, no watermark,
no hands, no logos
공개 URL이기만 하면 어떤 정지 이미지든 괜찮습니다—실제 제품 사진, 스크린샷, 또는 여기처럼 AI로 생성한 정지 이미지도요.
2단계—움직이게 하기
이것이 실제 출력입니다—4초, 720p, 9:16 MP4로 동기화된 오디오가 포함되어 있으며, 위의 정지 이미지와 다음 동작 프롬프트로 생성했습니다:
Camera holds a slow, steady static shot with no camera movement or zoom. Gentle
wisps of steam rise from the iced matcha latte, fine condensation droplets slowly
trickle down the glass, and the ice cubes shift subtly with a soft clink. Warm
morning sunlight flickers gently as if from a light breeze outside a nearby window.
Soft ambient cafe background sound with a faint ceramic clink and quiet room tone.
이 프롬프트는 피사체 자체를 거의 묘사하지 않는다는 점에 주목하세요—사진이 이미 그것을 정의했습니다. 무엇이 움직이고 무엇이 들려야 하는지만 묘사하며, 이것이 이미 구도가 잡힌 샷에 텍스트 투 비디오 대신 이미지 투 비디오를 사용하는 이유의 전부입니다.
API 호출하기
내부적으로 hiapi의 모든 모델—이미지든 영상이든—은 동일한 비동기 작업 패턴을 따릅니다: 제출, 폴링, 다운로드. veo-3.1-lite/image-to-video의 요청은 다음과 같습니다:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "veo-3.1-lite/image-to-video",
    "input": {
      "prompt": "Camera holds a slow, steady static shot with no camera movement or zoom. Gentle wisps of steam rise from the iced matcha latte...",
      "image_url": "https://your-cdn.example.com/still.jpg",
      "duration": 4,
      "resolution": "720p",
      "generate_audio": true
    }
  }'
이 요청은 즉시 taskId를 반환합니다. 상태가 success가 될 때까지 폴링한 다음 output[0].url에서 파일을 가져오세요—이 링크는 만료되므로 직접 링크하지 말고 즉시 다운로드하세요:
import subprocess, json, time

def animate_still(token, image_url, prompt, duration=4, resolution="720p", audio=True):
    def curl(args):
        r = subprocess.run(
            ["curl", "-s", "--max-time", "60", *args,
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, check=True,
        )
        return json.loads(r.stdout)

    payload = {
        "model": "veo-3.1-lite/image-to-video",
        "input": {
            "prompt": prompt,
            "image_url": image_url,
            "duration": duration,
            "resolution": resolution,
            "generate_audio": audio,
        },
    }
    task = curl(["-X", "POST", "https://api.hiapi.ai/v1/tasks",
                 "-H", "Content-Type: application/json",
                 "-d", json.dumps(payload)])
    task_id = task["data"]["taskId"]

    while True:
        status = curl([f"https://api.hiapi.ai/v1/tasks/{task_id}"])["data"]
        if status["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if status["status"] != "success":
        raise RuntimeError(status.get("error"))
    return status["output"][0]["url"]  # download immediately — this link expires
이것은 hiapi의 모든 작업 기반 모델에 문서화된 패턴과 동일하며, 위 클립을 렌더링하는 데 사용한 패턴이기도 합니다.
스키마가 실제로 받는 것
실시간 엔드포인트로 직접 검증했으므로 추측이 아닌 사실로 받아들이세요:
prompt—문자열, 동작(그리고generate_audio가 켜져 있으면 소리)을 설명합니다.image_url—단일 공개 URL. 플랫폼의 다른 일부 i2v 모델이 사용하는 배열이 아닙니다—여기서 리스트를 전달하면 실패합니다.duration—정수,4,6또는8초만 가능합니다. 다른 값은 허용되지 않습니다.resolution—"720p"또는"1080p".generate_audio—불리언. 네이티브 동기화 오디오를 켜거나 끕니다.- 스키마는 엄격합니다. 인식되지 않는 필드를 보내면 요청이 조용히 무시되는 것이 아니라 곧바로 거부됩니다.
클립 하나에 실제로 얼마가 드는가
가격은 출력 초 수를 기준으로 하며 해상도와 오디오 활성화 여부에 따라 달라집니다(2026년 9월 기준—대규모 예산 편성 전에 실시간 가격 페이지를 확인하세요):
720p오디오 포함: $0.10/초—4초 클립은 $0.40.720p오디오 미포함: $0.06/초—같은 클립이 $0.24로 낮아집니다.1080p오디오 포함: $0.14/초.1080p오디오 미포함: $0.10/초.
짧은 영상 콘텐츠 캘린더에서는 이 계산이 진짜 레버리지입니다. 4초 720p 오디오 포함 클립 열 개를 한 배치로 만들면 약 $4.00이고, 같은 배치를 오디오 없이 만들면 $2.40입니다. 사운드 디자인이 게시물에 중요하다면(카페 환경음, 제품의 촉각적 딸깍 소리, 발걸음 소리) 오디오를 켜 두세요—데모 클립과 현장에서 촬영한 듯한 작업 사이의 차이가 바로 여기서 납니다.
클립당 8초를 넘겨야 하거나 더 긴 길이에서 카메라 움직임을 독립적으로 제어하고 싶다면, hiapi는 veo-3.1-fast(더 높은 충실도, $0.25/초부터)와 플래그십 veo-3.1 티어($0.57/초부터)도 제공합니다—둘 다 텍스트 투 비디오와 이미지 투 비디오를 지원합니다. 하지만 대부분의 짧은 영상 소셜 클립에는 lite가 올바른 기본 선택입니다. 비용은 일부에 불과하고, 출력은 이미 세로형 10초 이내 클립에 맞게 조정되어 있습니다.
같은 짧은 영상 문제에 대한 다른 접근—더 긴 클립과 첫 프레임/끝 프레임에 대한 더 많은 수동 제어—에 대해서는 seedance-2.0-mini로 짧은 영상 워크플로 구축하기의 계산도 해 두었습니다. 이 모델은 사진에서 네이티브 오디오를 생성하는 대신 최대 15초 길이와 더 낮은 초당 요금을 제공합니다.
자주 묻는 질문
veo-3.1-lite/image-to-video는 여러 참조 이미지를 받나요?
아니요. image_url은 하나의 공개 URL만 받습니다. 여러 참조 이미지를 융합하는 모델이 필요하다면 그것은 다른 호출입니다—여기와 같다고 가정하기 전에 해당 모델 자체 페이지에서 정확한 입력 스키마를 확인하세요.
단일 호출로 8초를 넘는 클립을 얻을 수 있나요?
lite에서는 안 됩니다. duration 필드는 4, 6 또는 8만 받습니다. 더 긴 단일 영상이 필요하면 플랫폼의 영상 API 컬렉션에 있는 다른 영상 모델을 보세요. 여러 모델이 15초를 넘는 길이를 지원합니다.
출력에 이미 네이티브 오디오가 포함되나요, 아니면 후반 작업에서 사운드를 추가해야 하나요?
generate_audio가 true이면 반환되는 MP4에 이미 동기화된 AAC 오디오 트랙이 포함되어 있습니다—별도의 오디오 디자인 단계가 필요 없습니다. 클립에 직접 음악을 입히거나 환경음이 필요 없다면 false로 설정하세요.
영상 모델이 정말 필요한가요, 아니면 gpt-image-2 출력을 바로 게시할 수 있나요?
많은 짧은 영상 피드는 정적 콘텐츠와 동적 콘텐츠를 섞어 배치하므로, gpt-image-2/text-to-image로 생성한 정지 이미지 자체가 좋은 게시물입니다. 이미지 투 비디오는 플랫폼(또는 현재 상황)이 다시 촬영하지 않고도 움직임을 필요로 할 때 적합합니다—제품 디테일, 미묘한 전후 비교, 루프 같은 경우에요.
유효하지 않은 duration(예: 5)을 전달하면 어떻게 되나요?
작업이 생성되기 전에 요청이 거부됩니다—렌더링을 낭비하지 않고 즉시 스키마 오류를 받습니다.
시도해 볼 준비가 되셨나요? veo-3.1-lite/image-to-video 모델 페이지에는 코드 한 줄도 작성하기 전에 자신의 사진과 프롬프트를 넣어 볼 수 있는 실시간 플레이그라운드가 있습니다.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트