
Guia de uso
Veo 3.1 Lite 图生视频:通过 hiapi API 将照片变成短视频
分步图生视频工作流、真实定价,以及一个可直接运行的 API 示例。
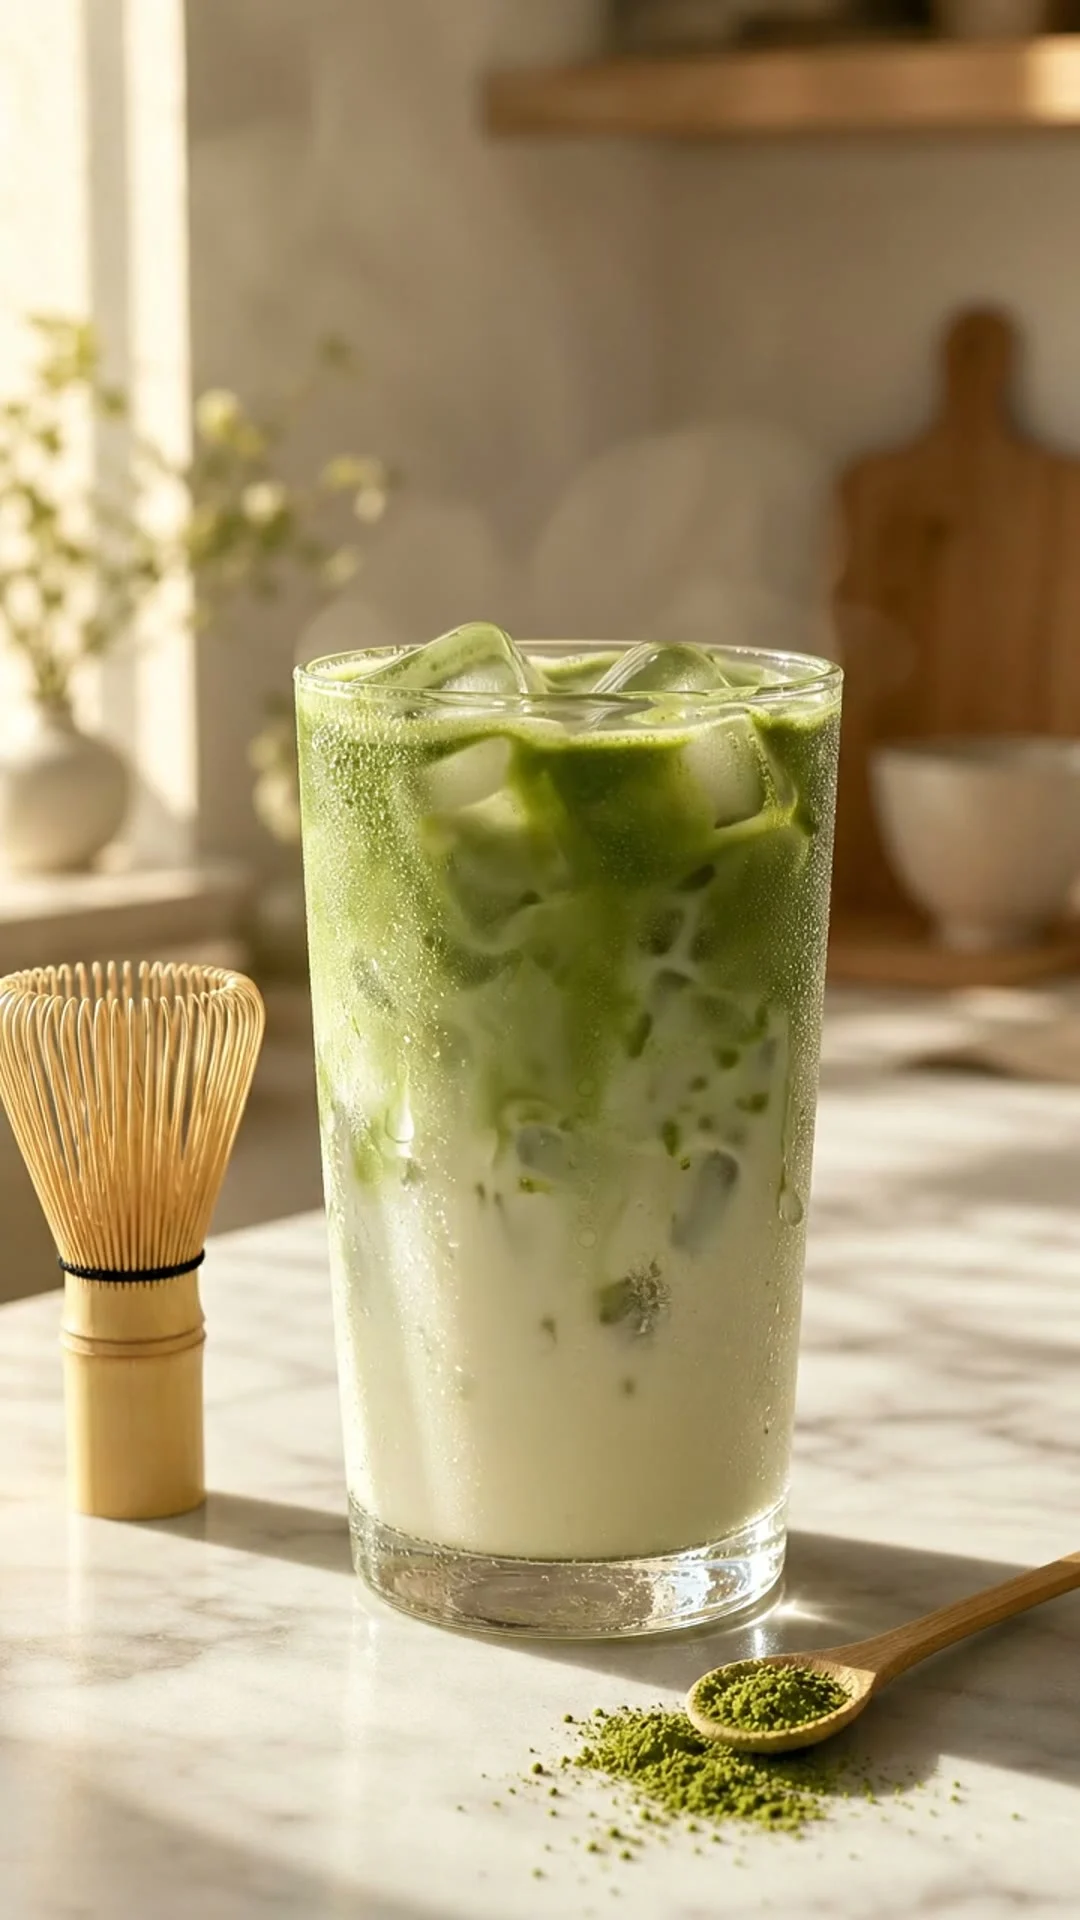
Resumo rápido
- O que é: um fluxo de trabalho real e de ponta a ponta que transforma uma única foto estática em um clipe vertical curto com áudio nativo usando veo-3.1-lite/image-to-video na API do hiapi. Cada imagem, cada prompt e cada chamada de API nesta página é a saída real das requisições mostradas.
- Por que conteúdo de formato curto combina com image-to-video: você controla completamente a composição, a apresentação da marca e o enquadramento do produto na imagem estática, e depois deixa o modelo adicionar movimento e som ambiente — em vez de torcer para que um prompt de text-to-video gere exatamente a cena que você quer.
- Fatos verificados da API: a tarefa aceita exatamente cinco campos de entrada —
prompt,image_url(uma única URL pública, não um array),duration(4, 6 ou 8 segundos),resolution(720pou1080p) egenerate_audio(booleano). O schema é estrito — qualquer outro campo é rejeitado. - Custo real: um clipe de 4 segundos em 720p com áudio nativo custa $0.40 ($0.10/s); desativando o áudio cai para $0.24 ($0.06/s). Consulte as tarifas atuais.
- Tempo real de renderização: o clipe de 4 segundos incorporado abaixo levou cerca de 55 segundos desde o envio da tarefa até o arquivo ficar disponível para download.
Por que image-to-video combina com conteúdo de formato curto
Clipes no estilo TikTok e Reels dependem do primeiro quadro — a miniatura em que as pessoas decidem se vão clicar. Text-to-video é uma aposta na composição: você descreve uma cena e torce para que o modelo a enquadre do jeito que você precisa. Image-to-video inverte tudo isso. Você primeiro fixa o enquadramento exato com uma imagem estática — posicionamento do produto, iluminação, proporção — e entrega ao modelo apenas o movimento: enquanto a câmera permanece parada, o que deve flutuar, soltar vapor, ondular ou se mover levemente.
Essa divisão de trabalho é exatamente para o que serve o veo-3.1-lite/image-to-video: dê a ele uma foto e um prompt de movimento, e ele retorna um MP4 com suporte nativo a 9:16 e áudio sincronizado, sem que você precise tocar em um editor de vídeo.
Demonstração: uma foto estática, depois em movimento
Para tornar o conteúdo mais concreto, executamos o fluxo completo com um sujeito simples: um matcha latte gelado, enquadrado como uma conta de receitas de bebidas ou de cafeteria faria para um feed vertical.
Passo 1 — a foto de origem
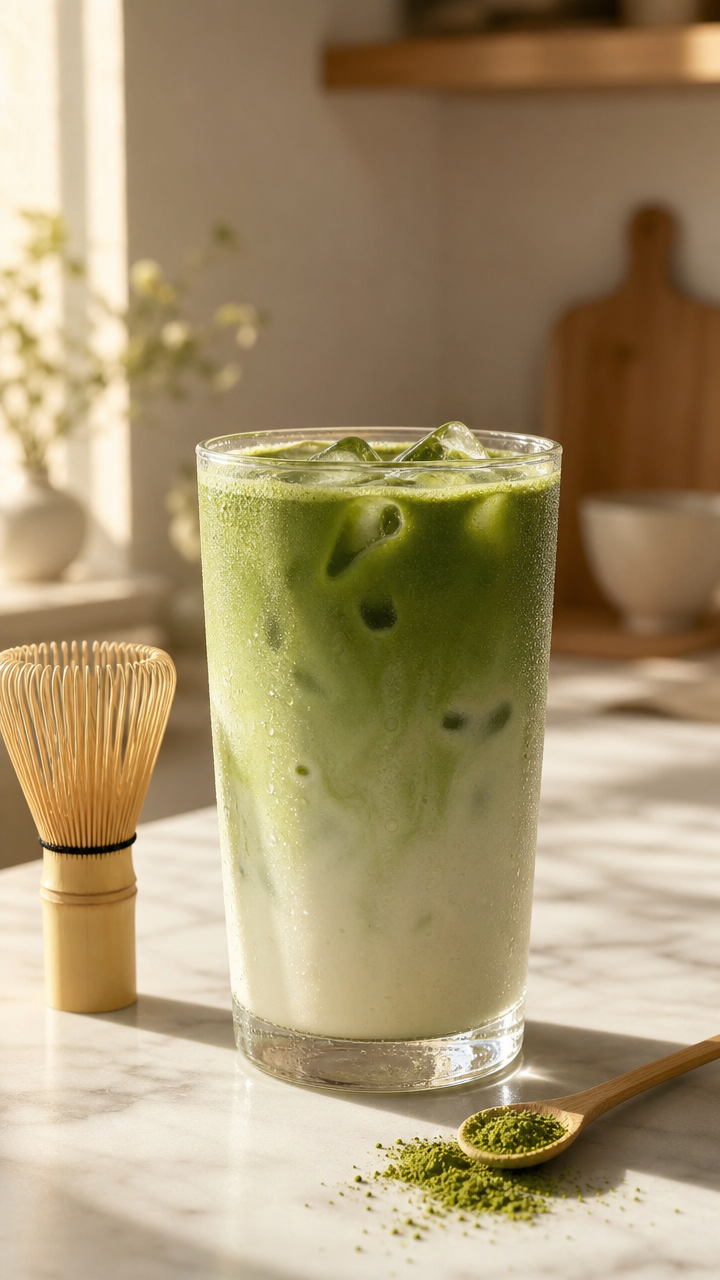
Esta imagem estática foi gerada com gpt-image-2/text-to-image na proporção 9:16, usando exatamente este prompt:
A vertical 9:16 studio product photograph of an iced matcha latte in a clear glass
on a white marble countertop, visible ice cubes and vivid green matcha layered against
milk, soft warm morning sunlight streaming in from the left casting a long soft shadow,
a small bamboo matcha whisk and a light wooden scoop with loose matcha powder resting
beside the glass, fine condensation droplets on the glass exterior, a blurred
cream-and-beige kitchen background with shallow depth of field, warm natural color
grade, high-resolution commercial beverage photography, no text, no watermark,
no hands, no logos
Qualquer imagem estática serve, desde que seja uma URL pública — foto real de produto, captura de tela ou, como aqui, uma imagem estática gerada por IA.
Passo 2 — coloque em movimento
Esta é a saída real — um MP4 de 4 segundos, 720p, 9:16, com áudio sincronizado, gerado a partir da imagem estática acima e do seguinte prompt de movimento:
Camera holds a slow, steady static shot with no camera movement or zoom. Gentle
wisps of steam rise from the iced matcha latte, fine condensation droplets slowly
trickle down the glass, and the ice cubes shift subtly with a soft clink. Warm
morning sunlight flickers gently as if from a light breeze outside a nearby window.
Soft ambient cafe background sound with a faint ceramic clink and quiet room tone.
Observe que este prompt quase não descreve o sujeito em si — a foto já define isso. Ele descreve apenas o que deve se mover e o que deve ser ouvido, o que é exatamente o sentido de usar image-to-video em vez de text-to-video para uma cena já composta.
Fazendo a chamada da API
Por baixo dos panos, todo modelo no hiapi — de imagem ou de vídeo — segue o mesmo padrão de tarefa assíncrona: enviar, consultar, baixar. Para o veo-3.1-lite/image-to-video, a requisição fica assim:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "veo-3.1-lite/image-to-video",
    "input": {
      "prompt": "Camera holds a slow, steady static shot with no camera movement or zoom. Gentle wisps of steam rise from the iced matcha latte...",
      "image_url": "https://your-cdn.example.com/still.jpg",
      "duration": 4,
      "resolution": "720p",
      "generate_audio": true
    }
  }'
Isso retorna imediatamente um taskId. Consulte-o até o status virar success e então obtenha o arquivo em output[0].url — esse link expira, então baixe imediatamente em vez de apontar diretamente para ele:
import subprocess, json, time

def animate_still(token, image_url, prompt, duration=4, resolution="720p", audio=True):
    def curl(args):
        r = subprocess.run(
            ["curl", "-s", "--max-time", "60", *args,
             "-H", f"Authorization: Bearer {token}"],
            capture_output=True, check=True,
        )
        return json.loads(r.stdout)

    payload = {
        "model": "veo-3.1-lite/image-to-video",
        "input": {
            "prompt": prompt,
            "image_url": image_url,
            "duration": duration,
            "resolution": resolution,
            "generate_audio": audio,
        },
    }
    task = curl(["-X", "POST", "https://api.hiapi.ai/v1/tasks",
                 "-H", "Content-Type: application/json",
                 "-d", json.dumps(payload)])
    task_id = task["data"]["taskId"]

    while True:
        status = curl([f"https://api.hiapi.ai/v1/tasks/{task_id}"])["data"]
        if status["status"] in ("success", "fail"):
            break
        time.sleep(5)

    if status["status"] != "success":
        raise RuntimeError(status.get("error"))
    return status["output"][0]["url"]  # download immediately — this link expires
Este é o mesmo padrão documentado para qualquer modelo baseado em tarefa no hiapi, e é o padrão que usamos para renderizar o clipe acima.
O que o schema realmente aceita
Verificamos manualmente contra o endpoint ao vivo, então trate isto como fato, não como suposição:
prompt— string descrevendo o movimento (e o som, segenerate_audioestiver ativado).image_url— uma única URL pública. Não é um array como em alguns outros modelos i2v da plataforma — passar uma lista aqui falha.duration— inteiro, apenas4,6ou8segundos. Outros valores não são aceitos.resolution—"720p"ou"1080p".generate_audio— booleano. Ativa ou desativa o áudio nativo sincronizado.- O schema é estrito: enviar campos não reconhecidos faz a requisição ser rejeitada diretamente, em vez de ignorada silenciosamente.
Quanto custa de fato um clipe
O preço é calculado por segundo de saída e depende da resolução e de o áudio estar ativado (dados de setembro de 2026 — consulte a página de preços atualizada antes de orçamentos em grande escala):
720pcom áudio: $0.10/s — $0.40 por um clipe de 4 segundos.720psem áudio: $0.06/s — o mesmo clipe cai para $0.24.1080pcom áudio: $0.14/s.1080psem áudio: $0.10/s.
Para um calendário de conteúdo de formato curto, essa conta é a verdadeira alavanca: um lote de dez clipes de 4 segundos em 720p com áudio custa cerca de $4.00; o mesmo lote sem áudio custa $2.40. Se o design de som importa para a publicação (ruído ambiente de cafeteria, o clique tátil do produto, passos), mantenha o áudio ativado — é a diferença entre o clipe de demonstração e uma peça que parece ter sido filmada no local.
Se você precisa de mais de 8 segundos por clipe, ou de controle independente do movimento de câmera em durações maiores, o hiapi também oferece o veo-3.1-fast (maior fidelidade, a partir de $0.25/s) e o nível carro-chefe veo-3.1 (a partir de $0.57/s) — ambos suportam text-to-video e image-to-video. Para a maioria das edições de formato curto para redes sociais, porém, o lite é a escolha padrão correta: o custo é uma fração, e a saída já está ajustada para clipes verticais de até 10 segundos.
Para uma abordagem alternativa ao mesmo problema de formato curto — clipes mais longos, mais controle manual sobre o primeiro/último quadro — também fizemos as contas de montar um fluxo de trabalho de formato curto com seedance-2.0-mini, que troca áudio nativo a partir de foto por durações de até 15 segundos e uma tarifa por segundo mais baixa.
Perguntas frequentes
O veo-3.1-lite/image-to-video aceita múltiplas imagens de referência?
Não. image_url aceita apenas uma URL pública. Se você precisa de um modelo que combine várias imagens de referência, essa é outra chamada — antes de assumir que é igual a esta, consulte a própria página do modelo para conhecer seu schema de entrada exato.
É possível obter um clipe de mais de 8 segundos em uma única chamada?
No lite, não. O campo duration aceita apenas 4, 6 ou 8. Para vídeos únicos mais longos, veja outros modelos de vídeo na coleção de APIs de vídeo da plataforma, vários dos quais suportam durações acima de 15 segundos.
A saída já vem com áudio nativo, ou preciso adicionar som na pós-produção?
Se generate_audio for true, o MP4 retornado já vem com uma faixa de áudio AAC sincronizada — sem etapa separada de design de som. Se você pretende trilhar o clipe por conta própria ou não precisa de som ambiente, defina como false.
Preciso mesmo de um modelo de vídeo, ou a saída do gpt-image-2 já pode ser publicada?
Muitos feeds de formato curto misturam conteúdo estático e em movimento, então a imagem estática gerada por gpt-image-2/text-to-image já é uma boa publicação por si só. Image-to-video serve para quando a plataforma (ou o momento) exige movimento — detalhes do produto, comparações sutis de antes/depois, loops — sem precisar refilmar.
O que acontece se eu enviar um duration inválido (por exemplo, 5)?
A requisição é rejeitada antes de criar qualquer tarefa — você recebe imediatamente um erro de schema, em vez de desperdiçar uma renderização.
Pronto para experimentar? A página do modelo veo-3.1-lite/image-to-video tem um playground ao vivo onde você pode colocar sua própria foto e prompt antes de escrever qualquer linha de código.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores