
Bewertung
GPT Image 2 ausführlicher Test: Bildqualität, Text und Geschwindigkeit im Praxistest
Basierend auf drei kleinen Stichproben mit identischem Prompt von 2026-05, mit echten Vergleichsbildern sowie aktualisierten Angaben zu aktuellem Modell, Routing und Migration
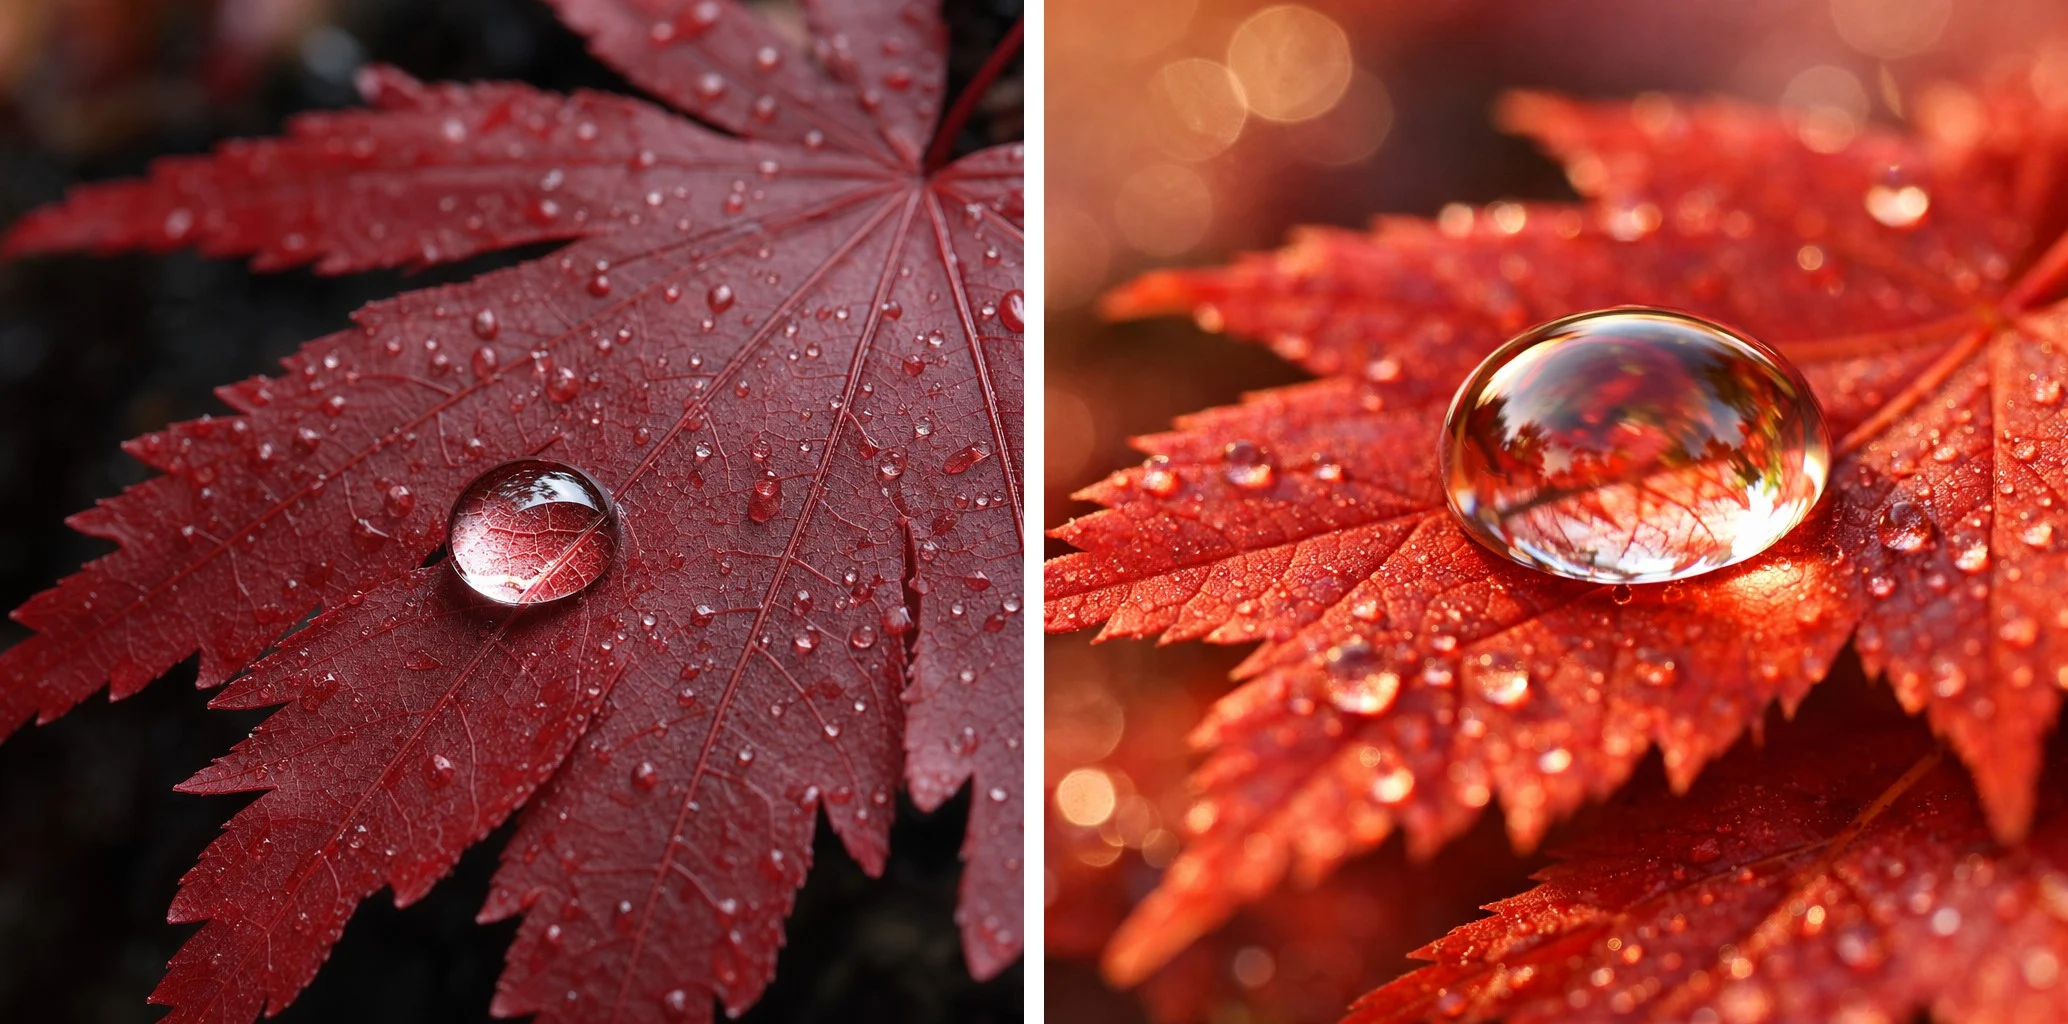
Dieser Review enthält die drei echten Vergleichstests, die im Mai 2026 auf HiAPI durchgeführt wurden. Pro Prompt und pro Modell wurde jeweils nur 1 Bild generiert; die folgenden Aussagen beziehen sich daher auf die damals in der Stichprobe beobachteten Ergebnisse und werden nicht zu einer langfristigen Garantie des Modells hochgeschrieben.
Zuerst das Fazit. In den drei Tests erfüllte GPT Image 2 die Aufgaben bei englischem Text, räumlichen Beziehungen und realistischen Details, wobei das Bild insgesamt realistischer und dunkler ausfiel. Es zeigten sich aber auch zwei Punkte, die Beachtung verdienen: Beim exakten Zählen war es nicht durchgehend besser als die Vorgängergeneration; die damals erfasste Generierungsdauer war deutlich länger. GPT Image 1.5 ist bereits außer Betrieb genommen; dieser Vergleich eignet sich heute dazu, Modellveränderungen zu verstehen und das Warteerlebnis zu bewerten, nicht mehr als Grundlage für die aktuelle Modellauswahl.
Veröffentlichungskontext und aktuelle Modellangaben
Die API-Modellseite von OpenAI listet den Snapshot gpt-image-2-2026-04-21 auf. Die aktuelle kanonische Modell-ID ist gpt-image-2; die offizielle Dokumentation beschreibt es als Bildmodell, das Bildgenerierung und -bearbeitung, flexible Größen und hochauflösende Bildeingaben unterstützt.
Hier muss zwischen Produktoberfläche und API-Vertrag unterschieden werden. Die /v1/tasks-Anfrage von HiAPI hat keinen thinking-Parameter; daher darf weder der Produktname noch ein Modus aus der Oberfläche direkt als HiAPI-Anfragefeld geschrieben werden, und die historische Dauer in diesem Artikel darf nicht mit einem nicht existierenden Feld erklärt werden.
Auf HiAPI lautet die aktuelle kanonische Text-zu-Bild-ID gpt-image-2/text-to-image und die kanonische Bild-zu-Bild-ID gpt-image-2/image-to-image. standard, beta und ext haben jeweils eigene Parameter- und Preisregeln; für aktuelle Anfragen sind die entsprechenden Docs maßgeblich.
Testbedingungen von 2026-05
Die ursprüngliche CMS-Aufzeichnung enthält Testdatum, Standardkonfiguration und Ergebnisbilder, aber keine Task-ID und kein vollständiges Request-Payload. Um keine nicht vorhandenen Belege zu ergänzen, verwendet diese Zusammenführung nur Informationen, die aus dem Originaltext und den Bildern überprüft werden können.
| Punkt | Damalige Aufzeichnung |
|---|---|
| Testzeitpunkt | 2026-05 |
| Plattform | HiAPI-Testkonto |
| Vergleichsobjekt | GPT Image 2 und GPT Image 1.5 |
| Routing | Damalige Standard-Text-zu-Bild-Route, beta oder ext nicht verwendet; entspricht nach aktueller Benennung der standard-Text-zu-Bild-Konfiguration |
| Stichprobengröße | Je 1 Bild pro Modell und Prompt |
| Parameter | Standardkonfiguration, keine zusätzliche Qualitätsstufe angegeben |
| Testdimensionen | Textwiedergabe, räumliche Anweisungen, realistische Details, Dauer pro Bild |
Die drei Prompts waren ein englisches Café-Poster, eine Leseecke mit klaren Positions- und Mengenvorgaben sowie eine Makroaufnahme von Wassertropfen auf rotem Ahornlaub. Im Folgenden bleiben die drei Vergleichsbilder aus dem ursprünglichen Review erhalten.
Drei echte Ausgaben
P1: Wiedergabe englischen Texts
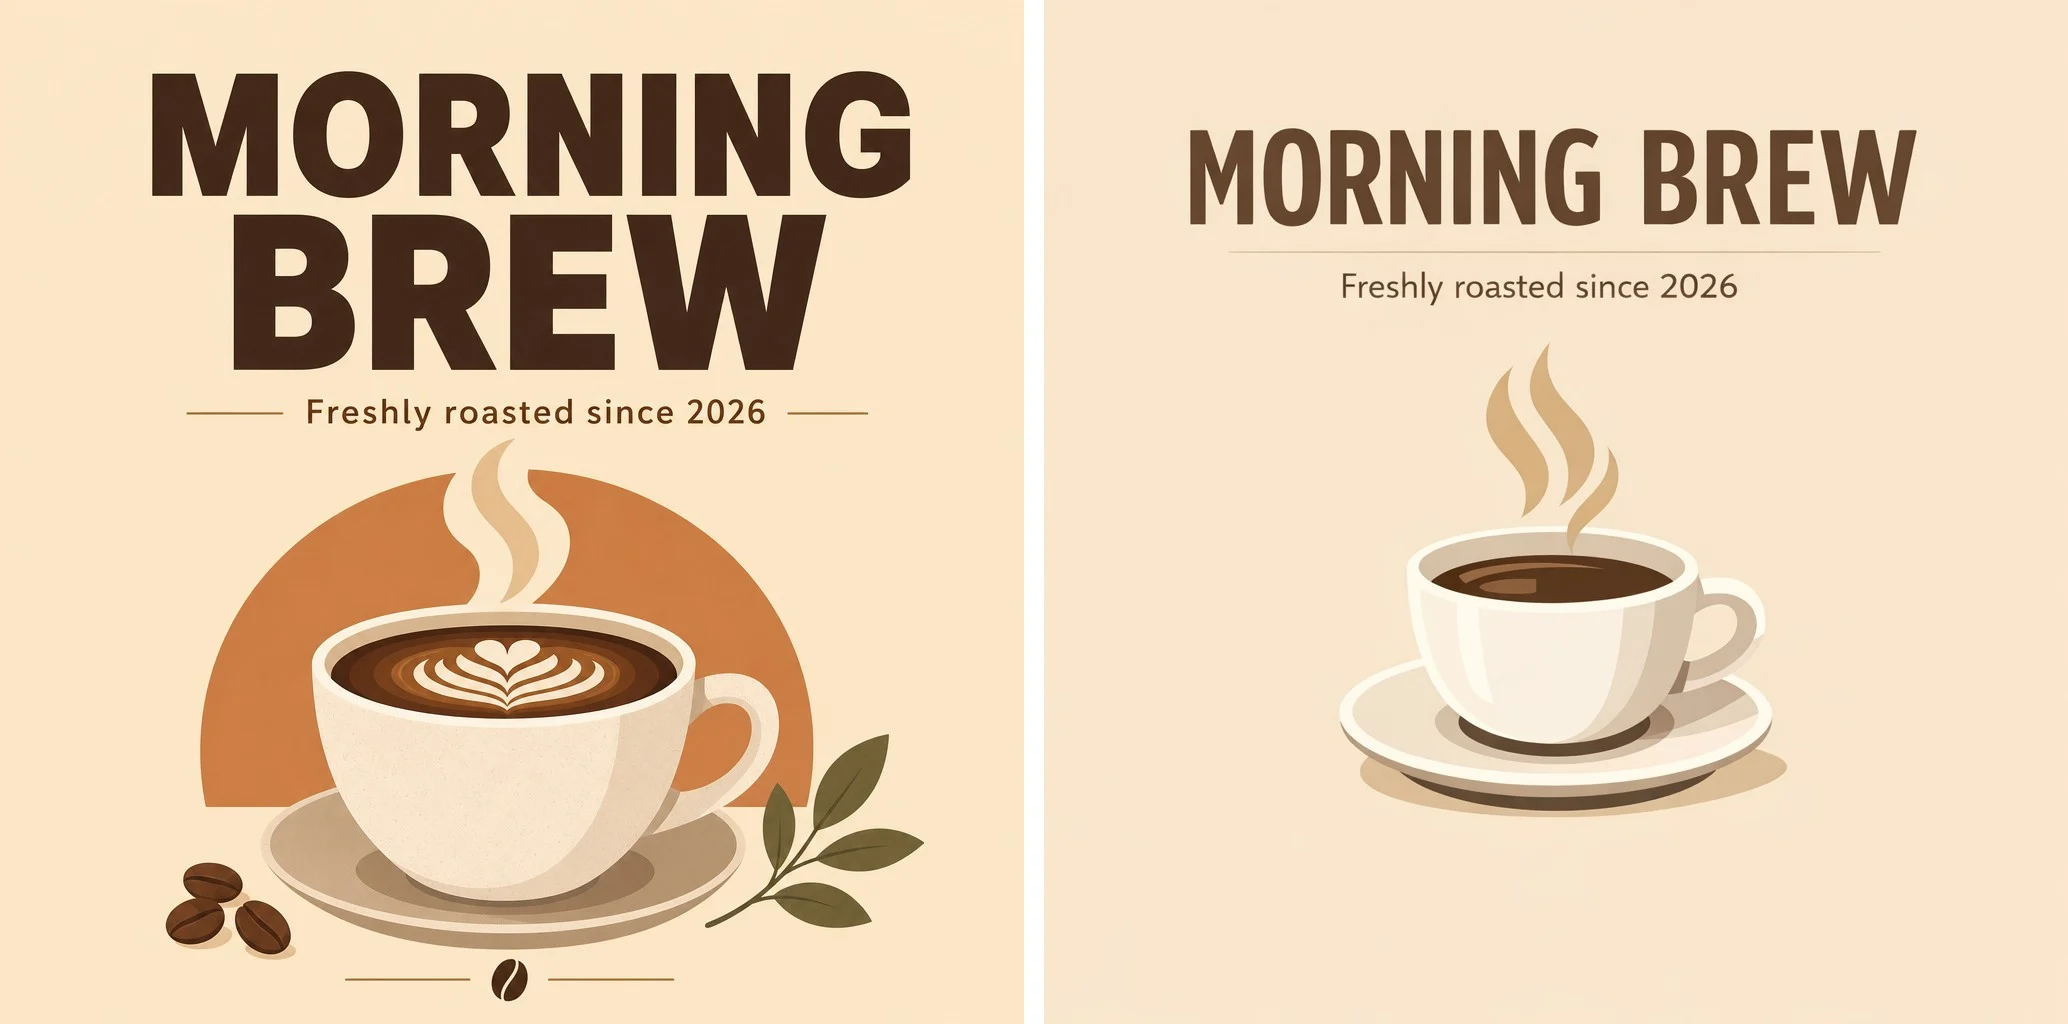
Der Prompt verlangte, dass das Poster den Titel „MORNING BREW“ und den Untertitel „Freshly roasted since 2026“ anzeigt. In dieser Gruppe stellten beide Seiten Titel und Untertitel korrekt dar, der Text war klar lesbar. Dieses Ergebnis zeigt, dass GPT Image 2 die kurze englische Textaufgabe in diesem Fall erfüllte, aber eine einzelne Stichprobe reicht weder für eine globale Genauigkeitsrate noch für die Aussage, dass es bei Text durchgehend besser als die Vorgängergeneration ist.
Wenn das Geschäft mehrsprachige Poster, Verpackungen oder Infografiken benötigt, sollte weiterhin mit echten Texten in größerem Umfang getestet und jedes Zeichen vor der Auslieferung geprüft werden.
P2: Räumliche Beziehungen und exaktes Zählen
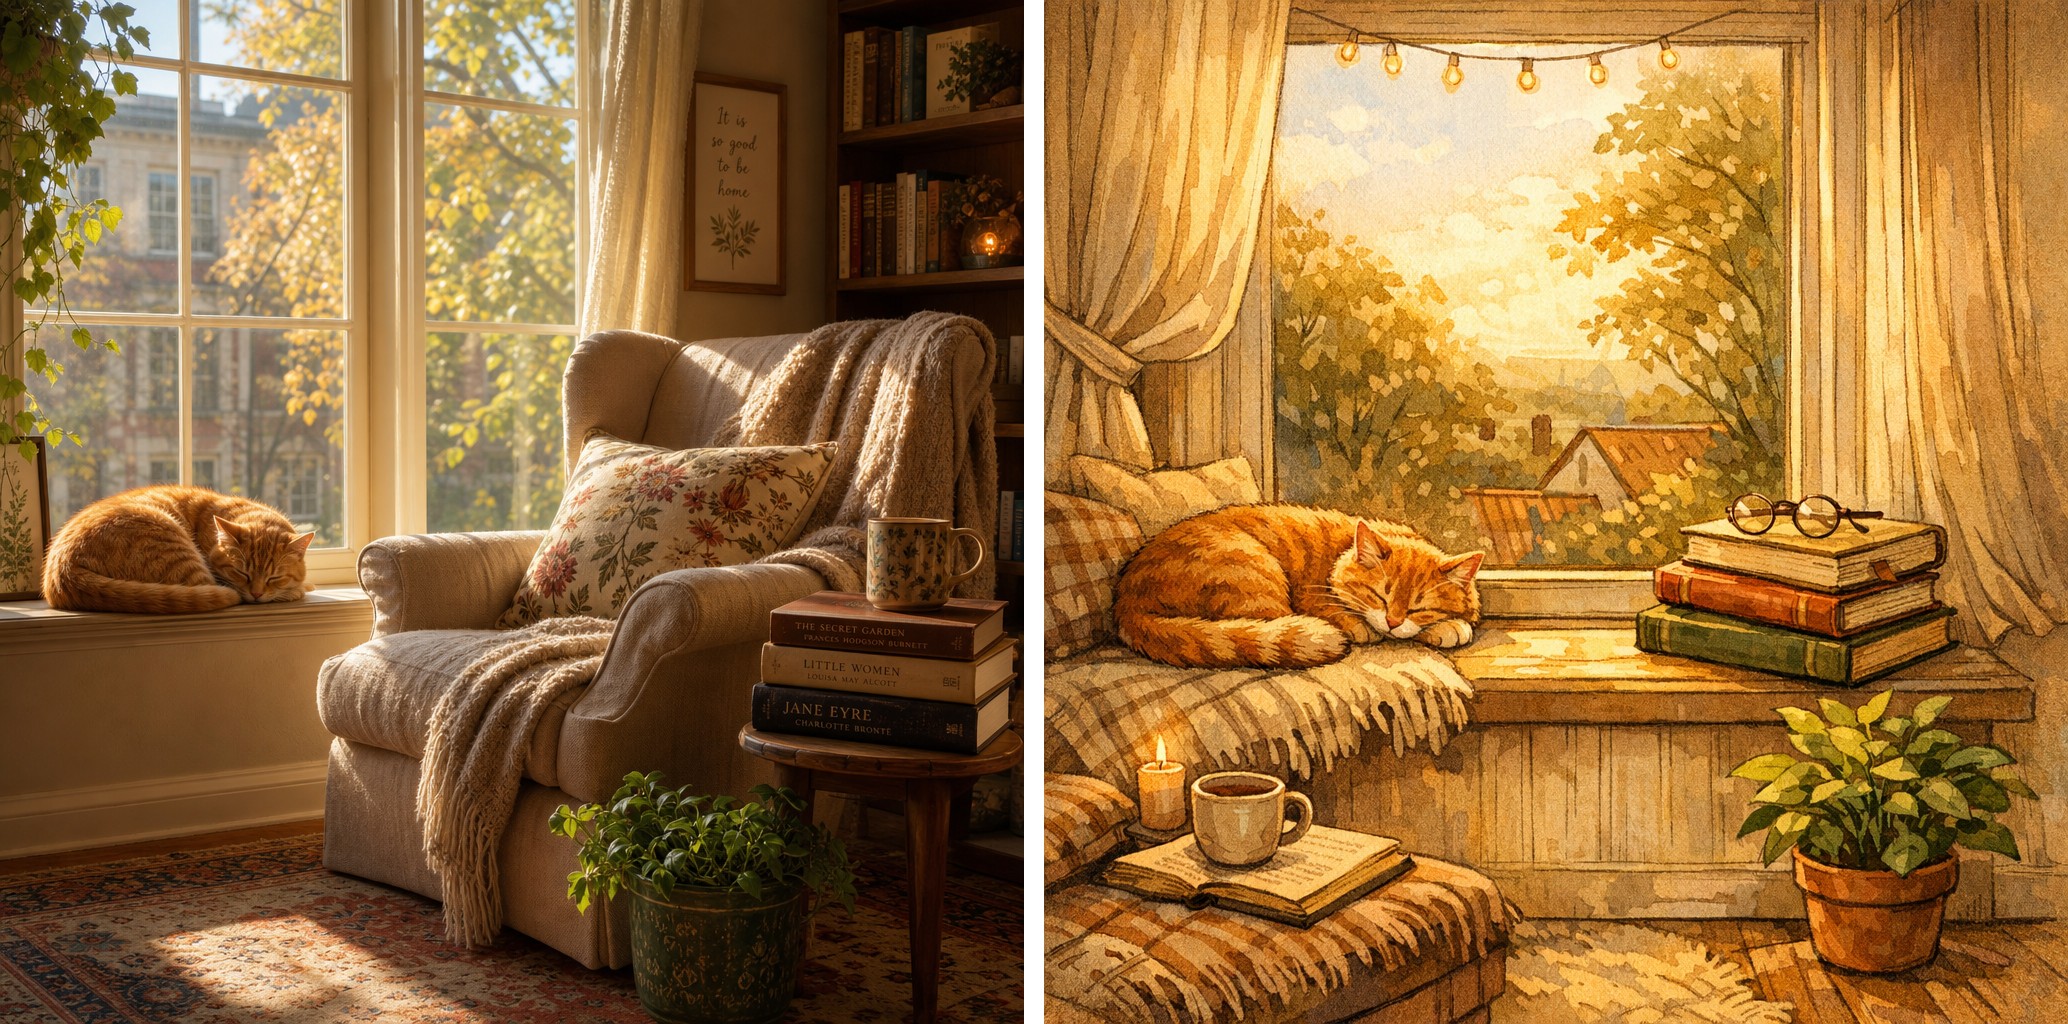
Der Prompt gab vor, dass die Katze auf der linken Fensterbank, drei Bücher auf der rechten Seite und eine Topfpflanze auf dem Boden stehen. Beide Modelle behielten die drei räumlichen Beziehungen bei. GPT Image 2 wirkte in diesem Bild wie realistische Fotografie, GPT Image 1.5 eher illustrativ und warmtonig.
Bei den Mengendetails waren die drei Bücher bei GPT Image 1.5 leichter zu zählen, während die Anzahl der Bücher bei GPT Image 2 unklarer war. Dieses Gegenbeispiel sollte erhalten bleiben: Die Erfüllung komplexer Anweisungen muss Punkt für Punkt geprüft werden; die Gesamtbildwirkung eines Modells ersetzt nicht die Abnahme von Anzahl, Text und Position.
P3: Realistische Details und Lichtstimmung
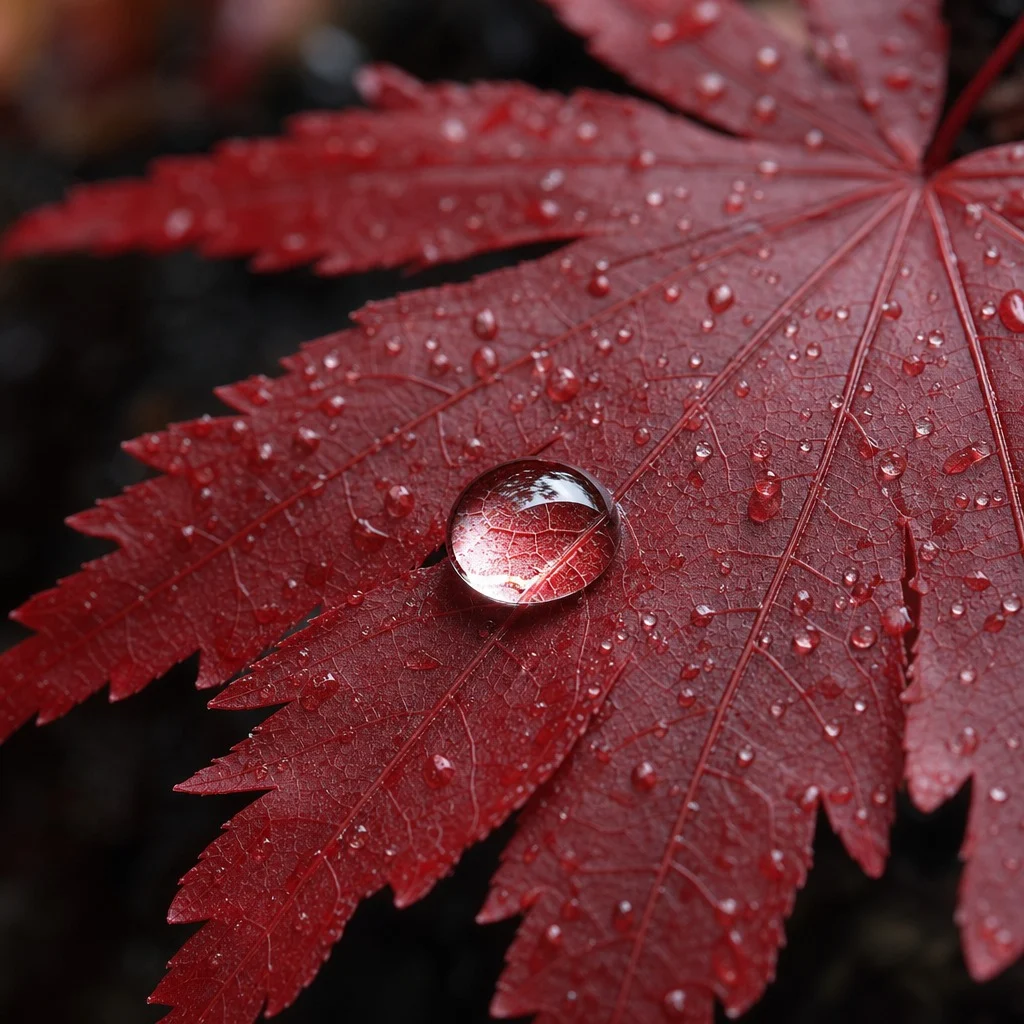
Beide Bilder zeigten Lichtbrechung in den Wassertropfen und Blattstrukturen. GPT Image 2 war in diesem Bild dunkler und kontrastreicher, GPT Image 1.5 wärmer und heller. Eine einzelne Stichprobe kann nur belegen, dass beide Seiten diese Makroaufgabe erfüllten, und trägt keine Schlussfolgerung wie „überlegene Bildqualität“ oder einen festen Stil.
Bei der aktuellen Bewertung von GPT Image 2 empfiehlt es sich, auf der GPT-Image-2-Modellseite mit den eigenen Geschäfts-Prompts erneut zu testen und dabei Subjektkonsistenz, exakten Text, Anzahl, Komposition und Wartezeit gemeinsam zu erfassen.
Wie die historischen Geschwindigkeitsdaten zu verstehen sind
Die im ursprünglichen Review erfassten Zeiten pro Bild sind wie folgt.
| Modell | Aufzeichnung pro Bild 2026-05 |
|---|---|
| GPT Image 2 | ca. 107 Sekunden |
| GPT Image 1.5 | ca. 18–36 Sekunden |
Dies ist der deutlichste historische Unterschied in diesem Artikel und zugleich der am leichtesten falsch verwendbare. Die Stichprobengröße beträgt nur 1 Bild pro Prompt, die ursprüngliche Aufzeichnung enthält keine Task-ID, keinen Warteschlangenstatus und keine vollständigen Request-Parameter; außerdem ändern sich Plattform-Routen und Last später. Daher eignen sich die 107 Sekunden als Hinweis, im Produktdesign asynchrones Warten und Statusfeedback vorzusehen, nicht als aktuelle Durchschnittsdauer oder SLA.
Die Task-Schnittstelle von HiAPI ist selbst asynchron. Eine Produktoberfläche sollte den Task-Status anzeigen, nach Erfolg das Ergebnis aus data.output[] lesen und es vor expireAt herunterladen oder auslagern. Für aktuelle Implementierungsdetails sind die Docs zu Text-zu-Bild und Bild-zu-Bild maßgeblich.
Migrationsentscheidung nach dem Ende von 1.5
GPT Image 1.5 wurde im Juni 2026 aus HiAPI außer Betrieb genommen; Empfehlungen der alten Seite wie „für die Live-Vorschau weiterhin 1.5 wählen“ sind damit ungültig. Es dient in diesem Artikel nur noch als historischer Vergleich von 2026-05 und erscheint nicht mehr in aktuellen Empfehlungen oder CTAs.
Die im alten Artikel erfassten $0.05/Bild sind eine damalige Preis-Momentaufnahme ohne Angaben zu route, resolution und quality und sollten nicht zur Berechnung heutiger Preisunterschiede verwendet werden. Bei der Preisprüfung am 31. August 2026 kosteten bei HiAPI standard Text-zu-Bild und Bild-zu-Bild für 1K, 2K und 4K jeweils $0.03, $0.04 und $0.06; beta Text-zu-Bild kostete $0.02; ext wird nach Kombination aus quality und resolution berechnet, wobei ext Bild-zu-Bild zusätzlich einen dynamischen Posten für Referenzbilder enthält. Für die Budgetplanung siehe aktuelle Routenpreise und Kostenbeispiele für GPT Image 2; maßgeblich ist stets das Echtzeit-Pricing.
Neue Projekte können die aktuelle Route nach Bedarf wählen. Für Text-zu-Bild beginnt man mit den Parametern und Request-Beispielen für GPT Image 2 Text-zu-Bild; wenn Bearbeitung mit Referenzbild benötigt wird, siehe Felder und Referenzbildregeln für GPT Image 2 Bild-zu-Bild. Falls alter Code noch 1.5 oder frühe Aliase verwendet, sollte zuerst anhand der Modellhistorie und Migrationszuordnung im englischen GPT Image API Hub der Modellname bereinigt und anschließend ein Regressionstest durchgeführt werden.
FAQ
Dauert die Generierung eines Bildes mit GPT Image 2 aktuell noch etwa 107 Sekunden?
Das lässt sich nicht so ableiten. Die 107 Sekunden stammen aus einer kleinen historischen Stichprobe von 2026-05, und es fehlen Belege, um damalige Warteschlange und Parameter zu reproduzieren. Bitte auf der aktuellen Route mit Geschäfts-Prompts P50, P95 und Fehler-/Wiederholungsfälle neu messen.
Unterstützt GPT Image 2 auf HiAPI den Thinking Mode?
Das aktuelle /v1/tasks-Schema von HiAPI hat kein Feld thinking. Images with thinking ist eine Funktion des ChatGPT-Produkts und sollte nicht als HiAPI-Task-Parameter geschrieben werden.
Unterstützt GPT Image 2 Bild-zu-Bild?
Ja. standard Bild-zu-Bild verwendet gpt-image-2/image-to-image und input_urls; ext verwendet dasselbe Basismodell mit dem Top-Level-Feld route: "ext" und dem Referenzbildfeld image_urls. Beide Routen akzeptieren derzeit 1–6 Referenzbilder; die genauen Beschränkungen sind in den Docs zu Bild-zu-Bild maßgeblich.
Kann man direkt einen transparenten Hintergrund anfordern?
Die OpenAI Images API bietet die Vorschau von background: "transparent" an; die Ausgabe muss PNG oder WebP verwenden. Das aktuelle GPT-Image-2-Task-Schema von HiAPI stellt background nicht bereit; daher kann dieses Feld in einer HiAPI-Anfrage nicht direkt übergeben werden.
Fazit
Die drei echten Bilder haben weiterhin Referenzwert. GPT Image 2 erfüllte in diesem Test die Aufgaben zu englischem Text, räumlichen Beziehungen und Makrodetails, wobei das Bild eher realistisch und dunkler ausfiel; exaktes Zählen und die historische Wartezeit erinnern daran, dass Abnahme und asynchrones Erlebnis weiterhin separat gestaltet werden müssen.
Die aktuelle Integrationsentscheidung ist klar: Geschäftsstichproben mit der aktuellen GPT-Image-2-Route erneut validieren, Anfragen gemäß den entsprechenden Docs senden und das Budget anhand des Echtzeit-Pricings planen. GPT Image 1.5 bleibt nur als historischer Vergleich erhalten und ist keine aufrufbare Option mehr.
Ähnliche Artikel
Alle Artikel ansehen →-
Bewertung
Der fotorealistischste KI-Bildgenerator: 4 Modelle im direkten Praxistest
Wir haben denselben Prompt für ein fotorealistisches Porträt an Seedream 5.0 Pro, Nano Banana 2, Qwen Image 3.0 Pro und FLUX.2 übergeben, um zu sehen, welches Modell Haut, Licht und Details wirklich richtig hinbekommt – und was jedes Bild tatsächlich kostet.
-
Bewertung
gpt-image-2-pro auf hiapi: Preise, Qualitätsstufen und wie man das neue Bildmodell aufruft
Zwei neue Pro-Einträge sind auf hiapi verfügbar – Text-zu-Bild für 0,35 $, Bild-zu-Bild für 0,42 $ –, maßgeschneidert für jene kleine Kategorie von Aufgaben, bei denen „ein schlechtes Rendering mehr kostet als zehn gute“.
-
Bewertung
GPT Image 2 Testbericht: Eine ehrliche Erfahrung aus der Praxis
Was überzeugt, was nicht – und welche Rolle es in deinem Workflow tatsächlich spielen sollte