
Avaliação
Análise aprofundada do GPT Image 2: qualidade de imagem, texto e velocidade na prática
Com base em três pequenos conjuntos de amostras com o mesmo prompt em 2026-05, mantendo as imagens de comparação reais, e atualizando o modelo atual, o roteamento e os critérios de migração
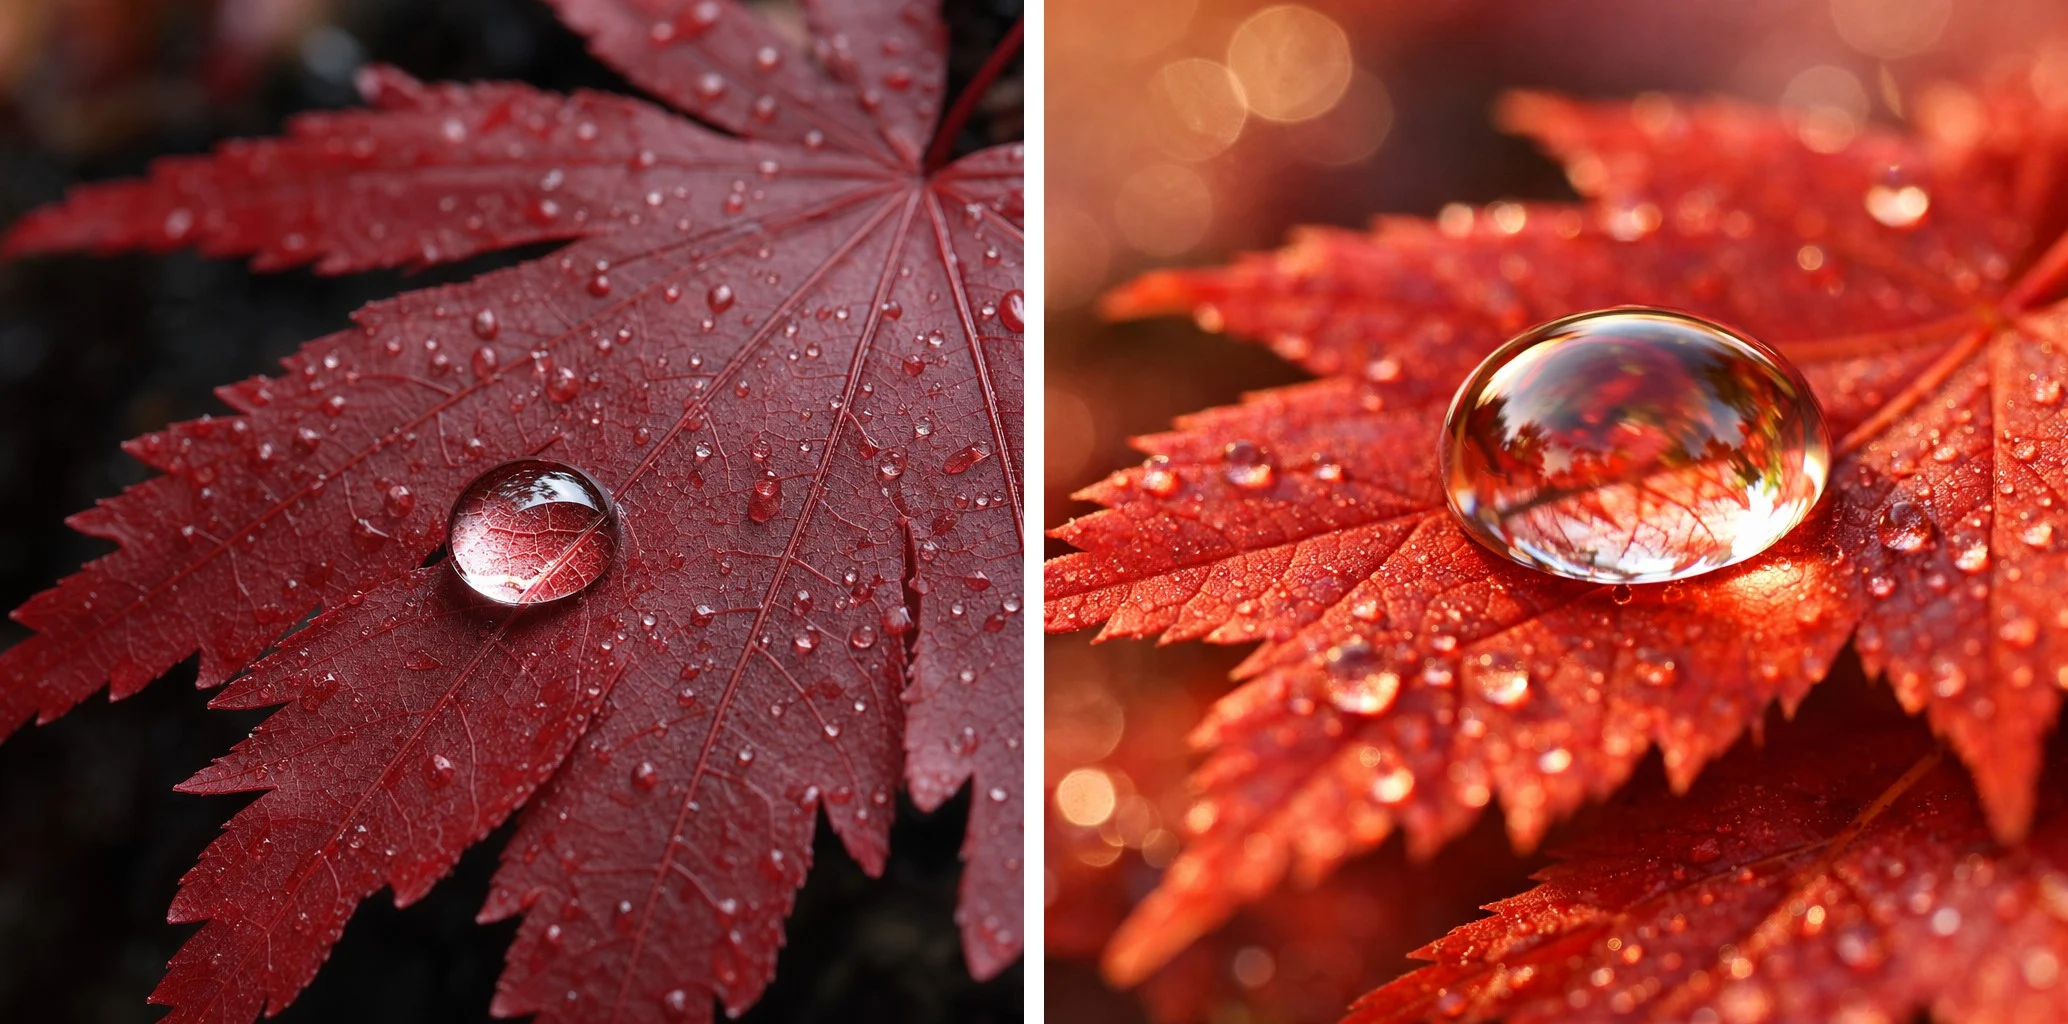
Esta análise preserva os três testes comparativos reais realizados na HiAPI em maio de 2026. Cada prompt e cada modelo gerou apenas 1 imagem, portanto o que se discute abaixo é o desempenho observado naquelas amostras, sem extrapolar para uma garantia de longo prazo do modelo.
Primeiro, a conclusão. Nos três testes, o GPT Image 2 cumpriu as tarefas de texto em inglês, relações espaciais e detalhes realistas, com a imagem mais inclinada ao realismo e ao tom escuro. Também revelou dois pontos de atenção: a contagem precisa não superou de forma consistente a geração anterior; e o tempo de geração registrado na época foi visivelmente maior. O GPT Image 1.5 já foi descontinuado, então esta comparação agora serve para entender a evolução do modelo e avaliar a experiência de espera, não mais para fins de seleção atual.
Contexto de lançamento e critérios do modelo atual
A página de modelos da API da OpenAI lista o snapshot gpt-image-2-2026-04-21. O ID de modelo canônico atual é gpt-image-2, descrito pela documentação oficial como um modelo de imagem com suporte a geração e edição de imagens, tamanhos flexíveis e entrada de imagens de alta fidelidade.
É preciso distinguir a interface do produto do contrato da API. A requisição /v1/tasks da HiAPI não possui o parâmetro thinking, portanto não se pode escrever diretamente o nome do produto ou o modo da interface como campo de requisição da HiAPI, nem usar um campo inexistente para explicar o tempo histórico deste artigo.
Na HiAPI, o ID canônico atual de texto para imagem é gpt-image-2/text-to-image, e o de imagem para imagem é gpt-image-2/image-to-image. standard, beta e ext têm cada um suas próprias regras de parâmetros e preços; as requisições atuais devem seguir a documentação correspondente.
Condições do teste de 2026-05
O registro original do CMS preservou a data do teste, a configuração padrão e as imagens de resultado, mas não preservou task ID nem o payload completo da requisição. Para não inventar evidências inexistentes, esta consolidação usa apenas informações verificáveis a partir do texto original e das imagens.
| Item | Registro da época |
|---|---|
| Data do teste | 2026-05 |
| Plataforma | Conta de teste HiAPI |
| Objetos de comparação | GPT Image 2 e GPT Image 1.5 |
| Rota | Rota padrão de texto para imagem da época, sem uso de beta ou ext; pela nomenclatura atual, corresponde ao critério standard de texto para imagem |
| Tamanho da amostra | 1 imagem por modelo e por prompt |
| Parâmetros | Configuração padrão, sem especificação de nível de qualidade adicional |
| Dimensões do teste | Renderização de texto, instruções espaciais, detalhes realistas, tempo por imagem |
Os três prompts foram, respectivamente, um pôster em inglês de cafeteria, um canto de leitura com restrições explícitas de posição e quantidade, e uma macro de gotas de água em folha de bordo vermelha. Abaixo são mantidas as três imagens de comparação originais da análise principal.
Três saídas reais
P1: renderização de texto em inglês
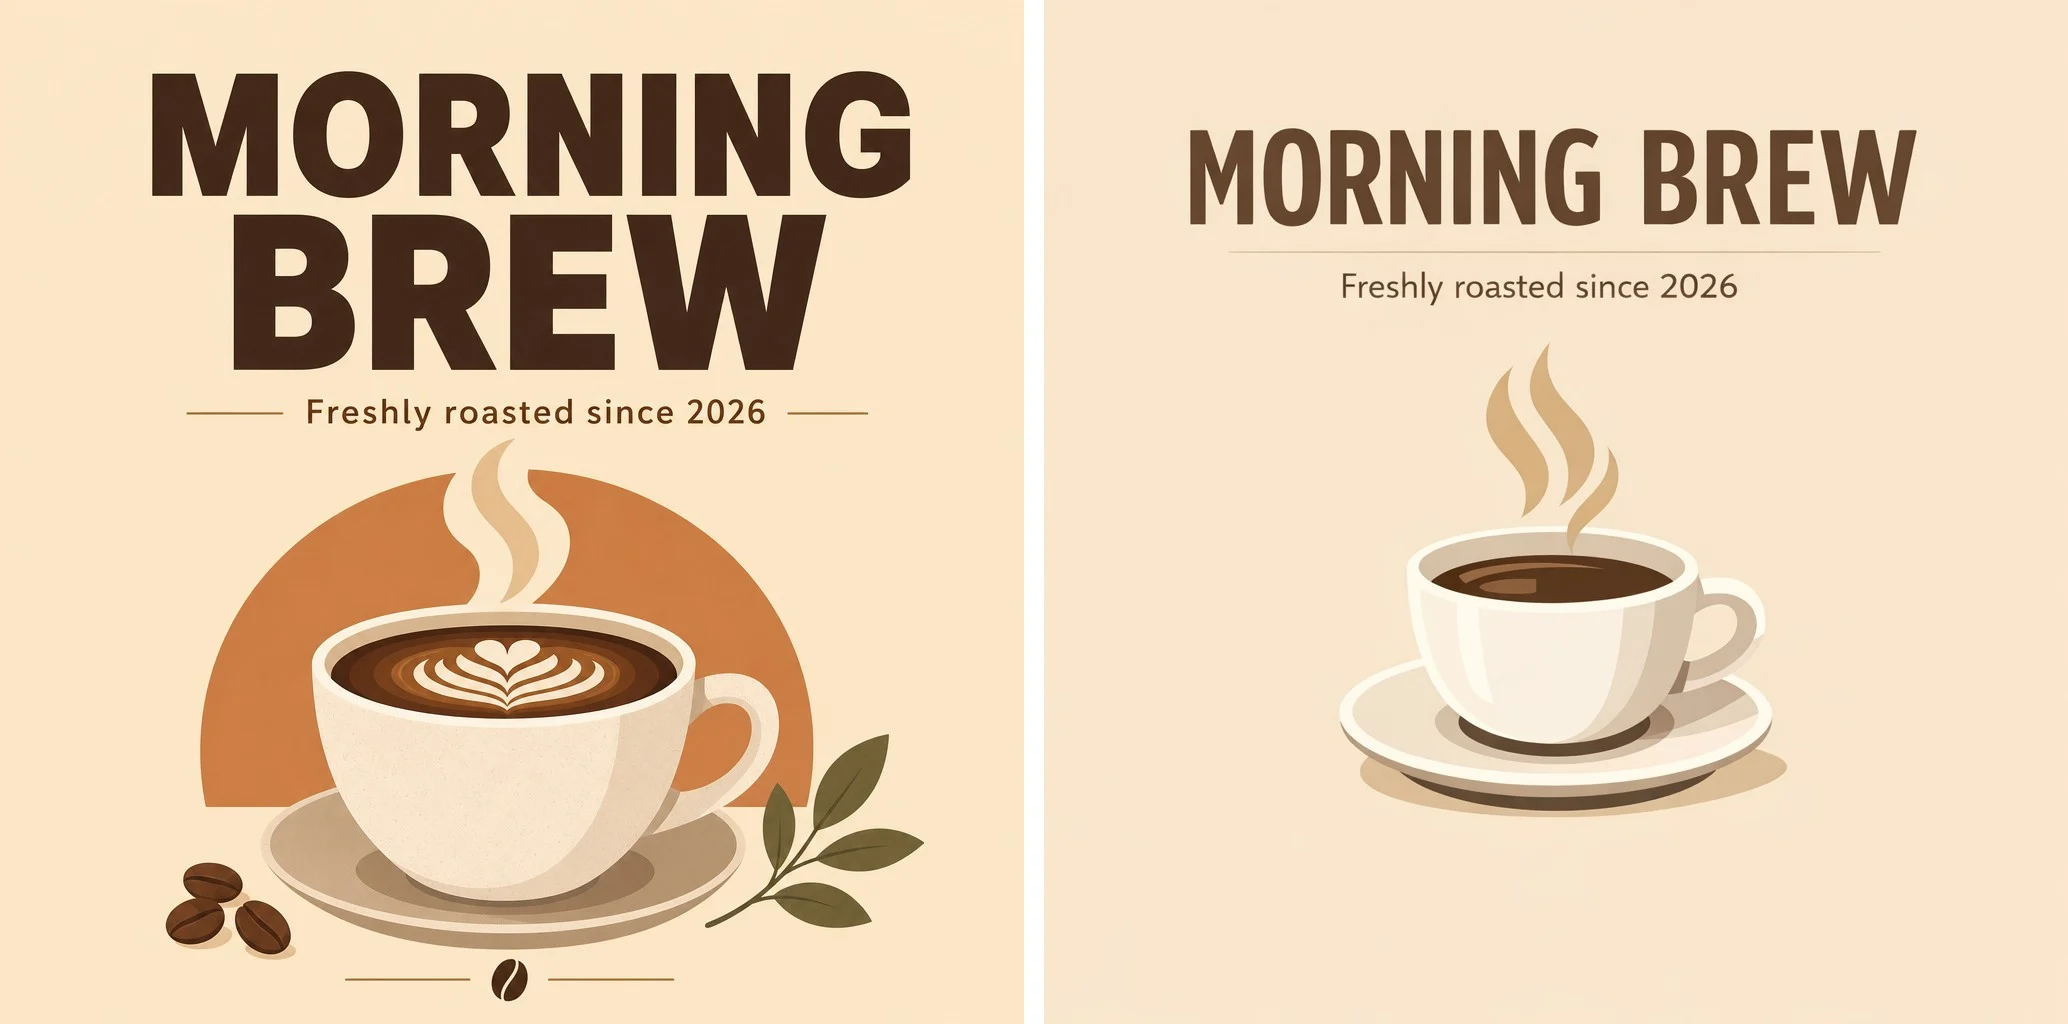
O prompt pedia que o pôster exibisse o título "MORNING BREW" e o subtítulo "Freshly roasted since 2026". Neste conjunto, ambos apresentaram corretamente o título e o subtítulo, com texto nítido e legível. Esse resultado mostra que o GPT Image 2 cumpriu esta tarefa de texto curto em inglês, mas uma única amostra não basta para inferir precisão global nem para afirmar que ele lidera de forma consistente a geração anterior em texto.
Se o negócio exigir pôsteres multilíngues, embalagens ou infográficos, ainda é necessário testar em lote com textos reais e revisar cada caractere antes da entrega.
P2: relações espaciais e contagem precisa
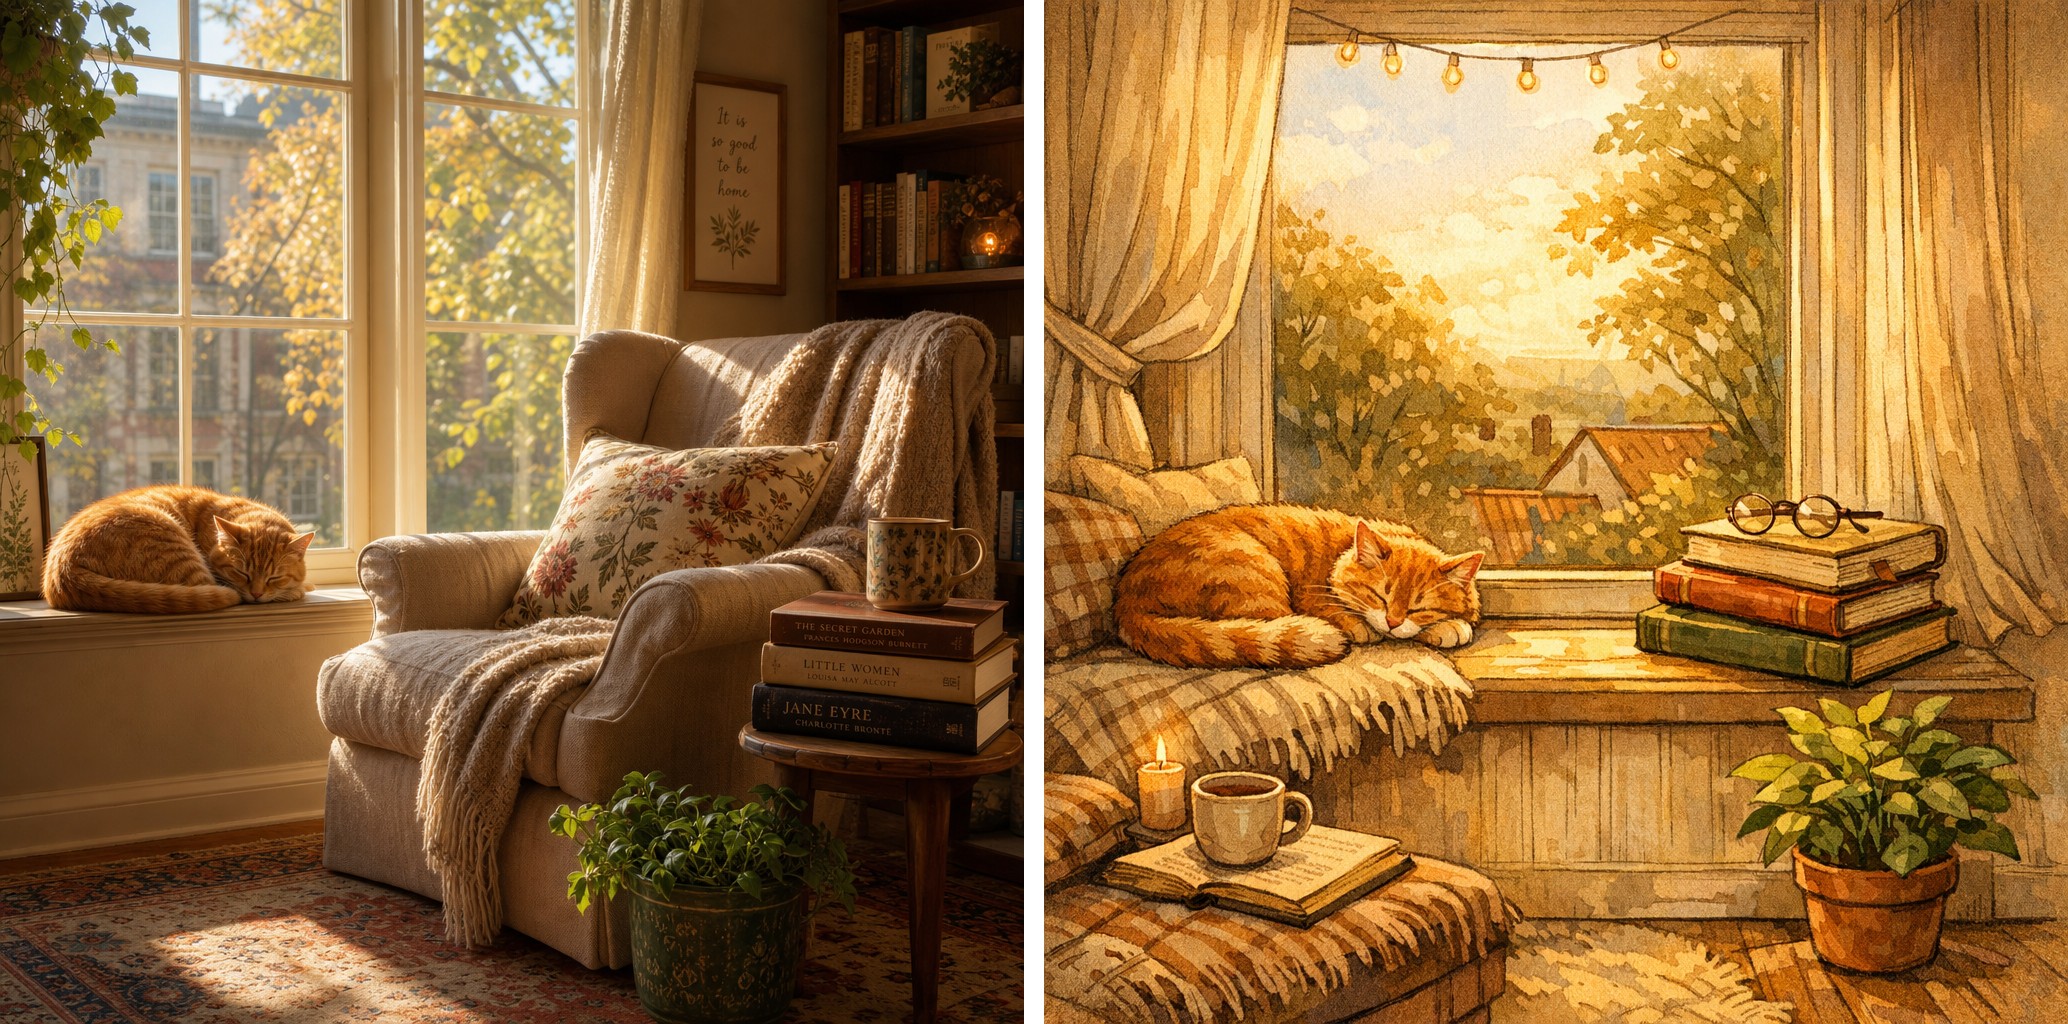
O prompt especificava um gato no parapeito à esquerda, três livros à direita e um vaso de planta no chão. Ambos os modelos preservaram as três relações espaciais. O GPT Image 2 nesta imagem apresentou tom de fotografia realista, enquanto o GPT Image 1.5 ficou mais ilustrativo e quente.
No detalhe de quantidade, os três livros do GPT Image 1.5 são mais fáceis de contar; a pilha de livros do GPT Image 2 é mais ambígua. Esse contraexemplo merece ser preservado: a completude de instruções complexas precisa ser verificada item a item, e a qualidade geral do modelo não substitui a validação de quantidade, texto e posição.
P3: detalhes realistas e iluminação
Ambas as imagens apresentaram refração das gotas de água e textura da folha. O GPT Image 2 nesta imagem ficou mais escuro e com contraste mais forte; o GPT Image 1.5 ficou mais quente e mais claro. Uma única amostra só indica que ambos cumpriram esta tarefa de macro, não sustenta conclusões de "qualidade esmagadora" nem de estilo fixo.
Ao avaliar o GPT Image 2 atualmente, recomenda-se retestar na página do modelo GPT Image 2 com seus próprios prompts de negócio, registrando em conjunto a consistência do sujeito, o texto preciso, a quantidade, a composição e o tempo de espera.
Como interpretar os dados históricos de velocidade
Os tempos por imagem registrados na análise original são os seguintes.
| Modelo | Registro por imagem em 2026-05 |
|---|---|
| GPT Image 2 | cerca de 107 segundos |
| GPT Image 1.5 | cerca de 18–36 segundos |
Esta é a diferença histórica mais clara deste artigo e também a mais fácil de usar equivocadamente. O tamanho da amostra é de apenas 1 imagem por prompt, o registro original não tem task ID, estado da fila nem parâmetros completos da requisição; as rotas e a carga da plataforma também mudam depois. Portanto, os 107 segundos servem para lembrar o design de produto a reservar espera assíncrona e feedback de estado, não como tempo médio atual ou SLA.
A interface de tarefas da HiAPI é assíncrona por natureza. A interface de produção deve exibir o estado da tarefa, ler o produto em data.output[] após o sucesso e baixar ou transferir antes de expireAt. Os detalhes de implementação atuais seguem a documentação de texto para imagem e imagem para imagem.
Decisão de migração após a descontinuação do 1.5
O GPT Image 1.5 foi descontinuado da HiAPI em junho de 2026, e recomendações antigas como "continue escolhendo 1.5 para pré-visualização em tempo real" já não são válidas. Neste artigo ele aparece apenas como comparação histórica de 2026-05, não mais em recomendações atuais ou CTAs.
O $0.05/imagem registrado no artigo antigo é um snapshot de preço da época, sem detalhes de route, resolution e quality, e não deve ser usado para calcular a diferença de preço de hoje. Na verificação de preços de 31 de agosto de 2026, o standard de texto para imagem e imagem para imagem da HiAPI custa, para 1K, 2K e 4K, respectivamente $0.03, $0.04 e $0.06; o beta de texto para imagem custa $0.02; o ext é cobrado pela combinação de quality e resolution, e o ext de imagem para imagem ainda inclui um item dinâmico de imagem de referência. Para orçamento, consulte preços atuais das rotas do GPT Image 2 e exemplos de custo, e use o Pricing em tempo real como base final.
Novos projetos podem escolher a rota atual conforme a necessidade. Para texto para imagem, comece por parâmetros e exemplo de requisição de texto para imagem do GPT Image 2; para edição com imagem de referência, veja campos de imagem para imagem do GPT Image 2 e regras de imagem de referência. Se o código antigo ainda usa 1.5 ou aliases iniciais, primeiro consulte o histórico de modelos e mapeamento de migração do GPT Image API Hub em inglês para limpar os nomes de modelo e depois faça testes de regressão.
FAQ
O GPT Image 2 ainda leva cerca de 107 segundos para gerar uma imagem atualmente?
Não se pode inferir isso. Os 107 segundos vêm de um registro histórico de pequena amostra de 2026-05, sem evidências suficientes para reproduzir a fila e os parâmetros da época. Meça novamente P50, P95 e falhas com retry na rota atual usando prompts de negócio.
O GPT Image 2 da HiAPI suporta Thinking Mode?
O schema atual de /v1/tasks da HiAPI não possui o campo thinking. Images with thinking é uma capacidade do produto ChatGPT e não deve ser escrita como parâmetro de tarefa da HiAPI.
O GPT Image 2 suporta imagem para imagem?
Sim. O standard de imagem para imagem usa gpt-image-2/image-to-image e input_urls; o ext usa o mesmo model base com route: "ext" no nível superior e o campo de imagem de referência image_urls. Ambas as rotas aceitam atualmente de 1 a 6 imagens de referência; os limites específicos seguem a documentação de imagem para imagem.
É possível solicitar fundo transparente diretamente?
A OpenAI Images API já oferece a pré-visualização de background: "transparent", e a saída precisa usar PNG ou WebP. O schema atual de tarefa do GPT Image 2 da HiAPI não expõe background, portanto não é possível passar esse campo diretamente em requisições da HiAPI.
Conclusão
As três imagens reais ainda têm valor de referência. O GPT Image 2 cumpriu neste teste as tarefas de texto em inglês, relações espaciais e detalhes macro, com imagens mais realistas e escuras; a contagem precisa e o tempo de espera histórico lembram que a validação de entrega e a experiência assíncrona ainda precisam de design próprio.
A decisão de integração atual já está clara: revalidar amostras de negócio com a rota atual do GPT Image 2, enviar requisições conforme a documentação correspondente e fazer orçamento com o Pricing em tempo real. O GPT Image 1.5 fica apenas como comparação histórica, não mais como opção chamável.
Artigos relacionados
Ver todos os artigos →-
Avaliação
Os geradores de imagem por IA mais realistas: comparação prática frente a frente de 4 modelos
Enviamos o mesmo prompt de retrato fotorrealista para Seedream 5.0 Pro, Nano Banana 2, Qwen Image 3.0 Pro e FLUX.2 para ver qual deles realmente acerta pele, luz e detalhes — e quanto custa cada imagem.
-
Avaliação
gpt-image-2-pro no hiapi: preços, níveis de qualidade e como chamar o novo modelo de imagem
Duas novas entradas Pro no hiapi — texto para imagem a $0,35, imagem para imagem a $0,42 — criadas para aquela pequena fração de tarefas em que "o custo de uma renderização ruim é maior que o de dez renderizações boas".
-
Avaliação
Avaliação do GPT Image 2: uma experiência sincera após o uso
O que se sustenta, o que não se sustenta e qual papel ele realmente deve desempenhar no seu fluxo de trabalho