
Avaliação
gpt-image-2-pro no hiapi: preços, níveis de qualidade e como chamar o novo modelo de imagem
Duas novas entradas Pro no hiapi — texto para imagem a $0,35, imagem para imagem a $0,42 — criadas para aquela pequena fração de tarefas em que "o custo de uma renderização ruim é maior que o de dez renderizações boas".
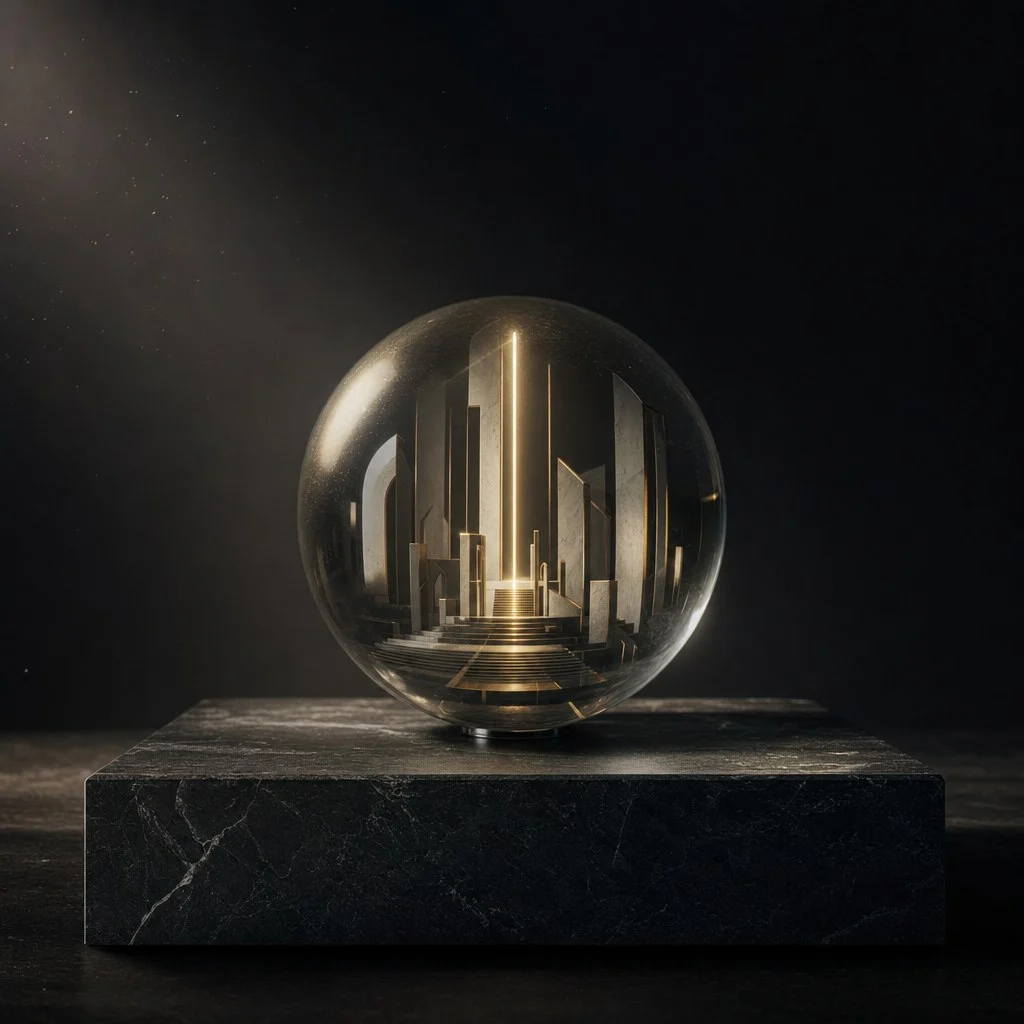
Com a atualização do endpoint /api/pricing do hiapi neste mês, duas novas entradas subiram ao topo da lista de modelos de imagem: gpt-image-2-pro e gpt-image-2-image-to-image-pro. Ambas trazem o selo roxo "Pro", ambas ficam fixadas no topo do seletor de modelos e ambas custam mais de dez vezes o valor de uma chamada padrão ao gpt-image-2. Então a pergunta óbvia é: afinal, pelo que você está pagando?
Este artigo explica uma a uma o que são as variantes Pro, como é a matriz de preços em tempo real e como chamá-las pela API de tarefas unificada do hiapi. Se você está em dúvida se vale pagar $0,35 a mais por frame no seu pipeline atual, aqui está a conta que você precisa fazer.
O que "Pro" significa na página de preços
As duas novas entradas se descrevem nos dados oficiais de preços como "nível de alta qualidade e estabilidade" — um nível que prioriza a estabilidade, construído para execuções em produção que precisam de taxa de sucesso e latência previsíveis, e não apenas de um bom desempenho médio.
Essa formulação importa mais do que parece. O gpt-image-2 padrão a $0,03 por chamada é perfeito para exploração, difusão em lote e qualquer cenário em que "algumas imagens ruins entre cem não importam, porque regenerar é barato". A variante Pro é o que você escolhe quando o custo de uma única imagem falha supera o de gastar dez dólares a mais em computação — uma renderização de marketing agendada que precisa sair impecável de primeira, um criativo pago cuja próxima tentativa perderia a janela de lançamento, um key visual que está travando o lançamento.
A variante imagem para imagem Pro tem uma capacidade adicional: aceita de uma a cinco imagens de referência além do prompt e, em seguida, as edita, compõe ou transfere estilo. A mesma promessa de estabilidade, o mesmo nível Pro, apenas com formato de entrada diferente.
Matriz de preços em tempo real
Confirmado em relação à página de preços em tempo real no momento da escrita — essa página é a única fonte da verdade, e os números abaixo foram retirados diretamente dela:
| Modelo | 1K (nível 1024) | 2K | Observações |
|---|---|---|---|
gpt-image-2 (padrão, texto para imagem) |
$0,03 | $0,04 | Nível de exploração; também oferece 4K |
gpt-image-2-pro (texto para imagem) |
$0,35 | $0,70 | Nível de estabilidade, fixado em 1º lugar |
gpt-image-2-image-to-image-pro |
$0,40 | $0,80 | 1–5 imagens de referência, edição / composição |
Algumas leituras práticas:
- O Pro custa cerca de 12–14 vezes o padrão em 1K e 17–21 vezes em 2K. É uma diferença orçamentária concreta. Se você não consegue explicar por que essa imagem específica precisa do Pro, provavelmente precisa da versão padrão.
- 2K é um multiplicador limpo de 2 vezes para o Pro. Diferentemente de alguns fornecedores de imagem que aplicam sobretaxas decrescentes para alta resolução, a variante Pro simplesmente dobra o preço, o que facilita a previsão.
- Imagem para imagem custa cerca de 14% mais que texto para imagem nos dois níveis ($0,40 contra $0,35 em 1K; $0,80 contra $0,70 em 2K). Você paga pelo processamento das imagens de referência extras.
Para comparação, o gpt-image-2 padrão segue um formato diferente: 1K = $0,03, 2K = $0,04 (multiplicador de 1,33 vezes), 4K = $0,06 (multiplicador de 2 vezes). A variante padrão oferece o nível 4K; a variante Pro chega no máximo a 2K por enquanto, mas com fidelidade por pixel bem maior. Se você precisa da resolução nativa, o 4K padrão continua sendo o caminho mais barato para uma tela grande; se você precisa de qualidade consistente de nível de produção, o Pro 2K é a escolha.
Quando o Pro vale a pena
O nível Pro é uma aposta em estabilidade, não um botão mágico de qualidade de imagem. Os cenários em que ele se paga têm todos o mesmo formato: a regeneração é cara e o custo de uma renderização fracassada é assimétrico.
Vale pagar pelo Pro quando:
- A imagem será entregue em uma interface voltada ao cliente e passará por revisão antes do próximo lote (anúncios pagos, e-mails de marketing, kits de mídia, visuais principais de loja).
- Você precisa manter a consistência de personagem ou produto em um pequeno conjunto de renderizações e não pode se dar ao luxo de nenhum frame variar.
- Você tem um SLA de estabilidade pelo qual responder — uma tarefa agendada que precisa produzir imagens utilizáveis dentro de uma janela de tempo conhecida.
- O pipeline posterior é caro: revisão humana, aprovação de marca, retoque manual. Gastar um pouco mais por imagem na entrada sai mais barato do que deixar uma renderização ruim seguir pela cadeia.
Continue com a versão padrão quando:
- Você está fazendo difusão em larga escala (50, 500, 5000 imagens) e pontuando e filtrando as saídas.
- Você está explorando prompts, não entregando-os. Usar o Pro em rascunhos é desperdício de dinheiro.
- A imagem vive em uma interface não crítica (preenchimento do corpo de um blog, slides internos, material de teste de desenvolvimento), em que regenerar é só um clique.
A faixa de aplicação da variante imagem para imagem Pro é mais estreita: ela quase sempre é a escolha certa quando você tem um material de referência que importa para a marca — uma foto de produto, uma ficha de personagem aprovada pelo designer, um moodboard de campanha — e precisa de uma edição que não destrua os destaques do material de referência. Pagar $0,40 para manter a iluminação de um ensaio de produto de $4.000 consistente em doze variações é uma conta óbvia.
Chamando os modelos a partir do hiapi
As duas variantes Pro usam a API de tarefas unificada do hiapi: POST /v1/tasks cria uma tarefa e retorna o ID da tarefa, GET /v1/tasks/:id informa o status e, em caso de sucesso, retorna URLs de imagens para download em output[]. Você passa o prompt em input (e, para imagem para imagem, também de uma a cinco URLs de imagens de referência).
Texto para imagem Pro
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2-pro",
    "input": {
        "prompt": "A pristine editorial magazine cover composition: a single "
                  "matte glass sphere resting on a polished dark slate plinth, "
                  "refracted interior architecture, studio key light, fine-grain "
                  "film texture, premium dark fashion-magazine aesthetic.",
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("hero.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Para gerar em 2K, defina "resolution": "2K" (e escolha a proporção de tela que o seu material exige). O motor de cobrança aplica a multiplicação de forma limpa — uma chamada, $0,70.
Imagem para imagem Pro
A variante imagem para imagem aceita de uma a cinco URLs de imagens de referência no array input_urls. As imagens de referência são URLs hospedadas — se a sua imagem está no disco, envie-a para um local acessível (armazenamento de objetos, seu CDN) e passe o link.
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2-image-to-image-pro",
    "input": {
        "prompt": "Restyle the product photo into a vintage Polaroid look: "
                  "warm tones, soft vignetting, retain product silhouette and "
                  "logo placement exactly. Magazine-grade output.",
        "input_urls": ["https://your-cdn.example.com/reference-product.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("restyled.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Dois pontos que vale conhecer para tráfego em produção:
- Uma renderização Pro leva de 60 a 120 segundos de ponta a ponta. O fluxo assíncrono significa que nenhuma conexão fica ocupada durante a espera — faça polling a cada poucos segundos ou defina
callback.urlno momento da criação para que o hiapi notifique seu servidor no estado terminal. - Se você chama a partir de um worker serverless na ponta, persista o
taskIdpara que um poller ou callback busque o resultado — não mantenha uma chamada aberta durante toda a geração Pro.
Um padrão prático de roteamento
Para equipes que já rodam o gpt-image-2 a $0,03, a forma mais limpa de adotar o Pro é manter o nível padrão como default e rotear para o Pro apenas uma parte marcada das tarefas. Um padrão mínimo:
def pick_model(job):
    if job.get("tier") == "hero" or job.get("brand_critical"):
        return "gpt-image-2-pro"
    if job.get("reference_image"):
        return "gpt-image-2-image-to-image-pro" \
            if job.get("brand_critical") else "gpt-image-2/image-to-image"
    return "gpt-image-2/text-to-image"
Marque as tarefas no momento do envio (um campo, um booleano) e sua conta permanece previsível. As variantes Pro passam, então, a funcionar como ferramentas de precisão em vez de opção padrão — exatamente o formato para o qual foram projetadas.
Versão resumida
gpt-image-2-pro e gpt-image-2-image-to-image-pro não são "um gpt-image-2 melhor". São entradas de nível de estabilidade da mesma família de modelos — criadas para aquela pequena fração de tarefas em que "o custo de uma renderização ruim é maior que o de dez renderizações boas". O padrão a $0,03 continua vencendo em exploração e processamento em lote. O Pro a $0,35 (ou $0,40 com imagem de referência) é o que você escolhe quando a imagem em si é a entrega, não um rascunho.
Confirme os números em tempo real na página de preços, marque as tarefas que realmente precisam de estabilidade e roteie de acordo. Os dois modelos respondem em POST /v1/tasks — o mesmo formato de tarefa que o seu worker atual de gpt-image-2 já usa.
Artigos relacionados
Ver todos os artigos →-
Avaliação
Os geradores de imagem por IA mais realistas: comparação prática frente a frente de 4 modelos
Enviamos o mesmo prompt de retrato fotorrealista para Seedream 5.0 Pro, Nano Banana 2, Qwen Image 3.0 Pro e FLUX.2 para ver qual deles realmente acerta pele, luz e detalhes — e quanto custa cada imagem.
-
Avaliação
Avaliação do GPT Image 2: uma experiência sincera após o uso
O que se sustenta, o que não se sustenta e qual papel ele realmente deve desempenhar no seu fluxo de trabalho
-
Avaliação
Análise aprofundada do GPT Image 2: qualidade de imagem, texto e velocidade na prática
Com base em três pequenos conjuntos de amostras com o mesmo prompt em 2026-05, mantendo as imagens de comparação reais, e atualizando o modelo atual, o roteamento e os critérios de migração