
Benutzerhandbuch
Grok Imagine 1.5 Bild-zu-Video-Prompt-Rezepte: direkt kopierbare Prompts und echte Ergebnisse
Vier in der Praxis verifizierte Bewegungs-Prompts für grok-imagine-1.5/image-to-video@preview – jeder mit seinem Ausgangsstandbild und dem Clip, den er auf der Live-API tatsächlich erzeugt hat.
Zusammenfassung
- Was das ist: Vier direkt kopierbare Bewegungs-Prompts für grok-imagine-1.5/image-to-video, jeder mit seinem Ausgangsstandbild und dem Clip, den er auf der Live-API tatsächlich erzeugt hat – die erste Ausgabe roh präsentiert, ohne versteckte Wiederholungsversuche, dauerhaft hier gehostet.
- Das Eine, das du über dieses Modell wissen musst: Die API hat überhaupt keine Bewegungs- oder Kameraparameter. Das Eingabe-Schema (live verifiziert) enthält nur
prompt+image_urlssowie optionalduration,resolutionundaspect_ratio. Alle Kamerabewegungen, Bewegungsstile und Tempovorgaben entstehen im Prompt-Text – genau dafür sind diese Rezepte da. - Schema-Fakten (gegen die Live-Task-API am 07.07.2026 verifiziert):
image_urlsist ein erforderliches Array mit öffentlich zugänglichen Bild-URLs;durationist eine Ganzzahl von 1 bis 15 Sekunden;resolutionist 480p oder 720p;aspect_ratioakzeptiertauto,1:1,16:9,9:16,3:2,2:3. Jeder andere Parameter (motion_mode,seedusw.) wird mit 400 abgelehnt. - Preise (pro Sekunde Ausgabe, laut Preisseite): 480p kostet $0,015/Sekunde, 720p kostet $0,0282/Sekunde. Die Dauer ist der einzige Multiplikator – ein 6-Sekunden-720p-Clip kostet etwa $0,17, ein 4-Sekunden-480p-Test kostet $0,06.
- Gesamtrechnung der Medien in diesem Artikel: Vier gpt-image-2-Standbilder zu je $0,03 plus 22 Sekunden 720p-Video – zu aktuellen Preisen insgesamt etwa $0,74. Das ist der Sinn von Bild-zu-Video: Das Standbild ist eine einmalige Ausgabe, die du beliebig oft neu animieren kannst.
Wie diese Rezepte entstanden sind
Jedes Rezept besteht aus drei Teilen: dem Ausgangsstandbild, dem exakten Bewegungs-Prompt (einfach unverändert kopieren) und dem Clip, den er erzeugt hat. Jedes Standbild habe ich mit gpt-image-2 erzeugt, jeden Bewegungs-Prompt selbst geschrieben und jeden über die Live-Task-API von hiapi auf grok-imagine-1.5 ausgeführt. Bei jeder Beschreibung stehen die Einstellungen und die tatsächlichen Kosten, damit du exakt denselben Aufruf reproduzieren kannst.
Da grok-imagine-1.5 keine Bewegungsparameter akzeptiert, leistet die Formulierung des Prompts die ganze Arbeit. Bewährte Gewohnheiten:
- Mit einem Kameraverb beginnen. „Slow steady dolly push-in“, „camera glides slowly to the left“ – stell es an den Anfang, und das Modell behandelt es als Rückgrat des Clips.
- Eine einzige durchgehende Bewegung verlangen und „no cuts“ erklären. Ohne Vorgabe erfindet das Modell manchmal eigene Schnitte. Der Zusatz „one continuous shot, no cuts“ am Prompt-Ende unterdrückt das zuverlässig.
- Beschreiben, was sich fortlaufend bewegt, nicht nur die Kamera. Dampf, Regen, Spiegelungen, Menschenmenge – wenn du Umgebungsbewegung benennst, bleibt das Bild lebendig, statt wie ein Schwenk über ein Foto zu wirken.
- Bei Personen Mikrobewegung verlangen und die Kamera fixieren. „Camera locked off on a tripod … facial features stay perfectly stable, no warping“ ist der Unterschied zwischen einem lebendigen Porträt und einem zerlaufenden Gesicht.
Rezept 1 – Kamerasprache: langsamer Push-in
Ziel: Eine klassische filmische Dolly-Fahrt die Straße entlang, die auf dem Essensstand landet, während Regen, Dampf und Spiegelungen weiterarbeiten.
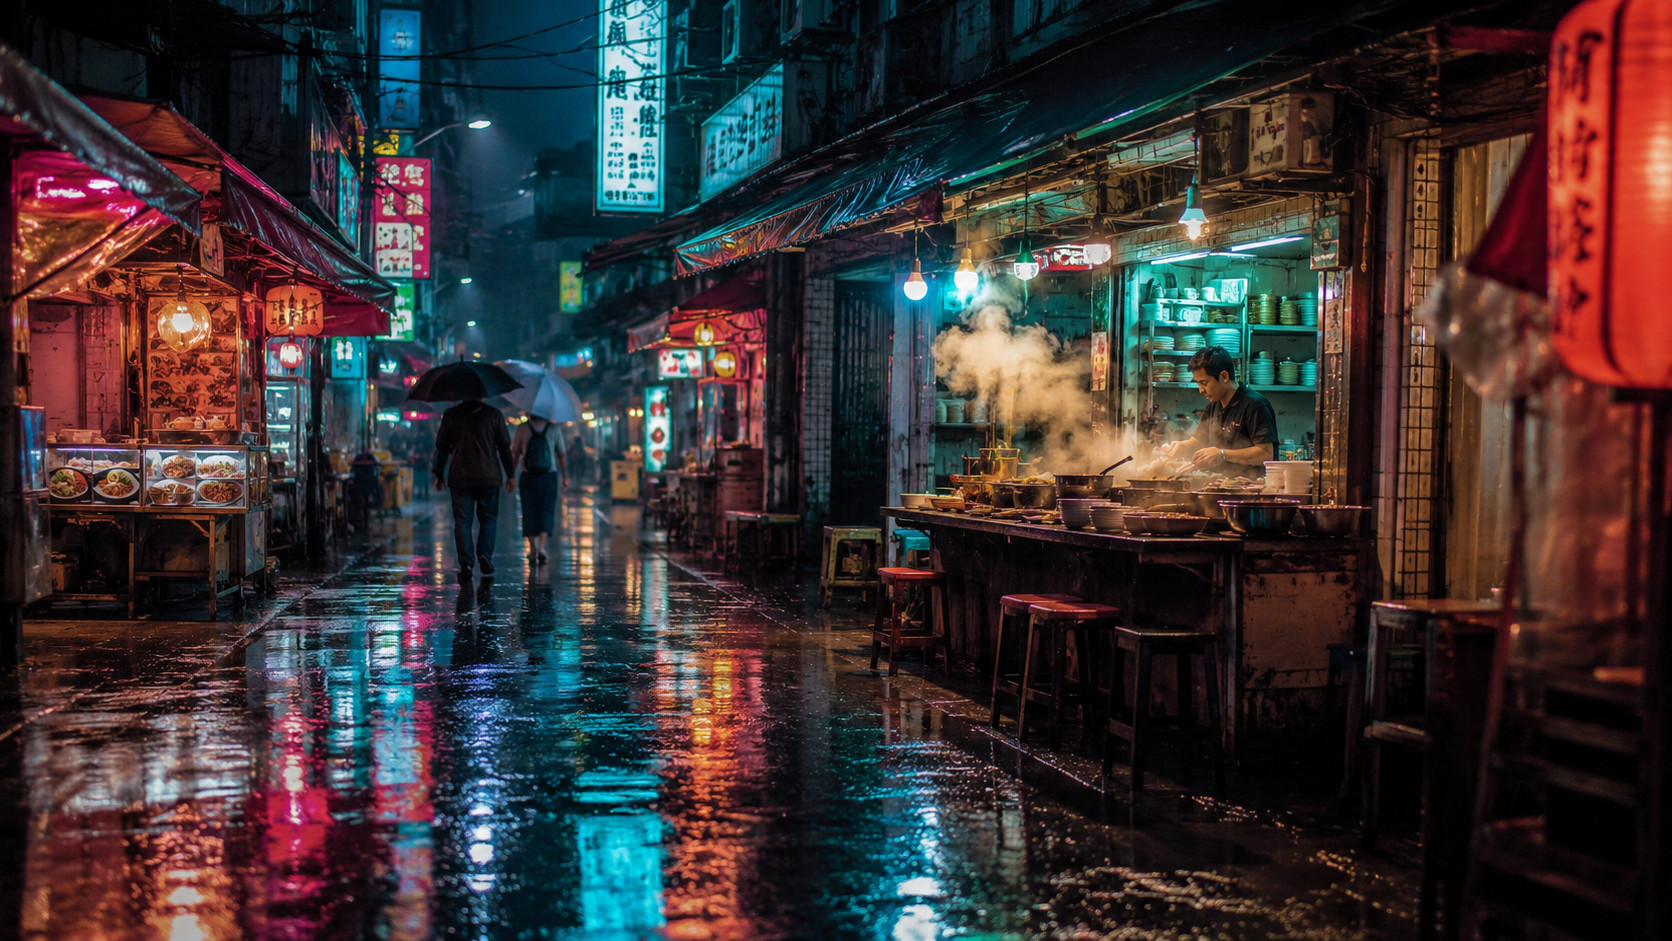
Ausgangsstandbild (gpt-image-2, 16:9, $0,03). Rezept 1 und 2 animieren beide dasselbe Bild.
Slow steady dolly push-in down the rain-soaked market street toward the glowing noodle stall, steam rising and curling from the pots, rain falling in thin streaks, neon sign reflections shimmering on the wet pavement, pedestrians walking slowly away under umbrellas, smooth constant camera speed, one continuous shot, no cuts, cinematic pacing
Langsame Dolly-Fahrt zum Nudelstand – grok-imagine-1.5/image-to-video, 6 Sekunden @ 720p, 16:9, $0,17 zu aktuellen Preisen. Echtes Ergebnis, für diese Anleitung erzeugt.
Warum es funktioniert: Der Push-in steht im ersten Teilsatz, also hält das Modell über die gesamten sechs Sekunden daran fest. Anschließend gibt der Prompt ihm eine Liste dessen, was sich fortlaufend bewegen muss – Dampf, Regenstreifen, Spiegelungen, Passanten – und genau das lässt die Aufnahme wie ein Video wirken statt wie ein Zoom auf ein Standbild. Achte darauf, wie nah der Koch und die Töpfe im letzten Frame sind: Das ist eine echte Kamerabewegung, kein Ausschnitt.
Rezept 2 – Dasselbe Standbild, anderes Kameraverb: laterale Mitfahrt
Ziel: Das exakt gleiche Standbild mit einer seitlichen Mitfahrbewegung neu animieren, um zu zeigen, dass die Kamerasprache in grok-imagine-1.5 vollständig im Prompt liegt – ein anderes Verb, eine andere Aufnahme.
Camera glides slowly to the left in a smooth lateral tracking move, strong parallax between the near market stalls and the far end of the street, rain keeps falling, neon reflections slide across the wet ground, the cook keeps stirring behind the counter, steam drifts sideways, one continuous move, no cuts, no zoom
Laterale Mitfahrbewegung quer über die Marktstraße – grok-imagine-1.5/image-to-video, 6 Sekunden @ 720p, 16:9, $0,17 zu aktuellen Preisen. Echtes Ergebnis, für diese Anleitung erzeugt.
Warum es funktioniert: „glides slowly to the left“ zusammen mit der ausdrücklichen Forderung nach Parallaxe zwischen den nahen Ständen und dem fernen Straßenende liefert dem Modell die Tiefenhinweise, die es animieren kann. Das ist zugleich die günstigste Art zu iterieren: Das Standbild ist eine versunkene Ausgabe von $0,03, sodass jede neue Kameravariante nur die Videosekunden kostet – hier beide Varianten zusammen etwa $0,34. Wenn du einen Look erkundest, ändere zuerst den Prompt für dasselbe Bild und denke erst dann über ein neues Bild nach.
Rezept 3 – Subjektgetriebene Bewegung: Porträt-Mikrobewegung (9:16)
Ziel: Ein vertikales, social-taugliches Porträt, bei dem die Person atmet und blinzelt, ihr Haar und ihr Schal sich bewegen – und sonst nichts.
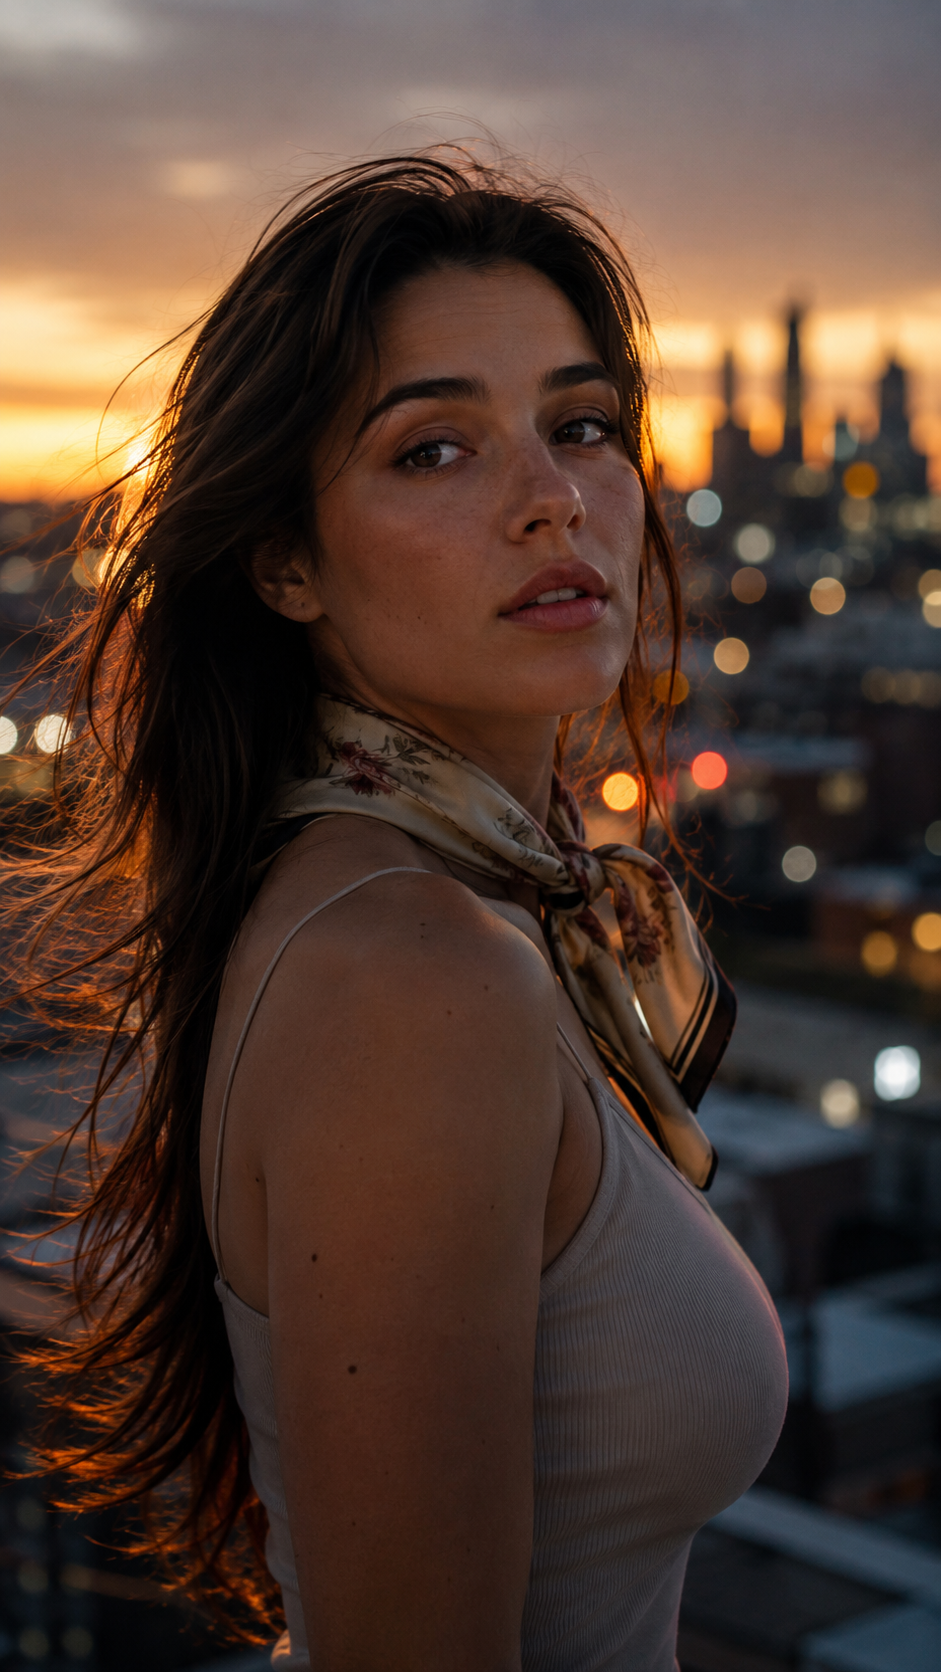
Ausgangsstandbild (gpt-image-2, 9:16, $0,03).
Gentle micro-motion only: her hair lifts and drifts in a soft evening breeze, the silk scarf ripples lightly, she blinks naturally and takes one calm slow breath, city bokeh lights flicker softly behind her, camera locked off on a tripod, facial features stay perfectly stable, no warping, subtle photoreal motion
Porträt-Mikrobewegung: Haar, Schal, Atem – grok-imagine-1.5/image-to-video, 6 Sekunden @ 720p, 9:16, $0,17 zu aktuellen Preisen. Echtes Ergebnis, für diese Anleitung erzeugt.
Warum es funktioniert: Porträts sind genau die Stelle, an der Bild-zu-Video-Modelle Gesichter zerlaufen lassen, deshalb verwendet der Prompt die meisten Wörter auf Einschränkungen: „micro-motion only“, „camera locked off“, „facial features stay perfectly stable, no warping“. Das Bewegungspudget geht an sichere, wirkungsvolle Elemente – Haar, Seide, Blinzeln, Atem. In 9:16 für den Feed aufgenommen; das Seitenverhältnis ist ein eigenes API-Feld, kein Ausschnitt.
Rezept 4 – Umgebungsatmosphäre: Die Szene sich selbst bewegen lassen
Ziel: Eine natürliche Endlosschleife mit fester Kamera, bei der alle Bewegung aus der Szene selbst kommt – Wellen, Nebel und der vorbeistreichende Leuchtturmstrahl. Vier Sekunden genügen.
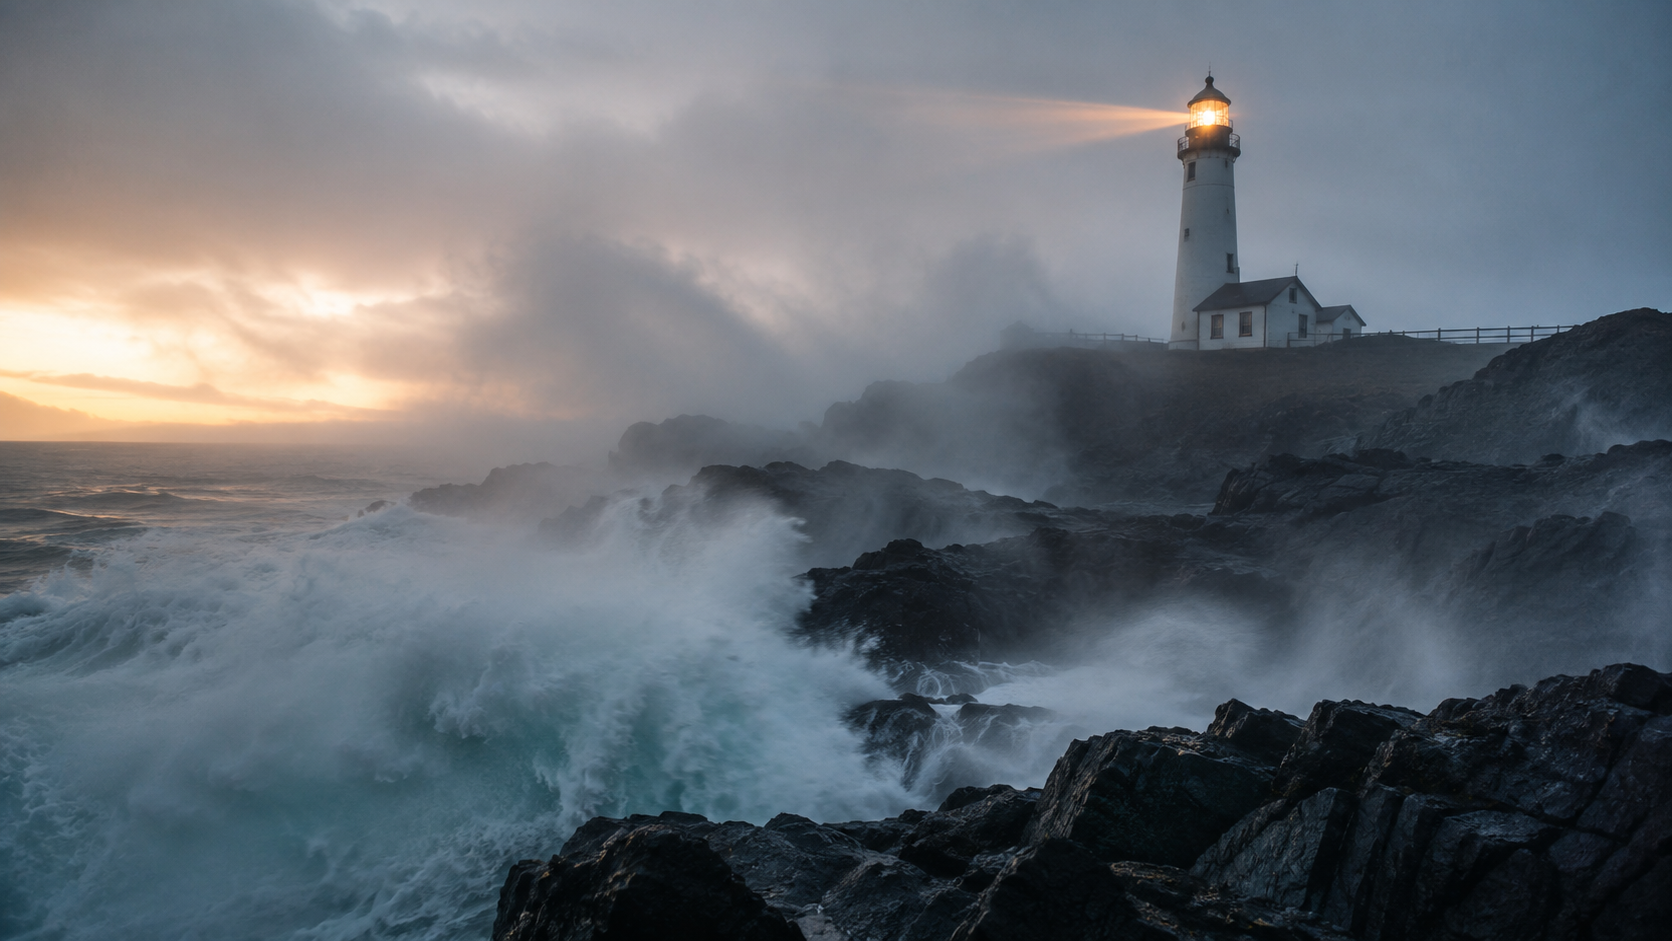
Ausgangsstandbild (gpt-image-2, 16:9, $0,03).
Waves keep rolling in and bursting against the dark rocks in slow rhythm, sea spray and fog drift across the frame, the lighthouse beam sweeps slowly through the mist, clouds crawl overhead, camera completely static on a tripod, natural documentary motion, no camera movement
Ambient-Meeresansicht: Wellen, Nebel, vorbeistreichender Strahl – grok-imagine-1.5/image-to-video, 4 Sekunden @ 720p, 16:9, $0,11 zu aktuellen Preisen. Echtes Ergebnis, für diese Anleitung erzeugt.
Warum es funktioniert: Die Erklärung „camera completely static on a tripod“ befreit das Modell, seine ganze Energie in Wasserphysik und Volumennebel zu stecken, was grok-imagine-1.5 beeindruckend gut hinbekommt – achte darauf, wie der Strahl tatsächlich durch den Nebel streicht. Dieser Clip kostet in 4 Sekunden 720p $0,11; Umgebungsschleifen brauchen selten mehr.
Die Abrechnung pro Sekunde im Griff
Die Videopreise sind hier erfrischend eindimensional: Dauer × Sekundensatz, sonst nichts. Das legt einen einfachen Arbeitsablauf nahe:
| Aktion | Berechnung | Kosten |
|---|---|---|
| Eine Bewegungsidee testen | 4 Sekunden × $0,015 (480p) | $0,06 |
| Den Prompt in Lieferqualität iterieren | 6 Sekunden × $0,0282 (720p) | $0,17 |
| Aufnahme in maximaler Länge | 15 Sekunden × $0,0282 (720p) | $0,42 |
| Ein vorhandenes Standbild neu animieren | Bildkosten | zusätzlich $0 |
Aus dieser Tabelle folgen drei Gewohnheiten. Teste mit 480p und kurzer Dauer – eine gescheiterte Idee sollte nur ein paar Cent kosten, nicht einen Dollar. Nutze Standbilder gnadenlos wieder – Rezept 1 und 2 oben sind dasselbe $0,03-Bild in zwei verschiedenen Kamerabewegungen. Verlange genau die Sekunden, die du brauchst – duration geht bis auf 1 herunter, und Umgebungsaufnahmen wie Rezept 4 werden nach wenigen Sekunden nicht mehr besser. Alle vier Clips auf dieser Seite kosten zu aktuellen Preisen zusammen $0,62 an Video.
Selbst ausführen: Einreichen, Abfragen, Herunterladen
Das Modell arbeitet aufgabenbasiert: POST /v1/tasks gibt eine Task-ID zurück, du fragst ab, bis sie erfolgreich ist, und lädst dann die Ausgabe-URL herunter (sie läuft ab – speichere die Datei, nicht den Link). Eine Sache musst du wissen: image_urls müssen öffentlich zugänglich sein – reichst du eine private oder lokale URL ein, scheitert die Einreichung mit einem normalize input media-Fehler, bevor das Modell überhaupt läuft.
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

task = requests.post(API, headers=HEADERS, json={
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
        "prompt": ("Slow steady dolly push-in down the rain-soaked "
                   "market street toward the glowing noodle stall, "
                   "steam rising, one continuous shot, no cuts"),
        "image_urls": ["https://your-host.com/your-still.jpg"],
        "duration": 6,          # int, 1-15 seconds
        "resolution": "720p",   # 480p | 720p
        "aspect_ratio": "16:9", # auto | 1:1 | 16:9 | 9:16 | 3:2 | 2:3
    },
}).json()
task_id = task["data"]["taskId"]

while True:
    t = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

assert t["status"] == "success", t.get("error")
url = t["output"][0]["url"]  # expiring link - download it now
open("clip.mp4", "wb").write(requests.get(url).content)
Die vollständige Request-Durchführung (inklusive curl) steht im grok-imagine-Bild-zu-Video-API-Leitfaden, und der Text-zu-Video-Leitfaden behandelt das reine Prompt-Geschwistermodell. Die allgemeine Plattformdokumentation findest du hier.
Kurzreferenz zum Schema
| Feld | Erforderlich | Werte (live verifiziert) |
|---|---|---|
prompt |
Empfohlen | Freitext – das ist deine einzige Bewegungssteuerung |
image_urls |
Ja | Array öffentlich zugänglicher Bild-URLs |
duration |
Nein | Ganzzahl, 1–15 (Sekunden) |
resolution |
Nein | 480p, 720p |
aspect_ratio |
Nein | auto, 1:1, 16:9, 9:16, 3:2, 2:3 |
Kein motion_mode, kein Seed, keine Negativ-Prompts – das Schema lehnt unbekannte Felder mit 400 ab, kopiere also keine Parameter aus anderen Modellen. Wenn du eine andere Bewegung willst, schreib einen anderen Satz.
Wenn dein Clip eine längere Dauer oder natives Audio braucht, ist seedance-2.0-fast in diesem Bereich verfügbar, und die seedance-2.0-mini-Rezeptsammlung nutzt dasselbe Einreichen-Abfragen-Herunterladen-Muster – Prompts und Pipeline lassen sich mit kleinen Anpassungen übertragen.
Alle vier Prompts stehen dir zum Kopieren bereit. Hol dir einen Schlüssel, richte das obige Code-Snippet auf grok-imagine-1.5, und dein erstes Standbild in 480p zu animieren kostet dich etwa fünf Cent.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte