
Guida all'uso
Ricette di prompt per image-to-video di Grok Imagine 1.5: prompt copiabili e output reali
Quattro prompt di movimento verificati sul campo per grok-imagine-1.5/image-to-video@preview — ciascuno accompagnato dal suo fotogramma statico di partenza e dal clip che ha effettivamente generato sull'API live.
Riepilogo
- Cos'è: quattro prompt di movimento copiabili così come sono per grok-imagine-1.5/image-to-video, ciascuno accompagnato dal suo fotogramma statico iniziale e dal clip che ha realmente generato sull'API live — output grezzo al primo tentativo, nessun nuovo tentativo nascosto, ospitato qui in modo permanente.
- L'unica cosa da sapere su questo modello: l'API non ha affatto parametri di movimento o di camera. Lo schema di input (verificato live) contiene solo
prompt+image_urls, più i facoltatividuration,resolutioneaspect_ratio. Tutte le decisioni su movimento di camera, stile di movimento e ritmo avvengono dentro il testo del prompt — ed è proprio a questo che servono queste ricette. - Fatti sullo schema (verificati sull'API dei task live il 2026-07-07):
image_urlsè un array obbligatorio di URL di immagini accessibili pubblicamente;durationè un intero da 1 a 15 secondi;resolutionè 480p o 720p;aspect_ratioaccettaauto,1:1,16:9,9:16,3:2,2:3. Qualsiasi altro parametro (motion_mode,seed, ecc.) viene rifiutato con un 400. - Prezzo (per secondo di output, dalla pagina dei prezzi): $0.015/secondo per 480p, $0.0282/secondo per 720p. La durata è l'unico moltiplicatore — un clip di 6 secondi a 720p costa circa $0.17, una prova di 4 secondi a 480p costa $0.06.
- Conto totale dei media di questo articolo: quattro fotogrammi statici gpt-image-2 a $0.03 ciascuno, più 22 secondi di video a 720p — circa $0.74 in totale ai prezzi attuali. Ecco il senso dell'image-to-video: il fotogramma statico è un costo una tantum, e puoi rianimarlo tutte le volte che vuoi.
Come sono state realizzate queste ricette
Ogni ricetta contiene tre parti: il fotogramma statico di partenza, il prompt di movimento esatto (copialo così com'è) e il clip che ha generato. Ogni fotogramma statico l'ho generato con gpt-image-2, ogni prompt di movimento l'ho scritto io stesso e ho eseguito ognuno tramite l'API dei task live di hiapi su grok-imagine-1.5. In ogni descrizione sono stampate le impostazioni e il costo reale, così puoi riprodurre esattamente la stessa chiamata.
Poiché grok-imagine-1.5 non accetta parametri di movimento, è la formulazione del prompt a fare tutto il lavoro. Abitudini che funzionano sempre:
- Inizia con il verbo di camera. "Slow steady dolly push-in", "camera glides slowly to the left" — mettilo all'inizio e il modello lo tratterà come la spina dorsale del clip.
- Chiedi un unico movimento continuo e dichiara "no cuts". Se lasciato a sé, il modello a volte inventa da solo dei tagli. Aggiungere "one continuous shot, no cuts" alla fine del prompt lo inibisce in modo affidabile.
- Descrivi cosa si muove di continuo, non solo la camera. Vapore, pioggia, riflessi, folla — indicare il movimento ambientale mantiene viva l'immagine, invece di sembrare una panoramica su una foto.
- Per le persone, chiedi micro-movimenti e blocca la camera. "Camera locked off on a tripod … facial features stay perfectly stable, no warping" è la differenza tra un ritratto vivo e una faccia che si scioglie.
Ricetta 1 — Linguaggio di camera: lento push-in
Obiettivo: il classico movimento di dolly cinematografico che avanza lungo la strada e si ferma sulla bancarella di cibo, mentre pioggia, vapore e riflessi continuano a lavorare.
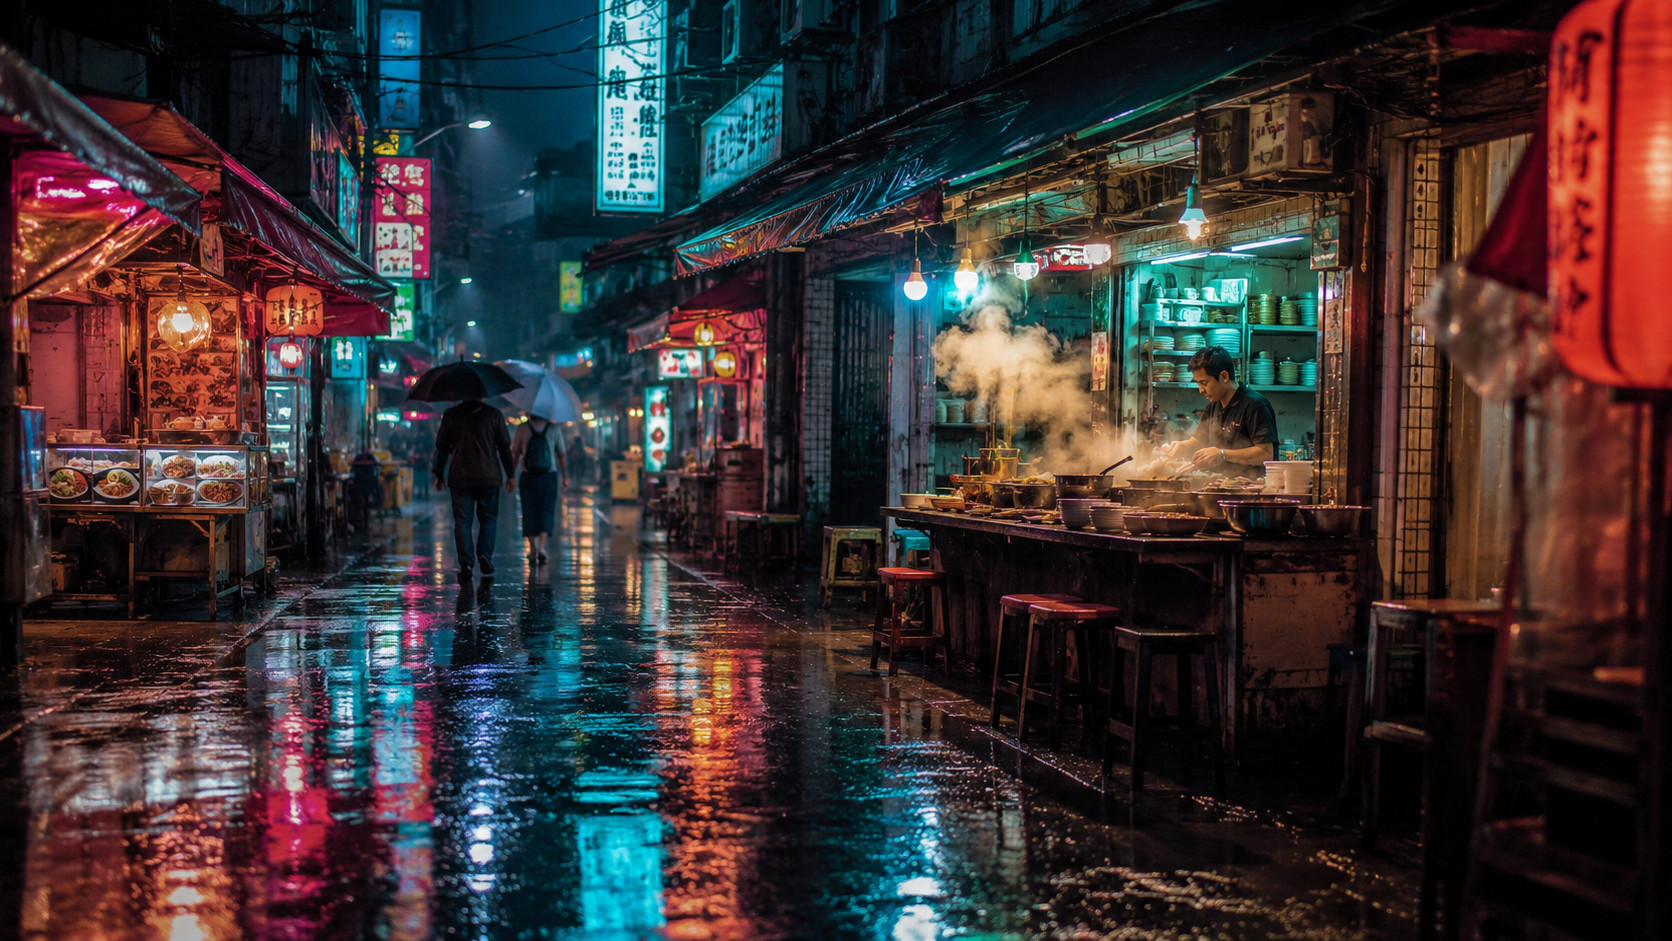
Fotogramma statico di partenza (gpt-image-2, 16:9, $0.03). Le ricette 1 e 2 animano entrambe lo stesso fotogramma.
Slow steady dolly push-in down the rain-soaked market street toward the glowing noodle stall, steam rising and curling from the pots, rain falling in thin streaks, neon sign reflections shimmering on the wet pavement, pedestrians walking slowly away under umbrellas, smooth constant camera speed, one continuous shot, no cuts, cinematic pacing
Lento push-in di dolly verso la bancarella di noodle — grok-imagine-1.5/image-to-video, 6 secondi @ 720p, 16:9, $0.17 ai prezzi attuali. Output reale, generato per questa guida.
Perché funziona: il push-in è la prima proposizione, quindi il modello vi si attiene per tutti e sei i secondi. Poi il prompt gli consegna un elenco di elementi che devono muoversi di continuo — vapore, fili di pioggia, riflessi, pedoni — ed è proprio questo che fa sembrare il filmato un video invece di uno zoom su un fotogramma statico. Nota quanto si sono avvicinati il cuoco e le pentole nell'ultimo fotogramma: è un vero movimento di camera, non un ritaglio.
Ricetta 2 — Stesso statico, diverso verbo di camera: tracking laterale
Obiettivo: rianimare esattamente lo stesso fotogramma statico con un movimento di tracking laterale, per mostrare che in grok-imagine-1.5 il linguaggio di camera risiede interamente nel prompt — cambia un verbo e ottieni una camera diversa.
Camera glides slowly to the left in a smooth lateral tracking move, strong parallax between the near market stalls and the far end of the street, rain keeps falling, neon reflections slide across the wet ground, the cook keeps stirring behind the counter, steam drifts sideways, one continuous move, no cuts, no zoom
Tracking laterale attraverso la strada del mercato — grok-imagine-1.5/image-to-video, 6 secondi @ 720p, 16:9, $0.17 ai prezzi attuali. Output reale, generato per questa guida.
Perché funziona: "glides slowly to the left" insieme alla richiesta esplicita di parallasse tra le bancarelle vicine e il fondo della strada fornisce al modello un indizio di profondità da animare. È anche il modo più economico di iterare: il fotogramma statico è un costo già sostenuto di $0.03, quindi ogni nuova interpretazione della camera costa solo i secondi di video — qui le due interpretazioni insieme fanno circa $0.34 in totale. Se stai esplorando un certo look, ri-prompt sullo stesso fotogramma prima di pensare di rigenerare l'immagine.
Ricetta 3 — Movimento guidato dal soggetto: micro-movimento del ritratto (9:16)
Obiettivo: un ritratto verticale, adatto ai social, in cui il soggetto respira, sbatte le palpebre e i suoi capelli e la sciarpa si muovono — e nient'altro.
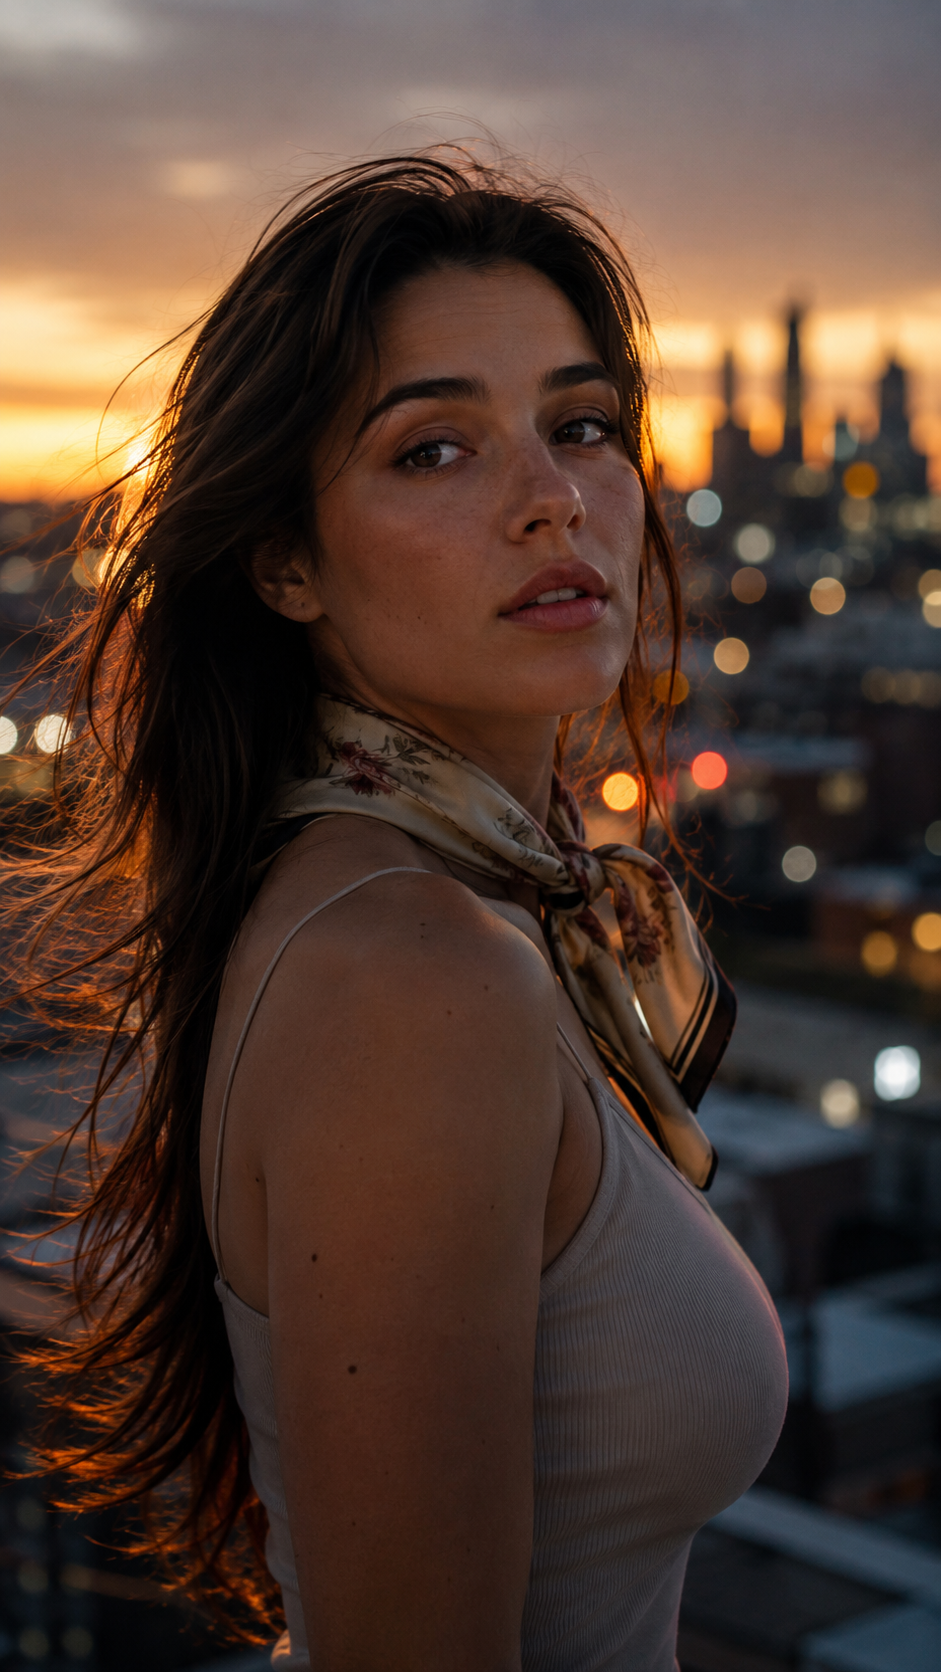
Fotogramma statico di partenza (gpt-image-2, 9:16, $0.03).
Gentle micro-motion only: her hair lifts and drifts in a soft evening breeze, the silk scarf ripples lightly, she blinks naturally and takes one calm slow breath, city bokeh lights flicker softly behind her, camera locked off on a tripod, facial features stay perfectly stable, no warping, subtle photoreal motion
Micro-movimento del ritratto: capelli, sciarpa, respiro — grok-imagine-1.5/image-to-video, 6 secondi @ 720p, 9:16, $0.17 ai prezzi attuali. Output reale, generato per questa guida.
Perché funziona: i ritratti sono esattamente il punto in cui i modelli image-to-video fanno sciogliere le facce, quindi il prompt spende la maggior parte delle parole in vincoli: "micro-motion only", "camera locked off", "facial features stay perfectly stable, no warping". Il budget di movimento è assegnato a elementi sicuri e di grande resa — capelli, seta, battito di ciglia, respiro. Girato in 9:16 per il feed; il rapporto d'aspetto è un campo API di prima classe, non un ritaglio.
Ricetta 4 — Atmosfera ambientale: lascia che sia la scena a muoversi
Obiettivo: un loop naturale a camera fissa in cui tutto il movimento nasce dalla scena stessa — onde, nebbia e il fascio rotante del faro. Quattro secondi bastano.
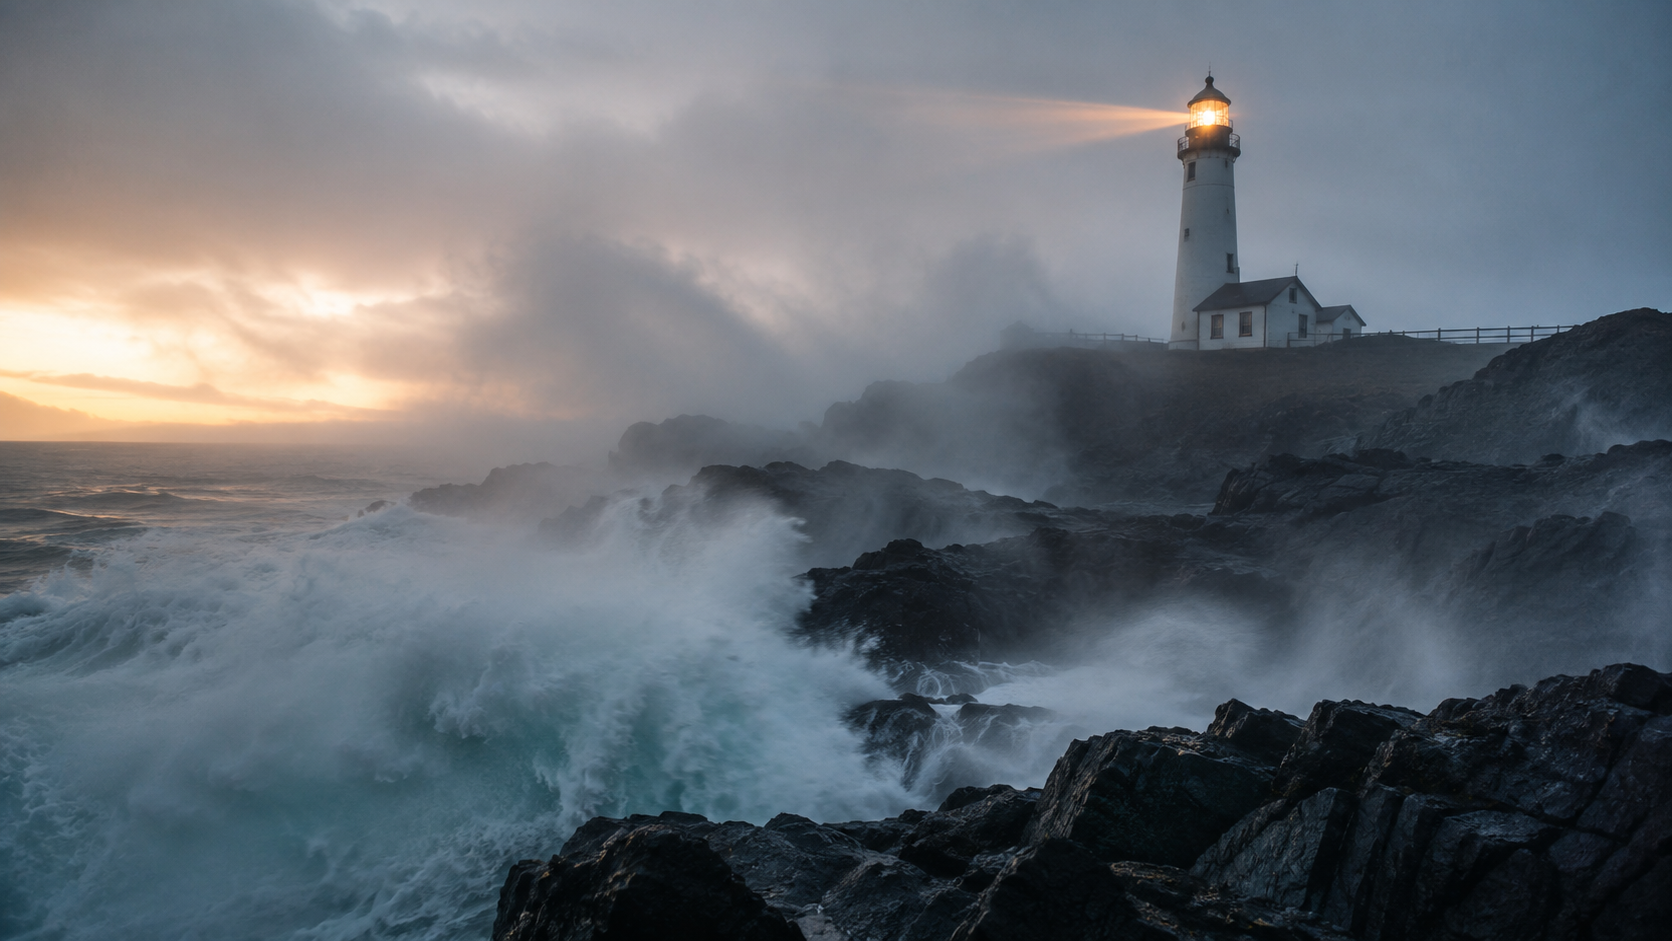
Fotogramma statico di partenza (gpt-image-2, 16:9, $0.03).
Waves keep rolling in and bursting against the dark rocks in slow rhythm, sea spray and fog drift across the frame, the lighthouse beam sweeps slowly through the mist, clouds crawl overhead, camera completely static on a tripod, natural documentary motion, no camera movement
Scena marina ambientale: onde, nebbia, fascio rotante — grok-imagine-1.5/image-to-video, 4 secondi @ 720p, 16:9, $0.11 ai prezzi attuali. Output reale, generato per questa guida.
Perché funziona: dichiarare "camera completely static on a tripod" libera il modello e gli permette di spendere tutte le energie sulla fisica dell'acqua e sulla nebbia volumetrica, che grok-imagine-1.5 gestisce in modo impressionante — nota che il fascio attraversa davvero la nebbia. Questo clip di 4 secondi a 720p costa $0.11; i loop ambientali raramente hanno bisogno di più.
Controllare il conto al secondo
Il prezzo dei video qui è rinfrescante perché ha una sola dimensione: durata × tariffa al secondo, nient'altro. Questo suggerisce un flusso di lavoro semplice:
| Operazione | Calcolo | Costo |
|---|---|---|
| Provare un'idea di movimento | 4 secondi × $0.015 (480p) | $0.06 |
| Iterare il prompt a qualità di consegna | 6 secondi × $0.0282 (720p) | $0.17 |
| Girare alla durata massima | 15 secondi × $0.0282 (720p) | $0.42 |
| Rianimare uno statico che hai già | Costo immagine | $0 extra |
Da questa tabella derivano tre abitudini. Prova a 480p e con durate brevi — un'idea fallita dovrebbe costare pochi centesimi, non un dollaro. Riusa spietatamente i fotogrammi statici — le ricette 1 e 2 qui sopra sono la stessa immagine da $0.03 con due diversi movimenti di camera. Chiedi esattamente i secondi che ti servono — duration scende fino a 1, e scene ambientali come la ricetta 4 smettono di migliorare dopo pochi secondi. Tutti e quattro i clip di questa pagina, ai prezzi attuali, fanno $0.62 di video in totale.
Esegui da solo: invia, fai polling, scarica
Il modello è basato su task: POST /v1/tasks restituisce un id del task, tu fai polling finché non va a buon fine, poi scarichi l'URL di output (scade — salva il file, non il link). Una cosa da sapere: image_urls deve essere accessibile pubblicamente — se passi un URL privato o locale, l'invio fallisce con un errore normalize input media prima ancora che il modello parta.
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_HIAPI_KEY"}

task = requests.post(API, headers=HEADERS, json={
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
        "prompt": ("Slow steady dolly push-in down the rain-soaked "
                   "market street toward the glowing noodle stall, "
                   "steam rising, one continuous shot, no cuts"),
        "image_urls": ["https://your-host.com/your-still.jpg"],
        "duration": 6,          # int, 1-15 seconds
        "resolution": "720p",   # 480p | 720p
        "aspect_ratio": "16:9", # auto | 1:1 | 16:9 | 9:16 | 3:2 | 2:3
    },
}).json()
task_id = task["data"]["taskId"]

while True:
    t = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if t["status"] in ("success", "fail"):
        break
    time.sleep(5)

assert t["status"] == "success", t.get("error")
url = t["output"][0]["url"]  # expiring link - download it now
open("clip.mp4", "wb").write(requests.get(url).content)
La procedura completa della richiesta (con curl) è nella guida all'API image-to-video di grok-imagine, mentre la guida al text-to-video copre il modello gemello basato solo sul prompt. La documentazione generale della piattaforma è qui.
Riferimento rapido allo schema
| Campo | Obbligatorio | Valore (verificato live) |
|---|---|---|
prompt |
Consigliato | Testo libero — è il tuo unico controllo sul movimento |
image_urls |
Sì | Array di URL di immagini accessibili pubblicamente |
duration |
No | Intero, 1–15 (secondi) |
resolution |
No | 480p, 720p |
aspect_ratio |
No | auto, 1:1, 16:9, 9:16, 3:2, 2:3 |
Niente motion_mode, niente seed, niente prompt negativi — lo schema rifiuta i campi sconosciuti con un 400, quindi non c'è bisogno di copiare parametri da altri modelli. Se vuoi un movimento diverso, scrivi una frase diversa.
Se il tuo clip richiede una durata maggiore o audio nativo, seedance-2.0-fast è disponibile in quel range, e la raccolta di ricette per seedance-2.0-mini usa lo stesso schema invia-polling-scarica — i prompt e la pipeline si trasferiscono con poche modifiche.
Tutti e quattro i prompt sono tuoi da copiare. Prendi una chiave, punta lo snippet qui sopra su grok-imagine-1.5, e animare il tuo primo fotogramma statico a 480p ti costerà circa cinque centesimi.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori