
Benutzerhandbuch
wan3.0-video-prime Einstiegsleitfaden: Grenzen der referenzbasierten Videogenerierung, Abrechnung und Integrationspraxis
Entscheidungscheckliste für Entwickler zur Anbindung des Alibaba-Videomodells
Warum wan3.0-video-prime Beachtung verdient
wan3.0-video-prime wird von Alibaba angeboten, der Ausgabetyp ist Video, die Kernfähigkeit ist reference-to-video. Der Grund, es in die Kandidatenliste aufzunehmen, ist direkt: Es zielt auf Anforderungen der Art „ein Referenzmaterial geben und daraus ein Video generieren“ ab, statt nur per Textprompt von null an ein Video zu erzeugen.
Für Entwickler hängt der Wert eines Modells davon ab, ob es zur eigenen Geschäftsform passt. Wenn in Ihrem Produkt bereits stabiles visuelles Material vorhanden ist – Markenbild, Charakterdesign, bestehende Produktbilder oder Musterclips – und Sie wünschen, dass die generierten Ergebnisse in diesen Dimensionen erkennbar konsistent bleiben, dann ist referenzgesteuerte Videogenerierung ein Zweig, der eine eigene Bewertung verdient. Umgekehrt, wenn die Anforderung eine offene Kreation rein aus Text zu Video ist, ist die Fähigkeitspositionierung dieses Modells nicht die beste Übereinstimmung.
Merken Sie sich zunächst zwei harte Fakten: Die Ausgabe ist Video, und die Abrechnung erfolgt nach Ausgabesekunden. Diese beiden Punkte ziehen sich durch alle folgenden Diskussionen zu Integration und Budget.
Die erste Frage bei der Modellauswahl
Bevor Sie in die Parameter eintauchen, stellen Sie sich eine Frage: Bringt mein Geschäft natürlicherweise ein „Referenzobjekt“ mit sich? Wenn die Antwort nein ist, ist der Nutzen des Weiterlesens begrenzt; wenn die Antwort ja ist, gilt es als Nächstes zu klären, wie stark dieses Referenzobjekt einschränken kann und wie viel Zeitkosten dafür anfallen.
Was reference-to-video kann und was nicht
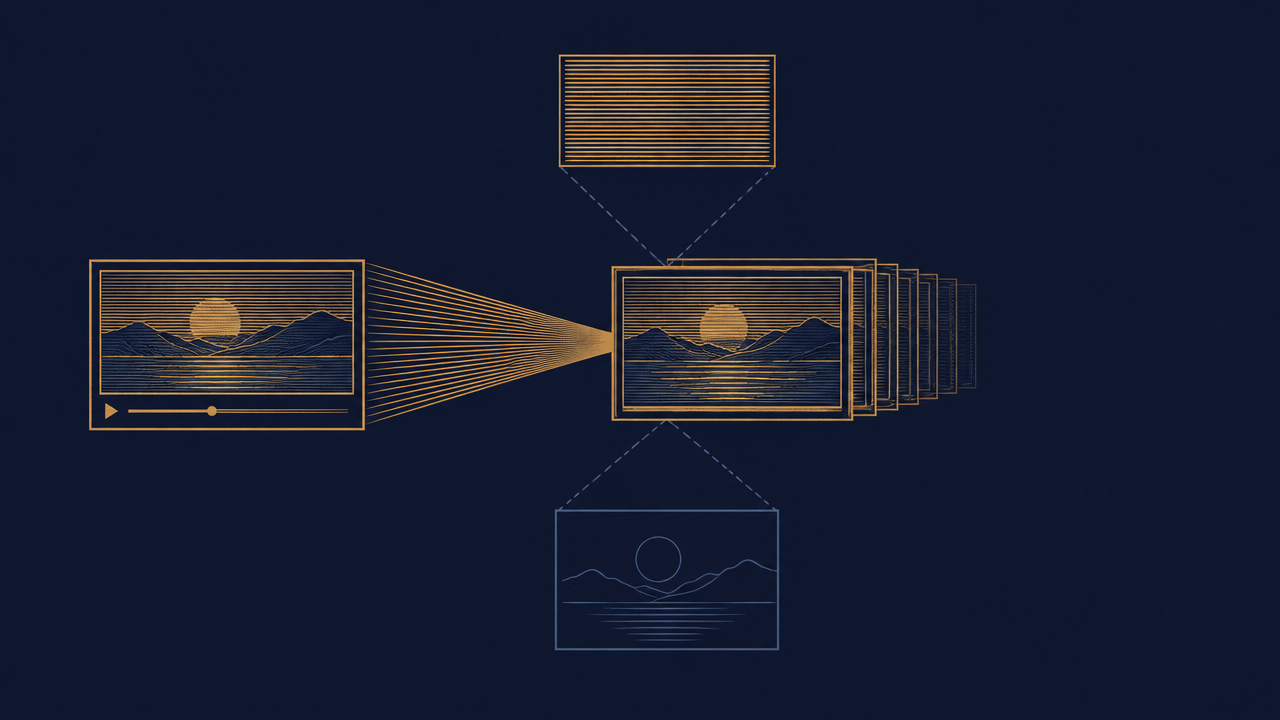
Die Grundform von reference-to-video ist: ein Referenzmaterial plus ein Textprompt bestimmen gemeinsam die Richtung des generierten Videos. Das Referenzmaterial übernimmt den Teil „wie es aussieht“, der Textprompt den Teil „wie es sich bewegt, wie es sich verändert“.
Was es kann
- Generierung von Kurzvideos mit hohen Anforderungen an Referenzkonsistenz: Wenn die Ausgabe die visuellen Merkmale des Referenzmaterials fortsetzen soll, ist dies das Kerngebiet des Modells.
- Iterative Kreation ausgehend von vorhandenem Material: Man muss nicht jedes Mal die gesamte Szene von null beschreiben, stabile Informationen in die Referenz legen, veränderliche Informationen in den Prompt.
- Einzelne Videoerzeugnisse mit kontrollierbarer Dauer: Geeignet für Szenarien, in denen die Aufmerksamkeit auf Ergebnisqualität statt auf Menge liegt.
Was es nicht kann oder worauf man nicht hoffen sollte
- Langdauernde Massengenerierung als günstige Lösung betrachten. Die Abrechnung nach Ausgabesekunden bedeutet, dass die Kosten mit der Dauer linear wachsen; lange Dauer kombiniert mit großer Stückzahl lässt das Budget schnell außer Kontrolle geraten.
- Referenzmaterial als Allzweck-Einschränkung betrachten. Die Referenz liefert Führung, keine pixelgenaue Kopiergarantie; Anforderungen, die „völlig identisch“ erwarten, sollten früh in der Bewertung aussortiert werden.
- Es als Ersatz für offene Text-zu-Video-Kreationsprozesse verwenden. Die Fähigkeitspositionierung ist anders, ein gewaltsames Übertragen führt nur zu halbem Ergebnis bei doppeltem Aufwand.
Die Beurteilungsmethode ist, eine Linie zu ziehen: Auf einer Seite „mit Referenz, konsistent, kurze Dauer“, auf der anderen „ohne Referenz, frei, lange Dauer“. Ersteres fällt hinein, Letzteres umgeht es.
Vor der Integration zu bestätigende Parameter und Prozesspunkte
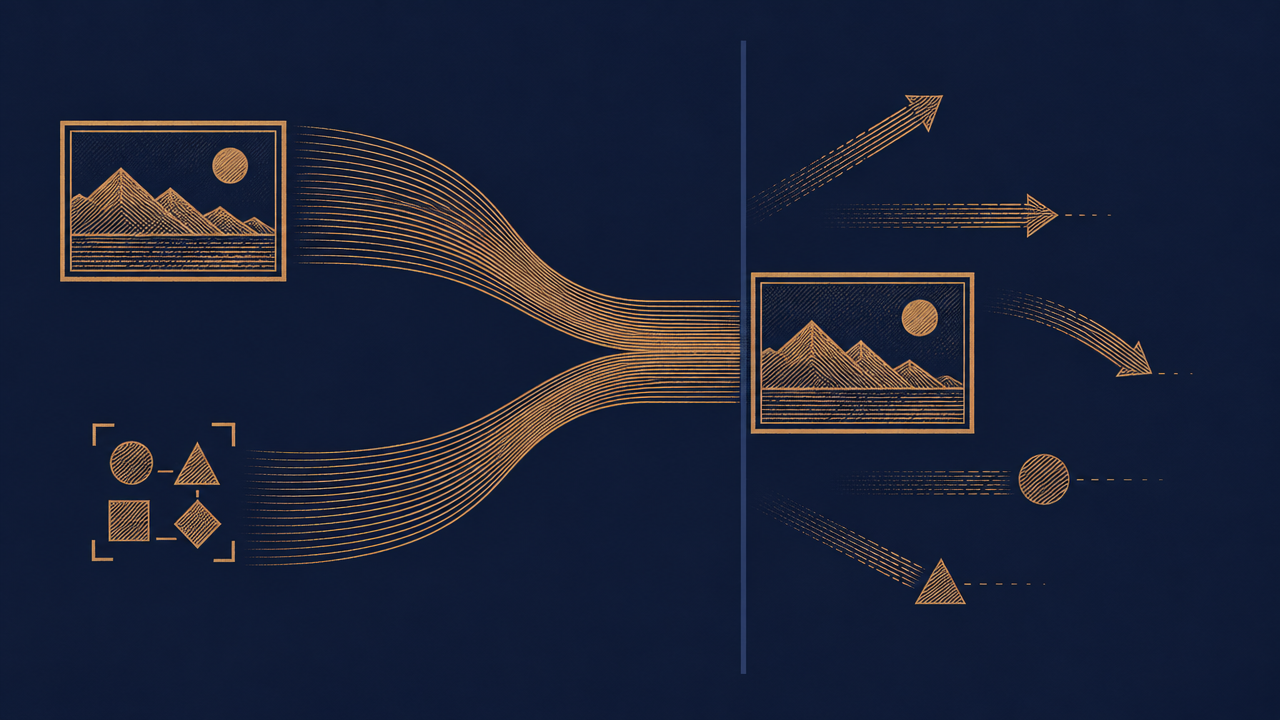
Bei der Integration über die einheitliche Schnittstelle von HiAPI.ai ist der Prozess selbst konvergent; was wirklich leicht Probleme macht, ist die Vorbereitung. Es empfiehlt sich, in der folgenden Reihenfolge vorzugehen.
Vorbereitungscheckliste
- Anmeldedaten und Berechtigungen: Zuerst bestätigen, dass die Aufruf-Anmeldedaten bereitstehen, und das zugehörige Kontingent sowie den Berechtigungsumfang klären, um in der Integrationsphase keine Zeit mit Authentifizierung zu verschwenden.
- Modellkennung: In der Anfrage den exakten Modellnamen wan3.0-video-prime verwenden, nicht raten oder alte Beispiele kopieren.
- Spezifikation des Eingabematerials: Format, Größe und inhaltliche Grenzen des Referenzmaterials im Voraus festlegen; die Materialqualität ist die Obergrenze der Ergebnisqualität.
- Prompt-Struktur: Zuerst eine strukturierte Prompt-Version schreiben statt eines Ein-Satz-Entwurfs; die konkrete Organisation siehe unten.
- Ausgabeverarbeitung: Klären, wie das Videoergebnis gespeichert, an das Frontend zurückgegeben und wie mit Timeouts umgegangen wird.
Aufrufreihenfolge
Zunächst mit einer minimal nutzbaren Anfrage die Kette durchlaufen – ein Referenzmaterial, ein kurzer Prompt, eine möglichst kurze Ausgabedauer – und bestätigen, dass ein Videoergebnis normal abgerufen werden kann; dann schrittweise die Dauer verlängern und die Prompt-Komplexität erhöhen. Bei jedem Schritt nur eine Variable ändern, damit bei Problemen lokalisiert werden kann, ob es am Material, am Prompt oder an der Dauer liegt.
Zu beachtende Punkte
Öffentliche Materialien decken nur Modellpositionierung, Ausgabetyp und Abrechnungsmaßstab ab; konkrete Parameterdetails sollten sich nach der tatsächlichen Schnittstellendokumentation richten. Nicht bestätigte Felder nicht aus Erfahrung füllen; bei Parametern, die die Dokumentation nicht abdeckt, zuerst mit einer minimalen Anfrage das Verhalten verifizieren und dann in den Produktionscode übernehmen.
Abrechnung nach Sekunden: Wie man Kosten schätzt und kontrolliert
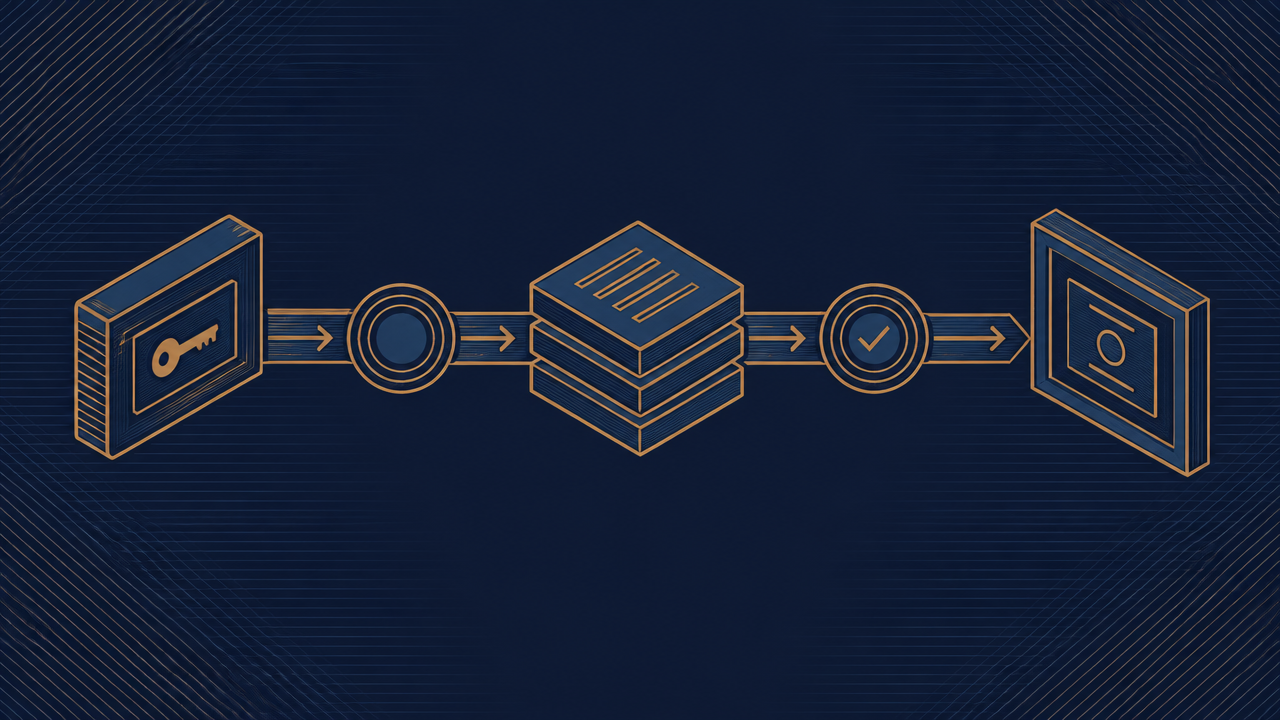
Das Modell rechnet nach Ausgabesekunden ab. Dieser Maßstab bestimmt die Grundformel der Kostenschätzung:
Kosten pro Einheit ≈ Ausgabesekunden × Preis pro Sekunde
Gesamtkosten ≈ durchschnittliche Sekunden pro Einheit × Anzahl × Preis pro Sekunde
Der aktuelle Preis pro Sekunde richtet sich nach dem Preispaneel der Website; konkrete Zahlen werden hier nicht ausgeführt. Wichtig ist, die Struktur zu verstehen: Die Kosten sind linear an die Dauer gekoppelt, unabhängig davon, wie oft Sie aufrufen, nur davon, wie viele Sekunden Video Sie produzieren.
Zwei Dinge, die bei der Schätzung leicht übersehen werden
- Wiederholungen zählen mit: Jeder Aufruf, der erfolgreich ein Video produziert, zählt zur Dauer; die Testkosten für wiederholtes Parameter-Tuning sind echte Kosten.
- Batch vervielfacht die Dauer: Anzahl und Dauer pro Einheit stehen in multiplikativer Beziehung; verdoppelt sich eine Seite, verdoppelt sich das Budget.
Kontrollstrategie
- Mit kurzer Dauer beginnen: Zuerst mit einer sehr kurzen Dauer pro Einheit prüfen, ob Prompt und Material wirksam sind; nach Bestätigung der Richtung verlängern.
- Dauer als Produktparameter behandeln: Auf der Geschäftsseite explizit „maximal wie viele Sekunden“ festlegen, statt die Dauer vom Nutzer frei ausreizen zu lassen.
- Budget-Schranke setzen: Ausgehend von „wie viele Sekunden diesen Monat geplant sind“ den akzeptablen Aufrufumfang rückwärts ableiten, statt nach „wie oft man aufrufen kann“ zu planen.
- Vergleichstests mit kleinen Stichproben: In der Tuning-Phase mit minimaler Stichprobengröße richtungsweisende Schlussfolgerungen ziehen und dann skalieren.
Kosten in Sekunden statt in Aufrufen umzurechnen ist der wichtigste Denkwechsel bei der Nutzung dieses Modells.
Typische Anwendungen und Empfehlungen zur Prompt-Struktur
Geeignete Szenarien für dieses Modell haben ein gemeinsames Merkmal: Das Referenzmaterial ist selbst ein Geschäftsvermögen. Zum Beispiel Kurzfilme mit Markenbild als Kern, Inhalte mit festen Charakteren als Subjekt, Präsentationsvideos auf Basis vorhandener Produktmaterialien. In diesen Szenarien ist Konsistenz ein Muss und die Dauer kontrollierbar.
Geschichtete Organisation des Prompts
Schreiben Sie den Prompt in drei Schichten statt in einem Absatz:
- Referenzschicht: Erklären, was im Referenzmaterial erhalten bleiben muss – Subjekt, Farbgebung, Stilgrundton.
- Bewegungsschicht: Beschreiben, wie sich das Bild verändert – wie die Kamera fährt, wie sich das Subjekt bewegt, wie schnell das Tempo ist.
- Einschränkungsschicht: Klar schreiben, was nicht erscheinen soll, sowie Anforderungen an Dauer und Bildformat.
Der Sinn der Schichtung liegt in der Debugbarkeit. Wenn das Ergebnis nicht stimmt, können Sie beurteilen, ob die Referenzbeschreibung unklar war, die Bewegungsbeschreibung im Konflikt steht oder Einschränkungen fehlen, statt alles neu zu schreiben.
Schreibweise der ersten Anfrage
Zuerst mit einem Satz das Subjekt bestätigen, dann Bewegung und Einschränkungen ergänzen, die Dauer pro Einheit auf das Minimum drücken. Nach erfolgreichem Durchlauf schichtweise Details hinzufügen, jeweils nur eine Schicht. So wissen Sie auch bei unbefriedigendem Ergebnis, welche Schicht die Abweichung verursacht hat.
Wenn ein Vergleich mehrerer Modelle nötig ist, die Prompt-Struktur unverändert lassen und nur die Modellkennung austauschen, um vergleichbare Schlussfolgerungen zu erhalten.
Maßstab für den horizontalen Vergleich mit anderen Videomodellen
Der häufigste Fehler beim Vergleich mehrerer Modelle ist, nur den Einzelpreis zu betrachten. Der Einzelpreis ist nur aussagekräftig, wenn die übrigen Dimensionen angeglichen sind. Es empfiehlt sich, einheitlich nach folgenden Dimensionen zu bewerten:
- Abrechnungsmaßstab: nach Sekunde, nach Aufruf oder nach Token. Bei unterschiedlichem Maßstab sind die Einzelpreiszahlen nicht direkt vergleichbar; zuerst in denselben Maßstab umrechnen, dann vergleichen.
- Referenzfähigkeit: ob referenzgesteuert unterstützt wird, wie stark die Referenz einschränken kann. Das entscheidet direkt, ob es in Ihre Kandidatenmenge gelangt.
- Bereich der Ausgabedauer: wie lang eine Einheit sein kann, ob es eine praktische Längenbegrenzung gibt.
- Ausgabetyp und -form: ob Grundattribute wie Auflösung und Bildformat des Videos die Geschäftsanforderungen erfüllen.
- Debug-Kosten: wie viele Aufrufrunden von einem Test bis zu einer brauchbaren Schlussfolgerung nötig sind – besonders wichtig bei Modellen mit Abrechnung nach Sekunden.
Wie man diesen Maßstab anwendet
Zuerst nach „Referenzfähigkeit“ hart filtern, nicht erfüllende direkt ausschließen; die verbleibenden Kandidaten nach den umgerechneten Kosten pro Sekunde sortieren; schließlich mit den Debug-Kosten korrigieren – ein Modell mit etwas niedrigerem Einzelpreis, das aber mehr Testrunden benötigt, kann real teurer sein.
Die Schlussfolgerung des Vergleichs sollte nicht „welches ist billiger“ sein, sondern „welches unter den Modellen, die meine Anforderungen an Referenzkonsistenz erfüllen, hat bei akzeptabler Dauer die niedrigsten Gesamtkosten“.
Häufige Fragen und Checkliste vor dem Go-live
Häufige Fragen
- Ergebnis ähnelt dem Referenzmaterial nicht: Meist ist die Referenzschicht zu allgemein beschrieben oder das Referenzmaterial selbst hat keine ausgeprägten Merkmale. Zuerst konkret schreiben, „was erhalten bleiben muss“.
- Bildbewegung entspricht nicht der Erwartung: Die Bewegungsschicht steht im Konflikt mit der Referenzschicht, z. B. wird sowohl eine statische Komposition als auch eine starke Kamerabewegung verlangt.
- Kosten übersteigen die Erwartung: Fast immer durch gleichzeitige Vervielfachung von Dauer und Stückzahl verursacht. Zurück zur Formel der Sekundenschätzung und erneut prüfen.
- Mehr Sekunden sehen wollen, also Einheit verlängern: Das ist die teuerste Optimierungsweise; vorrangig in mehrere kurze Videos aufteilen statt eine Einheit zu verlängern.
Checkliste vor dem Go-live
- Kosten: Budgetberechnung nach Ausgabesekunden abgeschlossen, Obergrenze der Dauer und Batch-Schranke gesetzt.
- Qualität: Vergleichstests mit minimaler Stichprobe abgeschlossen, Prompt-Struktur aus Referenz-, Bewegungs- und Einschränkungsschicht stabil und wiederverwendbar.
- Zuverlässigkeit: Anmeldedaten, Modellkennung, Timeout- und Retry-Strategie bestätigt, Fehlerpfade haben klare Behandlung; Speicher- und Rückgabekette der Ausgabeergebnisse läuft.
Erst wenn alle drei Spalten abgehakt sind, zu skalieren, ist der sicherste Weg bei der Nutzung von wan3.0-video-prime. Wenn Ihr Szenario bereits als referenzgesteuerte Kurzvideogenerierung bestätigt ist, liefert die Verifikation mit einer Anfrage minimaler Dauer schneller eine Antwort als jede Papierbewertung.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte