
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Laden Sie einfach ein einzelnes Foto und ein Skript hoch, um ein Sprecher-Avatar-Video mit Lippensynchronisation, Gesichtsausdrücken und Gesten zu erzeugen; unterstützt Ausgaben mit 1280p+ und eignet sich für digitale Sprecher und Voice-over-Inhalte
heygen-avatar-iv ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
videoHeyGen Avatar IV Text-zu-Video-Funktionsübersicht
Stil Sprechtext · Erläuterung · Avatar-Video
Referenz-Eingaben
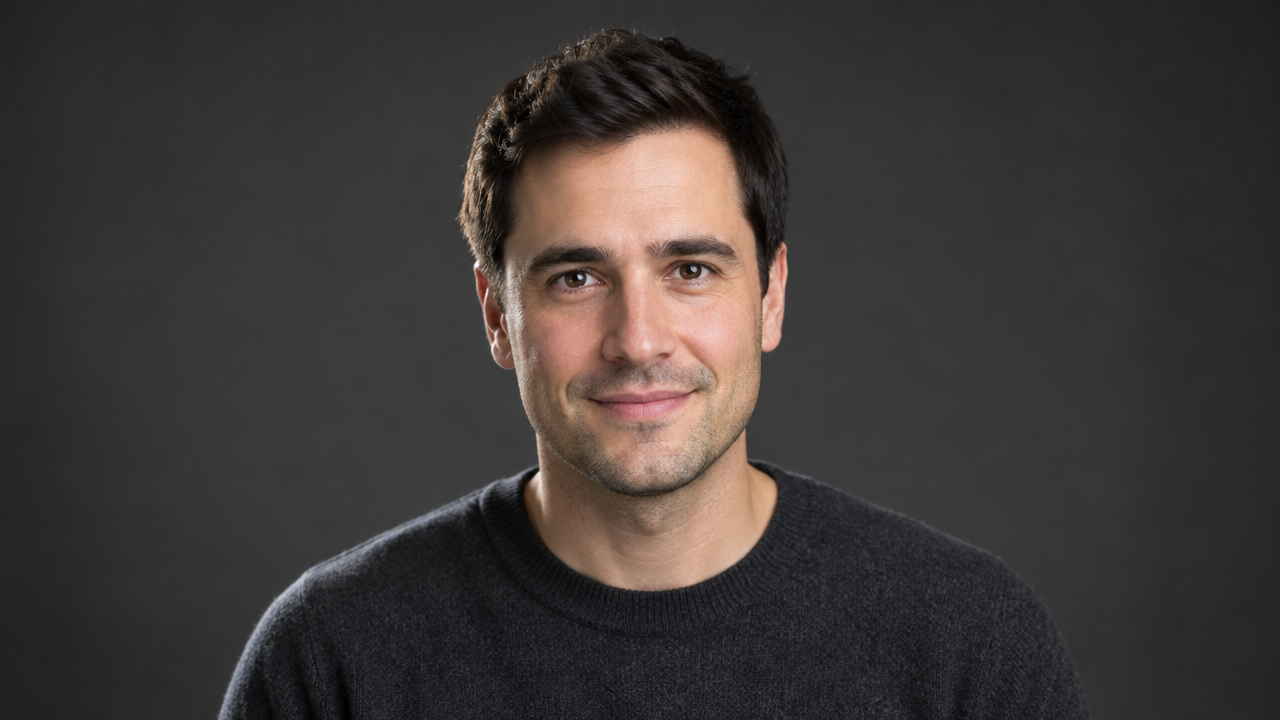
image_url
Prompt
Eine Moderatorin bzw. ein Moderator spricht direkt in die Kamera vor einem schlichten Studiohintergrund: Halbnahaufnahme von Kopf und Schultern, frontal ausgerichtet, stabiler Blickkontakt zur Kamera, leichte Kopfbewegungen und natürliche Gesten im Einklang mit dem Sprechrhythmus; weiches Hauptlicht von vorn links mit sanftem Aufhelllicht, neutraler dunkelgrauer nahtloser Hintergrund, geringe Schärfentiefe, 1080p-Breitbildkomposition im 16:9-Format, realistischer Corporate-Erklärstil, ruhiger und selbstbewusster Rhythmus.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
HeyGen Avatar IV Prompt-Formel-Karte: Visueller Leitfaden für strukturiertes Schreiben
Stil Erläuterung · Prompt-Engineering · sprechender Avatar
Referenz-Eingaben
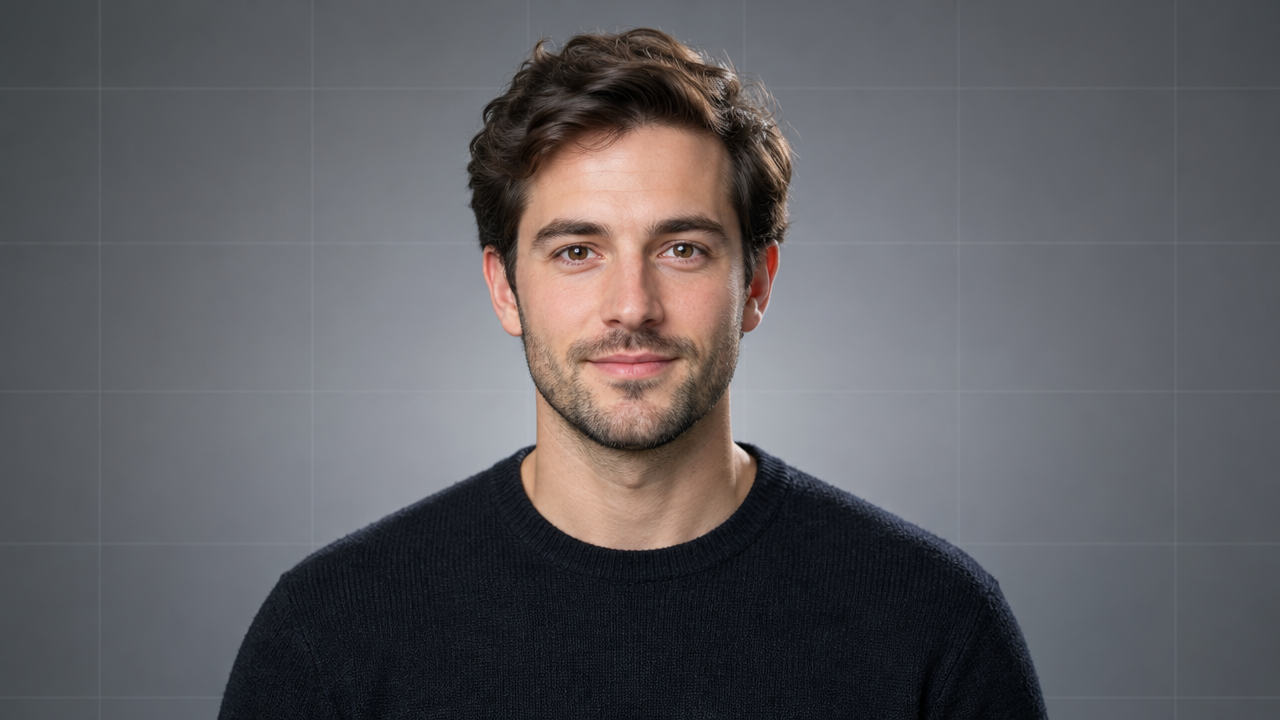
image_url
Prompt
Eine frontal auftretende Moderatorin spricht direkt in die Kamera in einem aufgeräumten Studio-Set und hält eine ausgedruckte Prompt-Formel-Indexkarte hoch; mittlere Nahaufnahme, langsame, dezente Kamerafahrt nach vorn und sanftes handgeführtes Schweben, weiches Hauptlicht mit Trennlicht für die Silhouette, geringe Schärfentiefe hält die Kartenränder klar lesbar und das Gesicht dennoch scharf; ruhiger, lehrreicher Rhythmus, in jedem Abschnitt kleine natürliche Gesten, die auf die Karte zeigen, Hintergrund als weicher neutraler Verlauf mit zarten Gitterlinien, die ein Dokument-Layout andeuten; klares Bild, hohe Detailtreue, 1080p-Anmutung.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Visuelle Notizen zur Kamerasprache: Avatar IV Sprech-Demo
Stil Kamerasprache · sprechender Avatar · Erläuterung
Referenz-Eingaben
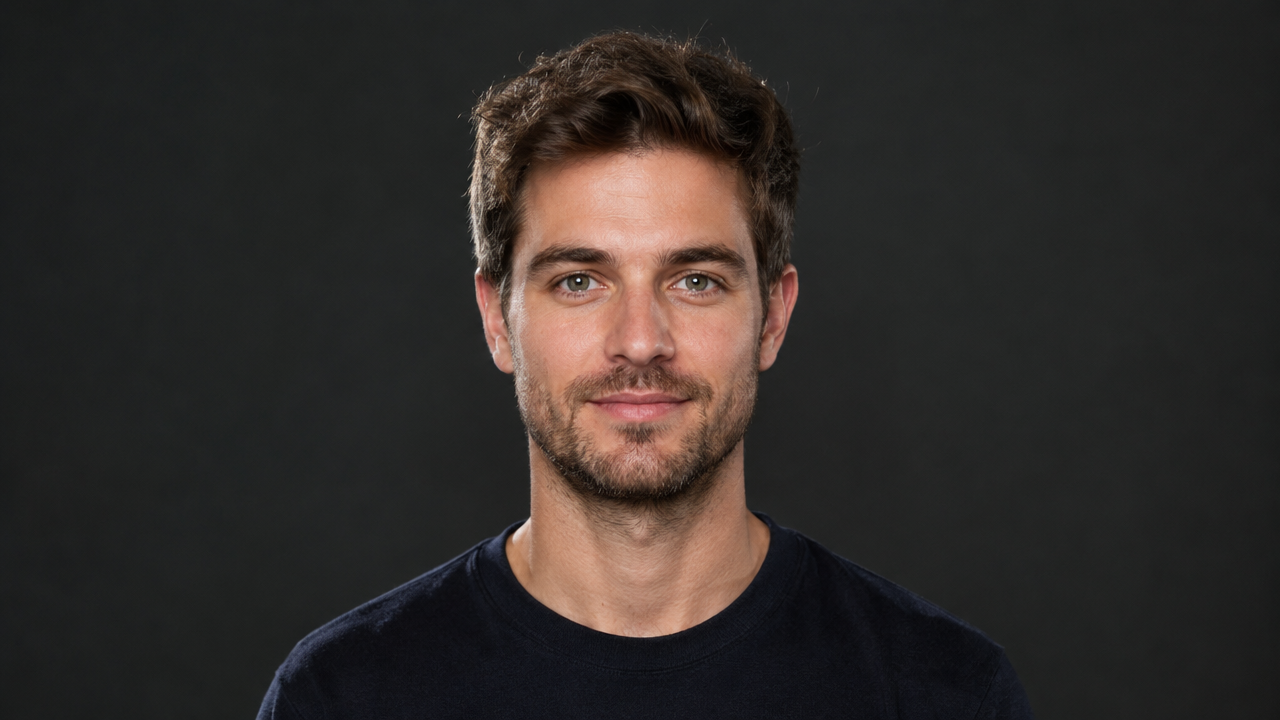
image_url
Prompt
Eine frontal zur Kamera ausgerichtete Person spricht mit ruhiger, erklärender Stimme direkt in die Kamera, als würde sie vor dem Objektiv eine visuelle Notiz zur Kamerasprache kommentieren. Der Blick ist stabil auf die Kamera gerichtet, der Kopf bewegt sich leicht und natürlich, gelegentlich mit erklärenden Gesten, die horizontalen Schwenk, Heranfahren und Auf- und Abbewegung andeuten. Neutrale Studiokomposition mit gleichmäßigem Licht, Hintergrund dunkel und entsättigt, insgesamt mit der Atmosphäre einer Bildschirmaufnahme, ruhiges Tempo, mit kurzen Pausen zwischen den einzelnen Kamerabewegungsbegriffen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
HeyGen Avatar IV Storyboard-Konzept: Vom Text zum sprechenden Bild
Stil sprechender Avatar · Storyboard · Erzählung
Referenz-Eingaben
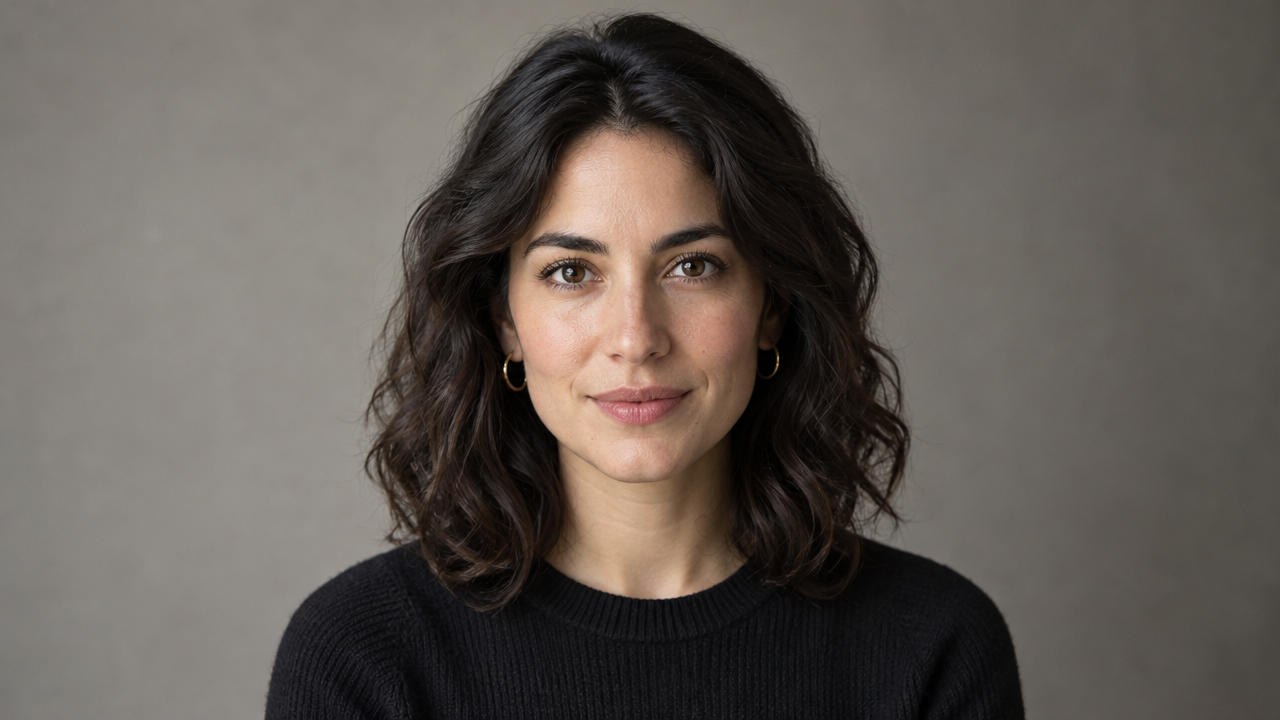
image_url
Prompt
Ein frontales Einzelporträt wird zu einem sprechenden Video verarbeitet: Die Person erzählt mit natürlicher Lippensynchronisation ein kurzes Storyboard-Voiceover, begleitet von leichten Kopfbewegungen und ausdrucksstarken Gesten, im 16:9-Format mit sauberem, neutralem Hintergrund, stabiler Halbnahaufnahme, weichem Hauptlicht und einem ruhigen, selbstbewussten Rhythmus.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
heygen-avatar-iv per second
| Einzelpreis | $0.150 |
|---|
Kurzbeschreibung
heygen-avatar-iv ist ein Modell von HeyGen für sprechende Avatar-Videos, das über die einheitliche Schnittstelle von HiAPI.ai aufgerufen wird. Entwickler laden ein frontales Porträtfoto hoch und geben einen Skripttext oder eine Audiodatei an, um ein sprechendes Video mit Lippensynchronisation, Gesichtsausdrücken und Gesten zu erzeugen. Unterstützt werden Ausgaben in 720p und 1080p sowie verschiedene Seitenverhältnisse – ideal für Entwickler und Content-Teams, die schnell digitale Sprecher oder sprechende Charaktere produzieren möchten.
Höhepunkte
- Ein einziges Foto erzeugt ein komplettes Sprechvideo – Es genügt ein frontales Porträtfoto zusammen mit einem Skript oder Audio; weder Dreharbeiten noch die Erstellung von 3D-Assets sind nötig, um ein fertiges Video zu erhalten.
- Mimik und Gestik folgen der Stimme – Die Ausgabe beschränkt sich nicht auf Lippenbewegungen: Gesichtsausdrücke und Kopfbewegungen verändern sich natürlich mit der Sprache und wirken nahezu wie eine echte sprechende Person.
- Texteingabe per Skript und Audioeingabe – Sie können direkt ein Skript eingeben und eine Stimme auswählen oder eine HTTPS-Audiodatei für die Lippensynchronisation übergeben, passend zu bestehenden Voiceover-Workflows.
- Konfigurierbares Bildformat und Hintergrund – Es stehen verschiedene Verhältnisse wie 16:9, 9:16 und 1:1 zur Verfügung; als Hintergrund können eine Volltonfarbe oder ein Bild festgelegt werden.
Funktionsbeschreibung
Sprechvideo aus Foto erzeugen: Mit einem frontalen Porträtfoto lässt sich ein Sprechvideo erzeugen; die Ausgabe ist eine Videodatei, die direkt als fertiges Video oder für die weitere Bearbeitung verwendet werden kann.
Skript in Sprache umwandeln und Lippenbewegungen steuern: Geben Sie einen Skripttext ein und wählen Sie eine integrierte Stimme; das Modell synthetisiert die Sprache und steuert den Avatar beim Sprechen. Ein Skript kann bis zu 5000 Zeichen lang sein.
Lippensynchronisation mit Audio: Mit einem HTTPS-Audiolink spricht das Foto passend zum Audio. Eine Audiodatei kann bis zu 600 Sekunden lang sein; in diesem Fall werden die Parameter für Skript und Stimme ignoriert.
Steuerung der Ausgabespezifikationen: Wählbar sind 720p oder 1080p sowie Seitenverhältnisse von 16:9, 9:16, 4:5, 5:4, 1:1 oder das des Originalbilds – passend für Querformat, Hochformat und quadratische Veröffentlichungsformate.
Hintergrundfüllung: Wenn das Ausgabeverhältnis vom Fotoverhältnis abweicht, können leere Bereiche mit einer Volltonfarbe oder einem Bild gefüllt werden, um leere Ränder zu vermeiden.
Anwendungsfälle
- Marketingteams erstellen Videos mit digitalen Sprechern – Mit Produktskripten und Fotos von Markenfiguren lassen sich sprechende Videos für Websites, Werbeflächen und Social Media erstellen, ohne Termine mit echten Darstellern zu planen.
- Schulungsabteilungen erzeugen Materialien für Erklärkurse – Kursunterlagen werden zu Skripten verarbeitet und in großer Zahl als Erklärvideos mit einheitlicher Darstellung erzeugt, die in Lernplattformen oder Kursmaterialien eingebettet werden.
- Kurzvideo-Creator produzieren Hochformat-Sprechvideos – Mit dem 9:16-Format und einer ausgewählten Stimme lassen sich Hochformat-Sprechmaterialien erzeugen, die direkt für Updates auf Kurzvideo-Plattformen genutzt werden.
- Mehrsprachige Anpassung bestehender Voiceovers – Vorhandene Voiceover-Audios werden für die Lippensynchronisation übergeben und zusammen mit einem Foto zu sprechenden Videos in der jeweiligen Sprache erzeugt, etwa für die Lokalisierung von Inhalten.
Einschränkungen und Auswahlhinweise
Das Eingabefoto muss ein klares, frontales Gesicht zeigen; Profilaufnahmen, Verdeckungen oder Gruppenfotos beeinträchtigen das Ergebnis deutlich, da die Ausgabequalität stark vom Ausgangsbild abhängt. Die Ausgabe ist ein Video und kein reiner Text; Skript oder Audio müssen im Voraus vorbereitet werden. Ein einzelnes Audio ist auf 600 Sekunden und ein Skript auf 5000 Zeichen begrenzt; längere Inhalte müssen in Abschnitte aufgeteilt werden. Wenn Sie nur vorgefertigte Avatar-Porträts oder digitale Doubles echter Personen benötigen, sollten Sie die entsprechenden anderen Modelllinien wählen.
Neuigkeiten
Changelog ansehen →- Neues Modell Neues Modell: heygen-avatar-iv – lade ein Porträtfoto hoch und erzeuge mit einem Skript und einer voreingestellten Stimme oder einer Audiodatei ein lippensynchrones Sprechvideo; bietet …
Häufige Fragen
Alle Fragen ansehen →-
Welche Eingaben benötigt HeyGen Avatar IV?
Ein Porträtfoto und eine gewählte Steuerungsmethode: entweder einen Sprechtext eingeben und eine Stimme auswählen oder eine Audiodatei hochladen. Wenn Sie den Sprechtext verwenden und keine Stimme auswählen, wird die Standardstimme Warm Pro Narrator verwendet.
-
Welche Art von Foto funktioniert am besten?
Am zuverlässigsten funktionieren Einzelporträts mit frontalem Gesicht, klaren und unverdeckten Gesichtszügen, gleichmäßiger Beleuchtung und natürlich geschlossenem Mund. Seitenprofile, Fotos mit Mundschutz, Gruppenfotos oder Fotos mit sehr kleinem Gesicht sind ungeeignet.
-
Wie lang ist das Ausgabevideo?
Es muss keine Dauer übergeben werden. Bei Sprachaufnahmen wird die Länge durch den Text und die Sprechgeschwindigkeit bestimmt; bei audio-getriebener Erzeugung entspricht sie der Länge des hochgeladenen Audios, wobei das Audio höchstens 600 Sekunden lang sein darf.
-
Welche Seitenverhältnisse und Auflösungen werden unterstützt?
Unterstützte Seitenverhältnisse sind 16:9, 9:16, 4:5, 5:4, 1:1 und auto (übernimmt das Seitenverhältnis des Fotos); unterstützte Auflösungen sind 720p und 1080p.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: heygen-avatar-iv
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für heygen-avatar-iv und Route default — siehe Parametertabelle unten.
voicestringOptionalStandard: "Warm Pro Narrator"minLength 1Gibt die Stimme an, die für das Skript des digitalen Avatars verwendet wird; Standard ist Warm Pro Narrator. Wird dieser Parameter ignoriert, wenn audio_url angegeben ist.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyAlle anzeigen (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringOptionalminLength 1maxLength 5000Der Skripttext, den der digitale Avatar vorlesen soll; erforderlich, wenn audio_url nicht angegeben ist.
audio_urlstringOptionalpattern ^https://HTTPS-Audioadresse für die Lippensynchronisation, maximale Dauer 600 Sekunden; nach der Angabe werden prompt und voice beide ignoriert.
image_urlstringPflichtpattern ^https://HTTPS-Adresse des Fotos, das animiert werden soll; muss ein klares, frontales einzelnes Gesicht enthalten, unterstützte Formate: jpg, jpeg, png, webp, gif, avif, heic, heif.
backgroundobjectOptional
Die Hintergrundeinstellung zum Füllen der Bereiche des Bildes, die nicht von der Person abgedeckt sind, wenn das Ausgabeseitenverhältnis nicht mit dem Originalfoto übereinstimmt; kann per Farbe oder Bild angegeben werden, Standard ist Weiß.
typestringPflichtDie Füllmethode des Hintergrunds; bestimmt, ob das Feld value als Farbe oder als Bild-URL interpretiert wird.
colorimagevaluestringPflichtminLength 1Der konkrete Wert des Hintergrunds: bei type als Farbe ein Hex-Farbwert #RRGGBB, bei Bild eine HTTPS-Bildadresse.
resolutionstringOptionalStandard: "720p"Die Auflösung des Ausgabevideos, Standard 720p.
720p1080paspect_ratiostringOptionalStandard: "16:9"Das Seitenverhältnis des Ausgabevideos, Standard 16:9; bei auto wird bevorzugt das Verhältnis des Quellfotos beibehalten, bei Nichtlesbarkeit wird auf 16:9 zurückgegriffen.
16:99:164:55:41:1autocallbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Veo 3.1 Fast Google $0.170 /Sekunde
-
 Wan 2.7 Video Alibaba $0.100 /Sekunde
-
 FLUX 3 Video Black Forest Labs $0.090 /Sekunde
-
 Wan 3.0 Video Alibaba $0.040 /Sekunde
-
 HeyGen Avatar V HeyGen $0.150 /Sekunde
-
 Seedance 2.5 ByteDance $0.121 /Sekunde
-
 Veo 3.1 Google $0.290 /Sekunde
-
 Runway Gen 4.5 Runway $0.172 /Sekunde
-
 PixVerse V6 PixVerse $0.036 /Sekunde
-
 Grok Imagine 1.5 xAI $0.011 /Sekunde
-
 MiniMax H3 MiniMax $0.072 /Sekunde
-
 Kling 2.5 Kuaishou $0.060 /Sekunde