
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
写真を1枚アップロードしスクリプトを用意するだけで、リップシンク・顔の表情・ジェスチャーを備えたトーキングアバター動画を生成できます。1280p以上の出力に対応し、デジタルプレゼンターやナレーションコンテンツに適しています
heygen-avatar-iv を試す
入力
作品ギャラリー
すべての作品を見る出力
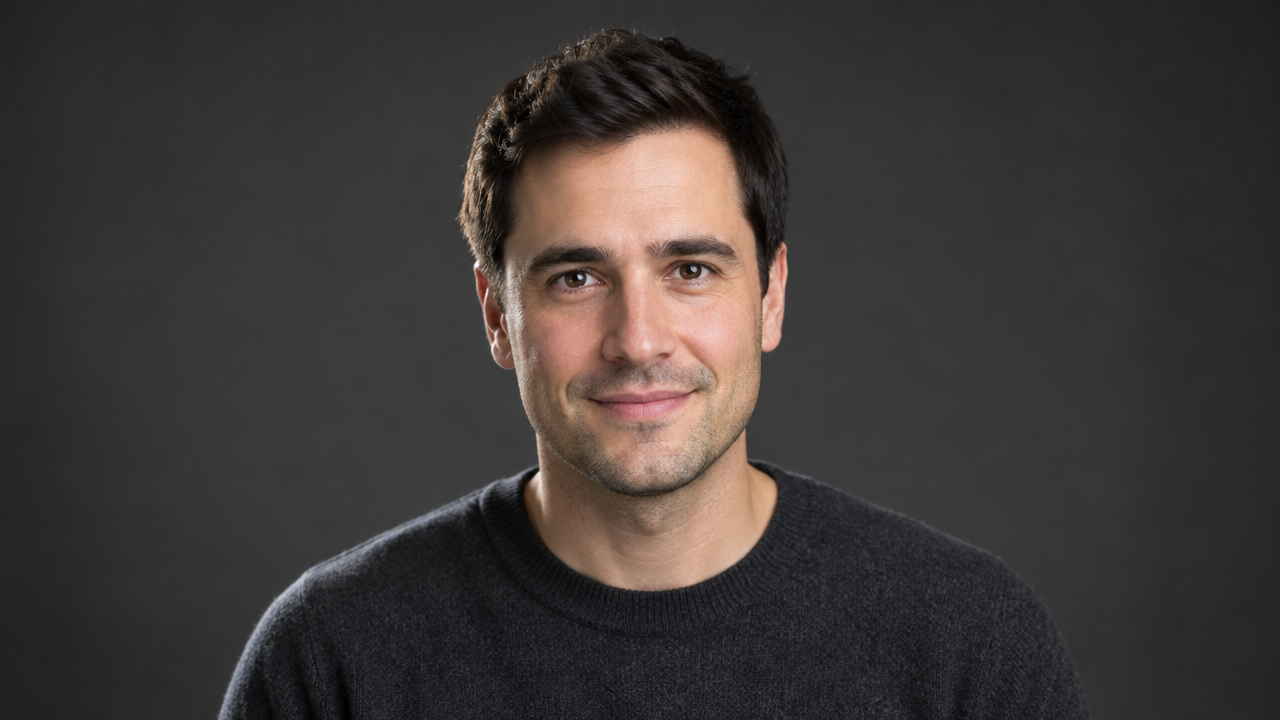
videoHeyGen Avatar IV テキストから動画生成機能図解
スタイル ナレーション · 解説 · アバタービデオ
参照入力
image_url
プロンプト
プレゼンターが簡潔なスタジオセットでカメラに向かって直接話している:頭と肩の構図、正面を向き、視線は安定してカメラと合い、話すリズムに合わせた軽微な頭の動きと自然なジェスチャー;左前方からの柔らかなキーライトと穏やかなフィルライト、ニュートラルなダークグレーのシームレス背景、浅い被写界深度、1080p 16:9 のワイドスクリーン構図、リアルな企業解説スタイル、落ち着いた自信のあるテンポ。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
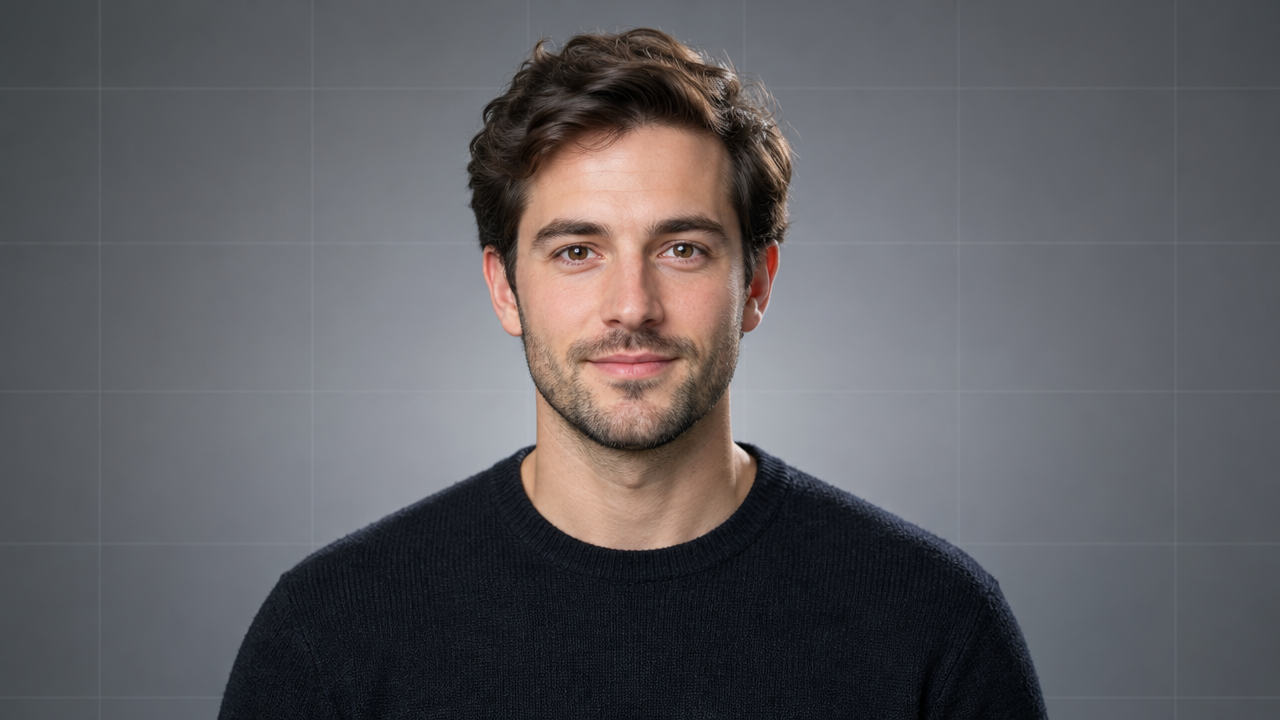
HeyGen Avatar IV プロンプト式カード:構造化記法のビジュアルガイド
スタイル 解説 · プロンプトエンジニアリング · トーキングアバター
参照入力
image_url
プロンプト
整ったスタジオセットで正面からカメラに向かって直接語りかける司会者が、印刷されたプロンプト式インデックスカードを掲げている。ミディアムクローズアップ、ゆっくりとした繊細なプッシュインと穏やかなハンドヘルドの揺らぎ、柔らかなキーライトとリム分離光、浅い被写界深度によりカードの縁ははっきりと読みやすく保たれ、顔もシャープなまま。落ち着いたテンポで教養ある雰囲気、各段落でカードを指す小さく自然なジェスチャーを添え、背景は柔らかなニュートラルグラデーションに淡いグリッド線が入り、ドキュメントのレイアウトを暗示する。クリアな映像、高精細、1080p の質感。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
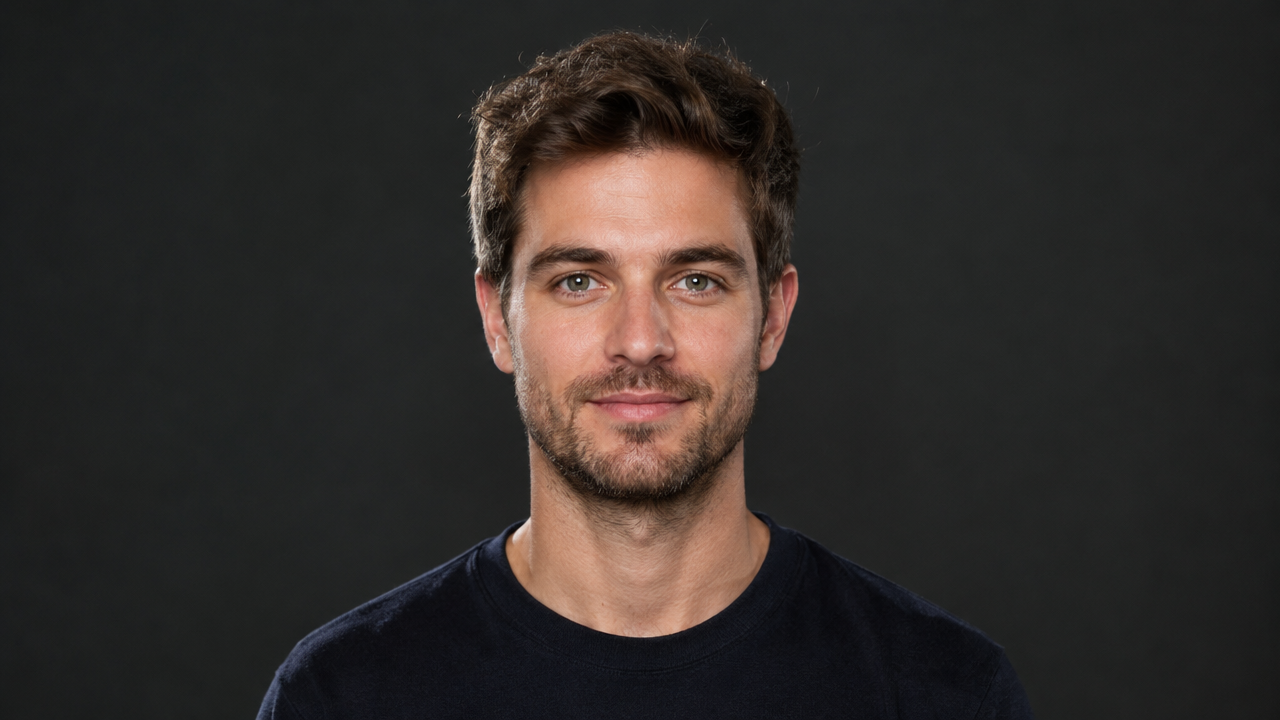
カメラワーク言語のビジュアルノート:Avatar IV 口播デモ
スタイル カメラ言語 · トーキングアバター · 解説
参照入力
image_url
プロンプト
カメラに正面を向いた出演者が、落ち着いた解説口調でカメラに向かって直接語りかけ、まるでカメラの前でカメラワークに関するビジュアルノートに注釈を付けているかのようです。視線は安定してレンズを見つめ、頭部はわずかに自然に動き、時折パン、プッシュイン、ティルトを示すような説明のジェスチャーを交えます。ニュートラルで均一な照明のスタジオ構図、背景は暗く低彩度で、全体にスクリーンレコーディングのような雰囲気があり、テンポは落ち着き、各カメラワーク用語の間に短い間を置きます。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
料金
heygen-avatar-iv per second
| 単価 | $0.150 |
|---|
位置づけの概要
heygen-avatar-iv は HeyGen が提供するトーキングアバター動画モデルで、HiAPI.ai の統合インターフェースを通じて呼び出せます。開発者は正面の顔写真を1枚アップロードし、台本テキストまたは音声を渡すだけで、リップシンク、表情、ジェスチャーを伴うトーキング動画を生成できます。720p と 1080p の出力および複数のアスペクト比に対応し、デジタルスピーカーやキャラクターのナレーション素材を素早く制作したい開発者やコンテンツチームに適しています。
主な特長
- 1枚の写真でトーキング動画全体を生成——正面の顔写真と台本または音声だけで、撮影や3Dアセットの構築なしに完成映像が得られます。
- 表情とジェスチャーが音声に連動——出力は唇の動きの同期にとどまらず、顔の表情や頭の動きが音声に合わせて自然に変化し、実際の人物のナレーションに近い見栄えになります。
- 台本テキストと音声の2入力に対応——台本を記入して音色を選択するか、HTTPS 音声を渡してリップシンクを行うことができ、既存のアフレコフローに適合します。
- アスペクト比と背景を設定可能——16:9、9:16、1:1 などの各種比率に対応し、単色または画像背景で画面を埋めるよう指定できます。
機能説明
写真からトーキング動画を生成:正面の顔写真を1枚渡すだけでトーキング動画を生成でき、出力は動画ファイルとして完成映像や後続の編集にそのまま利用できます。
台本を音声化して口元を動かす:台本テキストを記入し内蔵音色を指定すると、モデルが音声を合成してアバターに話させます。1つの台本は最大5000文字です。
音声リップシンク:HTTPS 音声リンクを渡すと、写真が音声の口元に合わせて話します。1つの音声は最大600秒で、この場合台本と音色のパラメータは反映されません。
出力仕様の制御:720p または 1080p の解像度を選択でき、16:9、9:16、4:5、5:4、1:1 または元画像に合わせる比率を設定できます。横画面、縦画面、正方形の掲載枠に対応します。
画面背景の埋め込み:出力比率が写真の比率と一致しない場合、単色または画像背景で余白領域を埋め、画面に空きの縁が生じないようにできます。
想定される利用シーン
- マーケティングチームによるデジタルスピーカー動画の制作——製品台本とブランド人物の写真でナレーション動画を生成し、公式サイト、広告枠、SNS 配信に使用。実演者の出演スケジュール調整が不要です。
- 研修部門による解説コース素材の生成——研修教材を台本として書き、統一された人物イメージの解説動画をバッチ生成して、学習プラットフォームや教材に埋め込みます。
- ショート動画クリエイターによる縦画面ナレーションの制作——9:16 のアスペクト比と選択した音色で縦画面ナレーション素材を生成し、ショート動画プラットフォームのコンテンツ更新に直接使用します。
- 既存アフレコを活用した多言語コンテンツの適応——既存のアフレコ音声を渡してリップシンクを行い、写真と組み合わせて対応言語のナレーション映像を生成し、コンテンツのローカライズに活用します。
制限と選定のアドバイス
入力する写真は鮮明な正面の顔である必要があり、横顔、遮蔽、複数人の集合写真は効果に明らかな影響を与えます。生成品質は元画像への依存度が大きくなります。出力は純粋なテキストの完成映像ではなく動画であるため、事前に台本や音声を準備する必要があります。1つの音声は最大600秒、台本は最大5000文字で、超長いコンテンツは分割して生成する必要があります。あらかじめ用意されたアバターや実在人物のデジタルツインのみが必要な場合は、対応する別のモデル回線を選択してください。
最新情報
更新履歴を見る →- 新しいモデル 新モデル追加:heygen-avatar-iv、人物写真を1枚アップロードするだけで、セリフとプリセット音声または駆動音声を使ってリップシンクしたトーキング動画を生成可能。提供…
よくある質問
よくある質問を見る →-
HeyGen Avatar IV にはどのような入力が必要ですか?
人物写真1枚に加えて、駆動方法を1つ選択します。セリフを入力して音声を選ぶか、音声ファイルをアップロードします。セリフ使用時に音声を選ばない場合は、デフォルト音声の Warm Pro Narrator が使用されます。
-
どのような写真が最も効果的ですか?
正面を向き、五官がはっきりと隠れず、光が均一で、口を自然に閉じた单人写真が最も安定した効果を発揮します。横顔、マスク着用、複数人の集合写真、または顔がとても小さい写真は適していません。
-
出力される動画の長さはどれくらいですか?
長さを指定する必要はありません。セリフの音声合成では、長さはセリフと話す速さによって決まります。音声駆動の場合は、アップロードした音声の長さと同じになり、音声は最長 600 秒です。
-
どのアスペクト比と解像度に対応していますか?
アスペクト比は 16:9、9:16、4:5、5:4、1:1 および auto(写真の比率を引き継ぐ)に対応しています。解像度は 720p と 1080p に対応しています。
生成タスクの作成
https://api.hiapi.ai/v1/tasks ヘッダー
Authorizationstring必須アカウントの API キー。すべてのリクエストで必須です。例:Bearer YOUR_HIAPI_API_KEY。API キーを取得
Content-Typestring任意リクエストボディは常に JSON として解析されます。送信する場合は application/json(charset 付き可)のみ受け付け、他の値は 415 を返します。例:application/json。
Idempotency-Keystring任意冪等キー。最大 255 バイト。同じアカウントで同じキーの再試行はタスクを 1 つだけ作成し、リプレイは最初の taskId を返します。
ネットワークタイムアウトやクライアントの自動再試行時、同じキーではタスクを 1 回だけ作成し、二重課金は発生しません(適用範囲 = API キーのアカウント)。業務側の一意識別子(例:"order-42")をキーに使うことを推奨します。同じキーのリプレイは最初の taskId を返し、キーは初回送信から 24 時間で失効します。詳細なシナリオ表は統一非同期 API の紹介ページをご覧ください。
ボディ
modelstring必須現在の固定値:heygen-avatar-iv
routestring任意現在の固定値:default
inputobject必須
heygen-avatar-iv とルート default の業務パラメータオブジェクト。下のパラメータ表を参照してください。
voicestring任意デフォルト: "Warm Pro Narrator"minLength 1デジタルヒューマンがスクリプトを読み上げる際に使用する音色を指定します。デフォルトは Warm Pro Narrator です。audio_url が提供された場合、このパラメータは無視されます。
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer Brittneyすべて表示(94 件)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstring任意minLength 1maxLength 5000デジタルヒューマンが読み上げるスクリプトのテキストです。audio_url が提供されていない場合は必須です。
audio_urlstring任意pattern ^https://リップシンクに使用する HTTPS 音声アドレスです。長さは最大 600 秒です。提供された場合、prompt と voice は無視されます。
image_urlstring必須pattern ^https://アニメーションを駆動する写真の HTTPS アドレスです。鮮明で正面を向いた単一の顔が含まれている必要があり、jpg、jpeg、png、webp、gif、avif、heic、heif 形式に対応しています。
backgroundobject任意
出力のアスペクト比が元の写真と一致しない場合に、画面内で人物が覆っていない領域を埋めるための背景設定です。色または画像で指定でき、デフォルトは白色です。
typestring必須背景の塗りつぶし方式です。value フィールドを色として解釈するか画像 URL として解釈するかを決定します。
colorimagevaluestring必須minLength 1背景の具体的な値です。type が色の場合は #RRGGBB 形式の 16 進数色値を、画像の場合は HTTPS 画像アドレスを指定します。
resolutionstring任意デフォルト: "720p"出力動画の解像度です。デフォルトは 720p です。
720p1080paspect_ratiostring任意デフォルト: "16:9"出力動画のアスペクト比です。デフォルトは 16:9 です。auto を指定した場合は元の写真の比率を優先して維持し、読み取れない場合は 16:9 にフォールバックします。
16:99:164:55:41:1autocallbackobject任意
終了状態の通知設定。省略した場合はコールバックされず、呼び出し側でポーリングします。
作成時に callback.url を指定すると、タスク終了時に HiAPI があなたのサービスへ POST し、ポーリングが不要になります。コールバックのリクエストボディはタスク詳細と同構造です。署名検証・再送・冪等の詳細は統一非同期 API 紹介ページのコールバック説明を参照してください。
urlstring必須callback を指定する場合は必須。タスク終了後にこの URL へ POST します。有効な http(s) URL である必要があります。
whenstring任意デフォルト: "final"現在は final のみ対応(success / fail の両方で通知)。
finalstoragestring任意デフォルト: "temp"成果物の保存期間:temp(デフォルト・約 7 日)または persistent(長期保存・サイズ課金)。残高不足や保存上限超過の場合は temp に自動降格します。実際に適用された段階はタスク詳細レスポンスで確認できます。
temppersistentリクエスト例
# 非同期タスクを送信。成功すると即座に taskId を返します(生成完了は待ちません)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
タスク詳細の取得
https://api.hiapi.ai/v1/tasks/:id レスポンスフィールド
taskIdstring必須タスク ID。先頭は固定で tk-hiapi-。
modelstring必須解決済みのモデル完全名。route パラメータで送信したタスクは base@route(例:gpt-image-2/text-to-image@ext)を返し、それ以外は送信時のモデル名と同一です。
routestring任意route パラメータを明示して送信したタスクでのみ出現し、送信時の値をエコーします。
statusstring必須タスク状態。
queued キュー投入済み、未開始。
handling 処理中。
archiving 処理完了、成果物準備中。
success 終端:完了。成果物利用可能(output を返却)。
fail 終端:失敗(error を返却)。
送信後は status で判断します:success と fail が終端、それ以外は非終端です。1〜3 秒間隔で終端までポーリングすることを推奨します。成功したら output[].url から成果物をダウンロードし、expireAt までに保存先へ転送してください。長期保存が必要な場合は作成時に storage: "persistent" を指定します。
creatednumber必須タスク作成時刻(Unix 秒)。
completednumber必須終了状態になった Unix 秒。非終端では 0 固定。
outputarray任意
status == success のときのみ出現。成果物リスト — 常に配列で、1 タスクで複数の type を同時に返すことがあります(例:video + first_frame)。
Array [ object ]
配列要素
urlstring必須成果物の URL。直接ダウンロードできます。
typestring必須現在の候補値:video、image、audio、first_frame、last_frame、thumbnail。今後拡張される可能性があります。
expireAtnumber必須成果物にアクセスできる期限(Unix 秒)。期限までにダウンロードまたは転送してください。
errorobject任意
status == fail のときのみ出現。
codestring必須業務エラーコード。
messagestring必須エラーの説明。
レスポンス例
成功
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
処理中(非終端)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
失敗
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}関連記事
すべての記事を見る →-

チュートリアル
HiAPI で kling-4.0/image-to-video を呼び出す方法:curl、Python、ポーリング
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI API で kling-4.0/text-to-video を使う方法:curl、Python、そして実行可能なリクエスト例
開発者向け実践ガイド:シネマティックなプロンプト、同期オーディオ、非同期ポーリング、出力のダウンロード
-

チュートリアル
HiAPI 上的 kandinsky-6.0-pro/image-to-video 教程:curl + Python
在 HiAPI 上发起一次可用的图生视频请求:从首帧上传到异步轮询再到最终下载
-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする
関連モデル
すべてのモデルを見る →同タイプ
-
 Hailuo 2.3 MiniMax $0.270 /動画
-
 Wan 2.6 Flash Alibaba $0.043 /秒
-
 Seedance 2.0 ByteDance $0.017 /秒
-
 HappyHorse 1.1 Alibaba $0.160 /秒
-
 Kling 2.5 Kuaishou $0.060 /秒
-
 PixVerse V6 PixVerse $0.036 /秒
-
 Runway Gen 4.5 Runway $0.172 /秒
-
 Ray 3.2 Luma $0.214 /動画
-
 Kling 3.0 Turbo Kuaishou $0.130 /秒
-
 Veo 3.1 Fast Google $0.170 /秒
-
 Vidu Q3 Vidu $0.149 /秒
-
 FLUX 3 Video Black Forest Labs $0.090 /秒
