
Comparativa
claude-sonnet-4-6 comparado horizontalmente con modelos similares: guía de selección y migración para desarrolladores
Desde el posicionamiento de capacidades y el coste por token hasta el coste de migración: un marco de comparación aplicable para equipos de ingeniería
Por qué las comparaciones de modelos a menudo no llegan a una conclusión
En la mayoría de los equipos, la comparación de modelos acaba convirtiéndose en una tabla de puntuaciones: se copian los números de varios modelos candidatos en los rankings públicos y se elige el de mayor puntuación para integrarlo en el sistema. Este proceso parece racional, pero en la práctica rara vez produce conclusiones fiables, normalmente por tres razones.
Los rankings no miden tu tarea
Las evaluaciones públicas miden el rendimiento en un conjunto de preguntas estandarizadas, mientras que tus solicitudes de negocio tienen su propia distribución: longitud de los prompts, densidad de terminología del dominio, formato de salida requerido y tolerancia a la latencia; nada de esto coincide del todo con la configuración de los rankings. Un modelo que lidera el ranking general no necesariamente es mejor en tu tarea de clasificación con prompts cortos, y en una canalización que exige salida JSON estricta podría incluso ser peor.
Comparar solo el precio unitario lleva a calcular mal la cuenta
La etiqueta de precio de un modelo es un número único, pero el coste real depende de la forma de tus solicitudes. Para el mismo volumen de negocio, distintas proporciones de tokens de entrada y salida pueden suponer diferencias de varias veces en el gasto real; un reintento o un reenvío tras truncamiento añaden aún más coste. Colocar solo los precios unitarios en una fila equivale a ignorar la estructura de costes.
El coste de migración se asume como cero
Cambiar de modelo no es solo cambiar una dirección de API. El estilo de los prompts, la lógica de análisis de la salida y las rutas de manejo de errores y truncamientos también deben adaptarse. Este trabajo suele ser mucho mayor que «hacer funcionar la interfaz», pero rara vez aparece en las tablas comparativas.
Un enfoque más razonable es dividir la comparación en tres dimensiones paralelas: adecuación a la tarea, estructura de costes y volumen de trabajo de migración. Primero hay que aclarar en qué capa de la pila tecnológica se ubicará el modelo, luego revisar el precio y, por último, estimar el coste de migración; si se invierte el orden, las conclusiones suelen desviarse.
Antes de comparar, aclara tres cosas
- ¿A qué tipo de tarea pertenece este lote de solicitudes y cuál es el coste de un fallo?
- ¿La principal fuente de coste son los tokens de entrada o los de salida?
- ¿Qué tan cerca están los prompts y el código de análisis existentes del estilo de salida del modelo objetivo?
Una vez respondidas estas tres preguntas, el rango de modelos candidatos suele haberse reducido a dos o tres, y el trabajo restante es la evaluación detallada.
Primero estratifica las tareas, luego elige el modelo
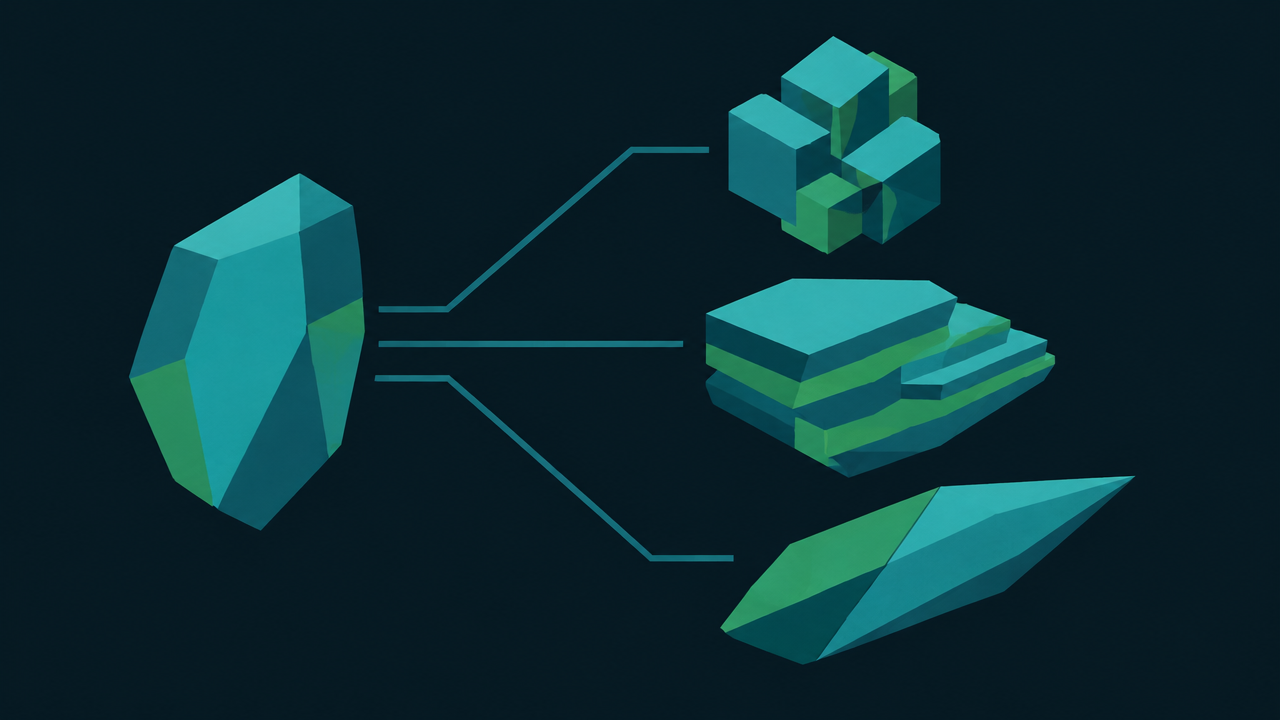
Comparar parámetros modelo por modelo es ineficiente porque asume que todas las solicitudes tienen la misma importancia. En un negocio real, la distribución de valor de las solicitudes es muy desigual: unas pocas determinan la experiencia de usuario y los ingresos, mientras que la mayoría solo mantiene el sistema en funcionamiento. Si primero se estratifican las tareas, cada capa solo responde a las métricas que le conciernen, y la selección se vuelve mucho más clara.
Primera capa: razonamiento complejo de alto valor
La forma típica son solicitudes de razonamiento en varios pasos, comprensión de documentos largos y juicios que requieren contexto. El volumen de esta capa no es grande, pero el coste de un error es alto. Las métricas de interés son: tasa de acierto de las conclusiones, grado de seguimiento de instrucciones complejas y estabilidad en casos límite. El precio en esta capa normalmente no es la restricción principal, porque el volumen es pequeño y el coste absoluto es controlable.
Segunda capa: salida estructurada de gran volumen
La forma típica son clasificación, extracción, resumen y reescritura con formato: gran volumen de solicitudes, salidas cortas por solicitud y requisitos de formato estable. Las métricas de interés en esta capa son: tasa de salida analizable, coste por solicitud, rendimiento y límites de velocidad. Las diferencias marginales de capacidad del modelo influyen poco aquí; lo que realmente determina la experiencia es la proporción de reintentos fallidos y la estructura de costes.
Tercera capa: solicitudes de cola larga y bajo valor
La forma típica son reconocimiento de intenciones, preguntas y respuestas simples y preprocesamiento de contenido: solicitudes que toleran cierto nivel de error y que pueden degradarse tras un fallo. Las métricas de interés en esta capa son casi solo coste y latencia; se puede aceptar un modelo algo menos capaz e incluso degradar activamente en horas punta.
Dos beneficios de la estratificación
Primero, convierte la pregunta «qué modelo es mejor» en «qué modelo encaja mejor en esta capa», evitando que una puntuación total pretenda cubrir todos los escenarios. Segundo, permite de forma natural el uso combinado: la capa de alto valor usa modelos más capaces, la capa de gran volumen usa modelos con mejor coste y la capa de cola larga usa la solución de respaldo más económica; el resultado global y el coste son más controlables que con un esquema de un solo modelo.
Al dibujar el diagrama de capas, se recomienda anotar junto a cada capa sus métricas clave y la tasa de fallo aceptable. Este diagrama se usará repetidamente: al seleccionar modelos sirve para filtrar candidatos y, tras el despliegue, para decidir si conviene cambiar de modelo.
Posicionamiento de claude-sonnet-4-6 y límites de la información conocida
claude-sonnet-4-6 es ofrecido por Anthropic, su tipo de salida es texto y su forma de facturación es por token. Estos tres puntos son todo lo que este artículo puede afirmar con certeza sobre él, y también la información que más conviene fijar antes de hacer una comparación horizontal.
Qué implican estas tres informaciones
Que el tipo de salida sea texto indica que es adecuado para tareas cuyo soporte es la palabra escrita, como diálogo, generación, extracción y reescritura; los escenarios con entrada y salida multimodal quedan fuera de su alcance. La facturación por token implica que el modelo de costes debe construirse en torno a la cantidad de tokens de entrada y salida, no por número de solicitudes o duración de la llamada: con el mismo número de solicitudes, distintas distribuciones de longitud producen facturas completamente distintas.
Campos sobre los que este artículo no afirma nada
Los siguientes parámetros no reciben conclusiones concretas en este artículo y deben consultarse en la documentación oficial:
- Límite máximo de contexto y restricciones de longitud de entrada;
- Límites de velocidad, cuotas de concurrencia y comportamiento de tiempo de espera;
- Valores de precio concretos y cualquier criterio de descuento;
- Detalles de implementación y grado de soporte de capacidades como salida estructurada y llamada a herramientas;
- Ritmo de iteración de versiones y política de obsolescencia.
Dejar estos campos vacíos no es una evasión, sino una disciplina de ingeniería deliberada: este tipo de información cambia con frecuencia y puede quedar obsoleta en el momento en que se copia en un plan técnico. Lo más prudente es reservar las filas correspondientes en la tabla comparativa y que la persona responsable de la selección consulte y registre la fecha de verificación en la documentación oficial el día de la evaluación.
La postura correcta al comparar
Trata claude-sonnet-4-6 como un candidato de «salida de texto y facturación por token» y colócalo en la estratificación de tareas anterior. Qué papel puede desempeñar en la capa de razonamiento de alto valor y en la capa de salida estructurada por lotes depende de los resultados de tus pruebas, no de ninguna tabla de parámetros. Con esta premisa, pasar a la lista de dimensiones de la siguiente sección hace que la comparación tenga sentido.
Qué dimensiones considerar en una comparación horizontal
Una tabla comparativa reutilizable tiene modelos candidatos en las filas y dimensiones de evaluación en las columnas. Si las dimensiones están mal elegidas, la tabla más bonita no sirve de nada. Las siguientes columnas son las que realmente sustentan las decisiones de ingeniería.
Tipo de salida
Texto, estructurada o multimodal determina en qué capa de tareas puede entrar el modelo. Un modelo cuyo tipo de salida no coincide, por muy capaz que sea, no puede usarse directamente; esta columna debe filtrarse antes de comparar.
Unidad de facturación y estructura de tokens
Algunos modelos facturan por token, con precios posiblemente distintos para entrada y salida; otros facturan por solicitud o por duración. En los modelos facturados por token, hay que modelar por separado los tokens de entrada y los de salida, porque su proporción varía enormemente según la tarea. En tareas con salidas largas, el peso del coste en el lado de salida aumenta de forma notable.
Contexto y restricciones de entrada
El límite de contexto determina cuánto material cabe en una solicitud. Si el negocio requiere procesar documentos largos, esta columna elimina directamente a parte de los candidatos; si las solicitudes son todas cortas, su peso debe reducirse.
Salida estructurada y llamada a herramientas
Cuando la canalización depende del análisis JSON, la estabilidad del formato de salida y la tasa de analizabilidad importan más que la puntuación del ranking. Se recomienda medir esta columna con tus propias muestras y registrar la tasa de fallos de análisis, en lugar de limitarse a leer la descripción de la documentación.
Estabilidad y límites de velocidad
Los límites de velocidad, el comportamiento de tiempo de espera y el diseño de códigos de error determinan el coste de reintentos en escenarios de alta concurrencia. Un modelo con limitación estricta y reintentos costosos tendrá un coste real superior al coste nominal.
Madurez del ecosistema y la documentación
Que la documentación sea clara, que los mensajes de error permitan diagnosticar y que los SDK y ejemplos estén completos afecta al coste de integración y resolución de problemas. Esta columna es subjetiva pero real; se recomienda que la puntúen los ingenieros que realmente escriben el código.
Coste de migración
Una columna propia, con puntuación propia. Diferencias en la estructura de prompts, diferencias en el estilo de salida, volumen de cambios en la lógica de análisis y volumen de reescritura del manejo de errores: estima un rango de trabajo para cada uno de los cuatro aspectos.
Cómo usar esta tabla
No calcules una puntuación total ponderada para cada columna. Lo más práctico es fijar primero umbrales obligatorios (tipo de salida, contexto, estabilidad de formato), descartar los candidatos que no los cumplen y comparar los restantes capa por capa. Las diferencias fuera de los umbrales rara vez bastan para justificar un cambio de modelo.
Recomendaciones de selección por escenario
Las siguientes recomendaciones son orientativas, no concluyentes; cada escenario incluye pasos de validación y la decisión final debe provenir de tus propias muestras.
Diálogo y generación de contenido
Este tipo de tareas exige naturalidad del texto y seguimiento de instrucciones, y la salida por solicitud suele ser larga, con un peso elevado de tokens de salida. claude-sonnet-4-6, como modelo de salida de texto, es un candidato razonable para este escenario. Pasos de validación: extrae entre veinte y treinta conversaciones reales y compara la relevancia, el control de longitud y la coherencia de tono de las respuestas, registrando también la proporción de tokens de entrada y salida de cada solicitud para estimar la estructura de costes.
Procesamiento de texto por lotes
Tareas como clasificación, extracción y resumen tienen mucho volumen y salidas cortas; lo que se pone a prueba es la tasa de analizabilidad y el coste unitario. Se recomienda ejecutar claude-sonnet-4-6 y un candidato más económico sobre el mismo lote de muestras y comparar la tasa de fallos de análisis y el consumo total de tokens, en lugar de mirar solo el resultado de cada caso.
Canalizaciones que requieren salida estructurada
Primero prueba la estabilidad del formato; lo demás viene después. Construye un conjunto de pruebas con el esquema de salida real de tu entorno de producción y cuenta la proporción que requiere reintentos o correcciones. Si la tasa de fallos es claramente alta, aunque el modelo sea más capaz, no es adecuado para la ruta principal; puede quedar como alternativa o para procesamiento offline.
Tareas secundarias sensibles al coste
Tareas como reconocimiento de intenciones, preprocesamiento y decisiones de enrutamiento pueden degradarse o ignorarse tras un fallo y no merecen un modelo costoso. Se recomienda usar directamente el candidato de menor coste como respaldo y reservar claude-sonnet-4-6 para las capas que realmente lo necesitan.
Principio general
Ningún escenario merece un cambio total «con el mismo criterio para todo». Prueba primero en una capa, obtén datos comparativos de resultado y coste, y luego decide si ampliar el alcance. Si este paso se hace bien, las decisiones posteriores requerirán mucho menos esfuerzo.
Aspectos a tener en cuenta en la migración e integración
Los puntos donde más problemas surgen al cambiar de modelo a menudo no están en la llamada a la interfaz en sí, sino fuera de ella. Los siguientes son errores que se repiten en migraciones reales.
Diferencias en el estilo de los prompts
Distintos modelos tienen distinta sensibilidad a las instrucciones: algunos necesitan restricciones de formato más explícitas y otros son más sensibles al número de ejemplos. Trasladar directamente los prompts antiguos suele degradar el resultado, y es fácil atribuirlo erróneamente a que «el modelo no es suficientemente capaz». Al migrar, hay que tratar la reescritura de prompts como una partida de trabajo independiente y conservar registros de comparación con la versión anterior.
Análisis de salida y manejo de truncamientos
Cuando la salida de texto debe analizarse, hay que asumir que puede estar truncada, llevar prefijos sobrantes o no ser JSON puro del todo. La capa de análisis debe ser tolerante: eliminar primero el contenido irrelevante y luego analizar; si el análisis falla, registrar el texto original en lugar de descartarlo, para facilitar la atribución posterior.
Coste de reintentos y facturación por token
La facturación por token implica que cada reintento vuelve a pagar el bloque completo de tokens. Si la lógica de reintentos es agresiva, la factura se infla de forma evidente. Se recomienda añadir un límite de reintentos y una estrategia de retroceso, y monitorizar por separado la tasa de reintentos: una tasa alta suele indicar que hay que ajustar los prompts o las restricciones de formato, no que haya un problema de red.
Despliegue gradual y evaluación de regresión
No hagas un cambio total de una vez. Despliega de forma gradual por proporción de tráfico, mantén el modelo antiguo como referencia y ejecuta regresiones con el mismo lote fijo de muestras. Las métricas de evaluación deben cubrir al menos: tasa de éxito de la tarea, tasa de éxito del análisis de formato, longitud media de salida y consumo de tokens por solicitud exitosa.
Diferencias en el manejo de errores
Las condiciones de activación y los mensajes de error de limitación de velocidad, tiempo de espera e intercepción de contenido varían. La capa de integración debe unificarlos en códigos de error internos para evitar que el código de negocio quede lleno de comprobaciones específicas de cada proveedor.
Dejar una vía de salida
El plan de migración debe indicar claramente las condiciones de reversión: qué métricas y por debajo de qué nivel obligan a volver al modelo anterior. Una migración con plan de reversión reduce mucho la carga psicológica del equipo y facilita mantener la objetividad durante el despliegue gradual.
Controlar costes y riesgo de dependencia con una capa de integración unificada
El mercado de modelos cambia más rápido que el ciclo de refactorización de la mayoría de los equipos. Vincular directamente el código de negocio a la forma de interfaz de un proveedor ahorra esfuerzo a corto plazo, pero a largo plazo se convierte en una carga: cada cambio de modelo obliga a modificar la lógica de negocio, y el ritmo de precios y versiones lo decide completamente el proveedor.
Forma de interfaz unificada
La práctica consiste en concentrar las llamadas a modelos en una capa de integración interna que exponga una estructura de solicitud y respuesta coherente, absorbiendo las diferencias entre proveedores dentro de la capa. El código de negocio solo depende de esta capa y no le importa quién está detrás. Así, al cambiar de modelo los cambios se concentran en un solo lugar y no se dispersan entre decenas de puntos de llamada.
Enrutamiento por tarea
Combinada con la estratificación de tareas anterior, la capa de integración puede distribuir las solicitudes a distintos modelos según el tipo de tarea: el razonamiento de alto valor va a modelos más capaces, las tareas por lotes a modelos con mejor coste y las solicitudes de cola larga a la solución de respaldo. Las reglas de enrutamiento deben ser configuración y no código fijo, para poder ajustarlas según los datos medidos.
Estrategia de degradación
Cuando un modelo sufre limitación de velocidad o tiempo de espera, la capa de integración debe poder degradar automáticamente a un modelo alternativo en lugar de hacer fallar la solicitud. La degradación debe registrarse en logs y revisarse periódicamente: una frecuencia alta indica que hay que ajustar la planificación de capacidad o las reglas de enrutamiento.
Conservar la capacidad de cambio
El mayor valor de una capa de integración unificada no es ahorrar dinero, sino conservar la capacidad de elegir. Cuando aparece un nuevo modelo, el antiguo sube de precio o cambia de versión, el equipo puede completar el cambio sin modificar el código de negocio y decidir con datos medidos en lugar de con restricciones contractuales.
En HiAPI.ai, este tipo de modelos puede integrarse mediante la misma forma de interfaz; con estrategias de enrutamiento y degradación, las prácticas anteriores pueden llevarse a la ingeniería.
Lista de implementación: evaluación completable en una semana
Un proceso de evaluación que puede ejecutarse en cinco días laborables, con el objetivo de producir una conclusión de selección revisable y reversible.
Día 1: muestrear solicitudes reales
Extrae de los logs de producción una muestra representativa de solicitudes que cubra las tres capas de tareas anteriores, con no menos de cincuenta por capa. La muestra debe incluir la cola larga real y los casos límite; no uses solo ejemplos bonitos.
Día 2: montar el experimento de control
Solicita con el mismo lote de muestras a claude-sonnet-4-6 y al modelo actual, fijando prompts y parámetros, y registra el número de tokens de entrada, el número de tokens de salida, el tiempo empleado y la respuesta original de cada solicitud. Guarda siempre la respuesta original: la atribución posterior depende de ella.
Día 3: evaluar resultados
Anota de forma manual o semiautomática la tasa de éxito de la tarea y la tasa de éxito del análisis de formato de cada capa de muestras. Define y escribe los criterios de puntuación de antemano para evitar que distintas personas apliquen criterios distintos y distorsionen las conclusiones.
Día 4: calcular coste y volumen de migración
Estima el coste unitario a partir de los datos de tokens registrados y contabiliza por separado el consumo adicional por reintentos. Al mismo tiempo, pide a los ingenieros que realmente escriben el código que estimen el trabajo de migración: reescritura de prompts, cambios en la capa de análisis y reescritura del manejo de errores, con un rango para cada uno.
Día 5: formar conclusiones y plan de reversión
Revisa juntas las tres dimensiones de adecuación a la tarea, estructura de costes y trabajo de migración, y da una conclusión clara: qué capa cambia a claude-sonnet-4-6, qué capa mantiene el estado actual, cuál es la proporción del despliegue gradual y cuáles son las condiciones de activación de la reversión. Escribe la conclusión en un documento con las muestras y los datos adjuntos, para facilitar la revisión dentro de tres meses.
Acciones continuas
Tras el despliegue, revisa semanalmente la tasa de reintentos, la tasa de fallos de análisis y el coste unitario; si alguno de estos tres indicadores se vuelve anómalo, normalmente significa que hay que ajustar los prompts o las reglas de enrutamiento, no que el modelo haya empeorado.
El objetivo final de la selección no es encontrar un modelo universal, sino establecer un mecanismo de elección que pueda recalibrarse continuamente con el negocio y los datos; esta es también la capacidad de ingeniería en la que más merece la pena invertir en un momento de rápida iteración de modelos.
Artículos relacionados
Ver todos los artículos →-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Comparativa
Comparativa horizontal de Seedream 5.0 Pro image-to-image: capacidades, precios y recomendaciones de selección