
Tutorial
Añade generación de imágenes con IA a una aplicación Next.js usando la API de hiapi
Proxy de route handler, sondeo de tareas asíncronas, almacenamiento persistente y cero CLS: una integración casi de producción en unas 150 líneas de TypeScript.
Conectar un modelo de generación de imágenes a una aplicación Next.js 14 App Router es un proyecto pequeño, pero casi todo el mundo comete errores en los mismos cuatro puntos críticos:
- La API tarda de 60 a 120 segundos: demasiado para una sola petición del cliente y demasiado para la mayoría de los runtimes de borde.
- La clave de API no puede enviarse al navegador, por lo que se necesita un route handler como proxy.
- La URL del resultado tiene una validez corta, por lo que debe persistirse antes de que el usuario actualice la página.
- Las dimensiones de la imagen se desconocen al devolverse; si se renderiza directamente, se daña gravemente el Cumulative Layout Shift (CLS).
Este tutorial te guiará por una integración casi de producción de la API de imágenes de hiapi: creación de tareas, sondeo, carga persistente y renderizado seguro para CLS, en unas 150 líneas de TypeScript. Todo el código puede colocarse directamente en un directorio app/ real.
El contrato de tareas asíncronas
hiapi ofrece un endpoint unificado para todos los modelos de imagen y vídeo: POST https://api.hiapi.ai/v1/tasks. Es totalmente asíncrono: envía la tarea, sondea hasta que alcance un estado terminal y luego descarga la salida. Sin HTTP de larga duración, sin tiempos de espera de proxy de 100 segundos y sin problemas con el runtime Edge.
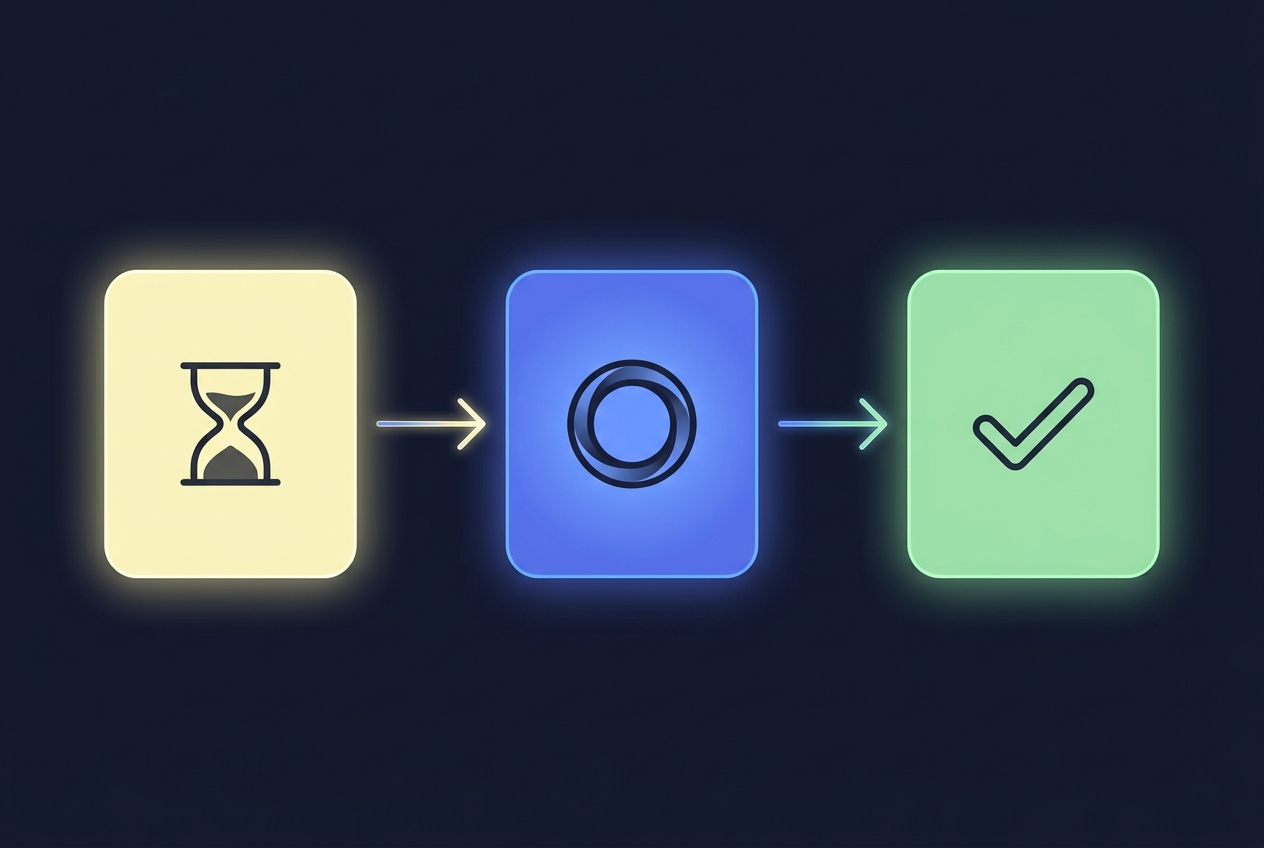
Una tarea puede estar en cuatro estados posibles:
pending: aceptada pero aún no tomadarunning: generándosesuccess:output[0].urlestá listo (firmado, válido por tiempo limitado)fail:error.codeyerror.messageestán rellenados
Una sola imagen 1K suele tardar entre 30 y 120 segundos en completarse. La mayor parte de ese tiempo se dedica a ejecutar el modelo; la propia API no añade una sobrecarga medible.
Paso 1: configuración del proyecto
Necesitas un proyecto Next.js 14+ App Router y una variable de entorno:
# .env.local
HIAPI_API_KEY=sk-...   # nunca la expongas al navegador
Añade esta clave como secreto del servidor en tu plataforma de despliegue (Vercel, Cloudflare Pages, Railway). No le pongas el prefijo NEXT_PUBLIC_.
Si quieres almacenamiento persistente (recomendado; el paso 5 lo cubre), añade también:
R2_ACCOUNT_ID=...
R2_ACCESS_KEY_ID=...
R2_SECRET_ACCESS_KEY=...
R2_BUCKET=...
R2_PUBLIC_BASE=https://cdn.your-domain.com   # dominio personalizado en el bucket
Paso 2: el route handler, por qué lo necesitas
La única razón de ser de un route handler: mantener la clave de API en el servidor. Cualquier petición lanzada desde un componente React se ejecuta en el navegador del usuario, y cualquier cadena compilada en el código del cliente está a una pestaña de DevTools de ser robada.
Un route handler también te da un único lugar auditable para aplicar límites de velocidad, registrar uso y validar prompts antes de que la petición llegue al endpoint de pago.
Crea app/api/images/route.ts:
// app/api/images/route.ts
import { NextResponse } from "next/server";

export const runtime = "nodejs";          // las fetch largas necesitan Node, no Edge
export const maxDuration = 180;           // Vercel: amplía el timeout de la función serverless

const HIAPI = "https://api.hiapi.ai/v1/tasks";

type CreateBody = {
  prompt: string;
  model?: string;
  aspectRatio?: string;   // p. ej. "16:9", "3:2", "1:1"
  resolution?: "1K" | "2K" | "4K";
};

export async function POST(req: Request) {
  const body = (await req.json()) as CreateBody;
  if (!body?.prompt || body.prompt.length > 2000) {
    return NextResponse.json({ error: "invalid prompt" }, { status: 400 });
  }

  const res = await fetch(HIAPI, {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.HIAPI_API_KEY}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      model: body.model ?? "Nano-Banana-2",
      input: {
        prompt: body.prompt,
        aspect_ratio: body.aspectRatio ?? "16:9",
        resolution: body.resolution ?? "1K",
      },
    }),
  });

  if (!res.ok) {
    const text = await res.text();
    return NextResponse.json({ error: text }, { status: res.status });
  }

  const { data } = await res.json();
  // data.taskId es el identificador que el cliente usa para sondear
  return NextResponse.json({ taskId: data.taskId });
}
Hay dos ajustes importantes que se olvidan con facilidad:
runtime = "nodejs": en muchos entornos, el runtime Edge limita una sola fetch a unos 25 segundos, lo que no sirve para un bucle de sondeo.maxDuration = 180: las funciones serverless de Vercel tienen por defecto 10 segundos en el plan Hobby y 60 segundos en el plan Pro; debes aumentar este valor manualmente, o si eliges esperar en el servidor, la ruta se terminará a mitad del sondeo.
Paso 3: el endpoint de sondeo (o: por qué no esperar en el servidor)
Hay dos opciones para mostrar el progreso al cliente:
| Enfoque | Ventajas | Desventajas |
|---|---|---|
| Esperar en el servidor y devolver todo de una vez | Solo una petición del cliente | Ocupa la invocación serverless 60–120 segundos, fácil de que expire, sin retroalimentación de progreso |
El servidor devuelve taskId y el cliente sondea |
Bajo coste de servidor, progreso en tiempo real | Hay que construir un endpoint más |
En producción, el segundo enfoque es claramente mejor. Añade app/api/images/[id]/route.ts:
// app/api/images/[id]/route.ts
import { NextResponse } from "next/server";

export const runtime = "nodejs";

const HIAPI = "https://api.hiapi.ai/v1/tasks";

export async function GET(
  _req: Request,
  { params }: { params: { id: string } },
) {
  const res = await fetch(`${HIAPI}/${params.id}`, {
    headers: { "Authorization": `Bearer ${process.env.HIAPI_API_KEY}` },
    cache: "no-store",
  });

  if (!res.ok) {
    return NextResponse.json({ error: await res.text() }, { status: res.status });
  }

  const { data } = await res.json();
  // status ∈ { pending, running, success, fail }
  return NextResponse.json({
    status: data.status,
    url: data.output?.[0]?.url ?? null,
    error: data.error ?? null,
  });
}
Este es el endpoint que el cliente sondea cada 3 segundos. Cada llamada es rápida (menos de 200 ms) y sin estado.
Paso 4: el componente de cliente
Un formulario sencillo, un estado de carga con indicador de progreso y un lienzo de resultados. El sondeo se configura con setInterval y se limpia al entrar en un estado terminal o al desmontarse el componente.
// app/generate/page.tsx
"use client";

import { useEffect, useRef, useState } from "react";

type Status = "idle" | "queued" | "running" | "done" | "error";

export default function GeneratePage() {
  const [prompt, setPrompt] = useState("");
  const [status, setStatus] = useState<Status>("idle");
  const [url, setUrl] = useState<string | null>(null);
  const [taskId, setTaskId] = useState<string | null>(null);
  const pollRef = useRef<ReturnType<typeof setInterval> | null>(null);

  useEffect(() => () => {
    if (pollRef.current) clearInterval(pollRef.current);
  }, []);

  async function start() {
    setStatus("queued");
    setUrl(null);
    const r = await fetch("/api/images", {
      method: "POST",
      headers: { "Content-Type": "application/json" },
      body: JSON.stringify({ prompt, aspectRatio: "16:9" }),
    });
    if (!r.ok) return setStatus("error");
    const { taskId } = await r.json();
    setTaskId(taskId);
    setStatus("running");

    pollRef.current = setInterval(async () => {
      const p = await fetch(`/api/images/${taskId}`).then(x => x.json());
      if (p.status === "success") {
        setUrl(p.url);
        setStatus("done");
        clearInterval(pollRef.current!);
      } else if (p.status === "fail") {
        setStatus("error");
        clearInterval(pollRef.current!);
      }
    }, 3000);
  }

  return (
    <main className="mx-auto max-w-2xl p-8 space-y-6">
      <textarea
        value={prompt}
        onChange={e => setPrompt(e.target.value)}
        rows={3}
        className="w-full border rounded p-2"
        placeholder="A sunset over a misty pine forest, cinematic, 16:9"
      />
      <button
        onClick={start}
        disabled={!prompt || status === "queued" || status === "running"}
        className="px-4 py-2 rounded bg-black text-white disabled:opacity-50"
      >
        {status === "running" ? "Generating…" : "Generate"}
      </button>

      {/* Lienzo reservado: por qué importa este div con relación de aspecto exacta, ver paso 6 */}
      <div className="relative w-full" style={{ aspectRatio: "16/9" }}>
        {status === "running" && (
          <div className="absolute inset-0 grid place-items-center bg-neutral-100 rounded">
            <span className="text-neutral-500">Waiting on task {taskId?.slice(0, 8)}…</span>
          </div>
        )}
        {url && (
          // eslint-disable-next-line @next/next/no-img-element
          <img
            src={url}
            alt={prompt}
            className="absolute inset-0 w-full h-full object-cover rounded"
          />
        )}
      </div>
    </main>
  );
}
Hay algunas mejoras de producción que conviene tener en cuenta ahora y añadir poco a poco después:
- El backoff exponencial (3 s → 5 s → 8 s) reduce el número de peticiones durante generaciones lentas.
- Un timeout de inactividad (por ejemplo, abandonar tras 240 s) evita el sondeo zombi de tareas muertas.
- Mostrar texto de progreso parcial (
"running"frente a"pending") da al usuario la certeza de que algo está ocurriendo.
Paso 5: persistir los resultados, las URL de salida caducan
Con cualquier API de imágenes moderna, el error más común es guardar output[0].url en una base de datos y darlo por hecho. Esas URL están firmadas, son efímeras (normalmente de minutos a horas) y devuelven 404 en cuanto el usuario actualiza la página.
La solución es canalizar los bytes a través de tu propio servidor hacia un almacenamiento persistente. El mismo handler app/api/images/[id]/route.ts es el lugar correcto: ejecútalo solo la primera vez que recibas una respuesta success, antes de devolver la URL al cliente.
// Añadir en app/api/images/[id]/route.ts tras la comprobación `data.status === "success"`
import { S3Client, PutObjectCommand } from "@aws-sdk/client-s3";

const s3 = new S3Client({
  region: "auto",
  endpoint: `https://${process.env.R2_ACCOUNT_ID}.r2.cloudflarestorage.com`,
  credentials: {
    accessKeyId: process.env.R2_ACCESS_KEY_ID!,
    secretAccessKey: process.env.R2_SECRET_ACCESS_KEY!,
  },
});

async function persist(taskId: string, sourceUrl: string): Promise<string> {
  const bytes = new Uint8Array(await (await fetch(sourceUrl)).arrayBuffer());
  const key = `generations/${taskId}.jpg`;
  await s3.send(new PutObjectCommand({
    Bucket: process.env.R2_BUCKET!,
    Key: key,
    Body: bytes,
    ContentType: "image/jpeg",
    CacheControl: "public, max-age=31536000, immutable",
  }));
  return `${process.env.R2_PUBLIC_BASE}/${key}`;
}
En la ruta de estado, cuando el estado pase a success, usa persist() y luego devuelve al cliente la URL persistida en lugar de la URL firmada del upstream. El cliente nunca verá una URL que caduque y un refresco de mañana seguirá funcionando.
Si persistes en tu propia base de datos (Postgres, Supabase, etc.), guarda la URL persistida, no la URL firmada.
Paso 6: eliminar el CLS
El Cumulative Layout Shift es el asesino silencioso de las Core Web Vitals en las aplicaciones de imágenes con IA. Las imágenes llegan más de 60 segundos después de cargar la página. Si las renderizas con <img> dentro de un contenedor sin dimensiones definidas, cada resultado desplazará todo lo que hay debajo.
Dos técnicas fiables:
Reserva la relación de aspecto con CSS. Eso es lo que hace el estilo aspectRatio: "16/9" del componente anterior. El contenedor conserva su espacio tanto si la imagen se ha cargado como si no.
Coincide con la relación de aspecto en la petición. Envía aspectRatio: "16:9" a hiapi y luego declara 16/9 en el contenedor. Ambos deben coincidir, o aparecerán barras negras o, peor, una forma distinta de la reservada.
Con el componente <Image> de Next.js se aplica el mismo principio: pasa atributos width y height que coincidan con la proporción solicitada. No uses fill a menos que el padre ya sea una caja de dimensiones fijas.
import Image from "next/image";

<Image
  src={persistedUrl}
  alt={prompt}
  width={1280}
  height={720}
  className="rounded"
  priority={false}
/>
Paso 7: elegir modelo y estimar costes
Los modelos de imagen de hiapi comparten la misma estructura de endpoint: solo cambia el campo model. Opciones habituales, con el precio por imagen a la resolución predeterminada:
| Modelo | Precio / imagen 1K | Punto fuerte |
|---|---|---|
qwen-image-2.0 |
$0.025 | El más barato; 2K por defecto; potente renderizado de texto en chino, japonés y coreano |
gpt-image-2 |
$0.03 | Relación de aspecto fiable; gran capacidad tipográfica |
Nano-Banana |
$0.05 | Muy rápido (1–2 s); buena consistencia de personajes |
flux-1.1-pro |
$0.05 | Fotorrealismo de estilo artístico |
Nano-Banana-2 |
$0.085 (1K) / $0.076 (2K) / $0.114 (4K) | Calidad alta, 4K nativo |
La elección predeterminada honesta depende de la tarea. Para maquetas de UI y titulares, gpt-image-2 es lo más seguro. Para fotorrealismo 4K nativo, elige Nano-Banana-2. Para trabajos por lotes en los que no duele tirar cada imagen, elige qwen-image-2.0 o Nano-Banana.
Para una aplicación de 100 000 usuarios que genera una imagen al día por sesión:
qwen-image-2.0: $2,500/díaNano-Banana-21K: $8,500/día
La arquitectura anterior no cambia. Solo cambia el campo model del paso 2.
Paso 8: lista de comprobación para producción
Antes de lanzar:
- Aplica límites de velocidad a los route handlers; de lo contrario, una sola IP puede agotar tu presupuesto mensual en una tarde. Upstash, Cloudflare Rate Limiting o un simple contador de Redis sirven.
- Valida la longitud y el contenido del prompt antes de reenviarlo en el servidor. La plataforma hiapi rechaza cierto contenido; no querrás pagar la latencia de ida y vuelta por un error 400.
- Establece una cuota diaria por usuario: guarda el número de generaciones por
userIdyYYYY-MM-DD, y rechaza la 11.ª del día con un mensaje amable. - Persiste antes de responder: nunca dejes que la URL del resultado llegue al cliente sin pasar antes por el almacenamiento persistente.
- PreesTablece las dimensiones del contenedor del resultado para que coincidan con la relación de aspecto solicitada. Saltarse este paso es la diferencia entre un CLS de 0 y uno de 0.4.
- Pasa el paso de persistencia a segundo plano para que el cliente responda en menos de un segundo: devuelve la URL del upstream de inmediato y lanza una tarea en cola que copie a R2 y actualice la fila de la base de datos.
Vale la pena añadir una frase sobre el último punto: la mayoría de las aplicaciones no lo necesitan. Persistir en línea mantiene el código simple, y los 1–2 segundos adicionales ocurren después de la espera de 60 segundos, cuando el usuario ya está viendo el indicador de carga.
Siguientes pasos
Ahora tienes una integración completa, segura y a prueba de CLS de la API de imágenes de hiapi en Next.js, en unas 150 líneas de TypeScript. A partir de aquí, el mismo patrón POST /v1/tasks se extiende a modelos de vídeo (Seedance 2.0 para material cinematográfico), flujos de imagen a imagen (solo añade image_url dentro de input) y edición de varios turnos, todo ello sin cambiar la arquitectura de sondeo.
Si quieres un punto de partida funcional, la página de modelos de hiapi enumera todos los modelos que responden a este endpoint e incluye la estructura de entrada de ejemplo de cada uno. Coloca cualquiera de ellos en el campo model anterior y el mismo componente renderizará los resultados.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado