
Kuaishou
Kling 3.0
kling-3.0-omni/image-to-video
Serie unificada de generación de vídeo multimodal que admite texto a vídeo, imagen a vídeo, referencia a vídeo y edición dentro del vídeo, con sincronización labial nativa y audio multilingüe
Probar kling-3.0-omni/image-to-video
Entrada
Creaciones
Ver todas las creacionesSalida
videoNotas visuales de movimiento de cámara: demostración del lenguaje de planos de imagen a vídeo
Estilo Movimiento de cámara · Guion gráfico · Lenguaje cinematográfico
Entradas de referencia
image_urls
Prompt
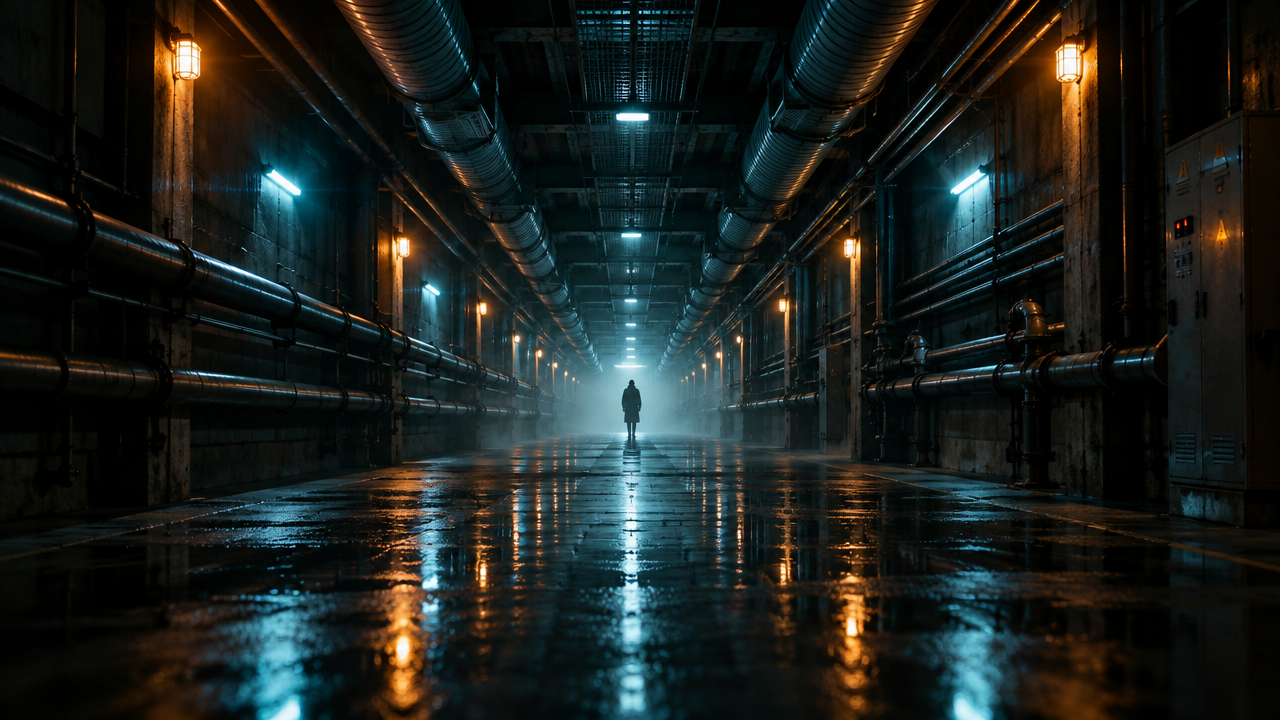
Lento dolly in cinematográfico; la cámara apunta a una figura solitaria al final de un pasillo industrial empapado por la lluvia; la cámara se desliza hacia delante a velocidad constante, con un leve temblor de cámara en mano, una profundidad de campo reducida que pasa del enfoque de las tuberías en primer plano al sujeto, luces prácticas en cian frío y ámbar parpadeando a lo largo de las paredes, niebla volumétrica desplazándose por el encuadre, destellos de objetivo anamórfico, desenfoque de movimiento cinematográfico a 24 fps, plano secuencia estable, sin cortes, tono contenido y observacional
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Kling 3.0 Omni 图生视频:parámetros clave y escenarios de aplicación ilustrados
Estilo Explicación · i2v · Demostración del producto
Entradas de referencia
image_urls
Prompt
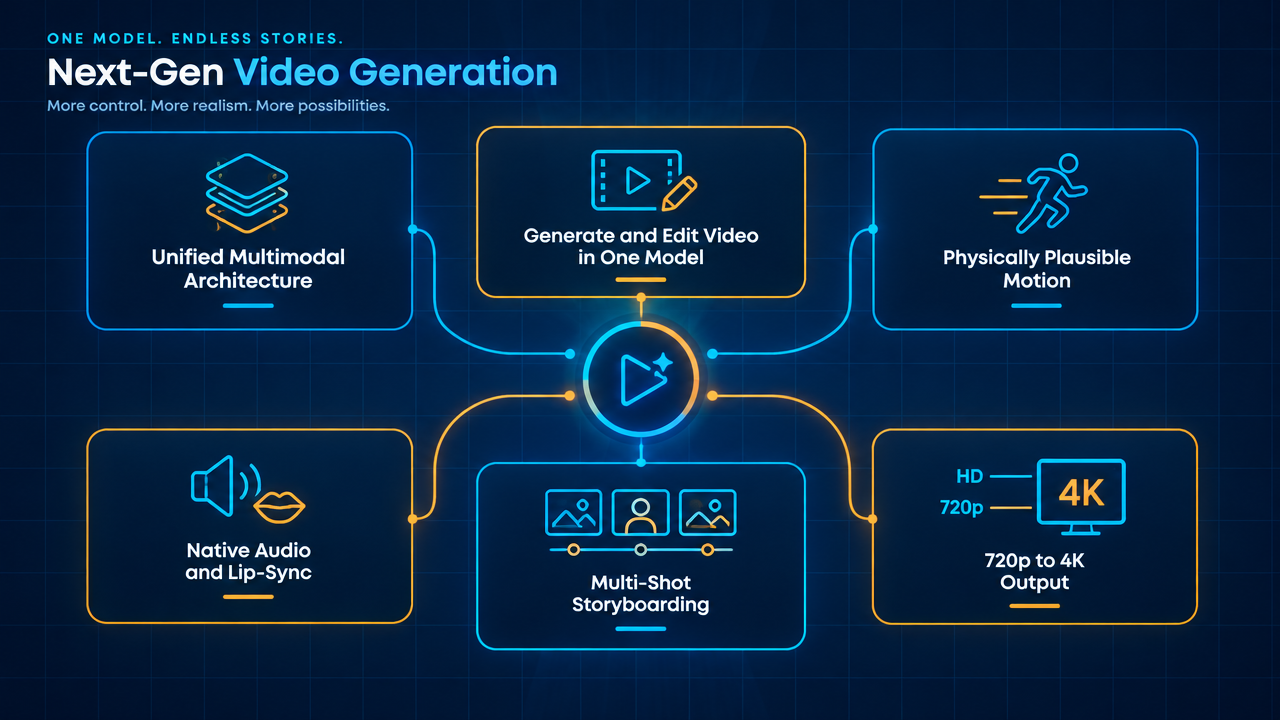
Convierte un diagrama técnico sencillo de capacidades en formato 16:9 en un breve vídeo explicativo. La escena inicial ya muestra una composición de rejilla en azul marino profundo con seis tarjetas de parámetros etiquetadas: arquitectura multimodal unificada, generación de vídeo a partir de texto / a partir de imagen / a partir de referencia y edición dentro del vídeo, atención conjunta espaciotemporal tridimensional para generar movimientos físicamente coherentes, audio nativo y sincronización labial multilingüe, storyboard multicámara de hasta 15 segundos y salida de 720p a 4K. La cámara avanza lenta y constantemente con una ligera deriva de paralaje; las tarjetas se resaltan sucesivamente con un suave barrido de izquierda a derecha y un halo sutil, mientras las líneas de conexión entre las tarjetas se dibujan gradualmente como finos haces de luz. Mantén todo el texto nítido, legible e inalterado, sin redibujado de texto ni glifos distorsionados. Estética tecnológica corporativa sobria, fondo azul marino profundo, luces de acento cian y ámbar cálido, niebla volumétrica suave, poca profundidad de campo en las capas de fondo, iluminación de estudio de alto contraste, composición estable, etiquetas sin deformar, sin añadir personas ni objetos.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Concepto de storyboard: la conversión del texto a la imagen en tomas
Estilo Guion gráfico · Arte conceptual · Cinematográfico
Entradas de referencia
image_urls
Prompt
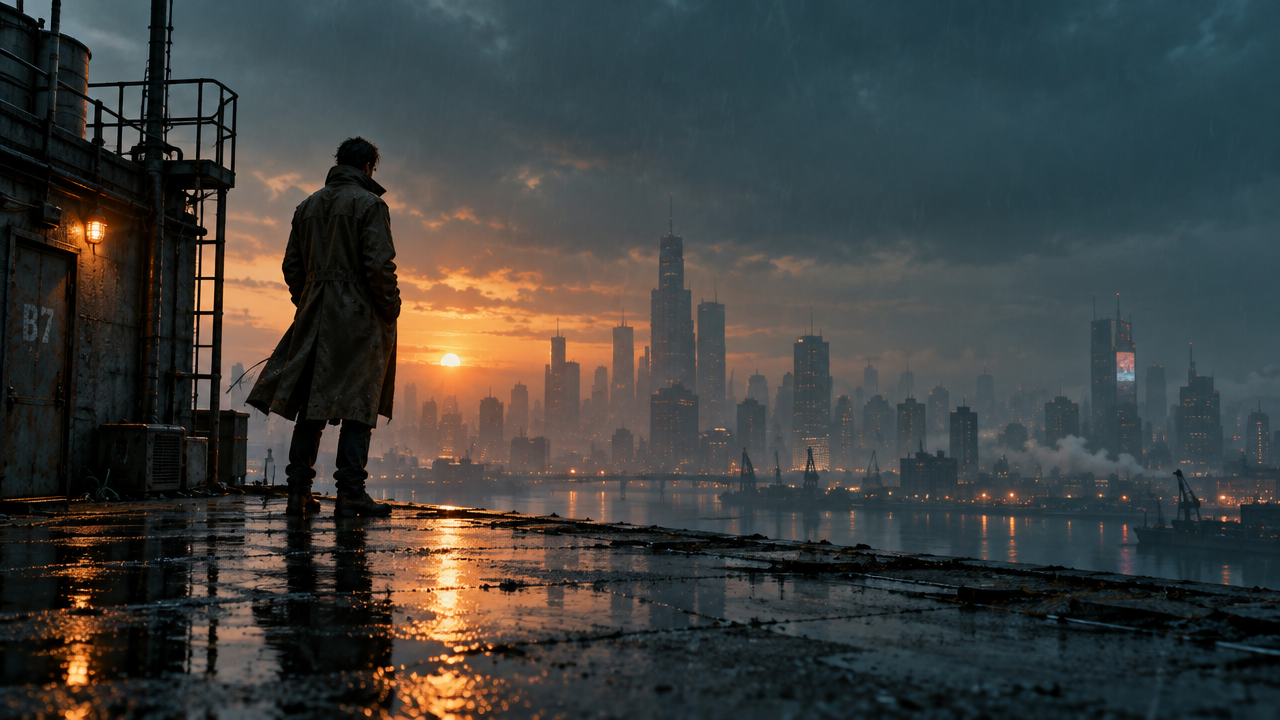
Toma conceptual de estética cinematográfica: al atardecer, una figura solitaria con un abrigo desgastado permanece de pie al borde de una azotea industrial mojada por la lluvia, mientras las luces de la ciudad a lo lejos se ven suaves entre la neblina. Desde un amplio plano general, la cámara se acerca lentamente y, al final, se eleva ligeramente sobre una grúa; profundidad de campo reducida, destellos de lente anamórfica, sombras en cian frío y contraluz cálido de farolas de sodio, finas gotas de lluvia que brillan en la luz, un leve balanceo de cámara en mano como si respirara, movimiento cinematográfico a 24 fps, que convierte el storyboard de arte conceptual en un ritmo de rodaje real.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
kling-3.0-omni/image-to-video per second
Descripción general
kling-3.0-omni/image-to-video es la versión Omni de la serie kling-3.0 orientada a la generación de vídeo a partir de imágenes, accesible mediante la interfaz unificada de HiAPI.ai. El desarrollador introduce una o varias imágenes de fotograma junto con un prompt de texto para generar vídeos de 3 a 15 segundos en 720p hasta 4K, con opción de activar audio nativo, multicámara inteligente y sujetos reutilizables. Es adecuado para desarrolladores que necesitan convertir rápidamente imágenes estáticas en vídeo dinámico en escenarios como exhibición de productos de comercio electrónico, cortometrajes para redes sociales o previsualización de storyboards, y que exigen coherencia de los elementos, duración y calidad controlables.
Aspectos destacados
- Control mediante fotogramas inicial y final: admite 1 imagen como fotograma inicial, o 2 imágenes para especificar el fotograma inicial y el final, de modo que el proceso de generación tenga un punto de partida y un punto de llegada claros.
- Sujetos reutilizables con coherencia: permite definir hasta 3 sujetos, cada uno descrito con 2 a 4 imágenes y referenciado en el prompt mediante @nombre, lo que reduce la deriva del sujeto entre tomas.
- Salida opcional de audio nativo: al activar audio, el vídeo y el sonido sincronizado se generan a la vez, lo que ahorra el paso independiente de doblaje posterior y alineación audio-imagen.
- Duración y resolución ajustables: la duración de salida abarca de 3 a 15 segundos, y la resolución puede ser 720p, 1080p o 4K, adaptándose a distintas fases, desde la previsualización hasta el montaje final.
Descripción de capacidades
Impulso por fotograma inicial y por fotogramas inicial y final: con 1 imagen se genera un vídeo que parte de esa imagen, o con 2 imágenes se controlan el fotograma inicial y el final; la relación de aspecto de salida sigue al fotograma inicial, lo que facilita la coincidencia con la composición de materiales existentes.
Referencia de sujetos y coherencia: mediante elements se definen hasta 3 sujetos con nombre, cada uno con 2 a 4 imágenes de referencia y una breve descripción, y se mencionan en el prompt con @nombre para ayudar a mantener estable la apariencia del sujeto en múltiples tomas.
Generación de audio nativo: al activar el parámetro audio, la generación del vídeo produce también sonido sincronizado, adecuado para montajes que requieren diálogos o sonido ambiente, y reduce los pasos de composición audio-imagen.
Planificación multicámara inteligente: al activar prefer_multi_shots, el modelo divide automáticamente el resultado en varias tomas según el prompt, de modo que con una sola llamada se obtiene un cortometraje con cambios de plano en lugar de una única imagen continua.
Casos de uso
- Conversión de imágenes de producto en vídeos de exhibición: usar la imagen principal del producto como fotograma inicial para generar un vídeo corto con movimiento de cámara, destinado a la página de detalles del producto o a materiales de anuncios en el feed.
- Conversión de pósteres estáticos para redes sociales en cortometrajes dinámicos: introducir el fotograma inicial y el final de un diseño para producir un vídeo dinámico vertical u horizontal y publicarlo directamente en plataformas sociales.
- Previsualización de storyboards con fotogramas inicial y final: emparejar fotogramas clave de storyboards de cine o animación con fotogramas inicial y final para generar tomas de transición y confirmar el ritmo y el movimiento de cámara en la fase previa.
- Cortometrajes de personajes con múltiples tomas: fijar la imagen del personaje con elements y activar la multicámara para generar por lotes vídeos narrativos breves con personajes coherentes, destinados a publicidad o series de contenido.
Limitaciones y recomendaciones de selección
La duración máxima por generación es de 15 segundos; las narrativas más largas requieren generar por segmentos y unirlos después. La relación de aspecto de salida la determina el fotograma inicial, por lo que la proporción de los materiales debe unificarse de antemano. La referencia de sujetos admite como máximo 3 sujetos, y cada uno requiere de 2 a 4 imágenes del mismo sujeto, lo que eleva el coste de preparación de las entradas. El audio nativo y la multicámara inteligente son interruptores opcionales; al activarlos, la calidad descriptiva del prompt cobra mayor importancia. Si solo se necesita generación a partir de texto, debe elegirse la línea de texto a vídeo de la misma serie; si se requiere sustitución local sobre un vídeo existente, queda fuera del ámbito de imagen a vídeo de esta línea.
Novedades
Ver el registro de cambios →- Nuevo modelo Nuevo modelo: Kling 3.0 Omni (可灵 O3), se invoca mediante POST /v1/tasks. kling-3.0-omn…
Preguntas frecuentes
Ver todas las preguntas →-
¿Kling 3.0 Image-to-Video requiere subir una imagen?
Sí. Actualmente kling-3.0/image-to-video es una ruta de video a partir de imagen; la imagen de entrada define el sujeto y la composición inicial, y el Prompt define la acción, el movimiento de cámara y los cambios del entorno.
-
¿Qué duraciones y resoluciones admite Kling 3.0 Image-to-Video?
El contrato de solicitud actual de HiAPI admite de 3 a 15 s, con resoluciones de salida de 720p, 1080p y 4K. Los valores disponibles están sujetos al panel de parámetros de la página y a la documentación de la API.
-
¿Cómo se factura Kling 3.0 Image-to-Video?
La tarea se factura según la duración de salida y el nivel seleccionado. La página muestra el precio en tiempo real siguiendo la unidad monetaria global, y el cargo final se basa en el registro de la tarea completada correctamente.
-
¿Cómo mejorar la estabilidad del sujeto en la generación de video a partir de imágenes?
Utiliza una imagen de entrada con un sujeto claro, pocas oclusiones y una composición completa; en el Prompt, describe primero la acción principal y el plano, y luego enumera la apariencia, los materiales y la relación con el fondo que deben conservarse. Para la primera prueba, se recomienda usar una duración más corta.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: kling-3.0-omni/image-to-video
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para kling-3.0-omni/image-to-video y la ruta default; consulta la tabla de parámetros a continuación.
audiobooleanOpcionalPredeterminado: falseInterruptor booleano que controla si se genera sonido sincronizado junto con el vídeo; por defecto false, es decir, no se genera audio.
promptstringObligatoriominLength 1maxLength 3072Describe el contenido del vídeo que se desea generar; para hacer referencia a un sujeto de subjects, se puede mencionar su nombre en el prompt con el formato @name.
durationintegerOpcionalPredeterminado: 5min 3max 15Duración del vídeo de salida, en segundos, con valores de 3 a 15; por defecto 5.
elementsarrayOpcionalmaxItems 3
Lista de sujetos reutilizables, máximo 3; cada elemento contiene un nombre, una descripción breve y de 2 a 4 imágenes, y se referencia en el prompt mediante @name.
Array [ object ]
Elementos del array
namestringObligatoriominLength 1Nombre del sujeto, debe ser único y no contener espacios; en el prompt se hace referencia a este sujeto con el formato @name.
descriptionstringObligatoriominLength 1Texto de descripción breve del sujeto, utilizado para ayudar al modelo a identificar sus características.
element_input_urlsarrayObligatoriominItems 2maxItems 4Array de URLs de 2 a 4 imágenes del mismo sujeto, en formato JPG/PNG.
Array [ string ]
image_urlsarrayObligatoriominItems 1maxItems 2Array de URLs de imágenes de primer y último fotograma: 1 imagen corresponde al primer fotograma, 2 imágenes corresponden en orden al primer y último fotograma; JPG/PNG, cada imagen de hasta 50MB, al menos 300 píxeles, relación de aspecto 0.4-2.5; la relación de aspecto de salida sigue la del primer fotograma.
Array [ string ]
resolutionstringOpcionalPredeterminado: "720p"Resolución del vídeo de salida; por defecto 720p.
720p1080p4kprefer_multi_shotsbooleanOpcionalPredeterminado: falseInterruptor booleano que controla si se permite que el modelo planifique automáticamente varios planos según el prompt; por defecto false.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0-omni/image-to-video",
  "input": {
    "audio": false,
    "prompt": "…",
    "duration": 5,
    "image_urls": "…",
    "resolution": "720p",
    "prefer_multi_shots": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "kling-3.0-omni/image-to-video",
input: {
"audio": false,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "kling-3.0-omni/image-to-video",
"input": {
"audio": False,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Kling 2.5 Kuaishou $0.060 /segundo
-
 Wan 3.0 Video Alibaba $0.040 /segundo
-
 Seedance 2.0 ByteDance $0.017 /segundo
-
 Gemini Omni 1.1 Flash Google $0.450 /vídeo
-
 HeyGen Avatar IV HeyGen $0.150 /segundo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Runway Gen 4.5 Runway $0.172 /segundo
-
 Creatify Boreal Creatify $0.015 /segundo
-
 Ray 3.2 Luma $0.214 /vídeo
-
 HeyGen Avatar V HeyGen $0.150 /segundo
-
 Kling AI Avatar Kuaishou --
-
 HappyHorse 1.1 Alibaba $0.160 /segundo

