
Veo 3.1
veo-3.1/image-to-video
Modelo de generación de vídeo de Google: la entrada de imagen permite generar de forma nativa vídeos de 8 segundos con sonido ambiental y diálogos, con soporte de hasta 4K y manteniendo la apariencia coherente del sujeto
Probar veo-3.1/image-to-video
Entrada
Creaciones
Ver todas las creacionesSalida
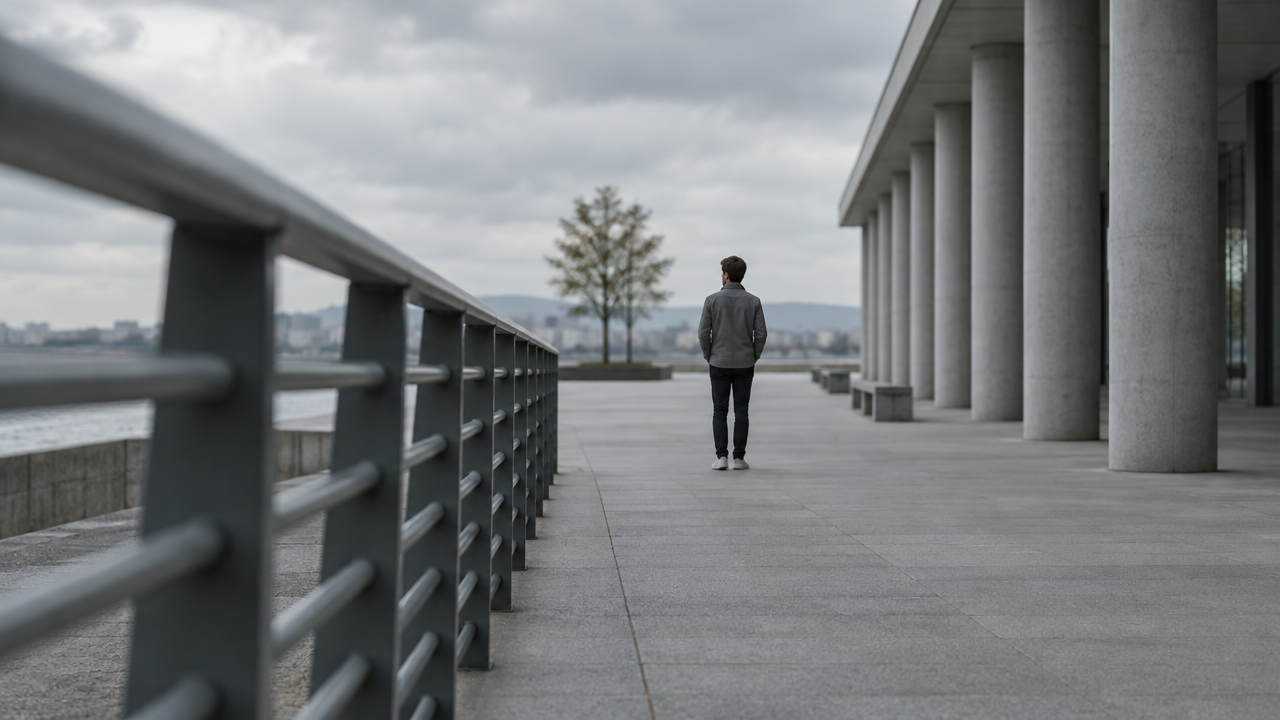
videoNotas visuales de movimiento de cámara: demostración del lenguaje cinematográfico para imagen a vídeo
Estilo Movimiento de cámara · Guion gráfico · film-grammar
Entradas de referencia
image_url
Prompt
Anima el fotograma fijo con un travelling de acercamiento lento y deliberado: la cámara avanza a velocidad constante a lo largo del eje óptico, manteniendo el horizonte nivelado y el sujeto centrado, mientras la profundidad de campo se comprime y los elementos del primer plano generan gradualmente paralaje. Estabilización sutil sin efecto de cámara en mano, sin respiración de zoom, sin distorsión de perspectiva. Se conserva la iluminación neutra y cinematográfica del fotograma de origen, con una profundidad de campo reducida que se estrecha progresivamente. Etalonaje de baja saturación, bordes limpios y desenfoque de movimiento coherente con una óptica de 35 mm. Con la textura de una demostración didáctica de movimiento de cámara, un único plano secuencia continuo, sin cortes.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
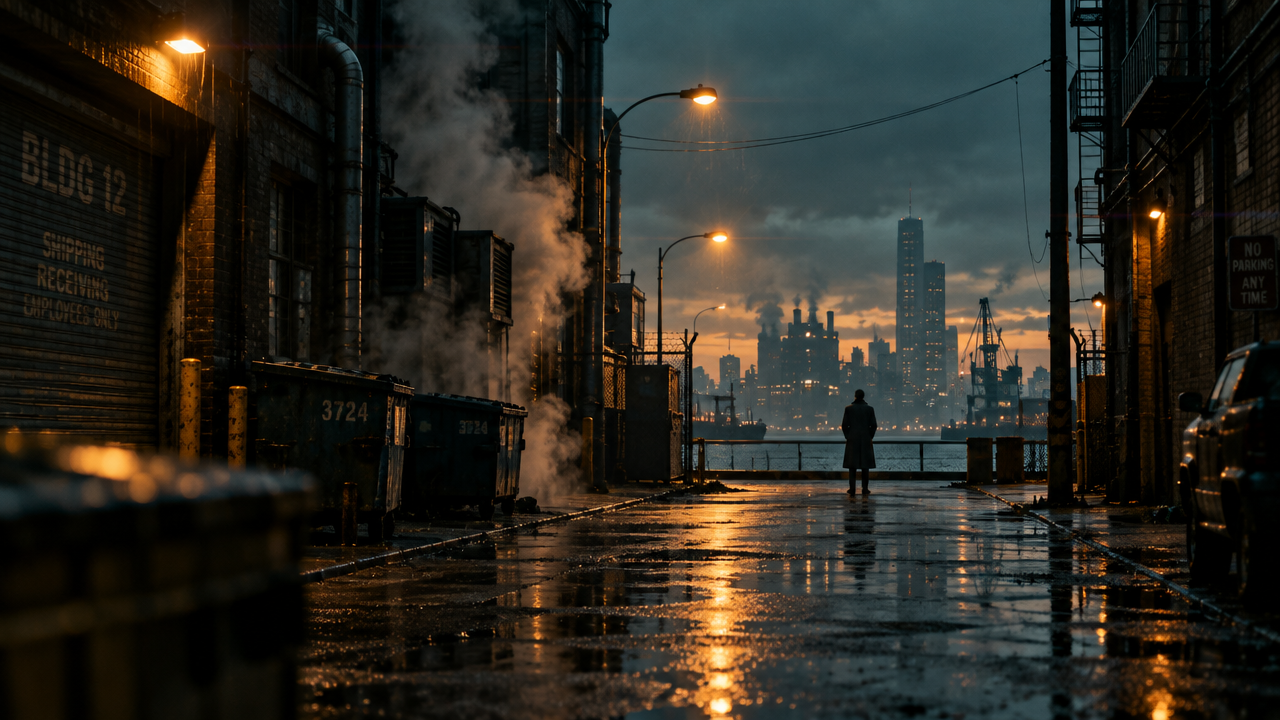
Visualización de conceptos de storyboard: de texto a fotograma inicial y de ahí al movimiento de cámara
Estilo Guion gráfico · Cinematográfico · Imagen a video
Entradas de referencia
image_url
Prompt
Convierte un único fotograma clave cinematográfico en un movimiento de cámara lento y controlado: un acercamiento suave desde un plano general amplio hacia el sujeto, con el polvo en primer plano y la niebla flotante mostrando un ligero paralaje. Mantén intactos la composición original y la gradación de color, conserva la profundidad de campo reducida y haz que la luz cambie suavemente como sombras de nubes al pasar. El viento ambiental y el ruido de fondo lejano de interior refuerzan la escena; sin cortes ni superposición de texto, con un ritmo constante a lo largo de ocho segundos.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
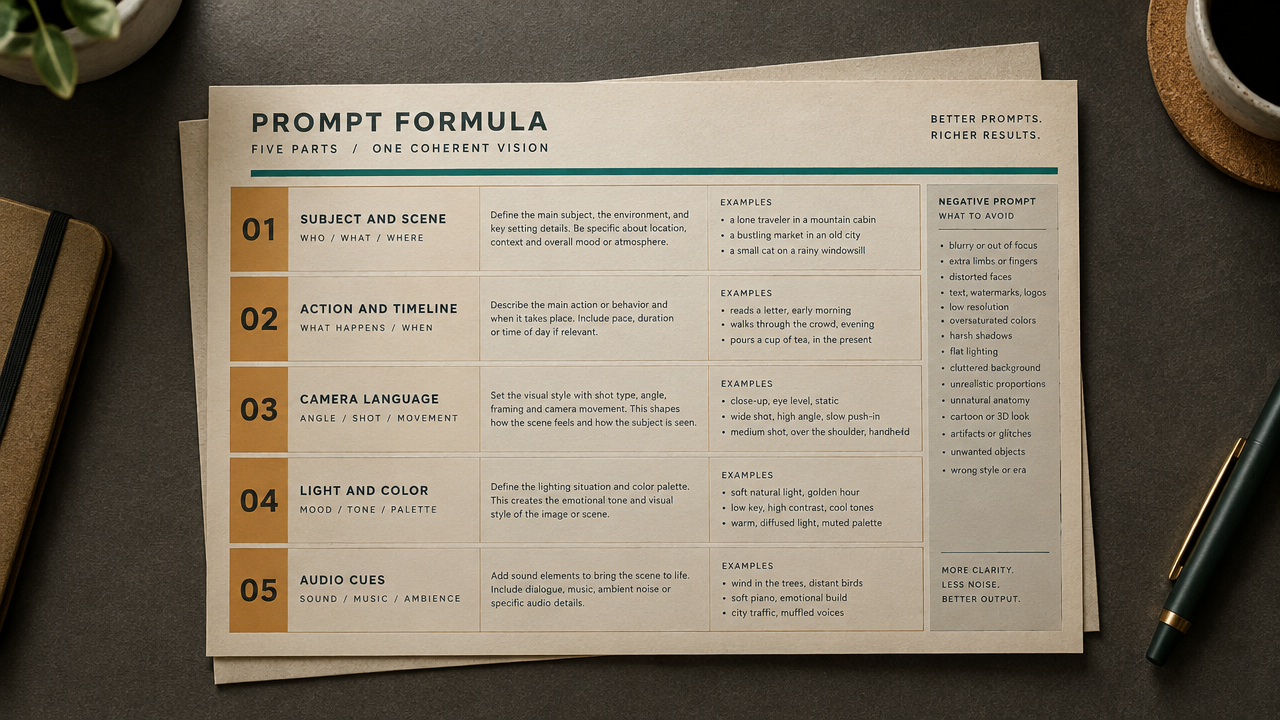
Tarjeta de fórmulas de prompts de imagen a vídeo para Veo 3.1
Estilo Ingeniería de prompts · Explicación · Diseño dinámico
Entradas de referencia
image_url
Prompt
Plano único en avance continuo, con vista cenital de una tarjeta de fórmulas de prompts extendida sobre un escritorio en tonos grafito cálidos. La tarjeta adopta un estilo de maquetación editorial limpio y nítido, e incluye cinco líneas de contenido etiquetadas —sujeto y escena, acción y línea de tiempo, lenguaje de cámara, luz y color, pistas de audio— dispuestas con una tipografía sans serif precisa, y a la derecha una pequeña columna de prompts negativos. La cámara se desliza hacia delante a una velocidad lenta y constante, generando un sutil paralaje sobre los bordes del papel apilado, sin cortes ni movimientos bruscos. Una luz principal suave y difusa entra desde la esquina superior izquierda y se atenúa delicadamente hacia los bordes; la paleta general es de tonos ámbar y blanco hueso de baja saturación, con una línea de acento cian. La profundidad de campo reducida mantiene nítido el centro de la tarjeta mientras el escritorio se vuelve suave. Solo hay ruido ambiente interior de fondo, silencioso y concentrado, adecuado para una narración documental o de tutorial.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Parámetros de imagen a vídeo de Veo 3.1 ilustrados: demostración de toma única
Estilo Imagen a video · Explicación técnica · Demostración del producto
Entradas de referencia
image_url
Prompt
Convierte la imagen estática en una animación de travelling cinematográfico lento y controlado. La cámara avanza con un ritmo estable y un ligero micro-movimiento de cámara en mano, manteniendo al sujeto siempre centrado en el encuadre y con un enfoque nítido. La luz ambiental varía ligeramente en la escena y pequeñas partículas flotan en el encuadre. Profundidad de campo reducida, desenfoque de movimiento natural, etalonaje cinematográfico, aspecto de 24 fps. Sin cortes, sin vibraciones bruscas de cámara, un único plano secuencia continuo.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
veo-3.1/image-to-video per second
Descripción general
La vía de imagen a vídeo de Veo 3.1 es la versión de generación de vídeo basada en imágenes del modelo de vídeo de Google en HiAPI.ai: recibe una imagen y un prompt de texto, y produce un vídeo dinámico con pista de audio nativa. Destaca por controlar el movimiento de cámara y la evolución de la escena manteniendo la apariencia del sujeto de la imagen de entrada; es adecuada para desarrolladores que necesitan convertir rápidamente material visual estático en clips reproducibles, con usos en publicidad, redes sociales y previsualización conceptual, entre otros.
Aspectos clave
- Generación nativa sincronizada de imagen y sonido: al generar el vídeo se producen en sincronía sonidos ambientales, diálogos y efectos de sonido, lo que reduce los pasos de doblaje y síntesis de efectos de sonido por separado en la postproducción.
- Resolución máxima opcional de 4K: la salida admite tres niveles, 720p, 1080p y 4k, y la relación de aspecto 16:9 o 9:16 puede ajustarse automáticamente según la imagen de entrada o especificarse manualmente.
- Duración de salida y audio controlables: la duración puede ser de 4, 6 u 8 segundos, y la pista de audio se puede activar o desactivar, lo que facilita ajustar las especificaciones de generación según el canal de difusión y el presupuesto de costes.
- Compatible con prompt negativo y semilla fija: permite usar negative_prompt para excluir elementos no deseados y seed para reproducir resultados de generación similares.
Descripción de capacidades
Generación de animación basada en imágenes: parte de una imagen y, junto con un prompt de hasta 20000 caracteres que describe el movimiento, produce un clip de vídeo de 4 a 8 segundos; es adecuada para convertir material visual existente directamente en contenido dinámico.
Generación de pista de audio nativa: por defecto genera audio nativo; al desactivar generate_audio se obtiene un vídeo sin sonido, lo que facilita añadir música o doblaje propio en el flujo de postproducción.
Control de resolución y relación de aspecto: permite especificar salida en 720p, 1080p o 4k; la relación de aspecto puede seguir automáticamente la imagen de entrada o forzarse a 16:9 o 9:16, adaptándose a difusión en horizontal y vertical.
Controlabilidad del resultado generado: mediante negative_prompt se describe el contenido que debe evitarse y mediante seed se fija la semilla aleatoria, lo que facilita mantener un estilo estable en la generación por lotes o realizar comparaciones A/B.
Casos de uso
- Equipos de marketing convierten imágenes de producto en anuncios en vídeo: introducen una imagen estática del producto y una descripción de la acción, y producen un clip de vídeo horizontal en 4K o 1080p, listo para su uso directo en publicidad en línea y presentación en el sitio web.
- Gestión de redes sociales crea contenido dinámico vertical: generan vídeos 9:16 a partir de imágenes verticales y prompts, con efectos de sonido nativos, para publicarlos como material en plataformas de vídeo corto.
- Preproducción audiovisual convierte imágenes conceptuales en previsualizaciones dinámicas: convierten storyboards o diseños conceptuales en clips dinámicos para ayudar al equipo a confirmar el movimiento de cámara y la atmósfera antes de la producción formal.
- Desarrolladores generan material dinámico por lotes: en flujos programáticos introducen imágenes y prompts y, combinando seed, producen por lotes clips de vídeo con estilo uniforme para pruebas o relleno de contenido.
Limitaciones y recomendaciones de selección
La duración máxima de una sola generación es de 8 segundos; las narraciones más largas requieren generar por segmentos y unirlos después, y la coherencia entre múltiples tomas aún necesita planificación manual. Se recomienda que la imagen de entrada tenga 720p o más y sea 16:9 o 9:16; otras proporciones se recortarán. La resolución y el interruptor de audio afectan a la facturación, por lo que antes de generar por lotes conviene hacer pruebas con especificaciones bajas. Si se necesita construir la imagen desde cero en lugar de animar una imagen existente, debe elegirse la vía de texto a vídeo de la misma familia.
Preguntas frecuentes
Ver todas las preguntas →-
¿Qué tipo de modelo de video es Veo 3.1 Text to Video?
Es una vía de texto a video pura, solo requiere un Prompt de texto, no exige subir una imagen inicial.
-
¿Qué especificaciones de salida admite Veo 3.1 Text to Video?
Admite de 4 a 8 segundos, con resoluciones que incluyen 720p, 1080p y 4k, y relaciones de aspecto que incluyen 16:9 y 9:16.
-
¿Se puede generar voz o usar una referencia de audio?
La generación de audio está activada por defecto
-
¿Cómo se factura Veo 3.1 Text to Video?
Se factura según la duración de salida y el nivel en tiempo real; las diferencias debidas a la resolución, el modo o las opciones de audio se rigen por el precio de la página y el registro de la tarea.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: veo-3.1/image-to-video
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para veo-3.1/image-to-video y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalSemilla aleatoria para hacer reproducible el resultado de la generación; introduce la misma semilla para obtener una salida consistente.
promptstringObligatoriominLength 1maxLength 20000Indicación de texto que describe de qué manera se desea que se mueva la imagen de entrada.
durationintegerObligatorioPredeterminado: 8min 4max 8Duración del vídeo generado (en segundos); el coste aumenta con la duración; por defecto 8 segundos.
468image_urlstringObligatorioURL de la imagen de entrada que se va a animar; se recomienda usar una resolución de 720p o superior y una relación de aspecto de 16:9 o 9:16; otras relaciones de aspecto se recortarán.
resolutionstringObligatorioPredeterminado: "720p"Resolución del vídeo de salida; cuanto mayor sea la resolución, mayor será el coste; por defecto 720p.
720p1080p4kaspect_ratiostringOpcionalPredeterminado: "auto"Relación de aspecto del vídeo de salida; por defecto auto, lo que significa que sigue la relación de aspecto de la imagen de entrada.
auto16:99:16generate_audiobooleanOpcionalPredeterminado: trueIndica si se genera una pista de audio nativa; al activarlo el precio es mayor; activado por defecto.
negative_promptstringOpcionalIndicación negativa que describe el contenido que debe evitarse en el vídeo generado.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "veo-3.1/image-to-video",
  "input": {
    "prompt": "…",
    "duration": 8,
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "auto",
    "generate_audio": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "veo-3.1/image-to-video",
input: {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "veo-3.1/image-to-video",
"input": {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 PixVerse V6 PixVerse $0.036 /segundo
-
 HeyGen Avatar V HeyGen $0.150 /segundo
-
 Veo 3.1 Fast Google $0.170 /segundo
-
 FLUX 3 Max Black Forest Labs $0.061 /segundo
-
 Kandinsky 6.0 Pro $1.93 /vídeo
-
 Ray 3.2 Luma $0.214 /vídeo
-
 Seedance 2.0 ByteDance $0.017 /segundo
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Vidu Q4 Preview Vidu $0.051 /segundo
-
 Vidu Q3 Vidu $0.149 /segundo
-
 Gemini Omni 1.1 Flash Google $0.450 /vídeo
-
 Kling 3.0 Kuaishou $0.100 /segundo
Mismo proveedor
-
 Gemini 3.1 Flash TTS Google --
-
 Google Virtual Try-On Google $0.107 /imagen
-
 Imagen 4 Google $0.030 /imagen
-
 Veo 3.1 Lite Google $0.060 /segundo
- Gemini Omni 1.1 Flash Google $0.450 /vídeo
-
 Lyria 3.5 Google $0.090 /canción
-
 Nano Banana 2 Google $0.036 /imagen
-
 Gemini Omni Google --
-
 Nano Banana 2 Lite Google $0.033 /imagen
-
 Lyria 3 Pro Google $0.140 /canción
- Veo 3.1 Fast Google $0.170 /segundo
-
 Nano Banana Google $0.021 /imagen