
Guide d'utilisation
Bibliothèque de prompts d'images IA : 10 prompts prêts pour la production, organisés par cas d'usage
Dix prompts testés sur l'API task de hiapi à travers cinq scénarios réels — e-commerce, réseaux sociaux, avatars, présentation produit et illustration éditoriale — avec les modèles et ratios d'aspect qui ont réellement fonctionné.
La plupart des bibliothèques de prompts en ligne ne sont en réalité que des murs d'inspiration déguisés : de belles captures d'écran, sans modèle indiqué, sans résolution, sans ratio d'aspect, et impossible de savoir si le résultat tient encore debout une fois réduit ou en production. Cette bibliothèque-ci fait exactement l'inverse. Chaque prompt ci-dessous a été testé sur l'API task de hiapi, avec le modèle et le ratio d'aspect indiqués. Copiez-le directement dans votre propre flux de travail, changez un nom, et vous obtiendrez un résultat exploitable dès le premier essai.
Cette collection est organisée autour de cinq grands cas d'usage — ceux qui couvrent l'écrasante majorité du travail d'image en production : visuels principaux e-commerce, couvertures pour les réseaux sociaux, avatars, présentations produit et illustrations éditoriales stylisées. Chaque section associe un prompt à un modèle testé, pour que vous sachiez s'il faut choisir le qwen-image-2.0 économique ($0,025/image), la référence photoréaliste flux-1.1-pro ($0,05), le Nano-Banana adapté à la cohérence ($0,05), ou le gpt-image-2 adapté au rendu de texte ($0,03 en résolution 1K).
1. Visuels principaux e-commerce
Vignettes de listing produit et images en situation — les deux visuels dont chaque produit a besoin. La vignette va sur fond blanc pour le catalogue ; l'image en situation insuffle de la vie dans une publicité sur les réseaux sociaux payants. Indiquez toujours explicitement la description du produit, la lumière et le ratio d'aspect ; laissez le modèle décider des textures et de l'étalonnage des couleurs.
Prompt 1 —— Vignette catalogue sur fond blanc pur (gpt-image-2, 1:1)
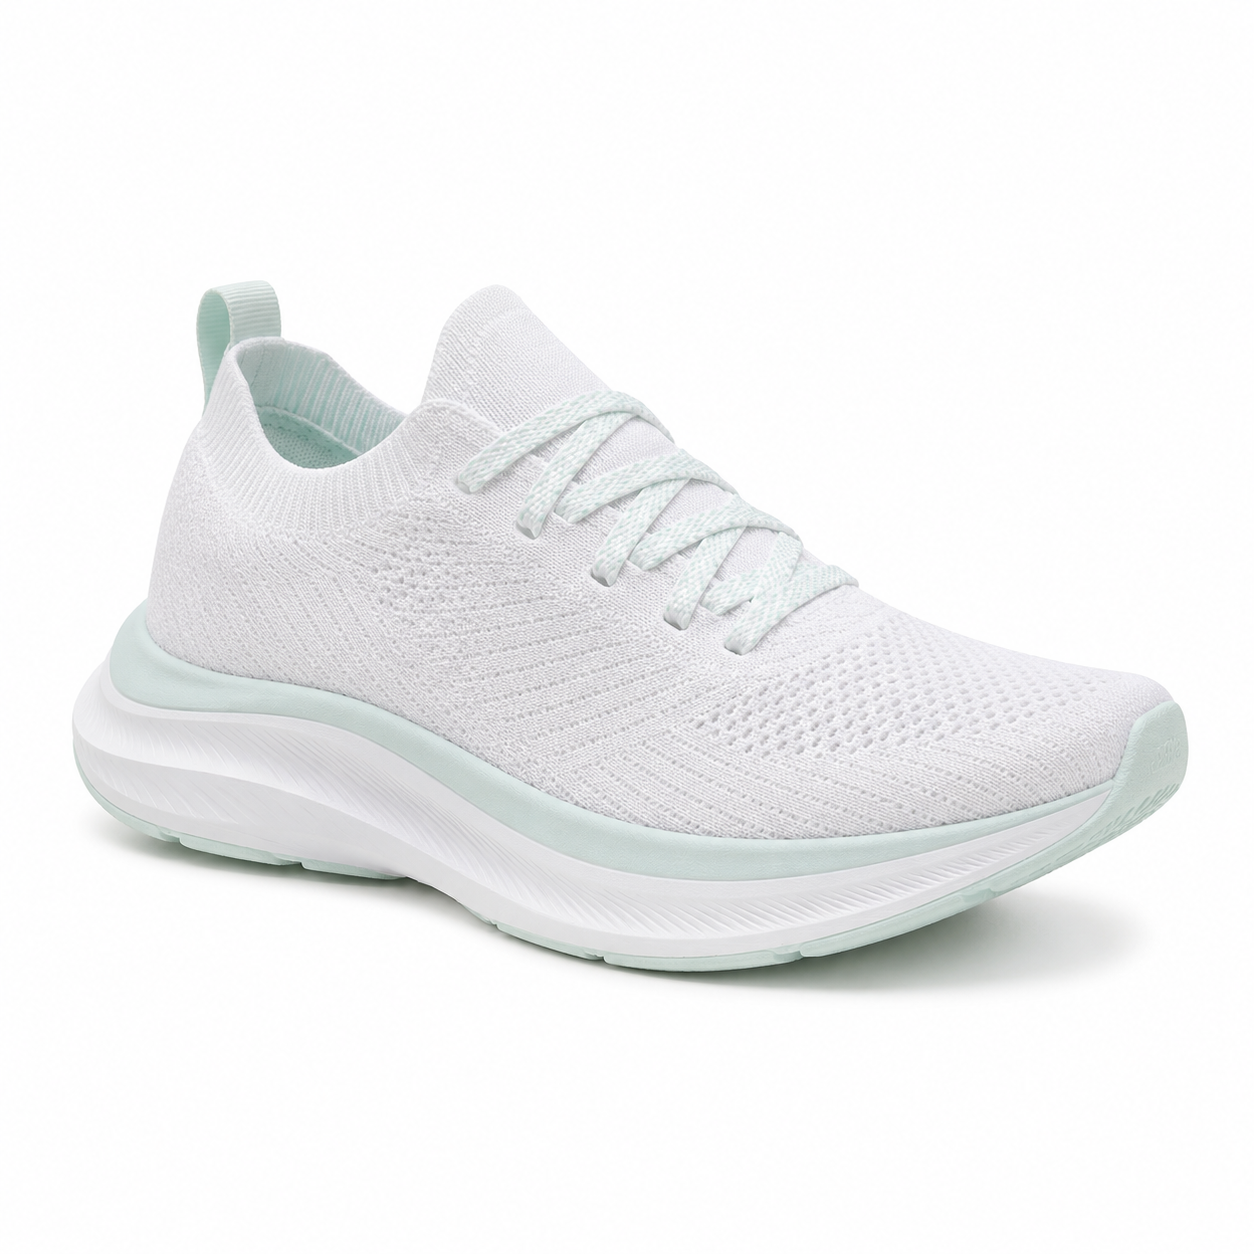
Studio product photograph of a single low-profile white knit running shoe with subtle mint
accents, centered on a pure white seamless cyclorama, soft top-down key light with a gentle
fill from camera left, contact shadow only, sharp focus on the heel cup and shoelace texture,
no logos, no text, 1:1 square crop suitable for an e-commerce listing thumbnail.
Pourquoi ça fonctionne. Ce prompt est rédigé comme un brief donné à un photographe : un sujet, un dispositif d'éclairage, un cadrage. « Contact shadow only » (ombre de contact uniquement) évite l'effet de produit flottant. « No logos, no text » (aucun logo, aucun texte) compte plus qu'on ne le croit — les modèles d'image adorent inventer des marques. Testé sur gpt-image-2 au ratio 1:1, coût de $0,03 ; pour un visuel principal à plus haute fidélité, passez à Nano-Banana-Pro à $0,17.
Prompt 2 —— Image en situation avec action (flux-1.1-pro, 4:3)
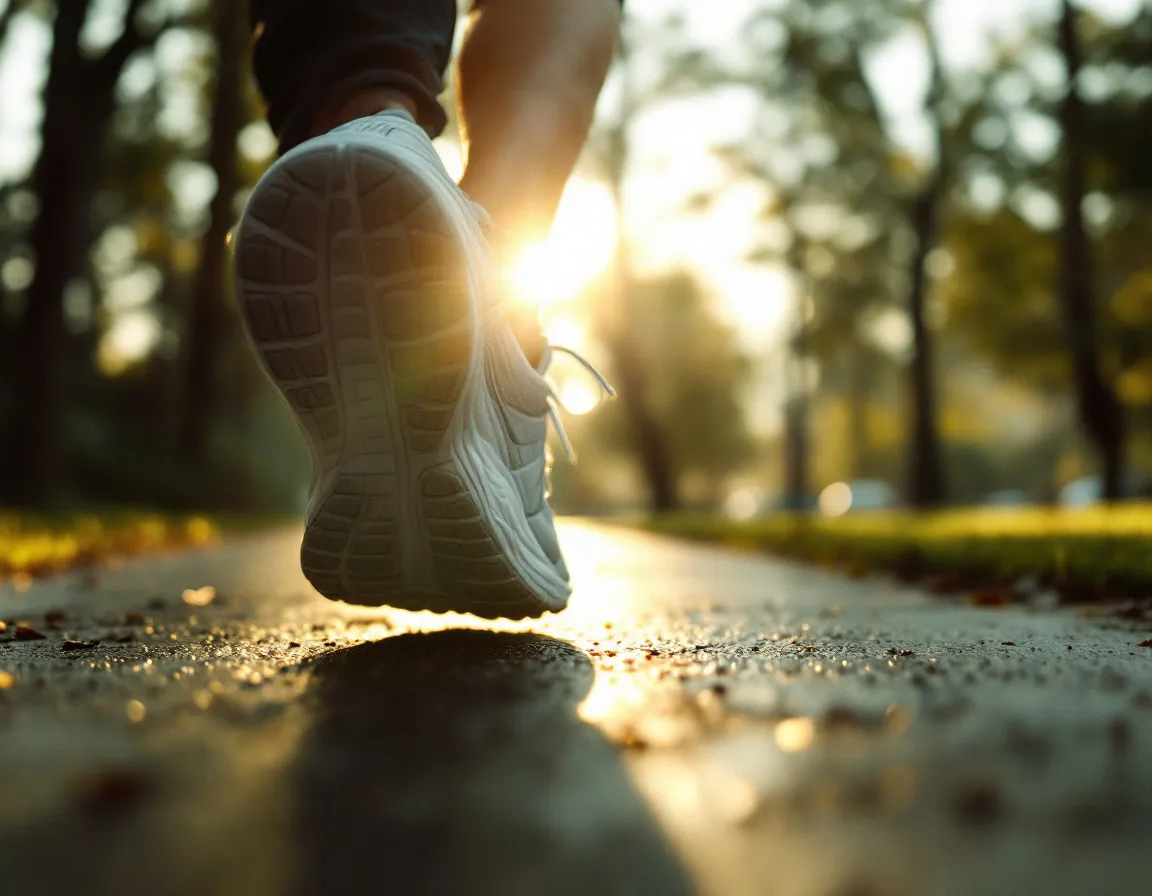
Editorial lifestyle photograph of the same white running shoe, now worn on a runner's foot
mid-stride on a damp morning sidewalk in a quiet park, golden hour rim light, shallow depth
of field f/2.0, slight motion blur on the trailing leg, faint warm fog in the background,
35mm film grain, color graded with muted greens and warm highlights, 4:3 aspect.
Pourquoi ça fonctionne. flux-1.1-pro est la référence photoréaliste de hiapi — il restitue de manière fiable la sensation de photographie argentique (grain, aberrations d'objectif, brume atmosphérique) qui manque à une image catalogue sur fond blanc pur. Les deux ancres « f/2.0 » et « 35mm film grain » font l'essentiel du travail. Le 4:3 est un cadrage adapté aux réseaux sociaux : il ne sera pas recadré en carré par Instagram et reste lisible sur LinkedIn.
2. Couvertures pour les réseaux sociaux
Les couvertures capables de s'adapter à la fois à une bannière LinkedIn, à une pochette de podcast Spotify et à un en-tête X ont un point commun : les décisions typographiques sont prises dans le prompt, et non ajoutées après coup. gpt-image-2 est le modèle le plus fiable pour rendre un texte précis ; pour une sortie en 4K, Nano-Banana-2 est l'alternative.
Prompt 3 —— Pochette de podcast avec grande typographie (gpt-image-2, 1:1)
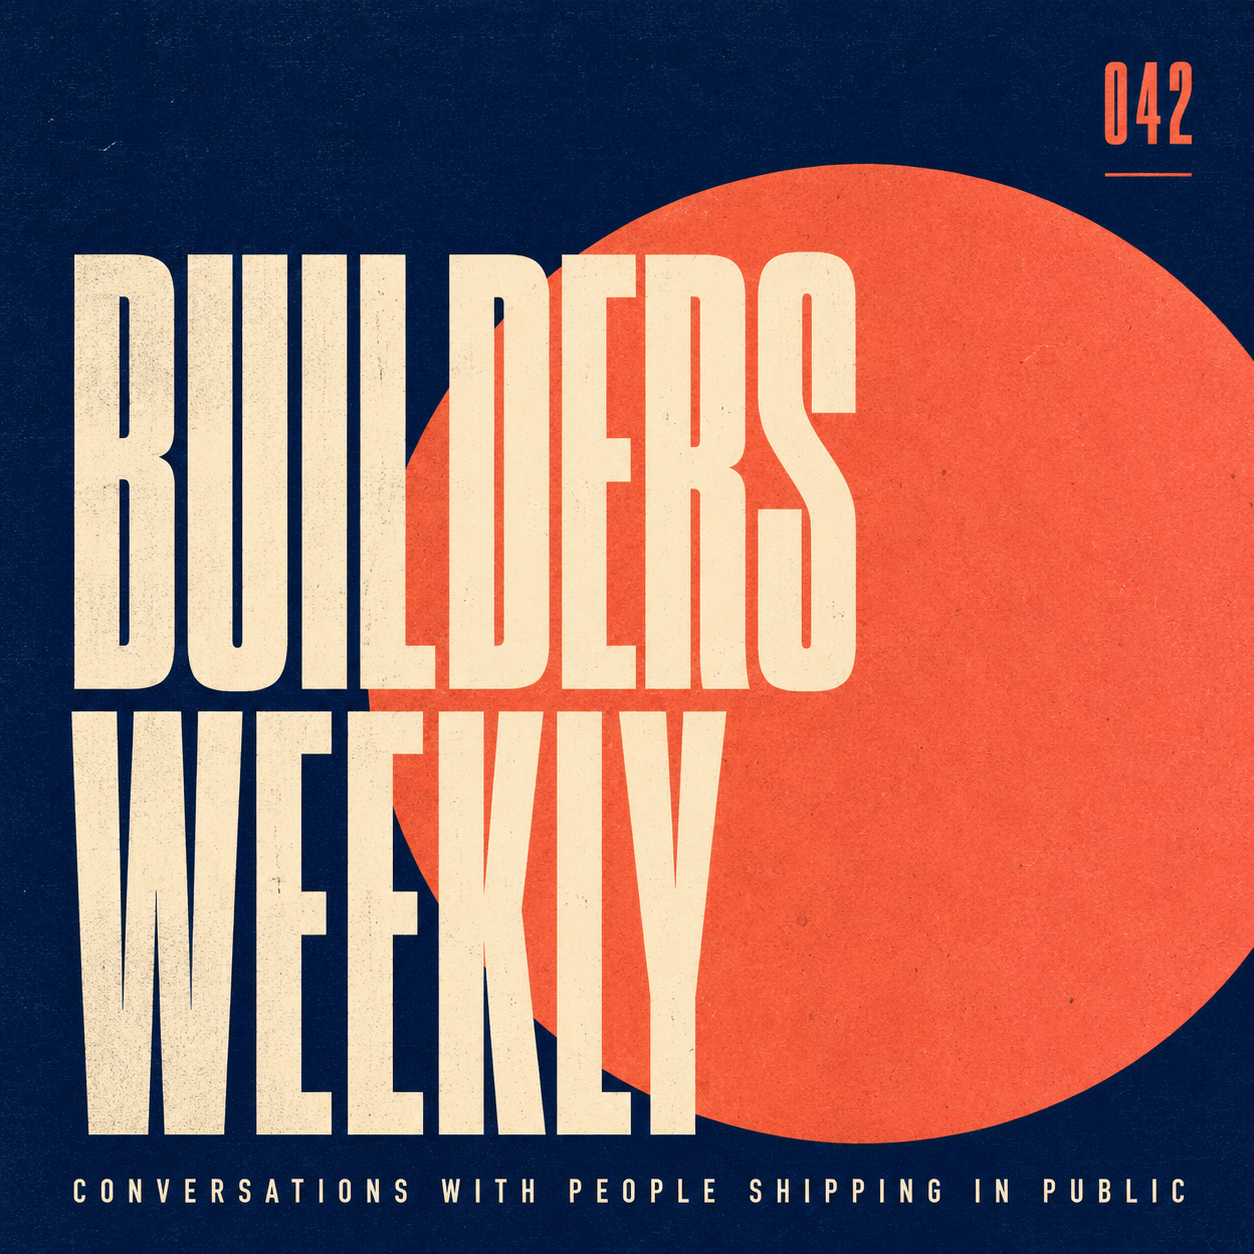
Square podcast cover: bold geometric layout, deep navy background with one large off-center
coral circle, condensed sans-serif title 'BUILDERS WEEKLY' in cream on three lines stacked
tightly, smaller all-caps tagline 'Conversations with people shipping in public' along the
bottom edge, episode number 042 micro-typed in the upper right, subtle paper grain, 1:1 aspect,
designed at Spotify cover proportions, no human faces, no logos.
Pourquoi ça fonctionne. Trois règles à connaître pour un prompt typographique : (1) précisez la casse (« all caps », tout en majuscules) ; (2) précisez la position dans la mise en page (« trois lignes empilées serrées », « en haut à droite ») ; (3) indiquez le style de police (« condensed sans-serif », sans empattement condensé). Sans cela, le modèle improvise et vous obtenez des empattements là où il n'en faut pas. gpt-image-2 rend de manière fiable jusqu'à environ 4-5 lignes de mots anglais par image.
Prompt 4 —— Bannière LinkedIn avec grand titre (gpt-image-2, 16:9)
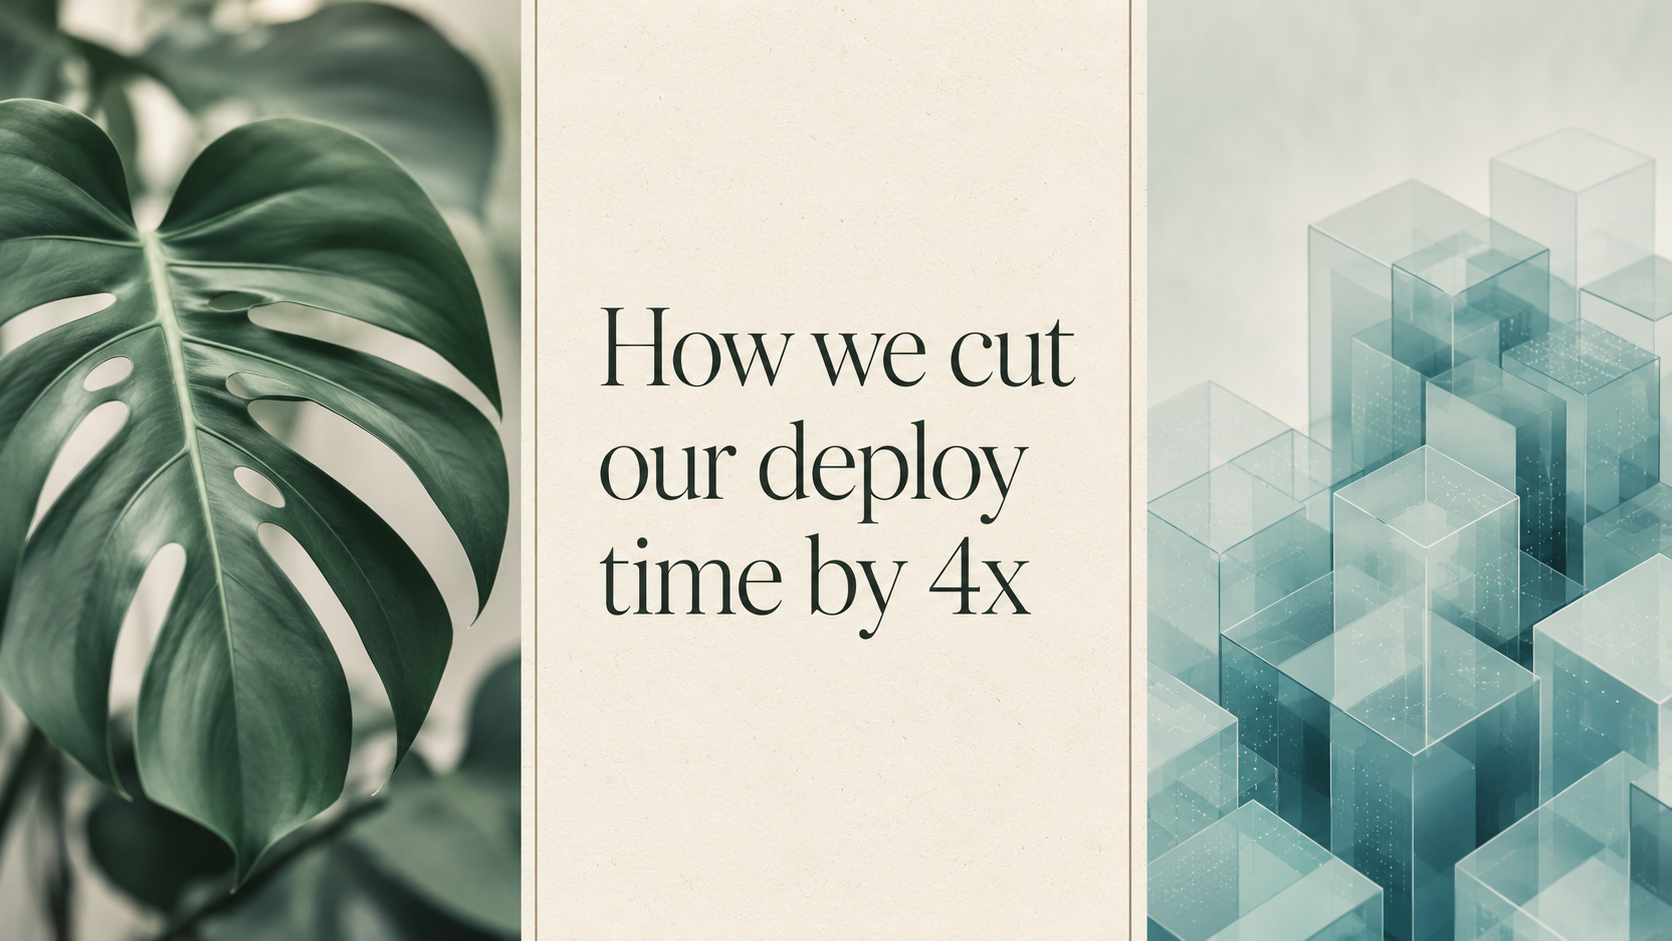
Wide LinkedIn banner: editorial collage layout, three vertical strips. Left strip a soft-focus
monstera leaf in jade green, middle strip a clean cream rectangle with the title 'How we cut
our deploy time by 4x' set in a refined serif at three lines, right strip an abstract isometric
render of stacked translucent cubes in pale teal. Thin separator lines in warm gray, subtle
paper texture, 16:9 ratio sized for LinkedIn 1584x396 proportions.
Pourquoi ça fonctionne. « Trois bandes verticales » impose au modèle une grille de composition stricte ; sans cela, vous obtenez un fouillis d'éléments superposés. « Nommer clairement les proportions LinkedIn en anglais simple (1584x396) » n'entre pas en conflit avec le ratio 16:9 que vous transmettez à l'API hiapi : le modèle traite les deux comme une intention de design.
3. Avatars et portraits
Deux approches : l'avatar photoréaliste (Nano-Banana excelle à maintenir la cohérence entre plusieurs poses) et l'avatar géométrique stylisé (n'importe quel modèle peut le faire ; qwen-image-2.0 est le moins cher). Les deux exigent de décrire explicitement l'âge, le teint, la coiffure et l'expression — rester vague ne produit que des moyennes étranges.
Prompt 5 —— Avatar professionnel photoréaliste (Nano-Banana, 1:1)
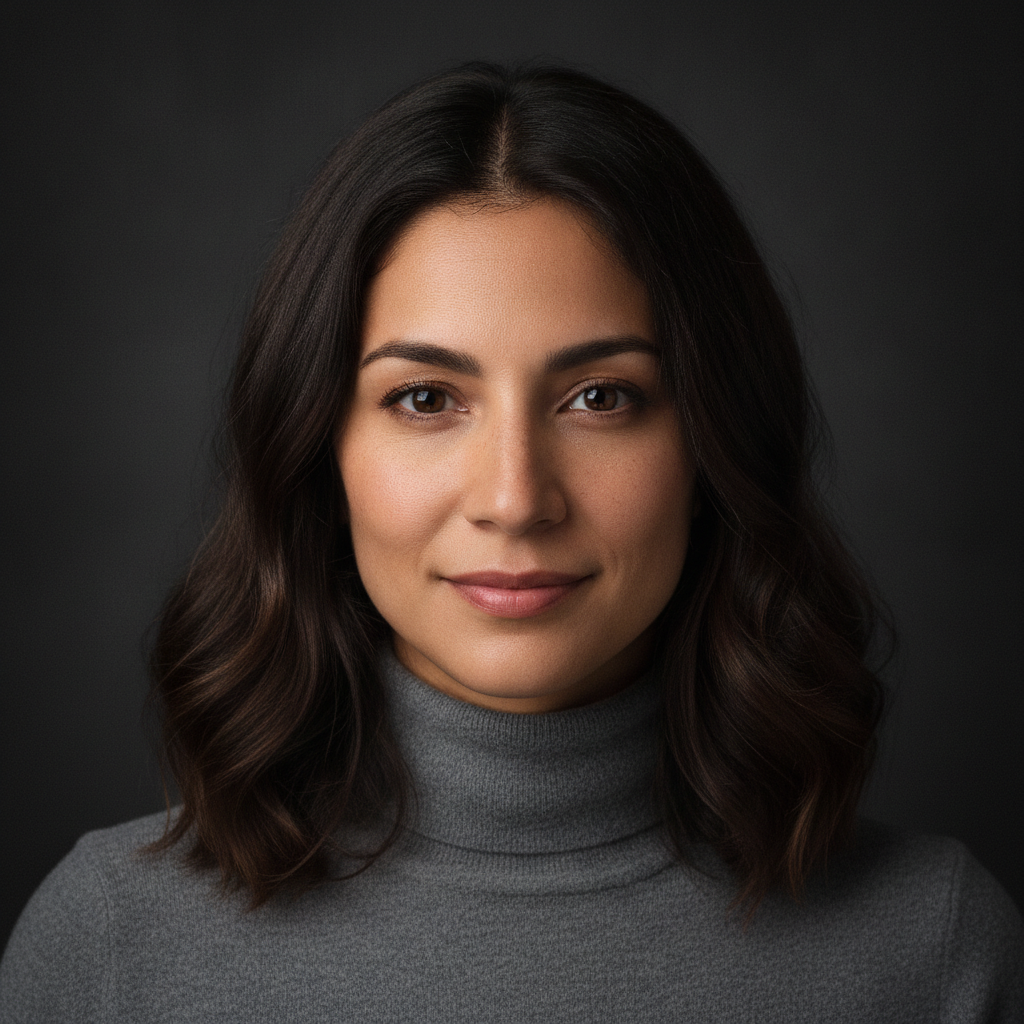
Professional headshot avatar: a 32-year-old woman with shoulder-length dark brown hair, warm
olive skin, faint freckles, wearing a soft charcoal turtleneck, neutral expression with a
gentle close-mouthed smile, looking directly at camera at eye level. Lit with a single large
softbox from camera left, dark seamless gray background falling off to near-black, 50mm
portrait lens, sharp focus on the eyes, subtle skin texture preserved, 1:1 square crop
tightened to the shoulders.
Pourquoi ça fonctionne. « Subtle skin texture preserved » (texture de peau subtile préservée) est la phrase la plus importante de tout prompt de portrait — sans elle, vous obtenez cet aspect plastique lisse qui trahit immédiatement un avatar IA. Nano-Banana est aussi le bon choix lorsque vous aurez ensuite besoin d'autres poses du même personnage ; sa réputation de cohérence entre personnages n'est pas un argument marketing.
Prompt 6 —— Avatar géométrique plat (Nano-Banana, 1:1)
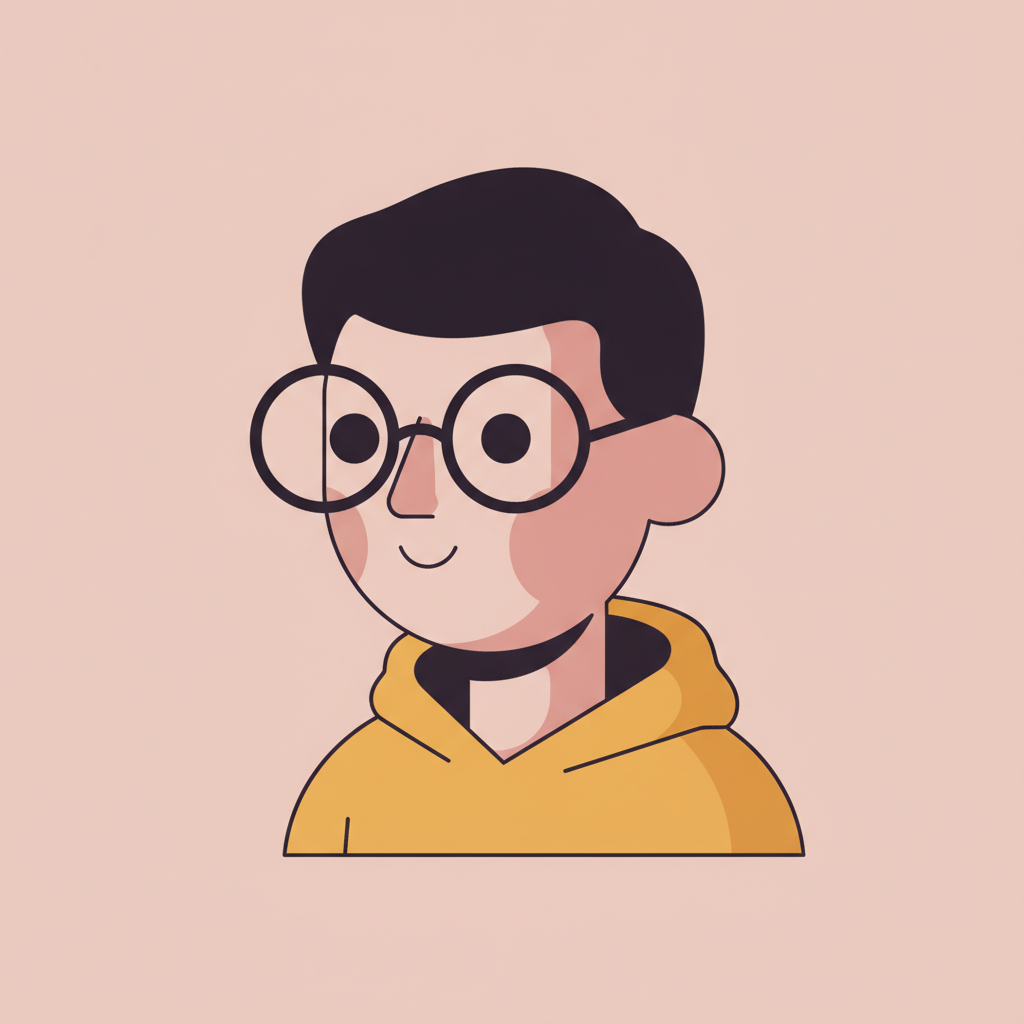
Stylized avatar illustration in a flat geometric style: a young man with short black hair,
round glasses, wearing a mustard-yellow hoodie, three-quarter view, simplified facial features
built from soft circles and rounded rectangles, two-tone shadowing in deep plum on a pale
dusty rose background, thin black outline only at the silhouette, no gradients, no facial
wrinkles, 1:1 square crop, designed to read clearly at 80x80 pixels.
Pourquoi ça fonctionne. « Designed to read clearly at 80x80 pixels » (conçu pour rester lisible en 80x80 pixels) force le modèle à recourir à de grandes formes plutôt qu'à des détails fins. La liste de ce qu'il faut exclure (« no gradients, no facial wrinkles » — pas de dégradés, pas de rides) fait office de note d'intention artistique — elle pousse le résultat vers l'extrémité géométrique du spectre, loin du style de portrait peint par défaut du modèle.
4. Présentation et mise en scène produit
Au milieu d'une page produit ou dans une comparaison de fonctionnalités, il faut souvent quelque chose de plus propre qu'un visuel principal : une vue à plat bien nette, un schéma isométrique éclaté, une maquette de packaging. flux-1.1-pro excelle en photographie à plat ; qwen-image-2.0 est parfait pour produire à faible coût des illustrations propres dans un style 3D.
Prompt 7 —— Vue à plat photographiée du dessus (flux-1.1-pro, 4:3)
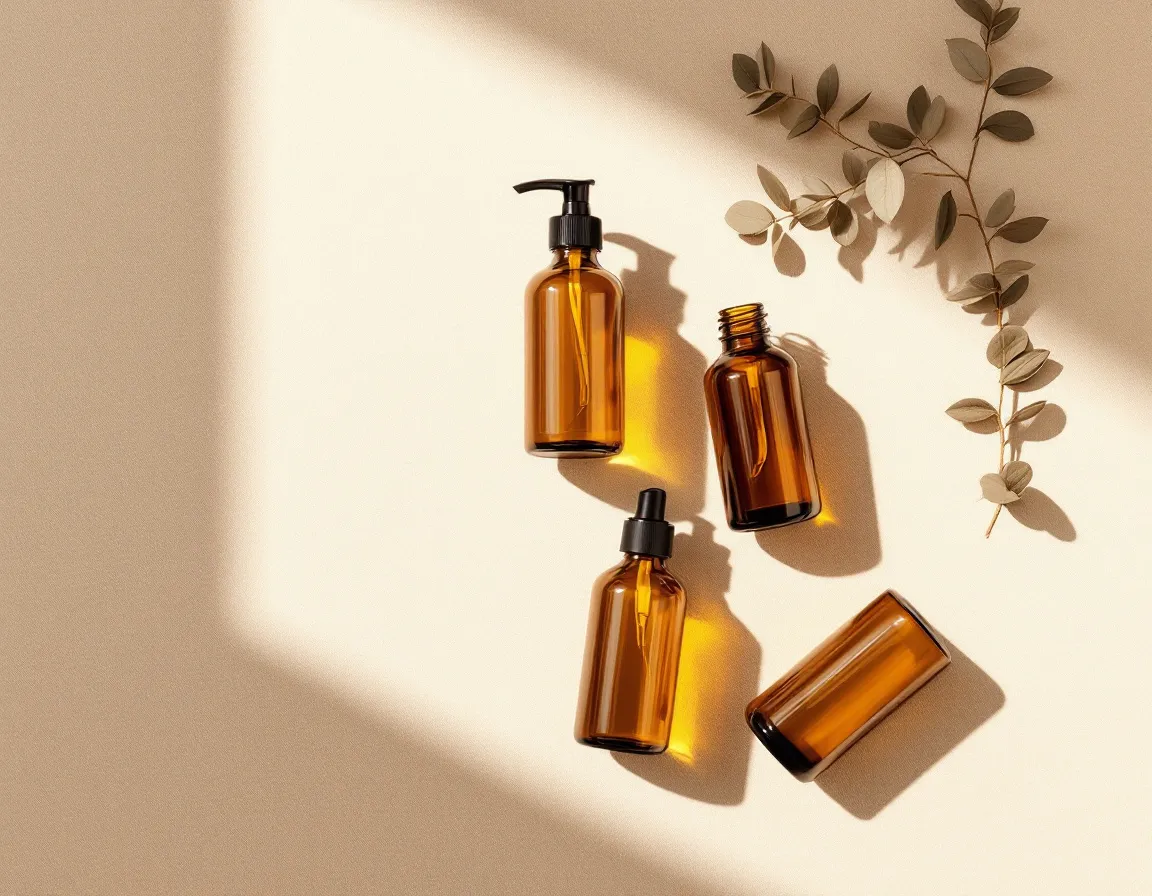
Overhead flat-lay photograph of four amber glass cosmetic bottles arranged in a square grid
on a sand-colored linen surface, generous even spacing, soft diffused daylight from above
creating soft shadows directly underneath each bottle, a single dried eucalyptus sprig in the
upper right corner for balance, no labels, no caps, sharp focus across the whole frame, 4:3
aspect, color graded warm and minimal.
Pourquoi ça fonctionne. Les mots-clés qui font le travail sont « soft diffused daylight from above » (lumière du jour diffuse et douce venant d'en haut — qui définit la lumière), « square grid » (grille carrée — qui définit la disposition), « sharp focus across the whole frame » (netteté sur toute l'image — qui empêche le modèle de créer une faible profondeur de champ) et « no labels » (aucune étiquette — qui empêche l'invention de marques). La branche d'eucalyptus est une asymétrie volontaire — sans elle, les quatre flacons de la grille paraîtraient figés.
Prompt 8 —— Rendu produit isométrique propre (qwen-image-2.0, 4:3)
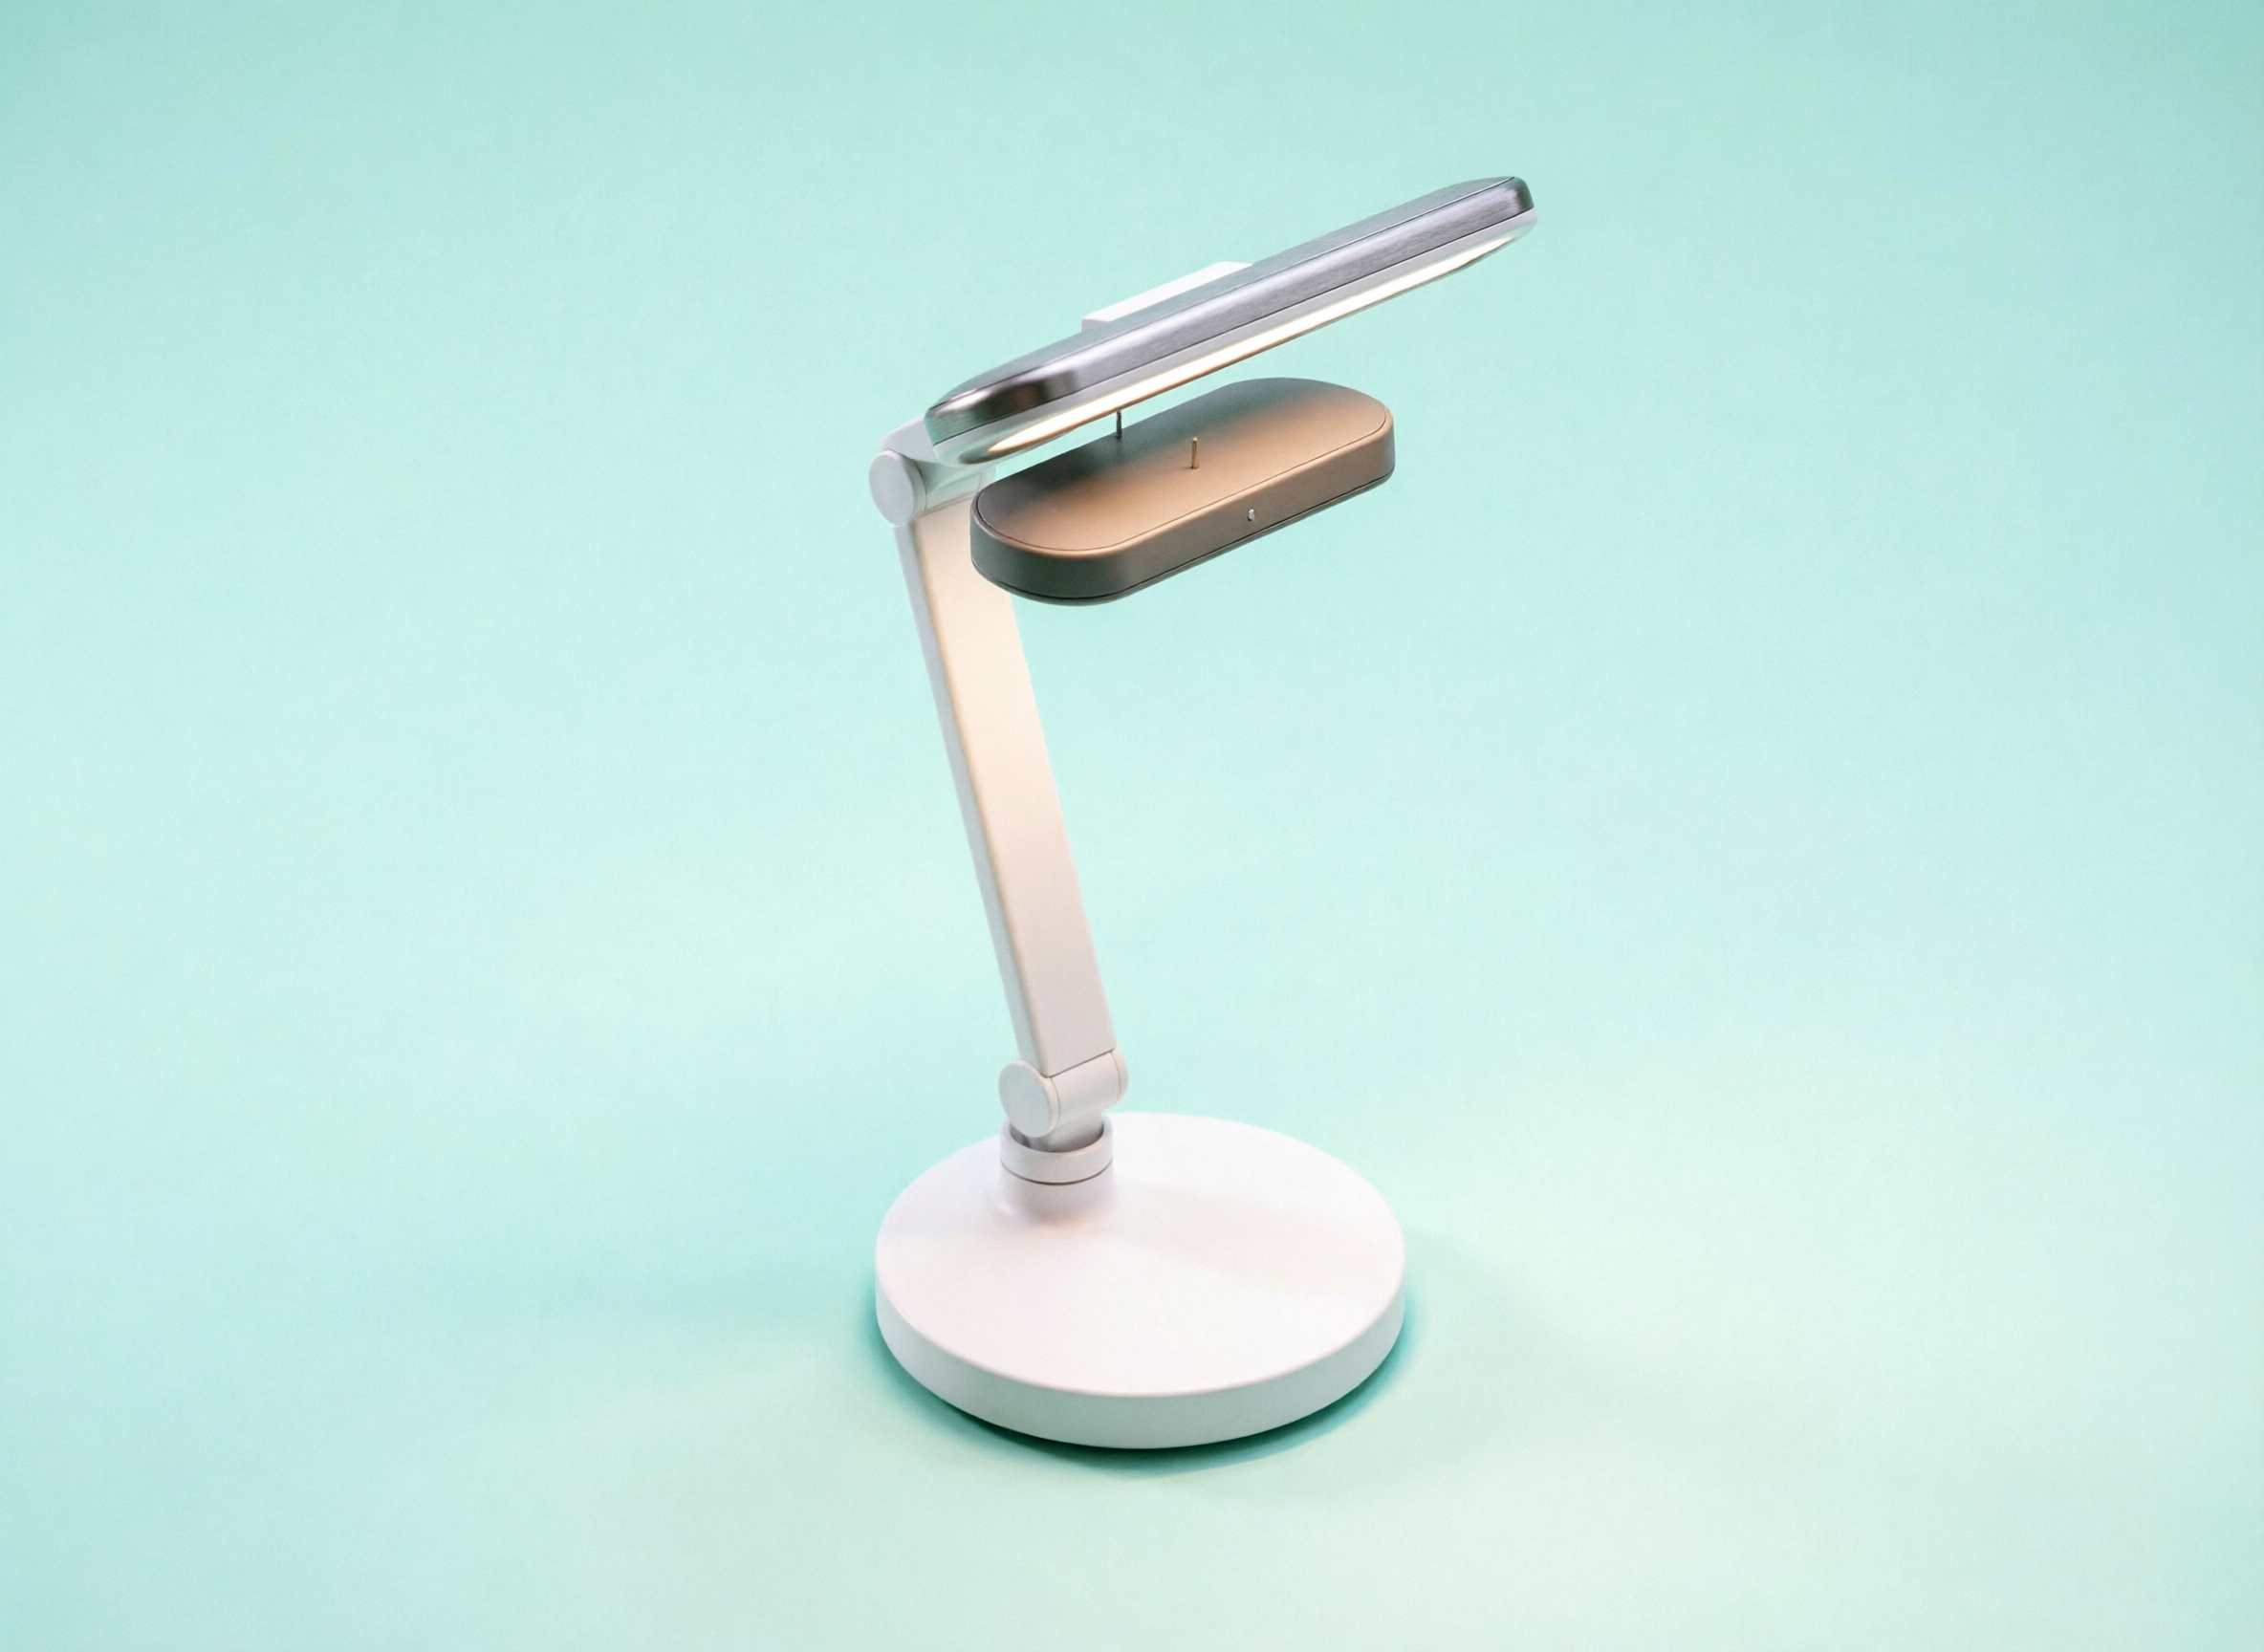
Clean isometric 3D illustration of a single smart desk lamp, exploded view showing four stacked
layers — base disc, articulated arm, head housing, LED panel — separated by thin connector
lines, on a pale mint background with a single very soft drop shadow, matte finish materials
in white and warm gray, no text, no annotations, 4:3 aspect, designed to sit cleanly on a
product specification page.
Pourquoi ça fonctionne (et où ça ne fonctionne pas). qwen-image-2.0, à $0,025, est le modèle le plus rentable de hiapi, et il maîtrise de manière fiable les palettes mates et les compositions propres. Mais à partir d'un prompt purement textuel, il refuse généralement de rendre une véritable vue éclatée — ici le résultat est une lampe assemblée bien nette, et non quatre couches séparées, même si les pièces ont été listées une par une. Le processus honnête pour obtenir un schéma éclaté : dessinez vous-même un croquis grossier des couches, puis nettoyez-le avec gpt-image-2/image-to-image. Retenez de cette section la leçon qu'elle donne réellement : confiez au modèle le style, la lumière et la palette ; quand la structure même est le sujet de l'image, dessinez la structure vous-même.
5. Illustrations éditoriales stylisées
Quand l'article est lui-même le produit — essai de fond, newsletter, présentation de conférence — la bonne image d'ouverture est une illustration, pas une photo. Deux styles fiables : l'illustration éditoriale mid-century moderne (formes plates, palette restreinte) et le papier découpé en couches. Les deux paraissent manifestement faits main et évitent la fatigue visuelle de la photographie de stock.
Prompt 9 —— Illustration éditoriale mid-century moderne (gpt-image-2, 3:2)
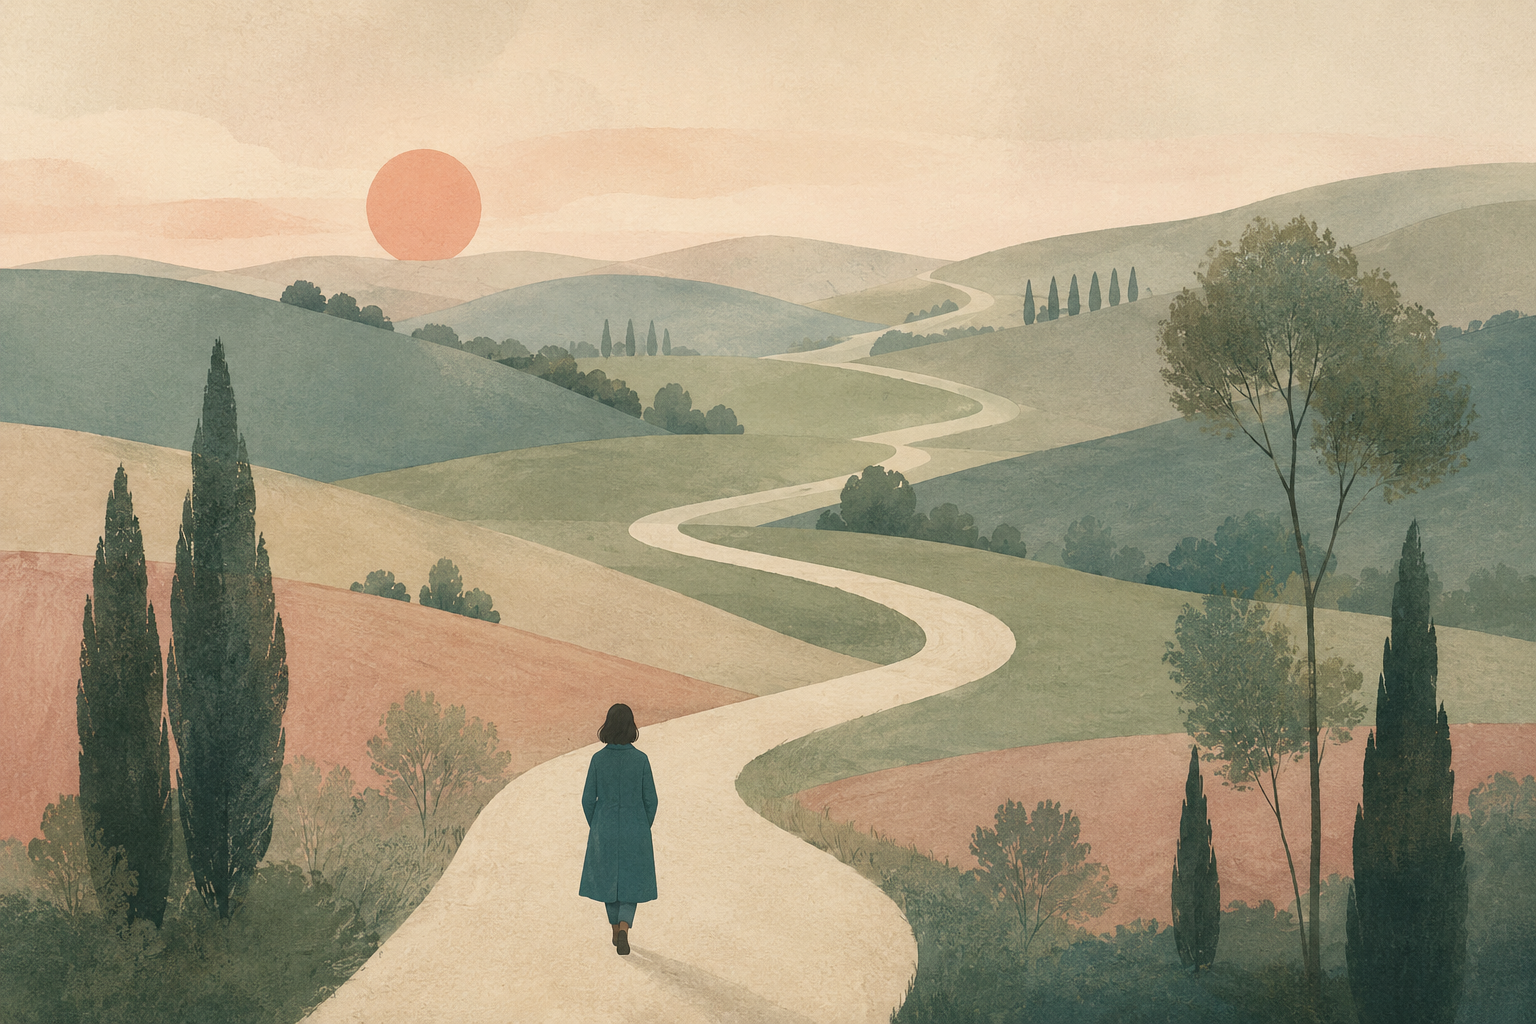
Editorial illustration for a long-form essay titled internally 'The slow web'. Composition: a
small figure in a teal coat seen from behind, walking on a winding cream-colored path that
loops through a soft pastel landscape of rolling muted hills, scattered slender trees, a low
watercolor sun. Style references mid-century editorial illustration, flat shapes, gentle paper
grain, restrained palette of teal, sage, cream and dusty rose, no outlines, no text, 3:2
landscape aspect.
Pourquoi ça fonctionne. Indiquer une référence de style (« illustration éditoriale mid-century ») est plus fiable qu'indiquer le nom d'un artiste — cela oriente le modèle vers une tradition visuelle reconnaissable sans plagier une personne précise. « Restrained palette » (palette restreinte) accompagné de la liste de quatre couleurs est une contrainte plus forte que « soft colors » (couleurs douces) ; le modèle mélangera précisément ces quatre couleurs et sautera tout le reste du spectre.
Prompt 10 —— Illustration en papier découpé en couches (qwen-image-2.0, 1:1)
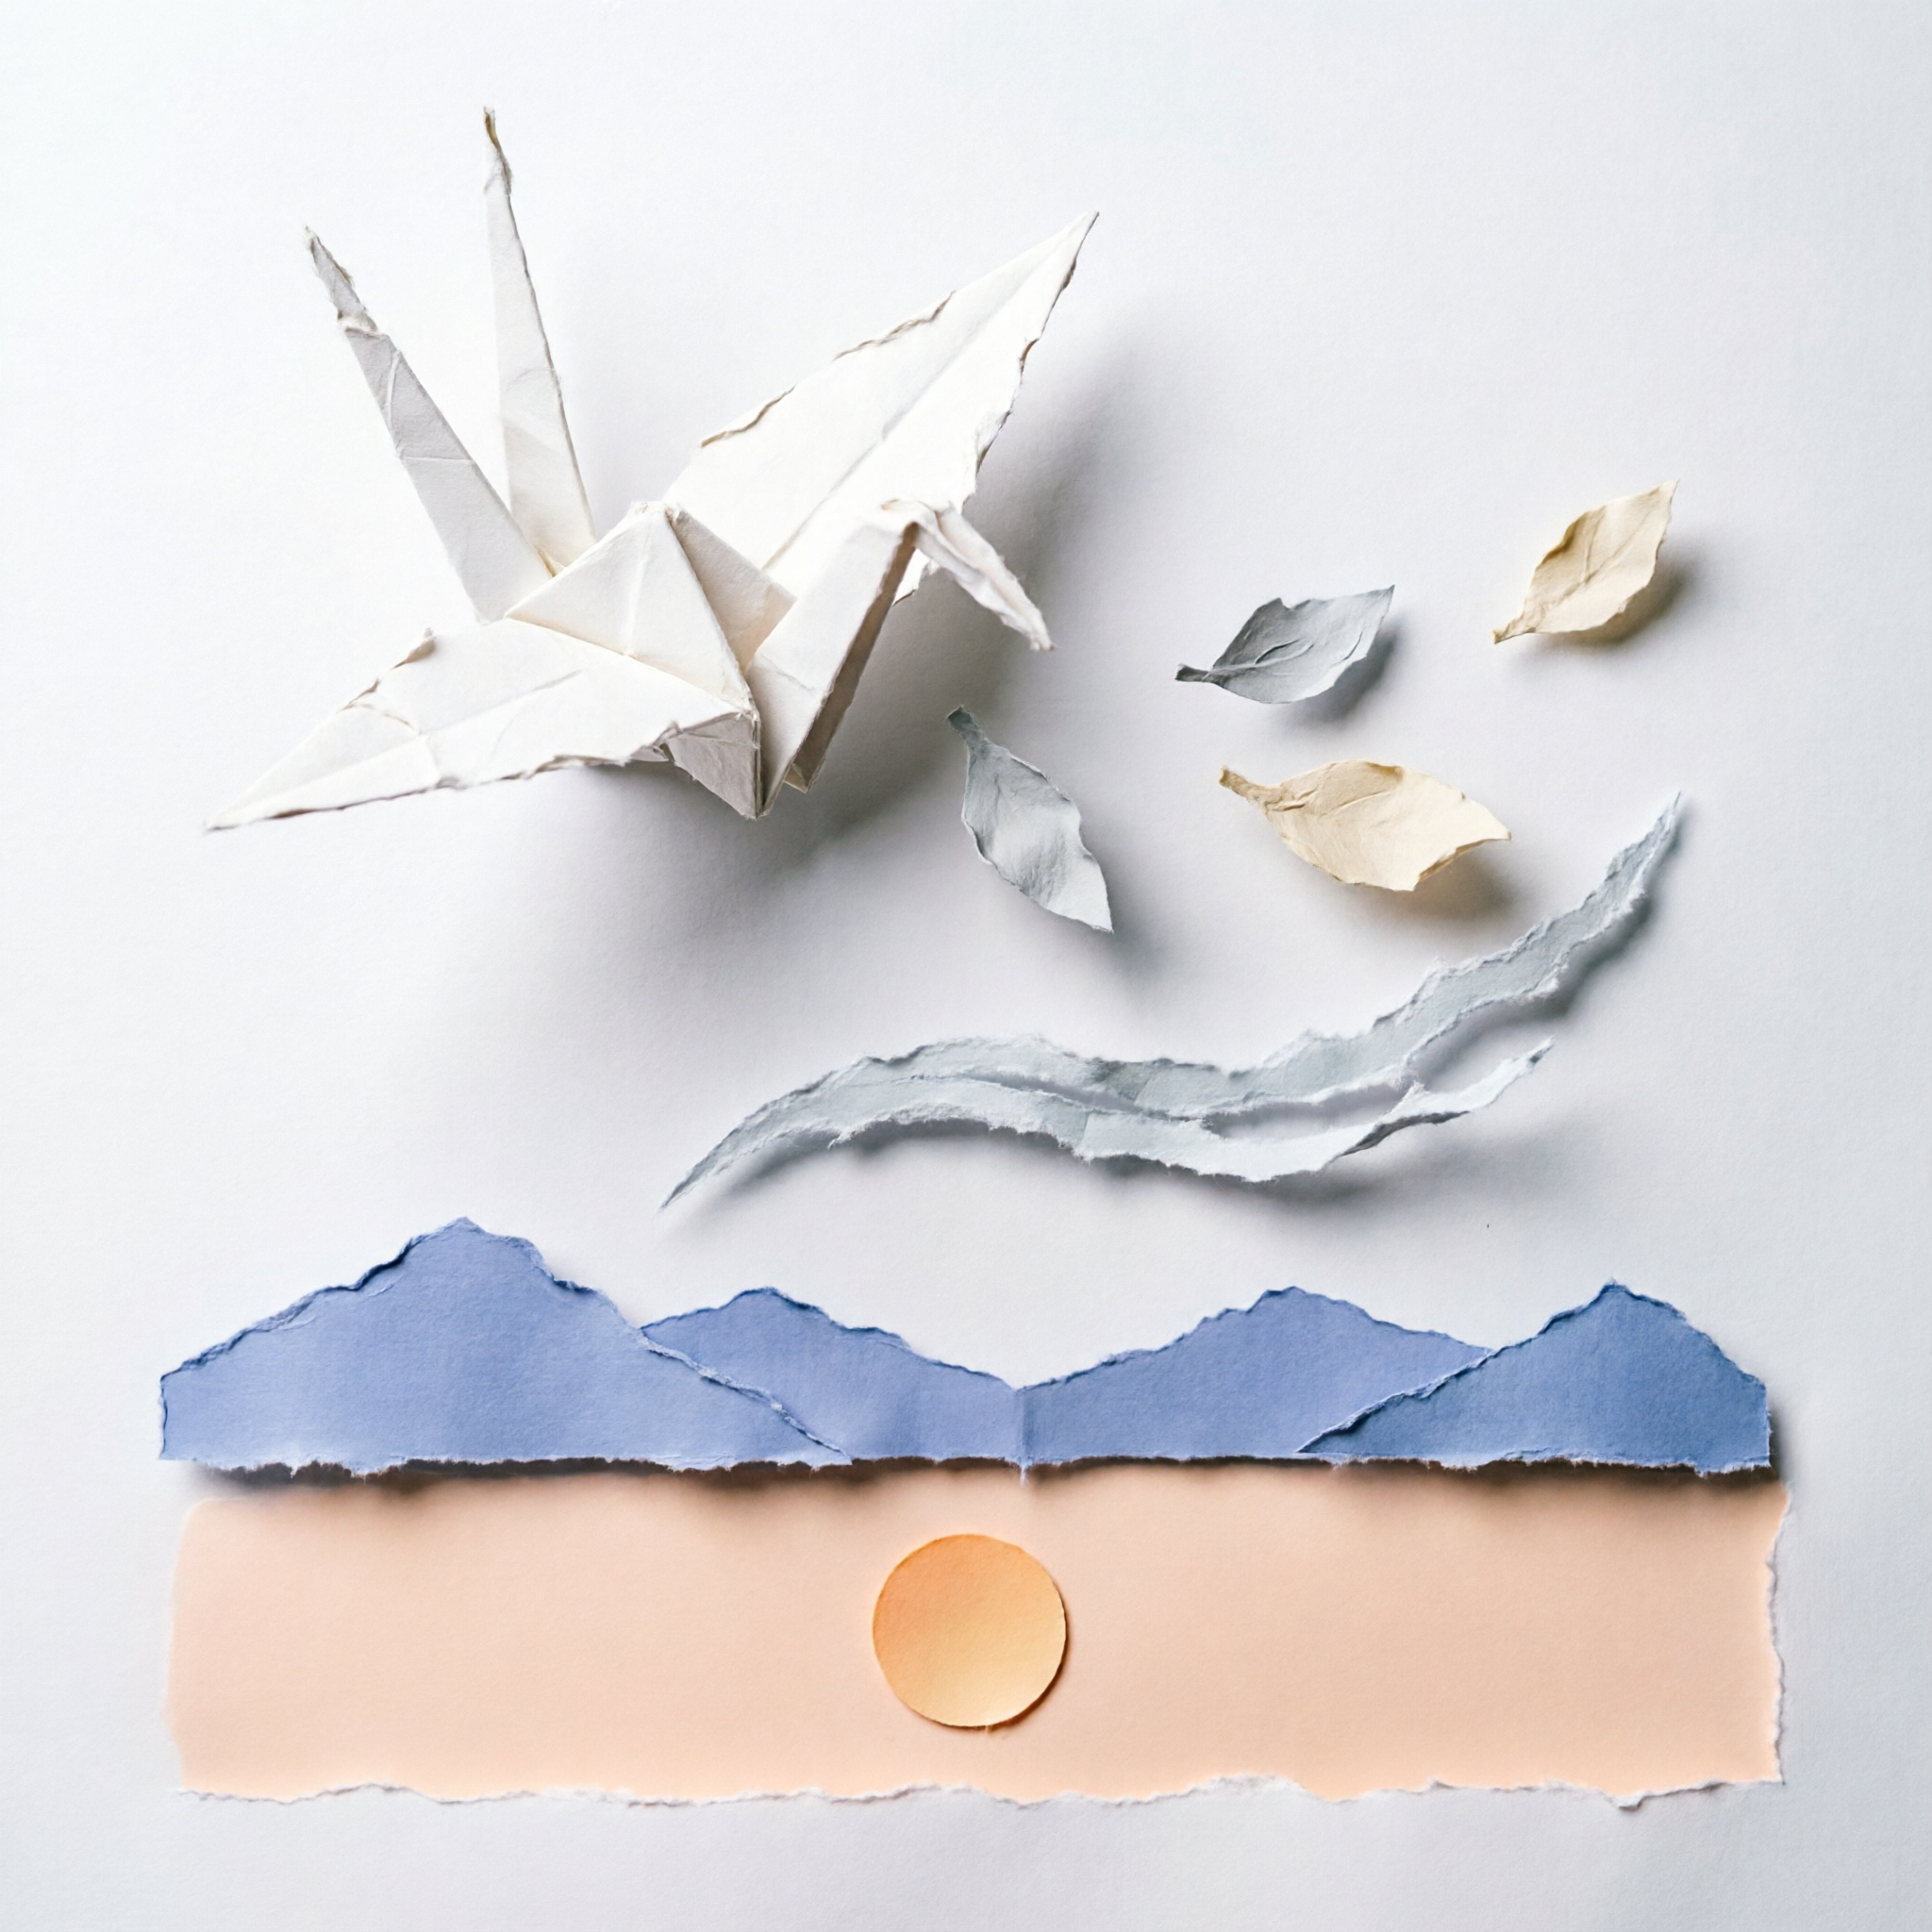
Layered paper-cut illustration of a single origami crane in flight, five distinct paper depth
planes from foreground to background — crane, drifting paper leaves, a torn arc representing
wind, distant mountains in pale indigo, and a flat sky with a single circular sun in pale
peach. Each layer has a soft cast shadow on the layer behind it, slightly rough cut edges,
matte paper texture, 1:1 aspect, balanced composition with the crane in the upper-left third.
Pourquoi ça fonctionne. Spécifier exactement cinq couches donne de la profondeur à l'effet papier découpé, et c'est précisément ce qui le distingue d'une illustration plate. « Slightly rough cut edges » (bords de coupe légèrement irréguliers) et « matte paper texture » (texture de papier mat) sont deux phrases qui empêchent le modèle de rendre le résultat comme un vecteur numérique lisse — ce qui détruirait tout l'intérêt de ce style.
Comment réécrire ces prompts
Trois règles traversent toutes les sections ci-dessus. Indiquez deux fois le ratio d'aspect — une fois dans l'appel API (le champ aspect_ratio de hiapi), une fois dans le texte du prompt (« 4:3 aspect »). Le modèle traite les deux comme une intention de design, et le résultat correspond au conteneur de la page. Écrivez explicitement ce qu'il faut exclure (« no logos », « no text », « no gradients ») au moins aussi souvent que ce qu'il faut inclure ; la liste négative façonne le résultat autant que la liste positive. Ancrez le style dans une référence traditionnelle ou technique, plutôt que dans un nom d'artiste — « illustration éditoriale mid-century », « 35mm film grain », « illustration 3D isométrique » — pour obtenir des résultats reproductibles et sans problèmes de droits.
Choisissez le modèle selon la tâche : qwen-image-2.0 pour le travail stylisé à fort volume, gpt-image-2 quand le rendu de texte est primordial, Nano-Banana pour la cohérence des portraits, flux-1.1-pro pour le photoréalisme. Chaque prompt ci-dessus a été exécuté sur l'API task de hiapi en 60 à 120 secondes, pour un coût de $0,025 à $0,05 par image — assez bon marché pour que la bonne méthode soit de générer trois variantes par prompt, de choisir la meilleure, puis de publier.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax