
Guia de uso
Biblioteca de prompts de imagem com IA: 10 prompts prontos para produção organizados por caso de uso
Dez prompts testados na task API da hiapi em cinco cenários reais — e-commerce, redes sociais, avatares, exibição de produtos e ilustração editorial — com os modelos e proporções de tela que funcionaram na prática.
A maioria das bibliotecas de prompts na internet é, na verdade, um mural de inspiração disfarçado: capturas de tela bonitas, sem indicação do modelo, sem resolução, sem proporção de tela, e sem como saber se o resultado continua confiável quando reduzido ou em ambiente de produção. Esta biblioteca é o oposto. Cada prompt abaixo foi testado na task API da hiapi, com o modelo e a proporção de tela indicados. Coloque diretamente no seu próprio fluxo, troque um substantivo e você obterá um resultado utilizável já na primeira tentativa.
Esta coleção está organizada em cinco casos de uso — que abrangem a grande maioria do trabalho de imagem em nível de produção: imagens principais de e-commerce, capas para redes sociais, avatares, exibição de produtos e ilustração editorial estilizada. Cada seção combina um prompt com o modelo testado, para que você saiba quando escolher o qwen-image-2.0 com boa relação custo-benefício (US$ 0,025/imagem), a referência de fotorrealismo flux-1.1-pro (US$ 0,05), o Nano-Banana amigável à consistência (US$ 0,05) ou o gpt-image-2 amigável à renderização de texto (US$ 0,03 em resolução 1K).
1. Imagem principal de e-commerce
Miniatura de listagem de produto e imagem de contexto de uso — as duas imagens de que todo produto precisa. A miniatura entra no catálogo sobre fundo branco; a imagem de contexto de uso dá vida a anúncios pagos em redes sociais. Sempre especifique claramente a descrição do produto, a iluminação e a proporção de tela; deixe o modelo decidir textura e gradação de cor.
Prompt 1 — Miniatura de catálogo em fundo branco puro (gpt-image-2, 1:1)
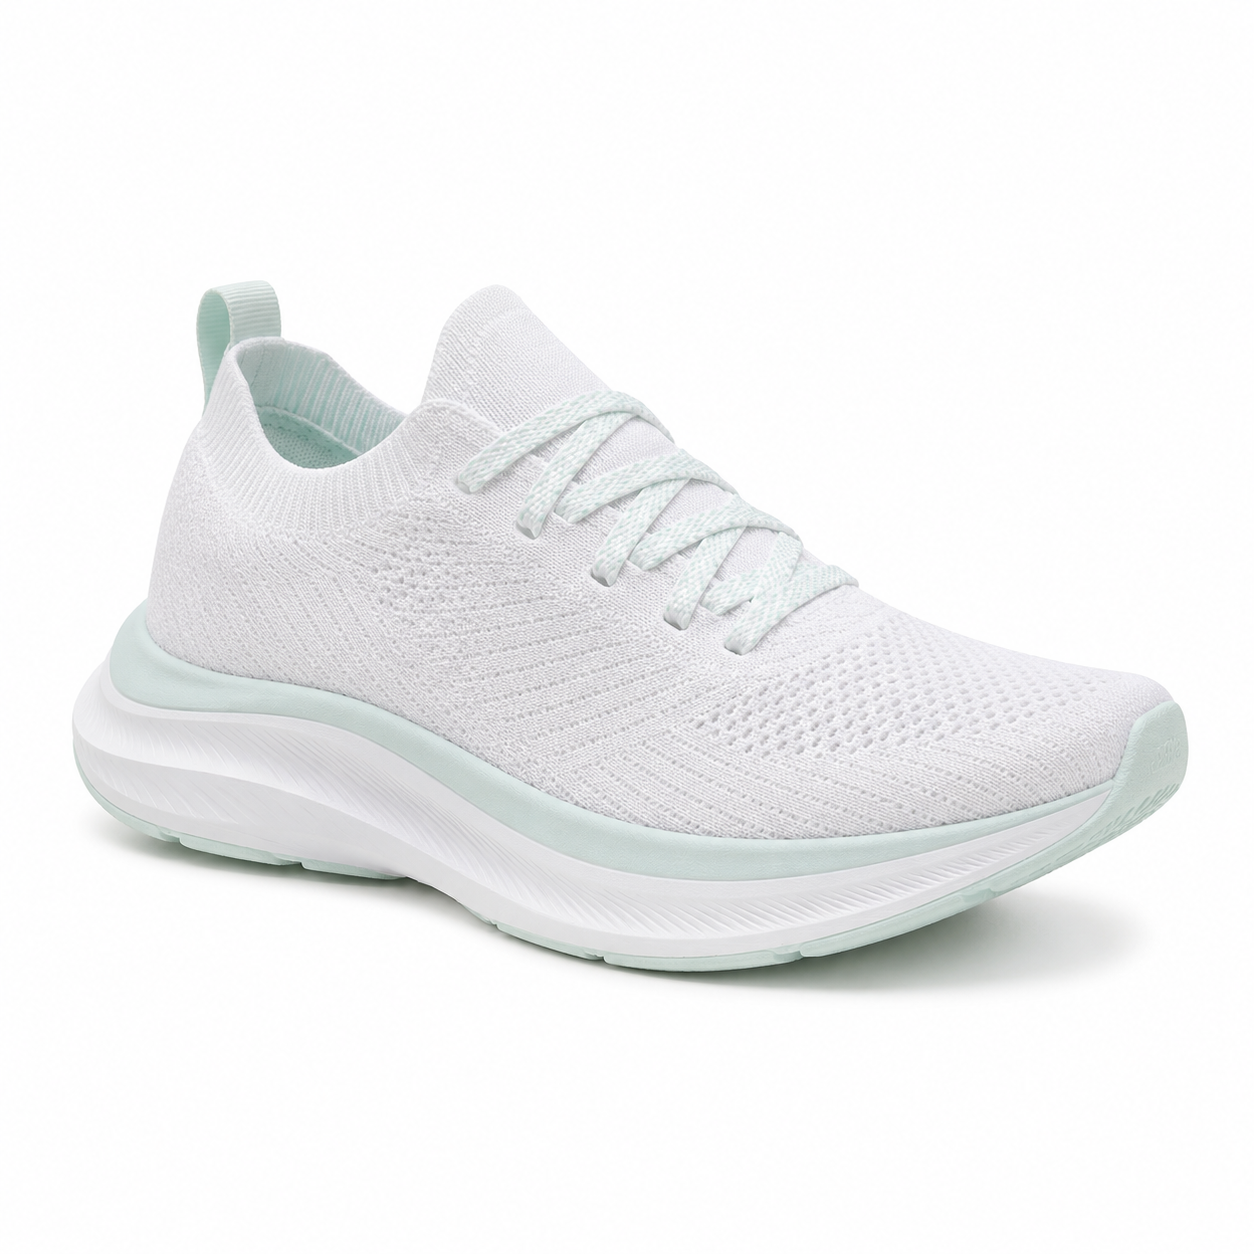
Fotografia de produto em estúdio de um único tênis de corrida de perfil baixo em malha branca com
sutis detalhes em menta, centralizado em um ciclorama contínuo branco puro, luz principal suave
vinda de cima com preenchimento delicado pela esquerda da câmera, apenas sombra de contato,
foco nítido no calcanhar e na textura do cadarço, sem logotipos, sem texto, corte quadrado 1:1
adequado para uma miniatura de listagem de e-commerce.
Por que funciona. Este prompt é escrito como um briefing para um fotógrafo: um sujeito, um esquema de iluminação, um enquadramento. "Apenas sombra de contato" evita a sensação de produto flutuando. "Sem logotipos, sem texto" é mais importante do que parece — os modelos de imagem adoram inventar marcas próprias. Em proporção 1:1 com gpt-image-2, o custo medido foi de US$ 0,03; se precisar de uma imagem principal com maior fidelidade, troque pelo Nano-Banana-Pro a US$ 0,17.
Prompt 2 — Imagem de contexto de uso em movimento (flux-1.1-pro, 4:3)
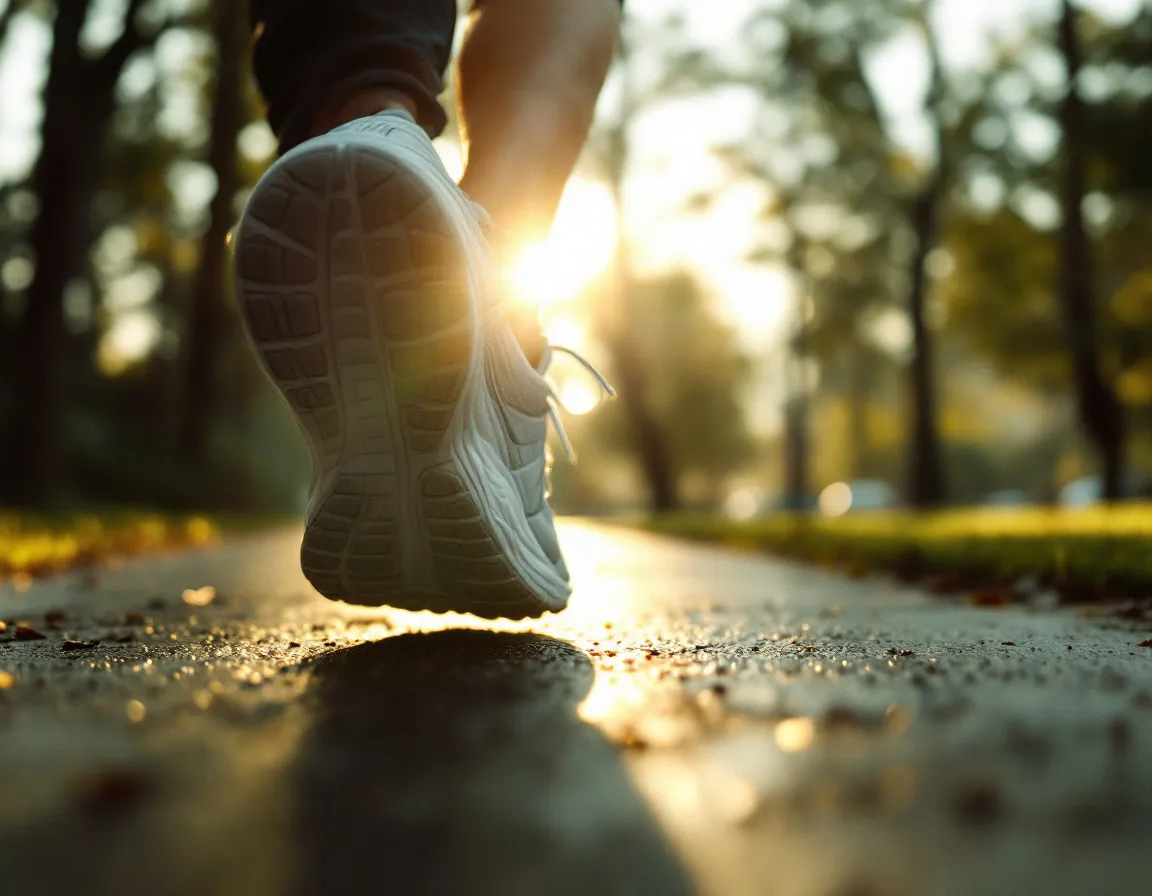
Fotografia editorial de estilo de vida do mesmo tênis de corrida branco, agora usado no pé de
um corredor em passada larga em uma calçada úmida de manhã em um parque tranquilo, luz de
contorno da hora dourada, profundidade de campo rasa f/2.0, leve desfoque de movimento na
perna de trás, névoa quente tênue ao fundo, granulação de filme 35mm, color graded com verdes
suaves e altas luzes quentes, proporção 4:3.
Por que funciona. O flux-1.1-pro é a referência de fotorrealismo da hiapi — ele entrega de forma consistente a estética de fotografia analógica (granulação de filme, aberração de lente, névoa atmosférica) que a imagem de catálogo em fundo branco puro não tem. Os pontos de ancoragem "f/2.0" e "granulação de filme 35mm" fazem o trabalho pesado. 4:3 é um corte adequado para redes sociais: não é cortado em quadrado pelo Instagram e continua legível no LinkedIn.
2. Capas para redes sociais
Capas que funcionam ao mesmo tempo como banner do LinkedIn, capa de podcast no Spotify e cabeçalho do X compartilham uma característica: as decisões tipográficas são tomadas dentro do prompt, não adicionadas depois. O gpt-image-2 é o modelo mais confiável para renderizar texto específico; quando precisa de saída em 4K, o Nano-Banana-2 é a alternativa.
Prompt 3 — Capa de podcast com tipografia grande (gpt-image-2, 1:1)
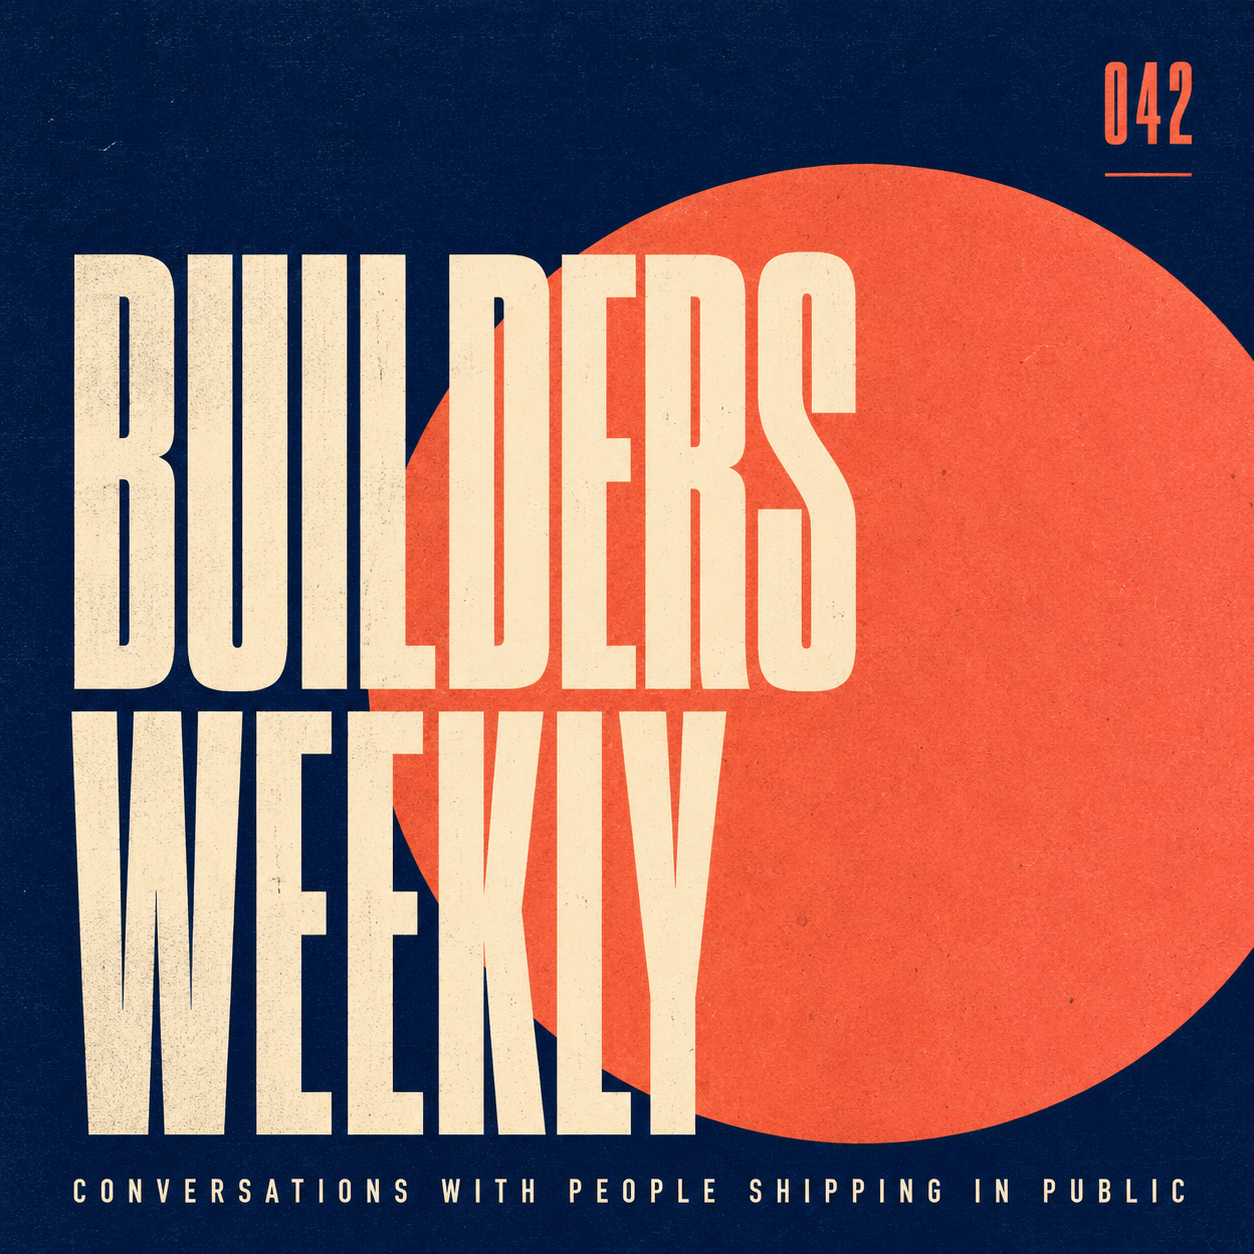
Capa quadrada de podcast: layout geométrico ousado, fundo azul-marinho profundo com um grande
círculo coral fora do centro, título em sans-serif condensada 'BUILDERS WEEKLY' em creme em três
linhas empilhadas bem próximas, slogan menor em caixa alta 'Conversations with people shipping
in public' ao longo da borda inferior, número do episódio 042 em microtipografia no canto
superior direito, leve textura de papel, proporção 1:1, projetada nas proporções de capa do
Spotify, sem rostos humanos, sem logotipos.
Por que funciona. Há três regras para prompts de tipografia que você precisa conhecer: (1) especifique a forma de caixa ("tudo em maiúsculas"); (2) especifique a posição no layout ("três linhas empilhadas bem próximas", "canto superior direito"); (3) indique o estilo de fonte ("sans-serif condensada"). Sem isso, o modelo decide por conta própria e, num contexto sem serifa, surgem serifas. O gpt-image-2 renderiza de forma confiável palavras em inglês dentro de cerca de 4 a 5 linhas por imagem.
Prompt 4 — Banner do LinkedIn com título grande (gpt-image-2, 16:9)
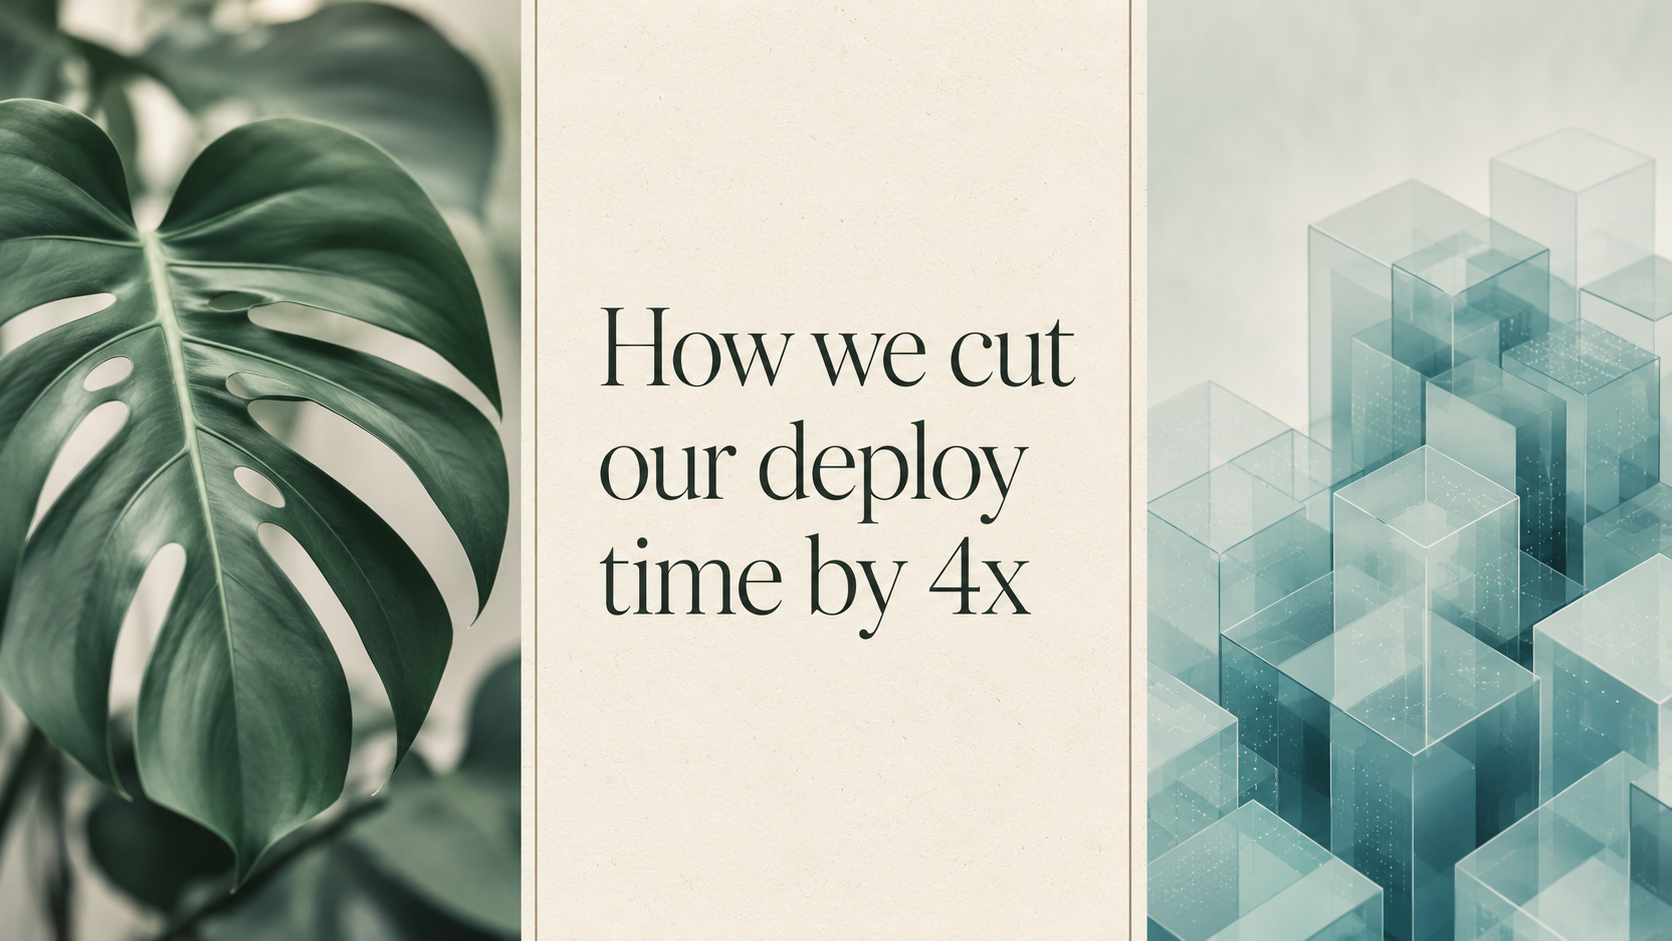
Banner largo do LinkedIn: layout de colagem editorial, três faixas verticais. Faixa esquerda uma
folha de monstera em foco suave em verde-jade, faixa central um retângulo creme limpo com o
título 'How we cut our deploy time by 4x' em uma serifa refinada em três linhas, faixa direita
uma renderização isométrica abstrata de cubos translúcidos empilhados em azul-petróleo claro.
Linhas separadoras finas em cinza quente, textura de papel sutil, proporção 16:9 dimensionada
para as proporções 1584x396 do LinkedIn.
Por que funciona. "Três faixas verticais" dá ao modelo uma grade de composição rígida; sem isso, você recebe um monte de elementos sobrepostos. "Especificar a proporção do LinkedIn em inglês direto (1584x396)" não entra em conflito com a proporção 16:9 que você passa para a API da hiapi — o modelo trata ambos como intenção de design.
3. Avatares e retratos de pessoas
Dois caminhos: avatar fotorrealista (Nano-Banana se destaca em manter a consistência entre várias poses) e avatar geométrico estilizado (qualquer modelo faz; qwen-image-2.0 é o mais barato). Ambos exigem descrever claramente idade, tom de pele, penteado e expressão — ser vago só produz médias genéticas esquisitas.
Prompt 5 — Avatar profissional fotorrealista (Nano-Banana, 1:1)
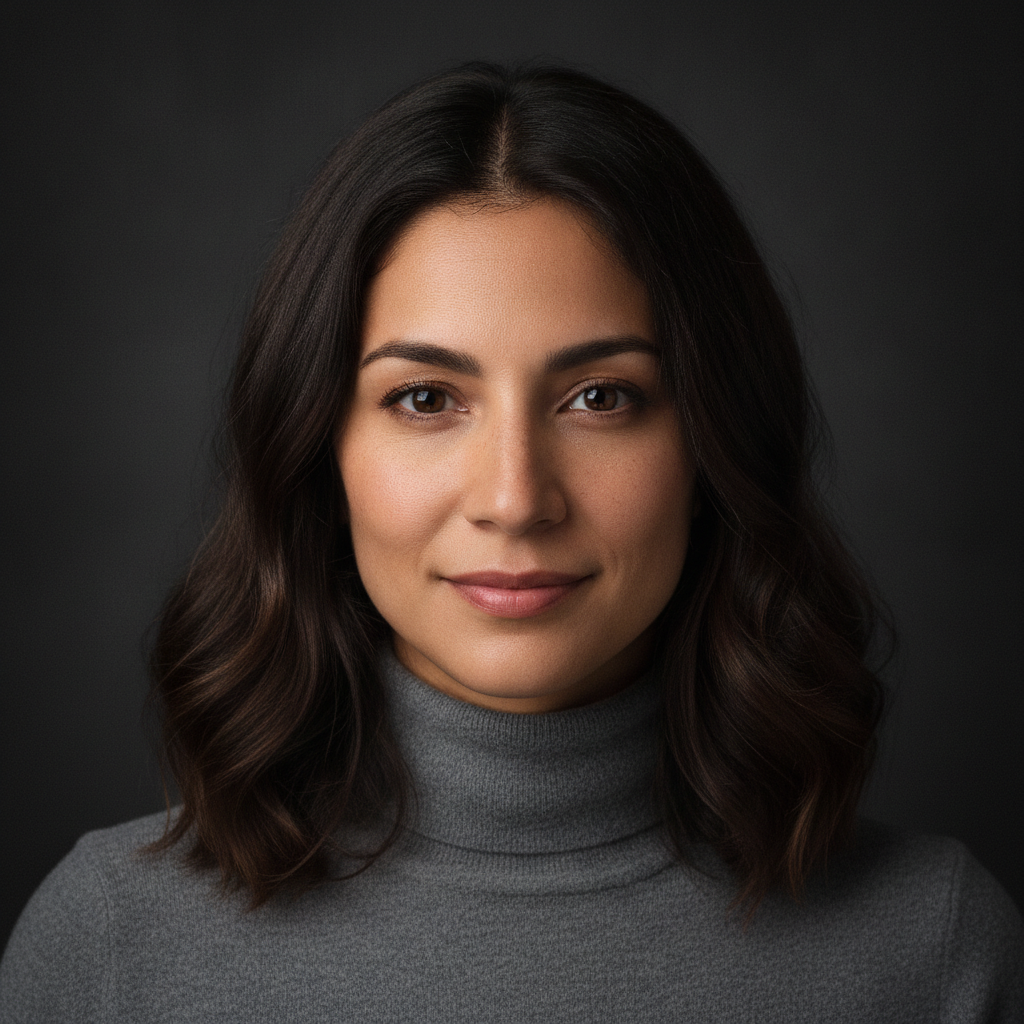
Avatar de retrato profissional: uma mulher de 32 anos com cabelo castanho-escuro na altura dos
ombros, pele oliva quente, sardas leves, vestindo uma gola alta macia cinza-carvão, expressão
neutra com um sorriso suave de boca fechada, olhando diretamente para a câmera na altura dos
olhos. Iluminada com um único softbox grande pela esquerda da câmera, fundo cinza contínuo
escuro caindo para quase preto, lente de retrato 50mm, foco nítido nos olhos, textura de pele
sutil preservada, corte quadrado 1:1 ajustado aos ombros.
Por que funciona. "Textura de pele sutil preservada" é a frase mais importante de todos os prompts de retrato — sem ela, você obtém aquela aparência lisa e plástica que denuncia na hora um avatar de IA. Quando depois precisar de mais poses da mesma pessoa, o Nano-Banana também é a escolha certa; sua reputação em consistência de personagem não é marketing.
Prompt 6 — Avatar geométrico plano (Nano-Banana, 1:1)
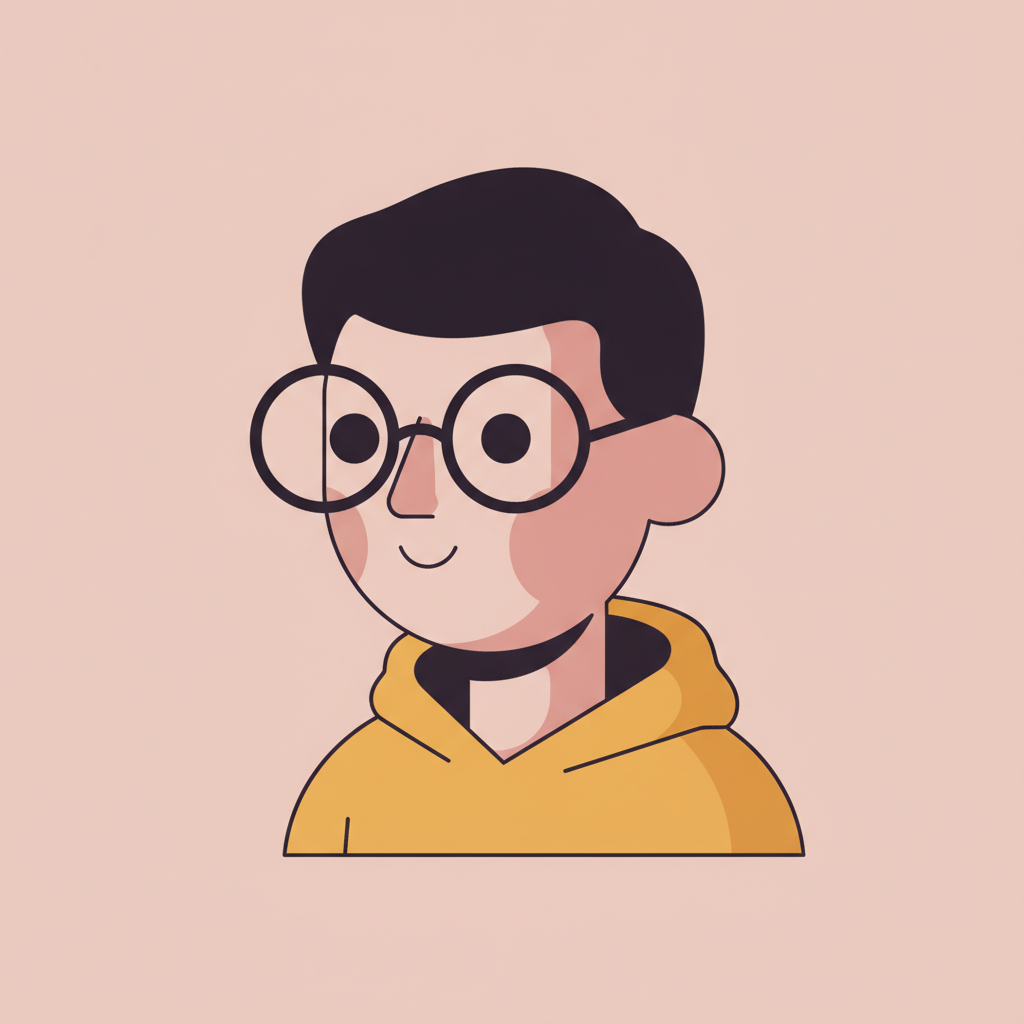
Ilustração de avatar estilizada em estilo geométrico plano: um jovem de cabelo preto curto,
óculos redondos, vestindo um moletom com capuz amarelo-mostarda, vista de três quartos,
feições faciais simplificadas construídas com círculos suaves e retângulos arredondados,
sombreamento em dois tons de ameixa profundo sobre fundo rosa empoeirado claro, contorno preto
fino apenas na silhueta, sem gradientes, sem rugas faciais, corte quadrado 1:1, projetado para
ser lido com clareza em 80x80 pixels.
Por que funciona. "Projetado para ser lido com clareza em 80x80 pixels" força o modelo a usar formas grandes em vez de detalhes finos. A lista de proibições ("sem gradientes, sem rugas faciais") funciona como uma nota de direção de arte — empurra o resultado para o lado geométrico, longe do estilo de retrato pictórico padrão do modelo.
4. Exibição e apresentação de produtos
No meio de uma página de produto ou numa comparação de funcionalidades, muitas vezes você precisa de algo mais limpo do que a imagem principal: uma vista superior de flat-lay limpa, um diagrama isométrico explodido, um mockup de embalagem. O flux-1.1-pro é ótimo em fotografia de flat-lay; o qwen-image-2.0 é excelente para produzir ilustrações limpas em estilo 3D a baixo custo.
Prompt 7 — Vista superior em flat-lay (flux-1.1-pro, 4:3)
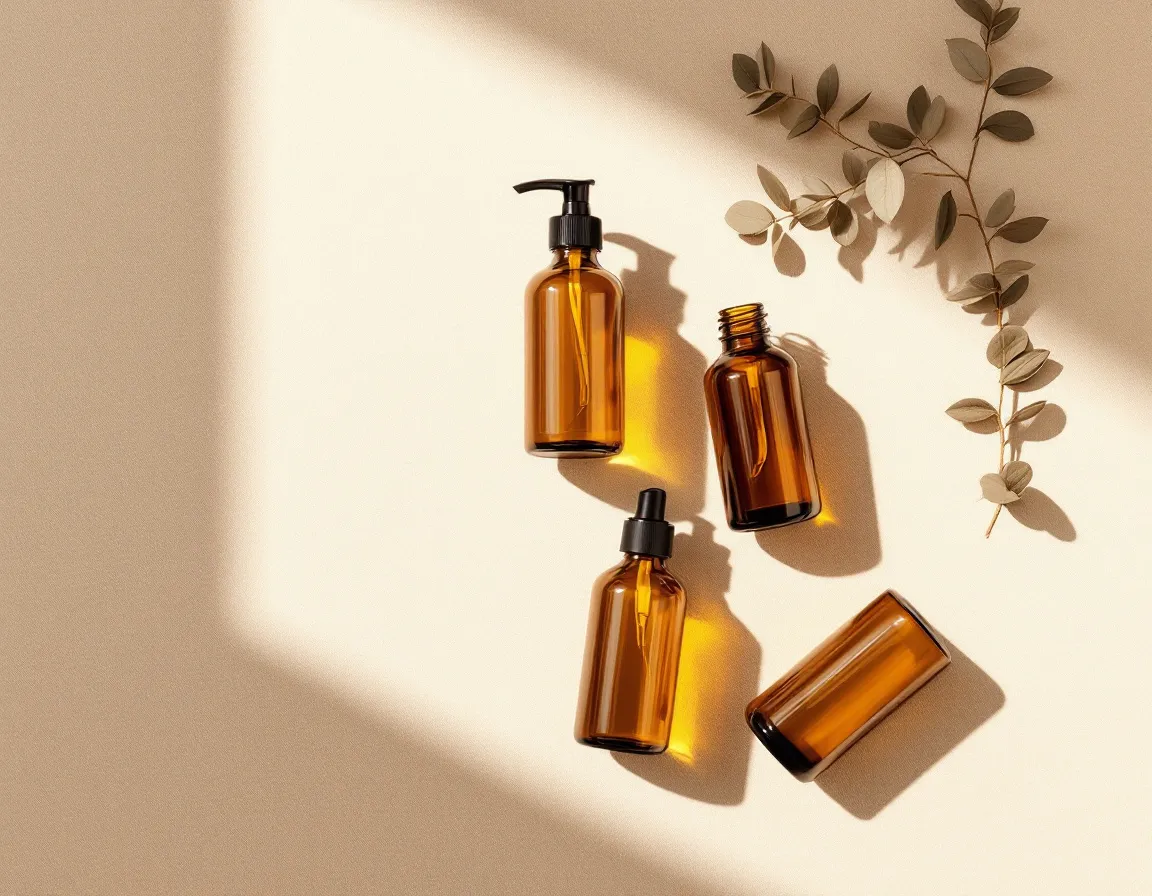
Fotografia flat-lay vista de cima de quatro frascos cosméticos de vidro âmbar dispostos em uma
grade quadrada sobre uma superfície de linho cor de areia, espaçamento generoso e uniforme,
luz do dia suave e difusa vinda de cima criando sombras suaves diretamente sob cada frasco,
um único ramo de eucalipto seco no canto superior direito para equilíbrio, sem rótulos, sem
tampas, foco nítido em todo o quadro, proporção 4:3, color graded quente e minimalista.
Por que funciona. As palavras-chave que fazem efeito são "luz do dia suave e difusa vinda de cima" (define a iluminação), "grade quadrada" (define o layout), "foco nítido em todo o quadro" (evita que o modelo adicione profundidade de campo rasa por conta própria) e "sem rótulos" (evita marcas fictícias). O ramo de eucalipto é uma assimetria deliberada — sem ele, os quatro frascos na grade parecem rígidos demais.
Prompt 8 — Renderização limpa de produto em isométrico (qwen-image-2.0, 4:3)
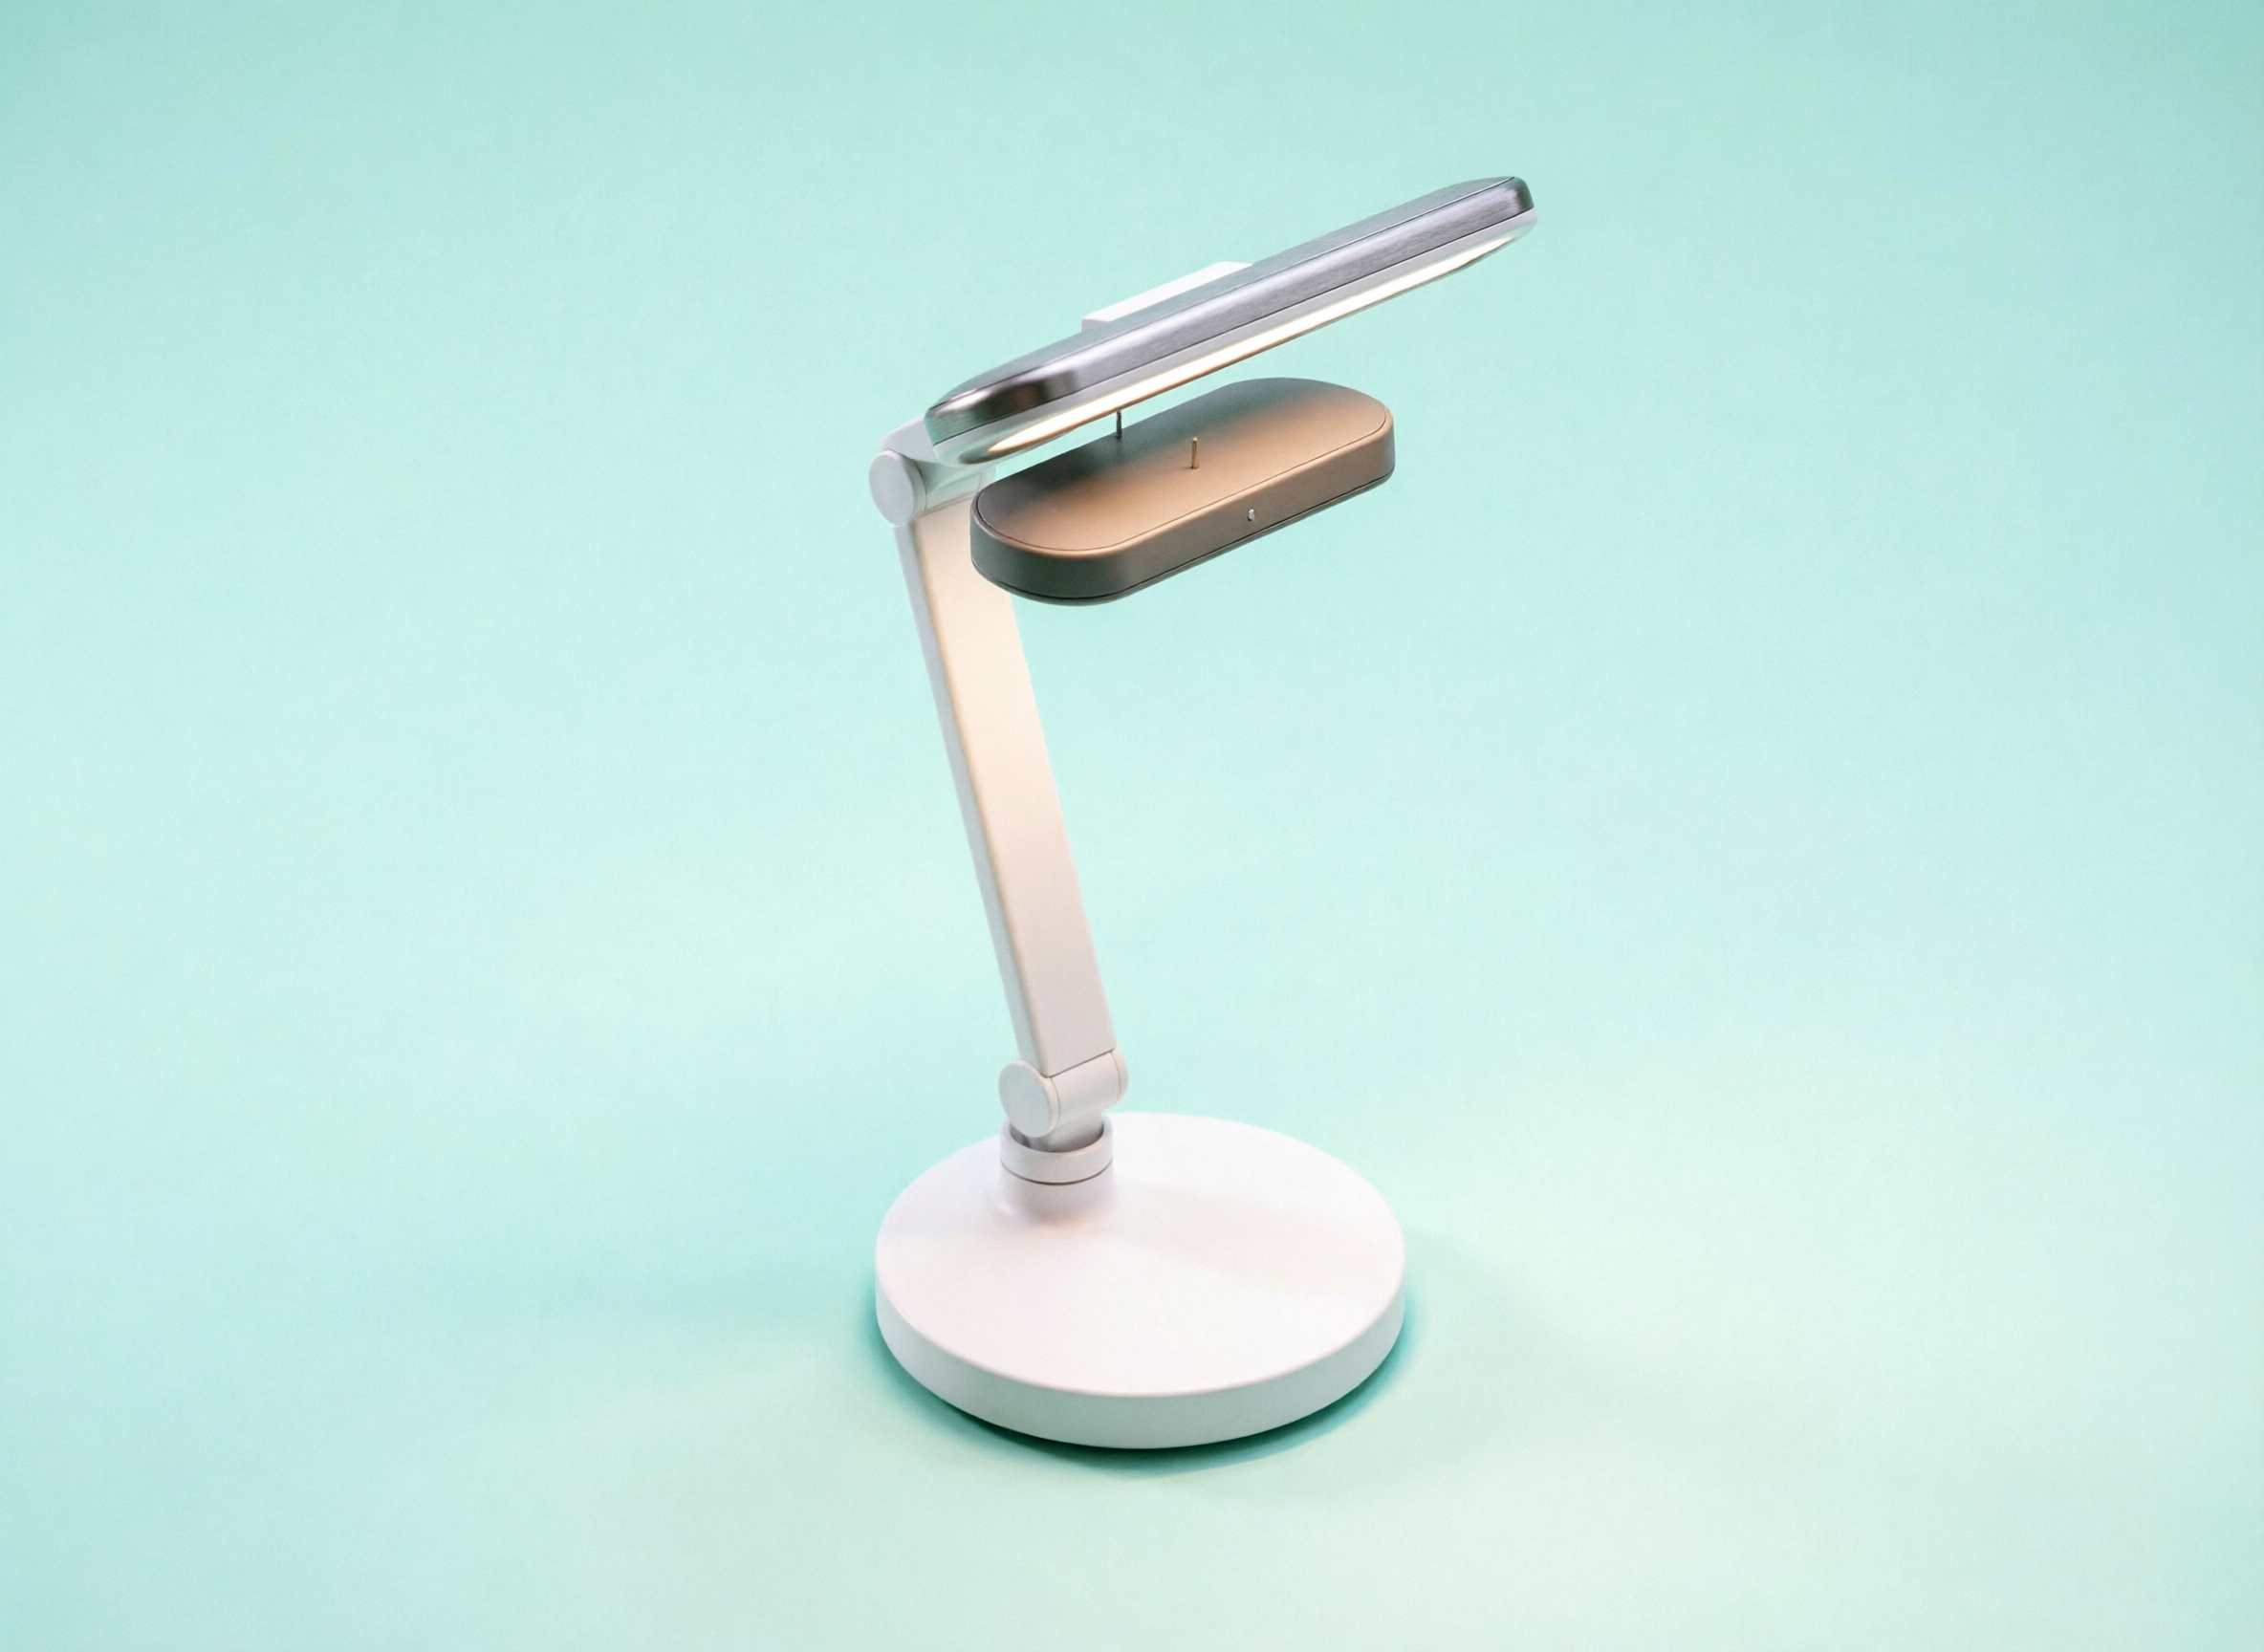
Ilustração 3D isométrica limpa de um único abajur de mesa inteligente, vista explodida
mostrando quatro camadas empilhadas — disco da base, braço articulado, carcaça da cabeça,
painel de LED — separadas por linhas conectoras finas, sobre fundo verde-menta claro com uma
única sombra projetada muito suave, materiais com acabamento fosco em branco e cinza quente,
sem texto, sem anotações, proporção 4:3, projetada para ficar limpa em uma página de
especificações de produto.
Por que funciona (e onde não funciona). O qwen-image-2.0 a US$ 0,025 é o modelo mais econômico da hiapi, e ele capta com confiança paletas foscas e composições limpas. Mas ele normalmente se recusa a renderizar uma verdadeira vista explodida a partir de um prompt puramente textual — aqui o resultado é um abajur montado e limpo, não quatro camadas separadas, mesmo com as peças listadas uma a uma. O processo honesto para criar diagramas explodidos é: desenhe você mesmo um esboço aproximado das camadas e depois limpe-o com gpt-image-2/image-to-image. Trate esta seção como a lição que ela de fato oferece: deixe estilo, iluminação e paleta para o modelo; quando a estrutura é o ponto central da imagem, desenhe a estrutura você mesmo.
5. Ilustração editorial estilizada
Quando o artigo em si é o produto — ensaios longos, newsletters, palestras em conferências — a abertura correta é uma ilustração, não uma foto. Duas estilizações confiáveis: ilustração editorial modernista de meados do século (formas planas, paleta contida) e papel recortado em camadas. Ambas parecem claramente feitas à mão e evitam a fadiga visual das fotos de banco de imagens.
Prompt 9 — Ilustração editorial modernista de meados do século (gpt-image-2, 3:2)
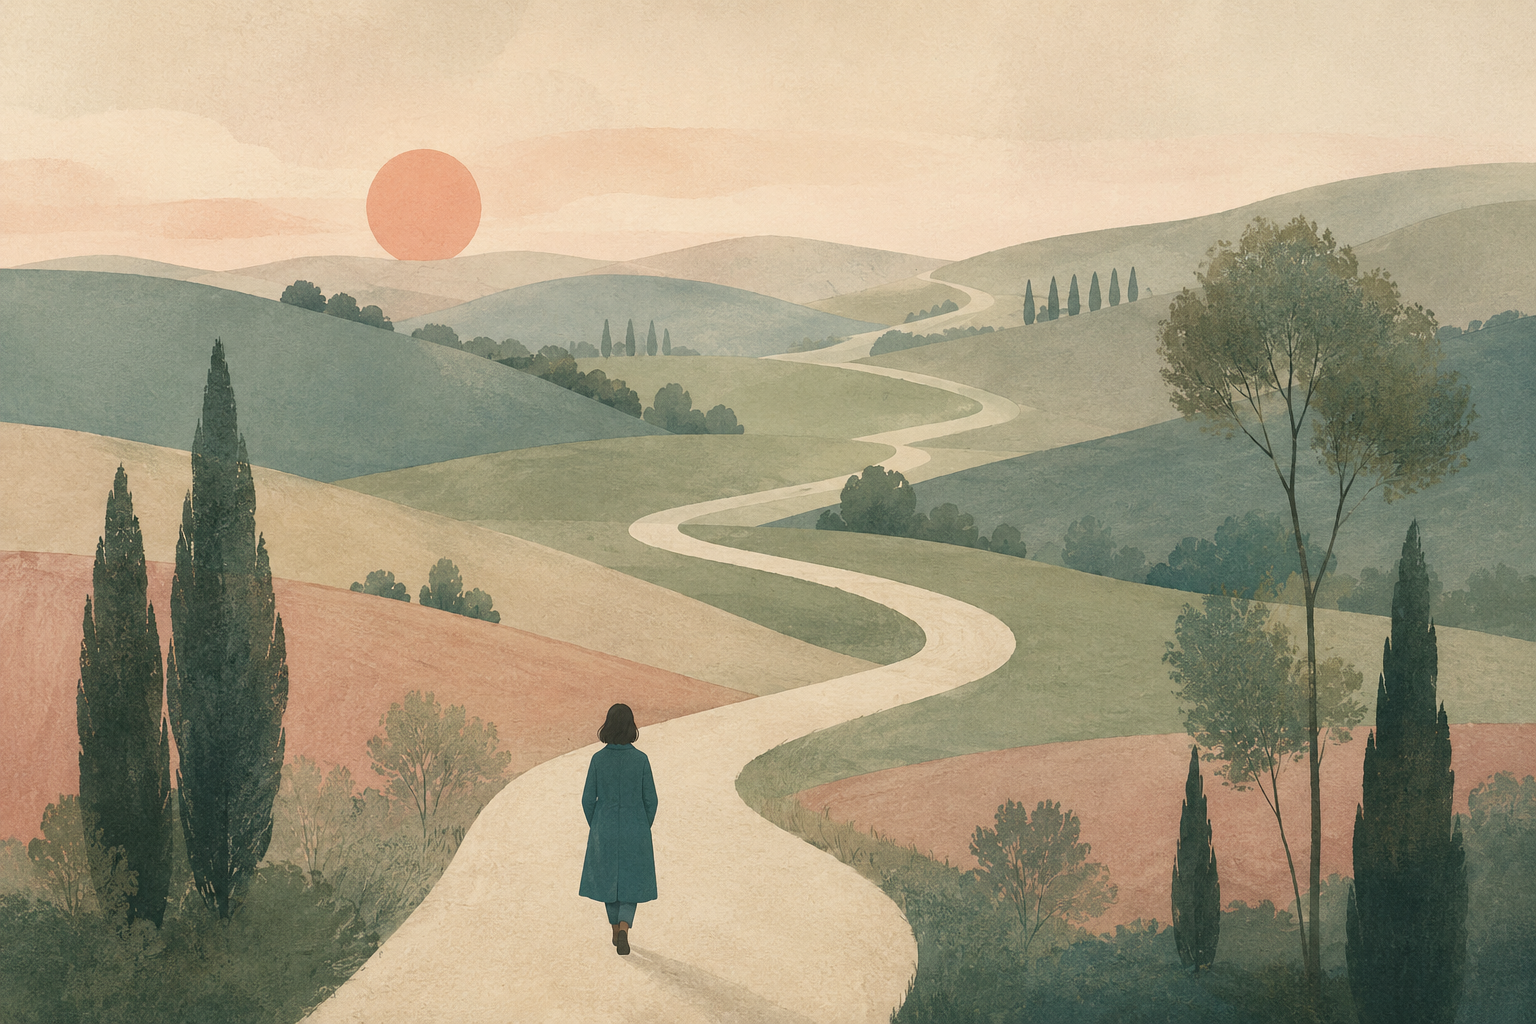
Ilustração editorial para um ensaio longo intitulado internamente 'The slow web'. Composição:
uma pequena figura de casaco azul-petróleo vista de costas, caminhando em um caminho creme
sinuoso que serpenteia por uma paisagem pastel suave de colinas onduladas e suaves, árvores
esguias espalhadas, um sol baixo em aquarela. Estilo referenciando ilustração editorial de
meados do século, formas planas, leve textura de papel, paleta contida de azul-petróleo,
sálvia, creme e rosa empoeirado, sem contornos, sem texto, proporção paisagem 3:2.
Por que funciona. Indicar a referência de estilo ("ilustração editorial modernista de meados do século") é mais confiável do que indicar o nome de um artista — guia o modelo para uma tradição visual reconhecível sem copiar nenhum indivíduo específico. "Paleta contida" com quatro cores listadas é uma restrição mais forte do que "cores suaves"; o modelo mistura exatamente essas quatro cores e ignora todo o resto do espectro.
Prompt 10 — Ilustração em papel recortado em camadas (qwen-image-2.0, 1:1)
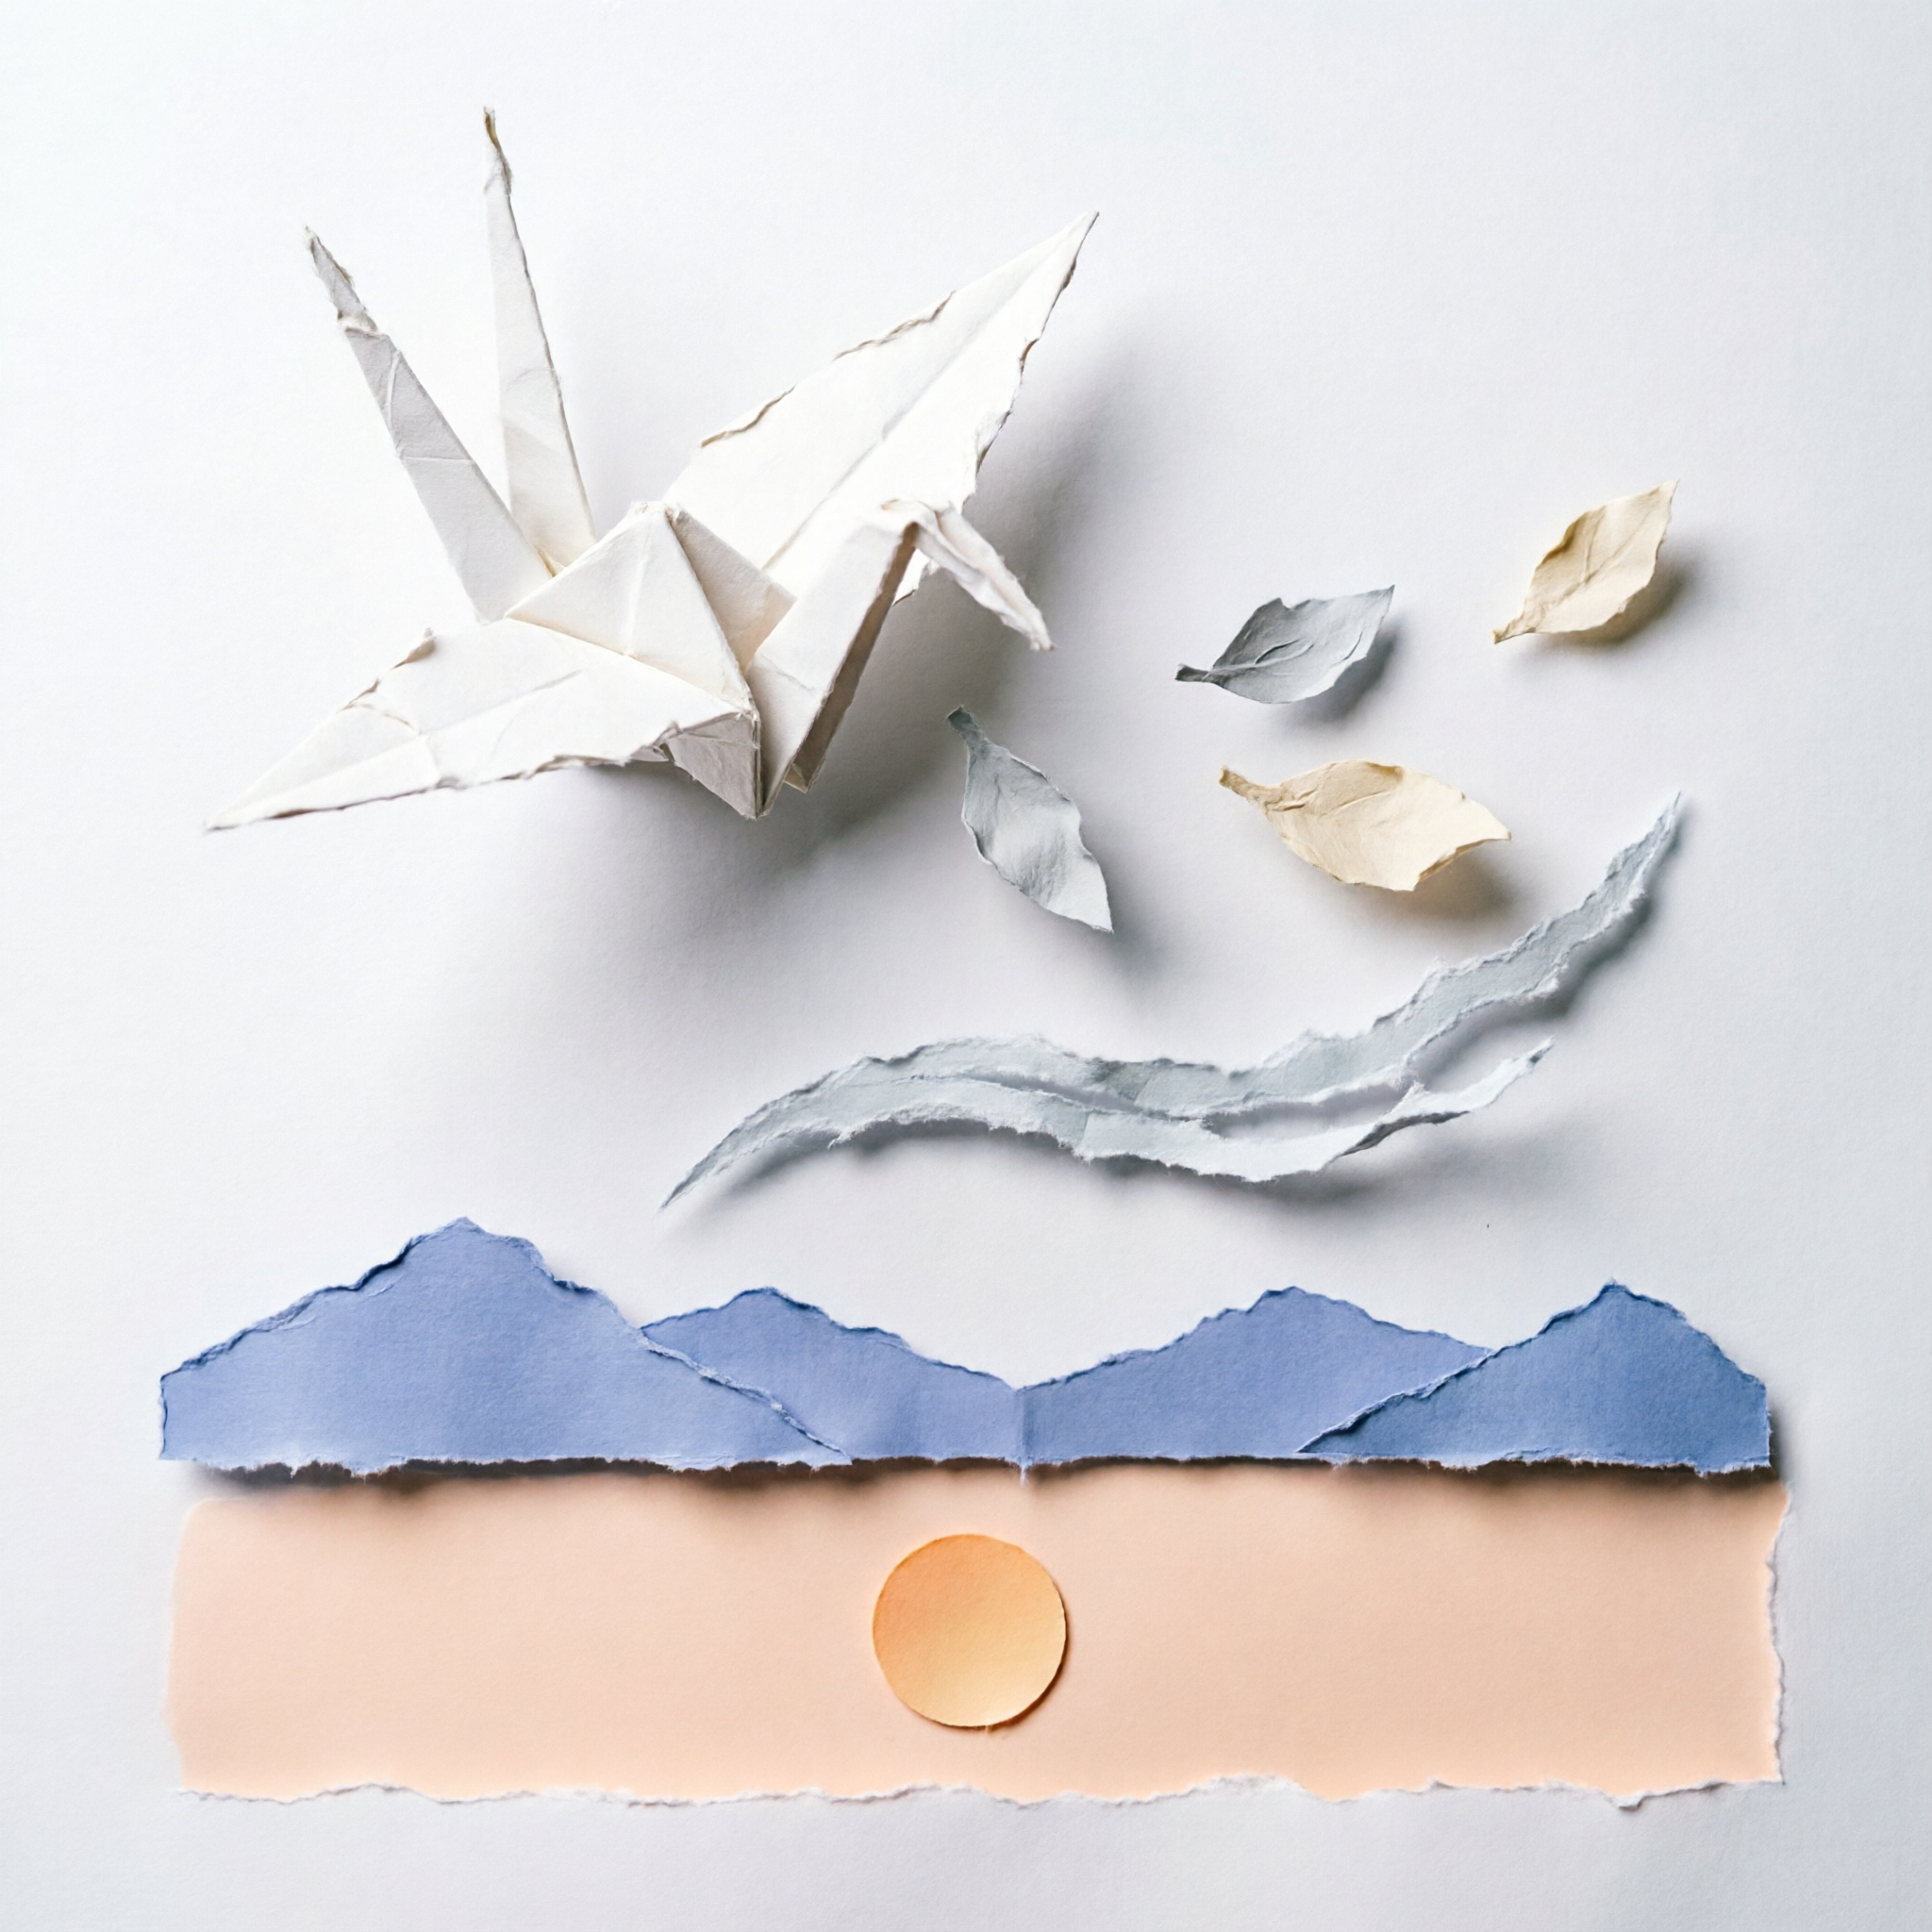
Ilustração em papel recortado em camadas de um único tsuru de origami em voo, cinco planos de
profundidade de papel distintos do primeiro plano ao fundo — o tsuru, folhas de papel à deriva,
um arco rasgado representando o vento, montanhas distantes em índigo claro, e um céu plano com
um único sol circular em pêssego claro. Cada camada tem uma sombra projetada suave sobre a
camada atrás dela, bordas de corte levemente rústicas, textura de papel fosco, proporção 1:1,
composição equilibrada com o tsuru no terço superior esquerdo.
Por que funciona. Especificar exatamente cinco camadas traz profundidade ao efeito de papel recortado, que é justamente o que o distingue da ilustração plana. "Bordas de corte levemente rústicas" e "textura de papel fosco" são duas frases que impedem o modelo de renderizar o resultado como um vetor digital liso — o que aniquilaria todo o sentido desse estilo.
Como reescrever estes prompts
Três regras atravessam todas as seções acima. Especifique a proporção de tela duas vezes — uma na chamada da API (o campo aspect_ratio da hiapi), outra no texto do prompt ("proporção 4:3"). O modelo trata ambas como intenção de design, e o resultado se encaixa no contêiner da página. Escreva explicitamente o que excluir ("sem logotipos", "sem texto", "sem gradientes") com frequência pelo menos igual à do que incluir; listas negativas moldam o resultado tanto quanto listas positivas. Ancore o estilo em referências tradicionais ou técnicas, não em nomes de artistas — "ilustração editorial modernista de meados do século", "granulação de filme 35mm", "ilustração 3D isométrica" — para obter resultados reproduzíveis e com direitos autorais limpos.
Escolha o modelo pela tarefa: qwen-image-2.0 para trabalho estilizado de alto volume, gpt-image-2 para renderização de texto intensa, Nano-Banana para consistência de retratos e flux-1.1-pro para fotorrealismo. Cada prompt acima foi executado na task API da hiapi em 60-120 segundos, com custo de US$ 0,025 a US$ 0,05 por imagem — barato o suficiente para que a abordagem correta seja gerar três variantes de cada prompt, escolher a mais forte e publicar.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores