
Guide d'utilisation
Maîtriser les coûts de l'API IA pour images et vidéos : paliers, traitement par lots et choix des modèles
Sur une même tâche, le modèle le moins cher et le plus cher affichent un écart de 34 à 50 fois. Maîtriser les coûts, c'est surtout savoir quand chaque palier en vaut la peine.
Personne n'épuise son budget média IA en un seul appel d'API spectaculaire. Les dépenses fuient discrètement par trois habitudes : payer le prix fort pour un brouillon jetable, ignorer l'unité réelle de facturation, et itérer en série sur des modèles coûteux parce que le workflow n'a jamais été conçu pour générer d'abord largement des variantes à bas coût.
Ce guide passe en revue les leviers de coût qui comptent vraiment lors de la génération d'images et de vidéos via hiapi : unités de facturation, paliers de qualité, durée des vidéos, workflow brouillon-puis-mise à niveau, et traitement par lots via l'API de tâches asynchrones. Tous les prix ci-dessous proviennent de la page tarifaire en direct de juillet 2026 — considérez-les comme un instantané et consultez les prix actuels avant tout budget.
Sachez exactement ce que vous payez à l'unité
hiapi facture les modèles média à un tarif fixe par unité de sortie — aucun calcul de tokens à reconstituer :
- Les modèles d'image sont facturés par image, quelle que soit la complexité du prompt.
- Les modèles vidéo sont facturés par seconde de sortie générée.
- Les modèles audio (par exemple
elevenlabs/text-to-dialogue-v3) sont facturés par tranche de 1 000 caractères de texte d'entrée.
Voici un panorama des prix par image sur la gamme texte-vers-image :
| Modèle | Prix par image |
|---|---|
flux-schnell/text-to-image |
$0.005 |
gpt-image-2/text-to-image@ext |
$0.007 |
z-image |
$0.008 |
gpt-image-2/text-to-image@beta |
$0.02 |
qwen-image-2.0 |
$0.025 |
gpt-image-2/text-to-image |
$0.03 |
nano-banana |
$0.05 |
flux-1.1-pro |
$0.05 |
flux-2/text-to-image |
$0.05 |
nano-banana-2 |
$0.051 |
wan2.7-image/text-to-image |
$0.08 |
nano-banana-pro |
$0.17 |
Et les prix par seconde pour la vidéo :
| Modèle | Prix par seconde |
|---|---|
grok-imagine (texte-vers-vidéo / image-vers-vidéo) |
$0.0114 |
kling-3.0-omni (texte-vers-vidéo / image-vers-vidéo) |
$0.129 |
seedance-2.0 |
$0.136 |
seedance-2.0-mini |
$0.147 |
wan2.7-video@pro (texte-vers-vidéo / image-vers-vidéo) |
$0.167 |
happyhorse-1.0 |
$0.168 |
happyhorse-1.1 (tous les endpoints) |
$0.21 |
seedance-2.0-fast |
$0.2357 |
veo-3.1-fast |
$0.25 |
veo-3.1 |
$0.57 |
Deux chiffres méritent d'être retenus : la gamme image s'étend du moins cher au plus cher sur un facteur 34 ($0.005 → $0.17), la vidéo sur un facteur 50 ($0.0114 → $0.57 par seconde). Le choix du modèle n'est pas un bouton de réglage fin — c'est la décision budgétaire la plus lourde que vous prenez.
Un avertissement : ne déduisez pas le prix du nom du modèle. Dans la famille Veo, la variante -fast est le palier le moins cher ($0.25/s contre $0.57/s), mais seedance-2.0-fast est un palier d'accélération premium dont le coût par seconde est supérieur à celui du seedance-2.0 de base ($0.2357 contre $0.136). Lisez la grille tarifaire ; ne présumez jamais.
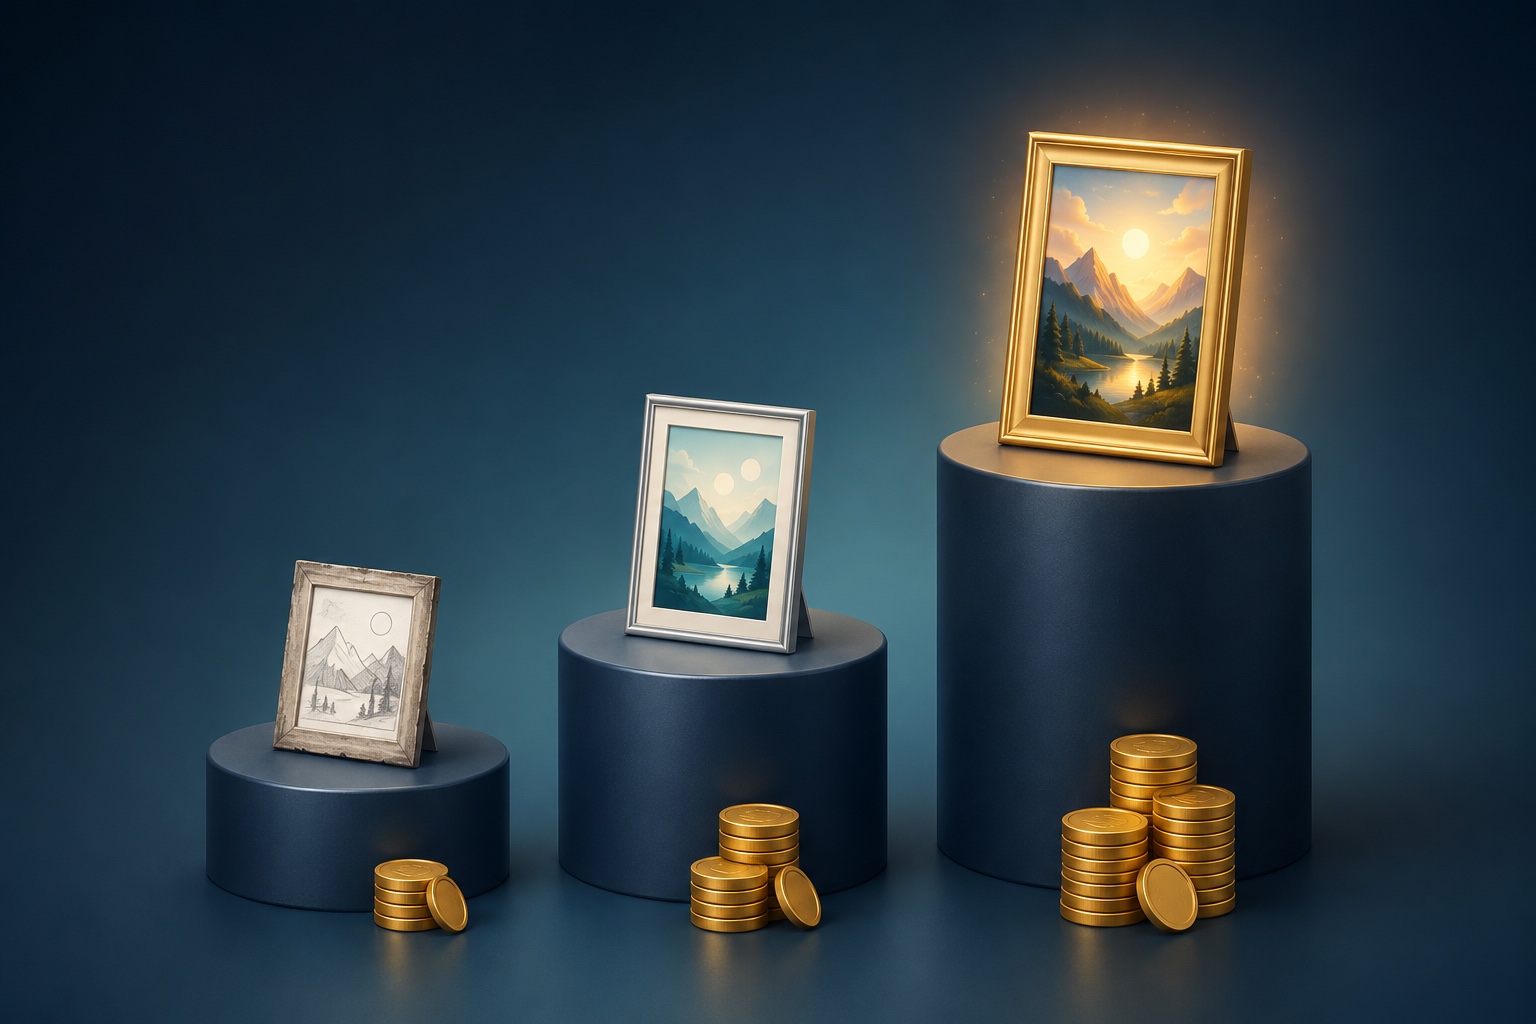
Traitez les paliers de prix comme une fonctionnalité, pas comme des petites lignes
La plupart des familles de modèles sont déclinées en paliers, et ces paliers existent précisément pour que vous n'ayez pas à payer le tarif d'un modèle phare pour chaque tâche :
- Palier brouillon ($0.005–$0.008) :
flux-schnell,z-image, et le canal@extde gpt-image-2. À utiliser pour itérer sur les prompts, tester les compositions, et tout contenu qu'un humain jettera après un coup d'œil. - Palier standard ($0.02–$0.05) :
gpt-image-2/text-to-image,qwen-image-2.0,nano-banana,flux-2. Pour la qualité de production : couvertures de blog, photos produit, assets d'UI. - Palier premium ($0.08–$0.17) :
wan2.7-imageetnano-banana-pro. À réserver aux visuels finaux où le détail et le respect des instructions sont critiques.
La même logique s'applique aux variantes de canal : la page tarifaire liste les versions @beta et @ext de gpt-image-2/text-to-image à $0.02 et $0.007 respectivement, contre $0.03 pour le canal standard. Si votre charge de travail tolère les conditions des canaux en aperçu, vous économisez 20 %–77 % sur des prompts identiques. Nous approfondissons l'interaction entre le coût par image, la résolution et le taux de nouvelle tentative dans l'API de génération d'images la moins chère : comment comparer le coût réel par image.
Pour la vidéo, la durée est un multiplicateur
Le coût vidéo, c'est tarif × secondes, ce qui signifie que chaque valeur par défaut que vous n'avez pas remise en question est amplifiée. Un même clip de 8 secondes coûte :
| Modèle | Clip de 8 secondes |
|---|---|
grok-imagine/text-to-video |
$0.09 |
kling-3.0-omni/text-to-video |
$1.03 |
veo-3.1-fast/text-to-video |
$2.00 |
veo-3.1/text-to-video |
$4.56 |
Deux habitudes découlent directement de là :
- Demandez la durée la plus courte qui convient à la prise de vue. Réduire un clip veo-3.1 de 8 à 5 secondes économise $1.71 — par clip, chaque fois.
- Itérez sur les modèles bon marché, rendez sur les modèles chers. Six itérations de brouillons de 4 secondes sur
grok-imaginecoûtent environ $0.27 au total — moins que le coût d'une demi-seconde de sortie surveo-3.1. Épuisez-y vos expérimentations de prompts, puis dépensez une seule fois $4.56.
Brouillons bon marché, rendu final premium
Le changement de workflow le plus impactant consiste à séparer l'exploration de la livraison. Exemple concret pour une photo produit :
- 20 itérations de brouillons sur
z-imageà $0.008 chacune = $0.16 - 3 rendus finaux sur
nano-banana-proà $0.17 chacun = $0.51 - Total : $0.67
Faire tourner les 23 générations sur nano-banana-pro coûterait $3.91. Même nombre d'appels d'API, mêmes assets finaux, avec environ 83 % de dépenses en moins — et la boucle de brouillons va aussi plus vite, car les modèles du palier brouillon répondent en quelques secondes.
Seule précaution : les prompts ne se transposent pas parfaitement d'une famille à l'autre. Lors des une ou deux dernières itérations, gardez la boucle de brouillons sur le modèle qui servira au rendu final, afin de repérer les particularités propres à la famille avant d'engager le budget premium.
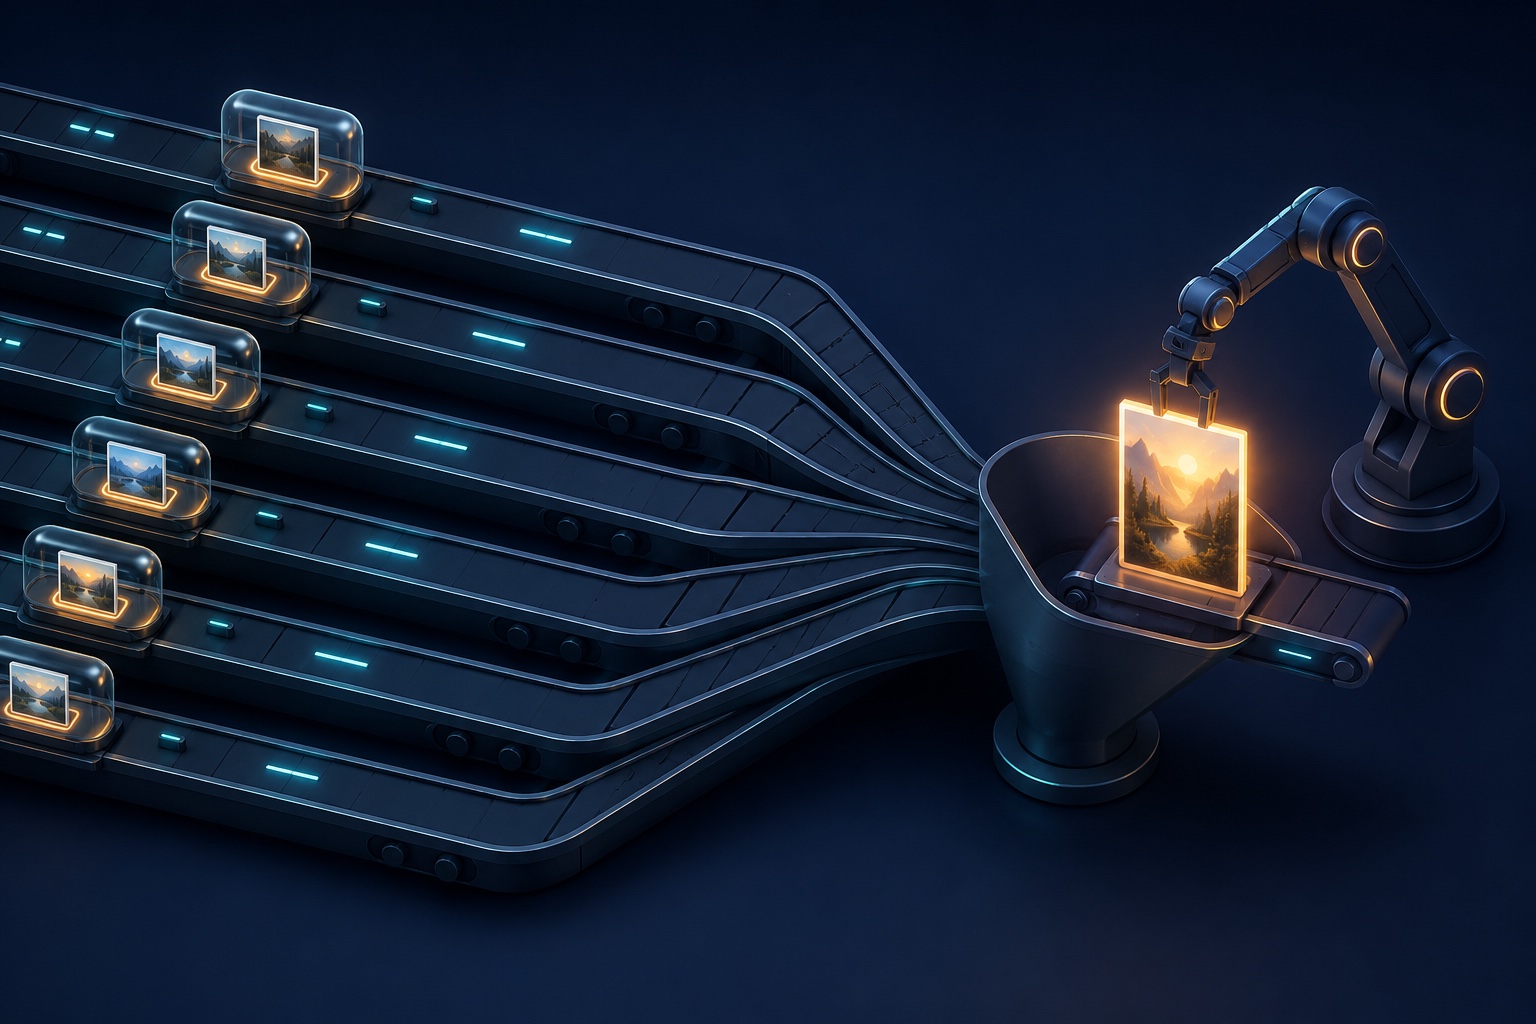
Traitement par lots via l'API de tâches asynchrones
Chaque modèle média de hiapi passe par un endpoint de tâches asynchrones : POST /v1/tasks renvoie immédiatement un identifiant de tâche, puis vous interrogez le résultat. Le traitement par lots n'offre pas de remise par requête — le gain est architectural. Comme la soumission est découplée de l'achèvement, vous pouvez distribuer tout un lot de brouillons d'un coup au lieu d'attendre chaque génération en série, ce qui rend précisément praticable la boucle brouillon-puis-mise à niveau :
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def create_task(model: str, prompt: str) -> str:
    r = requests.post(API, headers=HEADERS, json={
        "model": model,
        "input": {"prompt": prompt, "aspect_ratio": "1:1"},
    })
    r.raise_for_status()
    return r.json()["data"]["taskId"]

def wait_task(task_id: str, timeout: int = 600) -> str:
    deadline = time.time() + timeout
    while time.time() < deadline:
        task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]  # URL expirante — téléchargez-la maintenant
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(5)
    raise TimeoutError(task_id)

# Diffusez 12 variantes de brouillon sur un modèle à $0.008 : ~$0.10 pour tout le lot
variations = [f"studio product shot of a ceramic mug, camera angle {i}" for i in range(12)]
task_ids = [create_task("z-image", p) for p in variations]
urls = [wait_task(t) for t in task_ids]
Soumettez les douze d'abord, puis interrogez — les tâches se génèrent en parallèle côté plateforme, et votre code n'attend qu'une seule fois. Les champs d'entrée autres que prompt varient selon le modèle (certains acceptent resolution, d'autres uniquement aspect_ratio), donc consultez la table des paramètres du modèle avant de traiter par lots ; le tutoriel gpt-image-2 montre ce schéma de bout en bout.
Lorsque vous augmentez le volume de distribution, respectez les limites de concurrence de la plateforme — une rafale qui déclenche des 429 ne fait qu'ajouter de la latence de nouvelle tentative. Les limites de débit de l'API de génération d'images expliquées décrit le comportement des limites et comment reculer proprement.
Dix lignes de garde budgétaire transforment « nous surveillerons les dépenses » en véritable invariant :
PRICES = {"z-image": 0.008, "gpt-image-2/text-to-image": 0.03, "nano-banana-pro": 0.17}
BUDGET_USD = 5.00
spent = 0.0

def spend(model: str, images: int = 1) -> None:
    global spent
    cost = PRICES[model] * images
    if spent + cost > BUDGET_USD:
        raise RuntimeError(f"budget cap: ${spent + cost:.2f} would exceed ${BUDGET_USD:.2f}")
    spent += cost
Appelez-la avant chaque create_task ; une boucle incontrôlée échouera bruyamment à $5 plutôt que sur la facture du mois suivant.
Ne payez pas deux fois pour la même sortie
La fuite de coût la plus insidieuse, c'est la régénération — payer plein tarif pour une sortie que vous possédez déjà :
- Téléchargez les résultats immédiatement. Les URL de sortie des tâches ont une durée limitée. Si vous stockez des liens chauds plutôt que des fichiers, et que le lien expire, la seule solution est de payer une régénération. Détails et schémas de téléchargement ici.
- Distinguez « tâche échouée » de « mon interrogation a abandonné ». Une tâche qui réussit après le timeout de votre client, c'est de l'argent dépensé pour une sortie que personne ne récupère. Réglez le timeout d'interrogation bien au-delà du temps d'achèvement réel du modèle — voici comment diagnostiquer une tâche bloquée avant de la considérer comme échouée.
- Réutilisez votre propre bibliothèque. Avant la cinquième génération de « photo studio propre sur fond blanc », vérifiez les assets que vous avez déjà payés. Un bucket partagé avec des prompts consultables est le modèle le moins cher de votre stack.
Liste de contrôle pour maîtriser les coûts
- Budgétez dans l'unité native de chaque modèle : par image, par seconde, par 1 000 caractères.
- Choisissez un modèle de palier brouillon et un de palier livraison par type de média ; routez selon la phase de travail.
- Pour la vidéo, remettez en question chaque valeur par défaut de durée — les secondes sont un multiplicateur.
- Distribuez les brouillons via
/v1/tasks; ne promouvez que les gagnants en rendu premium. - Imposez un plafond de dépenses strict dans le code, pas dans un tableau de bord que vous consultez chaque semaine.
- Téléchargez chaque sortie immédiatement ; ne stockez jamais d'URL qui expirent.
Les prix des modèles évoluent à mesure que de nouvelles versions sortent, donc partez de la page tarifaire en direct, choisissez vos paliers brouillon et livraison dans le catalogue de modèles, et branchez le schéma de distribution ci-dessus dans votre pipeline — les premiers lots de tâches que vous exécuterez vous diront exactement le coût réel de chaque asset disponible.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax