
使用指南
控制 AI 图像和视频 API 成本:档位、批处理与模型选择
同一任务上最便宜和最贵的模型相差 34-50 倍。成本控制主要是知道每一档何时物有所值。
没有人会在一次戏剧性的 API 调用中耗尽 AI 媒体预算。支出是通过三种习惯悄悄泄漏的:为一次性草稿支付高价、不清楚实际按什么单位计费,以及在昂贵模型上串行迭代,因为工作流从未设置成先廉价地广泛生成变体。
本指南梳理通过 hiapi 生成图像和视频时真正重要的成本杠杆:计价单位、质量档位、视频时长、先草稿后升级的工作流,以及通过异步任务 API 进行批处理。以下所有价格均来自 2026 年 7 月的实时定价页面——请将其视为快照,在做任何预算之前查看当前价格。
明确你究竟按什么单位付费
hiapi 对媒体模型按固定的每输出单位计费——没有任何 token 计算需要反向推导:
- 图像模型按每张图像收费,无论提示词多复杂。
- 视频模型按生成输出的每秒收费。
- 音频模型(例如
elevenlabs/text-to-dialogue-v3)按输入文本每 1,000 个字符收费。
以下是文本到图像产品线的每图像价格全景:
| 模型 | 每张图像价格 |
|---|---|
flux-schnell/text-to-image |
$0.005 |
gpt-image-2/text-to-image@ext |
$0.007 |
z-image |
$0.008 |
gpt-image-2/text-to-image@beta |
$0.02 |
qwen-image-2.0 |
$0.025 |
gpt-image-2/text-to-image |
$0.03 |
nano-banana |
$0.05 |
flux-1.1-pro |
$0.05 |
flux-2/text-to-image |
$0.05 |
nano-banana-2 |
$0.051 |
wan2.7-image/text-to-image |
$0.08 |
nano-banana-pro |
$0.17 |
以及视频的每秒价格:
| 模型 | 每秒价格 |
|---|---|
grok-imagine(文本到视频 / 图像到视频) |
$0.0114 |
kling-3.0-omni(文本到视频 / 图像到视频) |
$0.129 |
seedance-2.0 |
$0.136 |
seedance-2.0-mini |
$0.147 |
wan2.7-video@pro(文本到视频 / 图像到视频) |
$0.167 |
happyhorse-1.0 |
$0.168 |
happyhorse-1.1(所有端点) |
$0.21 |
seedance-2.0-fast |
$0.2357 |
veo-3.1-fast |
$0.25 |
veo-3.1 |
$0.57 |
有两个数字值得牢记:图像产品线从最便宜到最贵跨越34 倍($0.005 → $0.17),视频跨越50 倍(每秒 $0.0114 → $0.57)。模型选择不是调优旋钮——它是你做出的最大单项预算决策。
一个警告:不要从模型名称推断价格。在 Veo 家族中,-fast 变体是更便宜的档位($0.25/s 对 $0.57/s),但 seedance-2.0-fast 是高级加速档,每秒成本高于基础版 seedance-2.0($0.2357 对 $0.136)。阅读价格表;永远不要假设。
把价格档位当作功能,而非细则
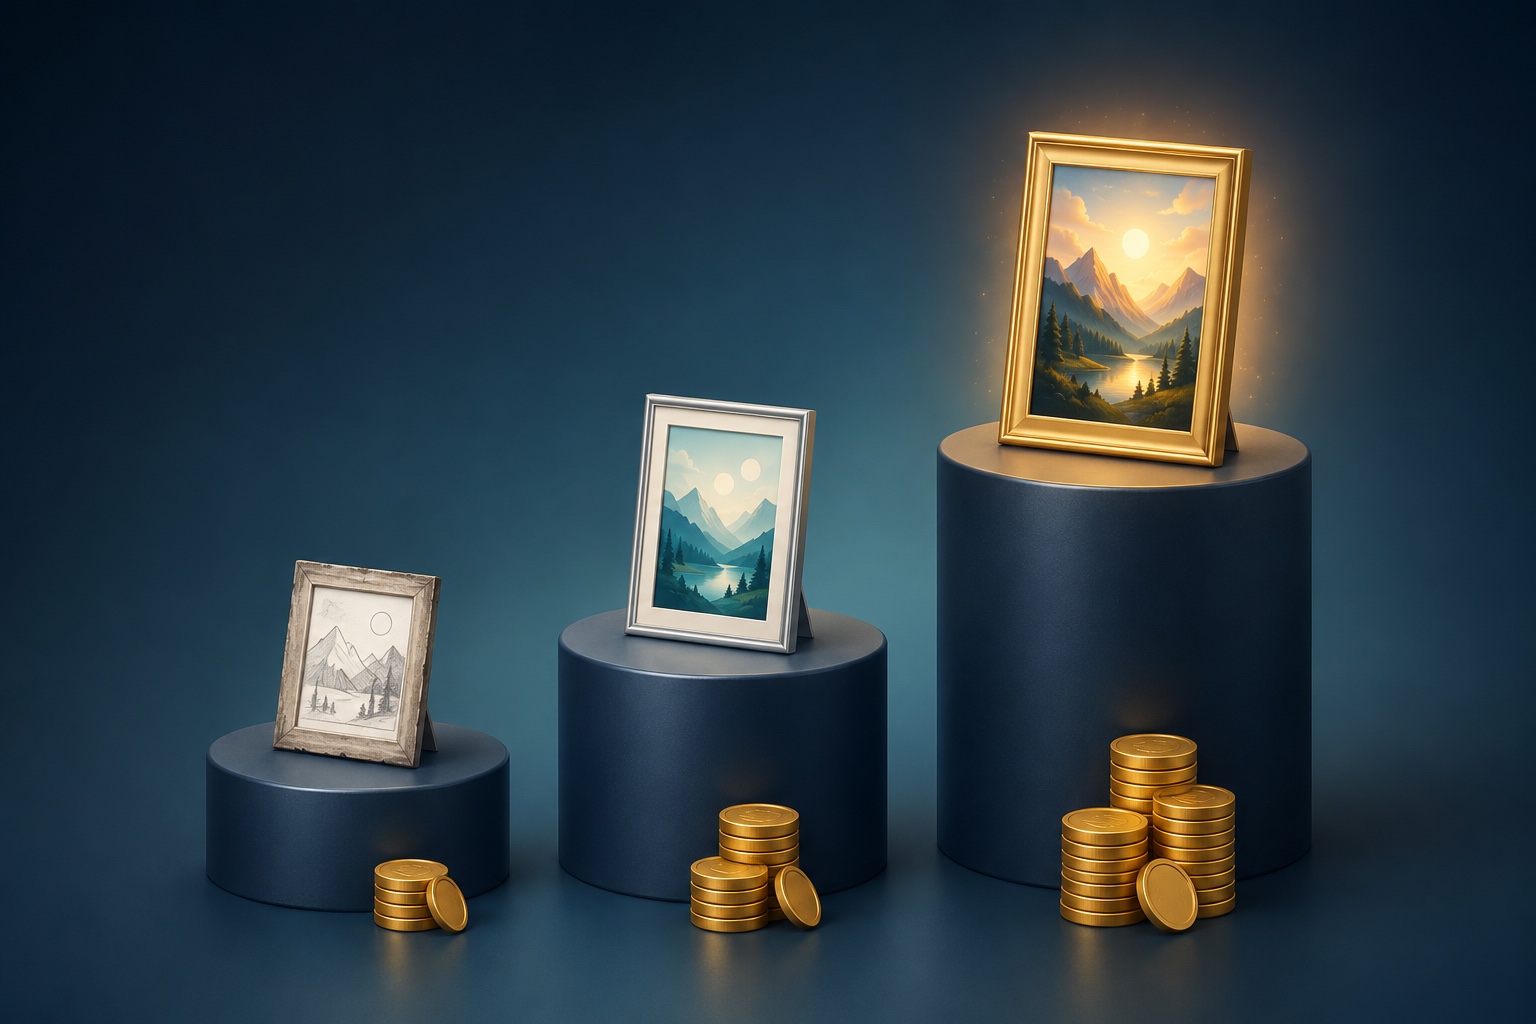
大多数模型家族都分档发布,而档位的存在正是为了让你不必为每项工作都支付旗舰级价格:
- 草稿档($0.005–$0.008):
flux-schnell、z-image,以及 gpt-image-2 的@ext通道。用于提示词迭代、构图测试,以及任何人类只会看一眼就丢弃的内容。 - 标准档($0.02–$0.05):
gpt-image-2/text-to-image、qwen-image-2.0、nano-banana、flux-2。用于博客封面、产品图和 UI 资产的生产质量。 - 高级档($0.08–$0.17):
wan2.7-image和nano-banana-pro。保留给细节和指令遵循至关重要的最终主视觉资产。
同样的逻辑适用于通道变体:定价页面列出 gpt-image-2/text-to-image 的 @beta 和 @ext 版本分别为 $0.02 和 $0.007,而标准通道为 $0.03。如果你的工作负载能容忍预览通道的条款,那么在相同提示词上可节省 20%–77%。我们在最便宜的图像生成 API:如何比较每张图像的真实成本中更深入地探讨了每图像成本与分辨率和重试率之间的相互作用。
对于视频,时长是乘数
视频成本就是 费率 × 秒数,这意味着每一个你没有质疑的默认值都会被放大。同样一段 8 秒片段成本为:
| 模型 | 8 秒片段 |
|---|---|
grok-imagine/text-to-video |
$0.09 |
kling-3.0-omni/text-to-video |
$1.03 |
veo-3.1-fast/text-to-video |
$2.00 |
veo-3.1/text-to-video |
$4.56 |
由此直接得出两个习惯:
- 请求能满足镜头的最短时长。将 veo-3.1 片段从 8 秒裁剪到 5 秒可节省 $1.71——每个片段,每次都是。
- 在便宜模型上迭代,在昂贵模型上渲染。在
grok-imagine上进行六次 4 秒草稿迭代总成本约 $0.27——低于veo-3.1输出半秒钟的成本。在那里消耗你的提示词实验,然后只花一次 $4.56。
廉价草稿,高级定稿
影响最大的单一工作流改变是将探索与交付分开。产品图的实际示例:
- 在
z-image上进行 20 次草稿迭代,每次 $0.008 = $0.16 - 在
nano-banana-pro上进行 3 次最终渲染,每次 $0.17 = $0.51 - 总计:$0.67
全部 23 次生成都在 nano-banana-pro 上运行将花费 $3.91。相同数量的 API 调用、相同的最终资产,支出大约减少 83%——而且草稿循环也更快,因为草稿档模型几秒内即可返回。
唯一需要注意的:提示词在不同家族之间无法完美迁移。在最后一到两次迭代时,将草稿循环保持在最终定稿所用的模型上,这样你就能在投入高级预算之前发现家族特有的怪癖。
通过异步任务 API 进行批处理
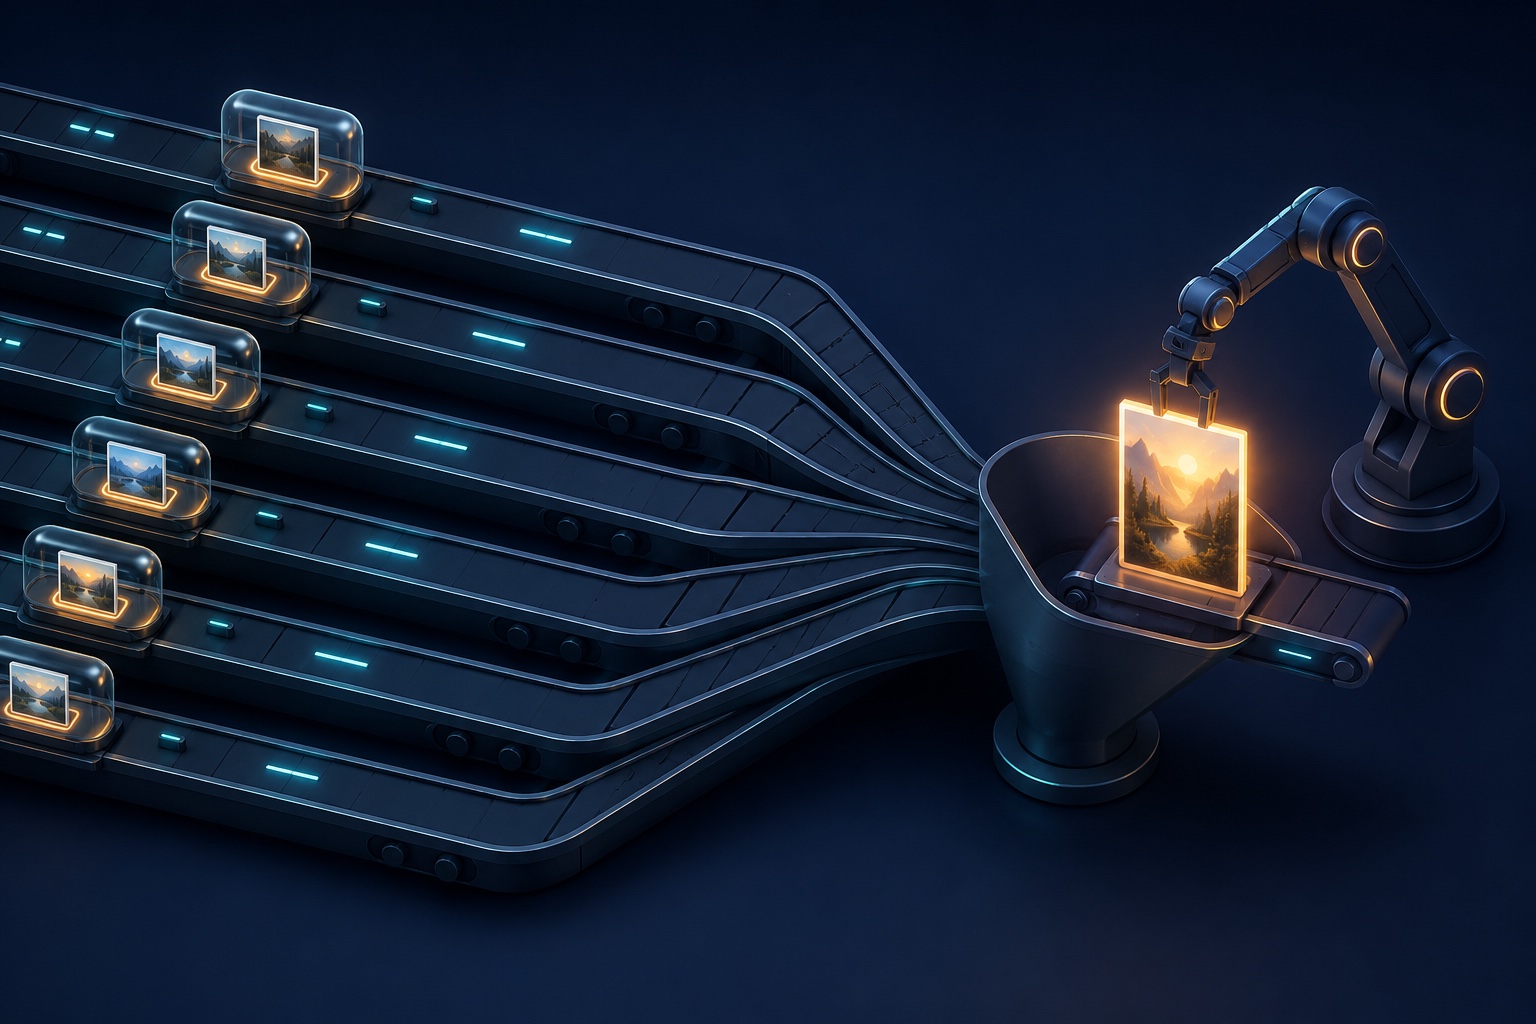
hiapi 上的每个媒体模型都通过异步任务端点运行:POST /v1/tasks 立即返回任务 ID,然后你轮询结果。批处理没有每请求折扣——收益是架构性的。由于提交与完成解耦,你可以一次性分发整个草稿批次,而不是串行等待每次生成,这正是先草稿后升级循环得以实用的原因:
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def create_task(model: str, prompt: str) -> str:
    r = requests.post(API, headers=HEADERS, json={
        "model": model,
        "input": {"prompt": prompt, "aspect_ratio": "1:1"},
    })
    r.raise_for_status()
    return r.json()["data"]["taskId"]

def wait_task(task_id: str, timeout: int = 600) -> str:
    deadline = time.time() + timeout
    while time.time() < deadline:
        task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]  # expiring URL — download it now
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(5)
    raise TimeoutError(task_id)

# Fan out 12 draft variations on a $0.008 model: ~$0.10 for the whole batch
variations = [f"studio product shot of a ceramic mug, camera angle {i}" for i in range(12)]
task_ids = [create_task("z-image", p) for p in variations]
urls = [wait_task(t) for t in task_ids]
先提交全部十二个,然后轮询——任务在平台侧并发生成,而你的代码只等待一次。除 prompt 之外的输入字段因模型而异(有些接受 resolution,有些只接受 aspect_ratio),所以在批处理之前查看模型的参数表;gpt-image-2 演练端到端展示了该模式。
当你扩大分发规模时,请遵守平台的并发上限——触发 429 的突发只会增加重试延迟。图像生成 API 速率限制详解介绍了限制的行为方式以及如何干净地退避。
十行预算守卫可将“我们会关注支出”变成真正的不变量:
PRICES = {"z-image": 0.008, "gpt-image-2/text-to-image": 0.03, "nano-banana-pro": 0.17}
BUDGET_USD = 5.00
spent = 0.0

def spend(model: str, images: int = 1) -> None:
    global spent
    cost = PRICES[model] * images
    if spent + cost > BUDGET_USD:
        raise RuntimeError(f"budget cap: ${spent + cost:.2f} would exceed ${BUDGET_USD:.2f}")
    spent += cost
在每次 create_task 之前调用它,失控的循环会在 $5 时大声失败,而不是出现在下个月的账单上。
不要为同一输出付两次钱
更隐蔽的成本泄漏是重新生成——为已经拥有的输出支付全价:
- 立即下载结果。任务输出 URL 有时间限制。如果你存储的是热链接而不是文件,而链接过期了,唯一的解决办法就是付费重新生成。详情和下载模式见此。
- 区分“任务失败”和“我的轮询放弃了”。客户端超时后才成功的任务,是花在无人收集的输出上的钱。将轮询超时设置得远高于模型的真实完成时间——在假设失败之前,这里介绍如何诊断挂起任务。
- 重用你自己的库。在第五次生成“白色背景上的干净工作室照片”之前,检查你已经付费的资产。一个带可搜索提示词的共享存储桶是你技术栈中最便宜的模型。
成本控制清单
- 按模型的原生单位做预算:每张图像、每秒、每 1,000 个字符。
- 每种媒体类型选择一个草稿档和一个交付档模型;按工作阶段路由。
- 对于视频,质疑每一个时长默认值——秒数是乘数。
- 通过
/v1/tasks分发草稿;仅将胜出者提升为高级渲染。 - 在代码中强制执行硬性支出上限,而不是在你每周检查的仪表板中。
- 立即下载每个输出;永远不要存储会过期的 URL。
随着新版本发布,模型价格会变动,所以从实时定价页面开始,从模型目录中选择你的草稿档和交付档,并将上述分发模式接入你的流水线——你运行的第一批任务会准确告诉你每个可用资产的真实成本。


