
Benutzerhandbuch
Kosten von KI-Bild- und -Video-APIs steuern: Tarifstufen, Batch-Verarbeitung und Modellauswahl
Beim selben Task unterscheiden sich das günstigste und das teuerste Modell um das 34- bis 50-Fache. Kostenkontrolle heißt vor allem zu wissen, wann welche Stufe ihren Preis wert ist.
Niemand sprengt sein KI-Medienbudget mit einem einzigen dramatischen API-Aufruf. Ausgaben entweichen auf leisen Sohlen durch drei Gewohnheiten: teuer für einen Einmal-Entwurf zahlen, nicht wissen, nach welcher Einheit tatsächlich abgerechnet wird, und seriell auf teuren Modellen iterieren, weil der Workflow nie so eingerichtet wurde, dass zuerst billig breit Varianten erzeugt werden.
Dieser Leitfaden sortiert die Kostenhebel, die bei der Erzeugung von Bildern und Videos über hiapi wirklich zählen: Abrechnungseinheit, Qualitätsstufen, Videolänge, den Workflow „erst Entwurf, dann Upgrade“ und Batch-Verarbeitung über die asynchrone Task-API. Alle folgenden Preise stammen von der Live-Preisseite vom Juli 2026 – betrachten Sie sie als Momentaufnahme und prüfen Sie die aktuellen Preise, bevor Sie ein Budget aufstellen.
Klarheit darüber, wofür Sie genau zahlen
hiapi rechnet Medienmodelle nach festen Einheiten pro Ausgabe ab – es gibt keine Token-Berechnung, die man rückwärts entschlüsseln müsste:
- Bildmodelle werden pro Bild berechnet, unabhängig davon, wie komplex der Prompt ist.
- Videomodelle werden pro Sekunde der erzeugten Ausgabe berechnet.
- Audiomodelle (z. B.
elevenlabs/text-to-dialogue-v3) werden pro 1.000 Zeichen Eingabetext berechnet.
Hier ist der Überblick über die Preise pro Bild in der Text-zu-Bild-Produktlinie:
| Modell | Preis pro Bild |
|---|---|
flux-schnell/text-to-image |
$0.005 |
gpt-image-2/text-to-image@ext |
$0.007 |
z-image |
$0.008 |
gpt-image-2/text-to-image@beta |
$0.02 |
qwen-image-2.0 |
$0.025 |
gpt-image-2/text-to-image |
$0.03 |
nano-banana |
$0.05 |
flux-1.1-pro |
$0.05 |
flux-2/text-to-image |
$0.05 |
nano-banana-2 |
$0.051 |
wan2.7-image/text-to-image |
$0.08 |
nano-banana-pro |
$0.17 |
Und die Preise pro Sekunde bei Video:
| Modell | Preis pro Sekunde |
|---|---|
grok-imagine (Text-zu-Video / Bild-zu-Video) |
$0.0114 |
kling-3.0-omni (Text-zu-Video / Bild-zu-Video) |
$0.129 |
seedance-2.0 |
$0.136 |
seedance-2.0-mini |
$0.147 |
wan2.7-video@pro (Text-zu-Video / Bild-zu-Video) |
$0.167 |
happyhorse-1.0 |
$0.168 |
happyhorse-1.1 (alle Endpunkte) |
$0.21 |
seedance-2.0-fast |
$0.2357 |
veo-3.1-fast |
$0.25 |
veo-3.1 |
$0.57 |
Zwei Zahlen sollte man sich einprägen: Die Bild-Produktlinie spannt vom günstigsten zum teuersten Modell das 34-Fache ($0.005 → $0.17), Video das 50-Fache ($0.0114 → $0.57 pro Sekunde). Die Modellwahl ist kein Feinregler – sie ist die größte Einzelentscheidung über Ihr Budget.
Eine Warnung: Leiten Sie den Preis nicht aus dem Modellnamen ab. In der Veo-Familie ist die -fast-Variante die günstigere Stufe ($0.25/s gegenüber $0.57/s), aber seedance-2.0-fast ist eine gehobene Beschleunigungsstufe, die pro Sekunde mehr kostet als die Basisversion seedance-2.0 ($0.2357 gegenüber $0.136). Lesen Sie die Preistabelle; nehmen Sie niemals etwas an.
Preisstufen als Funktion begreifen, nicht als Kleingedrucktes
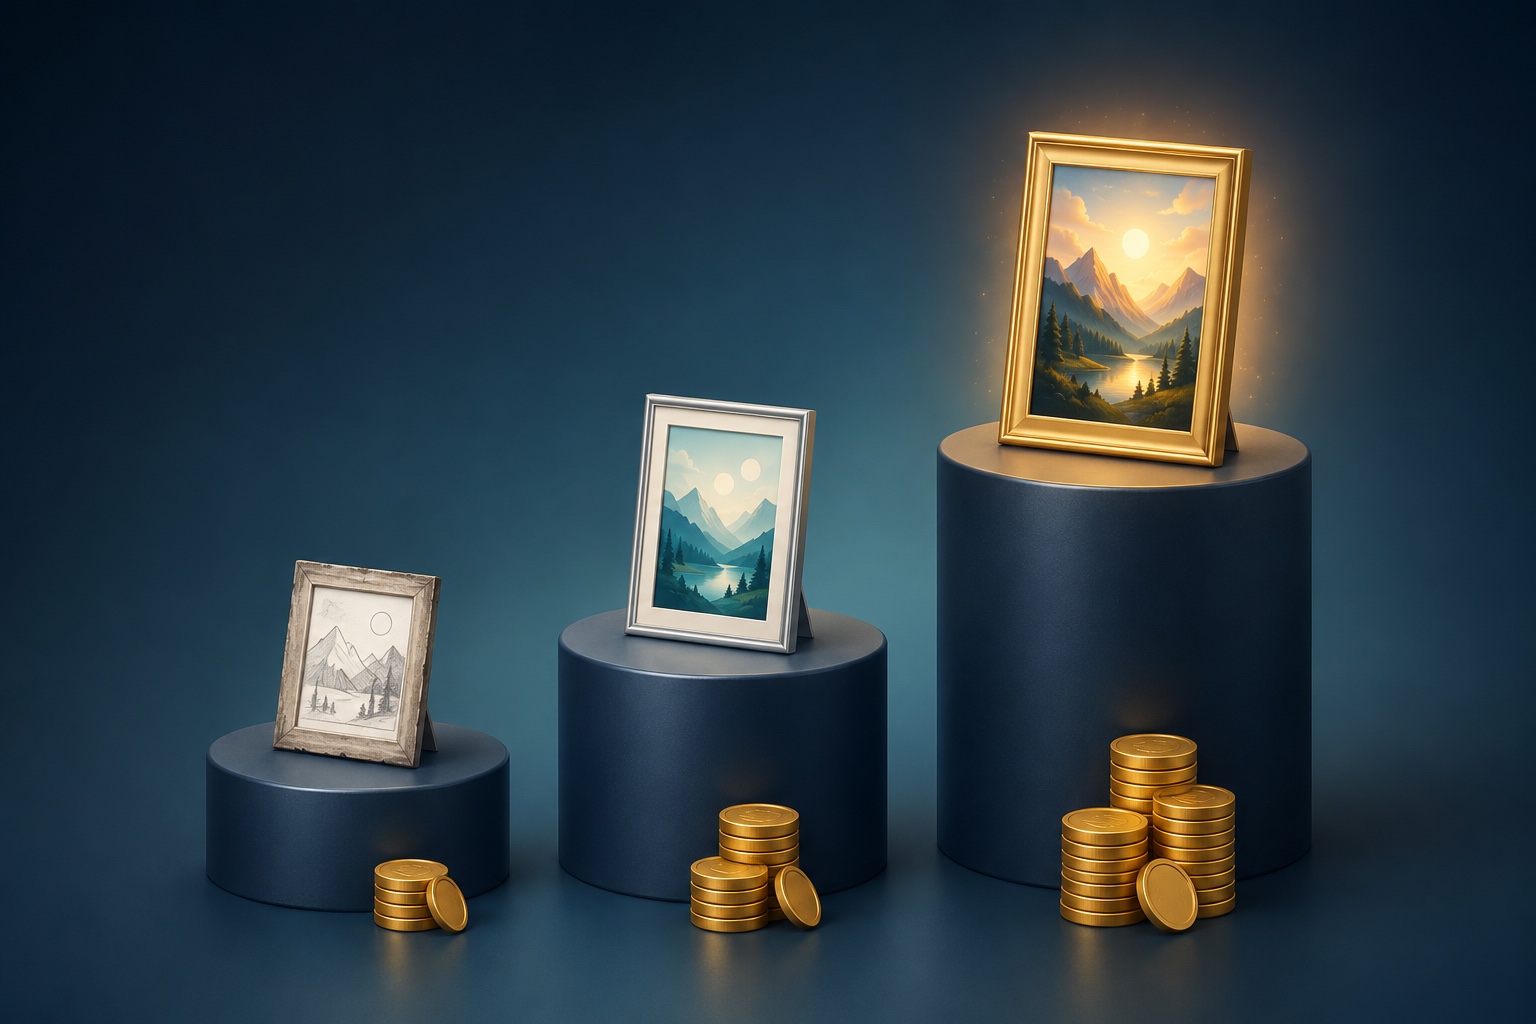
Die meisten Modellfamilien erscheinen in Stufen, und die Stufen existieren genau deshalb, damit Sie nicht für jede Aufgabe den Flaggschiff-Preis zahlen:
- Entwurfsstufe ($0.005–$0.008):
flux-schnell,z-imageund der@ext-Kanal von gpt-image-2. Für Prompt-Iteration, Kompositionstests und alles, was ein Mensch nur einmal ansieht und dann wegwirft. - Standardstufe ($0.02–$0.05):
gpt-image-2/text-to-image,qwen-image-2.0,nano-banana,flux-2. Für Produktionsqualität bei Blog-Covern, Produktbildern und UI-Assets. - Premium-Stufe ($0.08–$0.17):
wan2.7-imageundnano-banana-pro. Reserviert für finale Key-Visual-Assets, bei denen Details und Instruktionsbefolgung entscheidend sind.
Dieselbe Logik gilt für Kanalvarianten: Die Preisseite listet für gpt-image-2/text-to-image die Versionen @beta und @ext mit $0.02 bzw. $0.007, während der Standardkanal $0.03 kostet. Wenn Ihre Workload die Bedingungen des Vorschau-Kanals toleriert, sparen Sie bei identischem Prompt 20 %–77 %. Wie die Kosten pro Bild mit Auflösung und Wiederholungsrate zusammenspielen, vertiefen wir in Die günstigste Bildgenerierungs-API: Wie man die echten Kosten pro Bild vergleicht.
Bei Video ist die Länge ein Multiplikator
Videokosten sind einfach Tarif × Sekunden, was bedeutet, dass jeder ungeprüfte Standardwert verstärkt wird. Derselbe 8-Sekunden-Clip kostet:
| Modell | 8-Sekunden-Clip |
|---|---|
grok-imagine/text-to-video |
$0.09 |
kling-3.0-omni/text-to-video |
$1.03 |
veo-3.1-fast/text-to-video |
$2.00 |
veo-3.1/text-to-video |
$4.56 |
Daraus folgen direkt zwei Gewohnheiten:
- Fordern Sie die kürzeste Dauer an, die die Einstellung erfüllt. Einen veo-3.1-Clip von 8 auf 5 Sekunden zu kürzen spart $1.71 – pro Clip, jedes Mal.
- Auf günstigen Modellen iterieren, auf teuren rendern. Sechs 4-Sekunden-Entwurfsiterationen auf
grok-imaginekosten zusammen etwa $0.27 – weniger als eine halbe Sekunde Ausgabe vonveo-3.1. Verbrauchen Sie dort Ihre Prompt-Experimente und zahlen Sie dann nur einmal $4.56.
Günstiger Entwurf, Premium-Finalisierung
Die einzelne Workflow-Änderung mit der größten Wirkung besteht darin, Erkundung von Lieferung zu trennen. Ein konkretes Beispiel für ein Produktbild:
- 20 Entwurfsiterationen auf
z-imagezu je $0.008 = $0.16 - 3 finale Renderings auf
nano-banana-prozu je $0.17 = $0.51 - Gesamt: $0.67
Alle 23 Generierungen auf nano-banana-pro laufen zu lassen würde $3.91 kosten. Gleiche Anzahl an API-Aufrufen, gleiche finalen Assets, rund 83 % weniger Ausgaben – und die Entwurfsschleife ist zudem schneller, weil Modelle der Entwurfsstufe in Sekunden zurückkommen.
Die einzige Einschränkung: Prompts lassen sich nicht perfekt zwischen Familien übertragen. Halten Sie die Entwurfsschleife für die letzten ein bis zwei Iterationen beim Modell, mit dem Sie finalisieren wollen, damit Sie die Eigenheiten der Familie erkennen, bevor Sie das Premium-Budget einsetzen.
Batch-Verarbeitung über die asynchrone Task-API
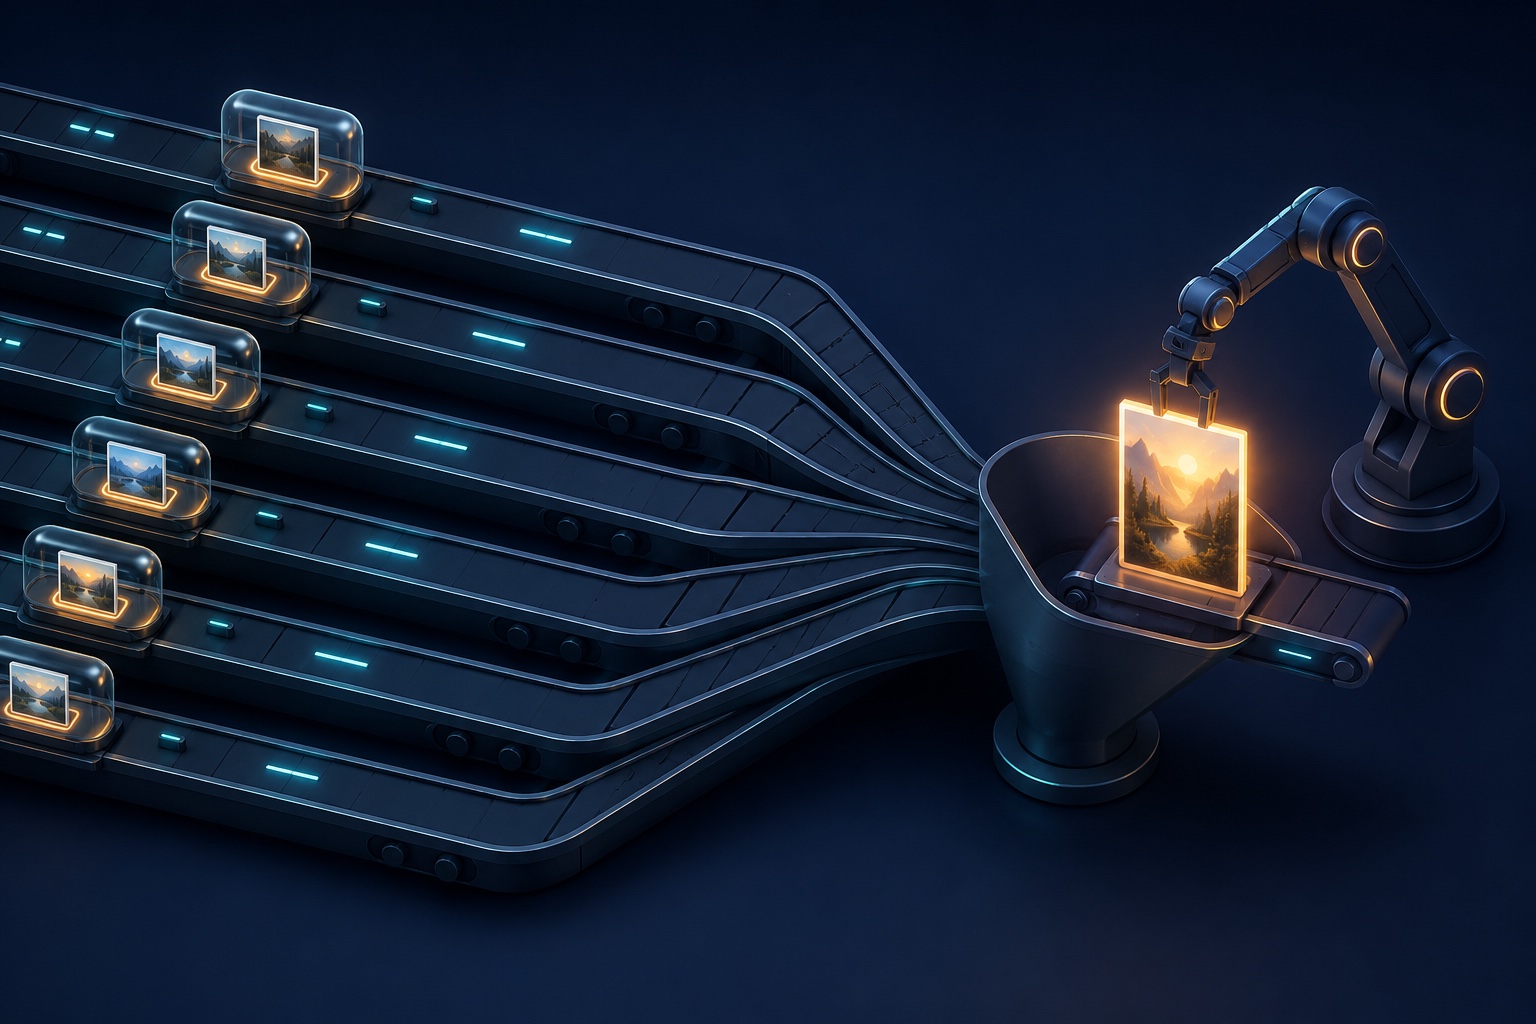
Jedes Medienmodell auf hiapi läuft über einen asynchronen Task-Endpunkt: POST /v1/tasks gibt sofort eine Task-ID zurück, danach pollen Sie das Ergebnis. Batch-Verarbeitung bringt keinen Rabatt pro Anfrage – der Gewinn ist architektonischer Natur. Da Einreichen und Abschluss entkoppelt sind, können Sie einen ganzen Entwurfsstapel auf einmal verteilen, statt seriell auf jede Generierung zu warten; genau das macht die Schleife „erst Entwurf, dann Upgrade“ praktikabel:
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def create_task(model: str, prompt: str) -> str:
    r = requests.post(API, headers=HEADERS, json={
        "model": model,
        "input": {"prompt": prompt, "aspect_ratio": "1:1"},
    })
    r.raise_for_status()
    return r.json()["data"]["taskId"]

def wait_task(task_id: str, timeout: int = 600) -> str:
    deadline = time.time() + timeout
    while time.time() < deadline:
        task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]  # expiring URL — download it now
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(5)
    raise TimeoutError(task_id)

# Fan out 12 draft variations on a $0.008 model: ~$0.10 for the whole batch
variations = [f"studio product shot of a ceramic mug, camera angle {i}" for i in range(12)]
task_ids = [create_task("z-image", p) for p in variations]
urls = [wait_task(t) for t in task_ids]
Reichen Sie zuerst alle zwölf ein und pollen Sie dann – die Tasks werden plattformseitig parallel generiert, während Ihr Code nur einmal wartet. Eingabefelder außer prompt unterscheiden sich je Modell (manche akzeptieren resolution, andere nur aspect_ratio), prüfen Sie also vor dem Batching die Parametertabelle des Modells; die gpt-image-2-Anleitung zeigt das Muster von Anfang bis Ende.
Wenn Sie die Verteilung ausweiten, beachten Sie die Nebenläufigkeitsgrenzen der Plattform – ein Burst, der 429 auslöst, erzeugt nur zusätzliche Wiederholungsverzögerung. Bildgenerierungs-API-Rate-Limits erklärt beschreibt, wie die Limits wirken und wie man sauber zurückweicht.
Ein Budget-Wächter in zehn Zeilen macht aus „wir behalten die Ausgaben im Blick“ eine echte Invariante:
PRICES = {"z-image": 0.008, "gpt-image-2/text-to-image": 0.03, "nano-banana-pro": 0.17}
BUDGET_USD = 5.00
spent = 0.0

def spend(model: str, images: int = 1) -> None:
    global spent
    cost = PRICES[model] * images
    if spent + cost > BUDGET_USD:
        raise RuntimeError(f"budget cap: ${spent + cost:.2f} would exceed ${BUDGET_USD:.2f}")
    spent += cost
Rufen Sie ihn vor jedem create_task auf, und eine außer Kontrolle geratene Schleife scheitert lautstark bei $5 statt auf der Rechnung des nächsten Monats.
Zahlen Sie nicht zweimal für dieselbe Ausgabe
Das versteckteste Kostenleck ist die Neugenerierung – den vollen Preis für eine Ausgabe zahlen, die Sie schon haben:
- Ergebnisse sofort herunterladen. Task-Ausgabe-URLs sind zeitlich begrenzt. Wenn Sie Hotlinks statt Dateien speichern und der Link abläuft, besteht die einzige Lösung darin, kostenpflichtig neu zu generieren. Details und Download-Muster finden Sie hier.
- „Task fehlgeschlagen“ von „mein Polling hat aufgegeben“ unterscheiden. Ein Task, der erst nach dem Client-Timeout erfolgreich war, ist Geld für eine Ausgabe, die niemand abgeholt hat. Setzen Sie das Polling-Timeout deutlich über die realistische Fertigstellungszeit des Modells – wie man hängende Tasks diagnostiziert, bevor man einen Fehlschlag annimmt, steht hier.
- Eigene Bibliothek wiederverwenden. Bevor Sie zum fünften Mal „sauberes Studiofoto auf weißem Hintergrund“ generieren, prüfen Sie die Assets, für die Sie bereits bezahlt haben. Ein gemeinsamer Bucket mit durchsuchbaren Prompts ist das günstigste Modell in Ihrem Stack.
Checkliste zur Kostenkontrolle
- Budgetieren Sie in der nativen Einheit des Modells: pro Bild, pro Sekunde, pro 1.000 Zeichen.
- Wählen Sie pro Medientyp ein Modell der Entwurfsstufe und eines der Lieferstufe; routen Sie nach Arbeitsphase.
- Hinterfragen Sie bei Video jeden Standardwert für die Länge – die Sekunden sind ein Multiplikator.
- Verteilen Sie Entwürfe über
/v1/tasks; befördern Sie nur die Gewinner zu Premium-Renderings. - Erzwingen Sie harte Ausgabengrenzen im Code, nicht in einem Dashboard, das Sie wöchentlich prüfen.
- Laden Sie jede Ausgabe sofort herunter; speichern Sie nie ablaufende URLs.
Mit neuen Versionsveröffentlichungen ändern sich Modellpreise, also beginnen Sie bei der Live-Preisseite, wählen Sie Ihre Entwurfs- und Lieferstufenmodelle aus dem Modellkatalog und hängen Sie das oben beschriebene Verteilungsmuster in Ihre Pipeline – die ersten Tasks, die Sie ausführen, zeigen Ihnen genau, was jedes verfügbare Asset tatsächlich kostet.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte