
Guia de uso
Controlar os custos da API de imagem e vídeo com IA: faixas, processamento em lote e seleção de modelos
Na mesma tarefa, o modelo mais barato e o mais caro diferem em 34 a 50 vezes. O controle de custos consiste principalmente em saber quando cada faixa vale a pena.
Ninguém esgota o orçamento de mídia de IA numa única chamada dramática à API. O gasto vaza silenciosamente por três hábitos: pagar caro por rascunhos descartáveis, não saber por qual unidade você realmente é cobrado e iterar em série em modelos caros porque o fluxo de trabalho nunca foi configurado para gerar muitas variantes de forma barata primeiro.
Este guia mapeia as alavancas de custo que realmente importam ao gerar imagens e vídeos pelo hiapi: unidade de cobrança, faixas de qualidade, duração do vídeo, o fluxo de rascunho primeiro e depois upgrade, e o processamento em lote pela API de tarefas assíncronas. Todos os preços abaixo vêm da página de preços ao vivo em julho de 2026 — considere-os um instantâneo e consulte os preços atuais antes de qualquer orçamento.
Deixe claro por qual unidade você está pagando
O hiapi cobra pelos modelos de mídia por uma unidade fixa de saída — não há nenhum cálculo de tokens para deduzir:
- Modelos de imagem são cobrados por imagem, por mais complexo que seja o prompt.
- Modelos de vídeo são cobrados por segundo de saída gerada.
- Modelos de áudio (por exemplo,
elevenlabs/text-to-dialogue-v3) são cobrados por 1.000 caracteres de texto de entrada.
Veja a visão geral de preços por imagem da linha de texto para imagem:
| Modelo | Preço por imagem |
|---|---|
flux-schnell/text-to-image |
$0.005 |
gpt-image-2/text-to-image@ext |
$0.007 |
z-image |
$0.008 |
gpt-image-2/text-to-image@beta |
$0.02 |
qwen-image-2.0 |
$0.025 |
gpt-image-2/text-to-image |
$0.03 |
nano-banana |
$0.05 |
flux-1.1-pro |
$0.05 |
flux-2/text-to-image |
$0.05 |
nano-banana-2 |
$0.051 |
wan2.7-image/text-to-image |
$0.08 |
nano-banana-pro |
$0.17 |
E o preço por segundo de vídeo:
| Modelo | Preço por segundo |
|---|---|
grok-imagine (texto para vídeo / imagem para vídeo) |
$0.0114 |
kling-3.0-omni (texto para vídeo / imagem para vídeo) |
$0.129 |
seedance-2.0 |
$0.136 |
seedance-2.0-mini |
$0.147 |
wan2.7-video@pro (texto para vídeo / imagem para vídeo) |
$0.167 |
happyhorse-1.0 |
$0.168 |
happyhorse-1.1 (todos os endpoints) |
$0.21 |
seedance-2.0-fast |
$0.2357 |
veo-3.1-fast |
$0.25 |
veo-3.1 |
$0.57 |
Dois números merecem ser memorizados: a linha de imagens vai do mais barato ao mais caro numa faixa de 34 vezes ($0.005 → $0.17), e o vídeo numa faixa de 50 vezes ($0.0114 → $0.57 por segundo). A escolha do modelo não é um botão de ajuste fino — é a maior decisão orçamentária isolada que você toma.
Um alerta: não deduza o preço a partir do nome do modelo. Na família Veo, a variante -fast é a faixa mais barata ($0.25/s contra $0.57/s), mas seedance-2.0-fast é a faixa premium acelerada, com custo por segundo superior ao da versão base seedance-2.0 ($0.2357 contra $0.136). Leia a tabela de preços; nunca presuma.
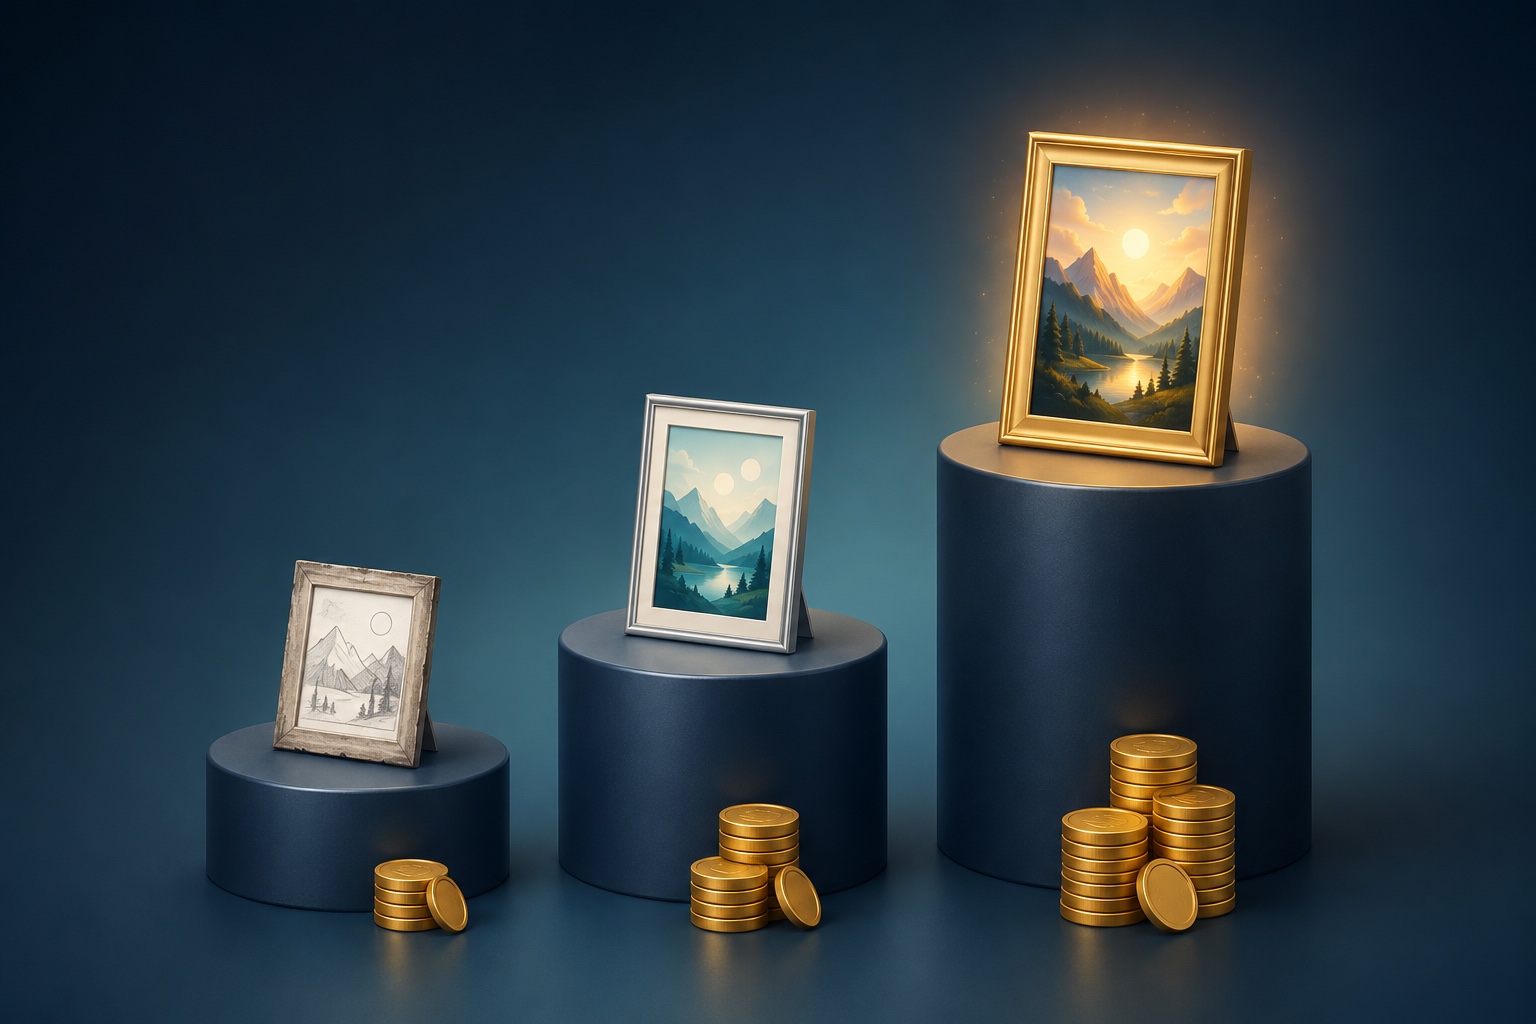
Trate as faixas de preço como recurso, não como letra miúda
A maioria das famílias de modelos é lançada em faixas, e as faixas existem justamente para que você não pague o preço do carro-chefe por todo trabalho:
- Faixa de rascunho ($0.005–$0.008):
flux-schnell,z-imagee o canal@extdo gpt-image-2. Use para iteração de prompts, testes de composição e qualquer coisa que um humano vai olhar uma vez e descartar. - Faixa padrão ($0.02–$0.05):
gpt-image-2/text-to-image,qwen-image-2.0,nano-banana,flux-2. Qualidade de produção para capas de blog, fotos de produto e ativos de UI. - Faixa premium ($0.08–$0.17):
wan2.7-imageenano-banana-pro. Reserve para os ativos de key visual finais em que detalhe e aderência às instruções são críticos.
A mesma lógica se aplica às variantes de canal: a página de preços lista as versões @beta e @ext de gpt-image-2/text-to-image a $0.02 e $0.007 respectivamente, enquanto o canal padrão custa $0.03. Se sua carga de trabalho tolera os termos do canal de pré-visualização, isso representa uma economia de 20%–77% no mesmo prompt. Aprofundamos a interação entre custo por imagem, resolução e taxa de novas tentativas em A API de geração de imagens mais barata: como comparar o custo real por imagem.
Para vídeo, a duração é um multiplicador
O custo de vídeo é simplesmente tarifa × segundos, o que significa que todo padrão que você não questiona é amplificado. O mesmo clipe de 8 segundos custa:
| Modelo | Clipe de 8 segundos |
|---|---|
grok-imagine/text-to-video |
$0.09 |
kling-3.0-omni/text-to-video |
$1.03 |
veo-3.1-fast/text-to-video |
$2.00 |
veo-3.1/text-to-video |
$4.56 |
Dois hábitos decorrem diretamente disso:
- Peça a menor duração que atenda à cena. Cortar um clipe do veo-3.1 de 8 para 5 segundos economiza $1.71 — por clipe, sempre.
- Itere em um modelo barato, renderize no caro. Seis iterações de rascunho de 4 segundos no
grok-imaginecustam cerca de $0.27 no total — menos do que meio segundo de saída doveo-3.1. Gaste ali sua experimentação de prompts e depois pague $4.56 uma única vez.
Rascunho barato, finalização premium
A mudança de fluxo de trabalho de maior impacto é separar exploração de entrega. Um exemplo real de foto de produto:
- 20 iterações de rascunho no
z-imagea $0.008 cada = $0.16 - 3 renders finais no
nano-banana-proa $0.17 cada = $0.51 - Total: $0.67
Rodar todas as 23 gerações no nano-banana-pro custaria $3.91. Mesmo número de chamadas à API, mesmos ativos finais, com cerca de 83% menos gasto — e o ciclo de rascunho também é mais rápido, porque os modelos da faixa de rascunho retornam em segundos.
A única ressalva: prompts não migram perfeitamente entre famílias. Nas últimas uma ou duas iterações, mantenha o ciclo de rascunho no modelo que você usará para a finalização, assim você identifica peculiaridades específicas da família antes de comprometer o orçamento premium.
Processamento em lote pela API de tarefas assíncronas
Todo modelo de mídia no hiapi roda por um endpoint de tarefas assíncronas: POST /v1/tasks retorna imediatamente um ID de tarefa, e então você consulta o resultado. O processamento em lote não tem desconto por requisição — o ganho é arquitetural. Como o envio é desacoplado da conclusão, você pode despachar todo o lote de rascunhos de uma vez, em vez de esperar em série por cada geração, e é exatamente isso que torna prático o ciclo de rascunho e depois upgrade:
import requests, time

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def create_task(model: str, prompt: str) -> str:
    r = requests.post(API, headers=HEADERS, json={
        "model": model,
        "input": {"prompt": prompt, "aspect_ratio": "1:1"},
    })
    r.raise_for_status()
    return r.json()["data"]["taskId"]

def wait_task(task_id: str, timeout: int = 600) -> str:
    deadline = time.time() + timeout
    while time.time() < deadline:
        task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]  # expiring URL — download it now
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(5)
    raise TimeoutError(task_id)

# Fan out 12 draft variations on a $0.008 model: ~$0.10 for the whole batch
variations = [f"studio product shot of a ceramic mug, camera angle {i}" for i in range(12)]
task_ids = [create_task("z-image", p) for p in variations]
urls = [wait_task(t) for t in task_ids]
Envie as doze de uma vez e depois consulte — as tarefas geram em paralelo do lado da plataforma, e seu código espera apenas uma vez. Campos de entrada além de prompt variam por modelo (alguns aceitam resolution, outros apenas aspect_ratio), então consulte a tabela de parâmetros do modelo antes de processar em lote; o passo a passo do gpt-image-2 mostra esse padrão de ponta a ponta.
Ao ampliar o despacho, respeite os limites de concorrência da plataforma — picos que disparam 429 só aumentam a latência das novas tentativas. Limites de taxa da API de geração de imagens explicados descreve como os limites se comportam e como recuar de forma limpa.
Dez linhas de proteção orçamentária transformam “vamos acompanhar os gastos” em uma invariante real:
PRICES = {"z-image": 0.008, "gpt-image-2/text-to-image": 0.03, "nano-banana-pro": 0.17}
BUDGET_USD = 5.00
spent = 0.0

def spend(model: str, images: int = 1) -> None:
    global spent
    cost = PRICES[model] * images
    if spent + cost > BUDGET_USD:
        raise RuntimeError(f"budget cap: ${spent + cost:.2f} would exceed ${BUDGET_USD:.2f}")
    spent += cost
Chame isso antes de cada create_task, e um loop descontrolado falhará ruidosamente ao atingir $5 em vez de aparecer na fatura do mês seguinte.
Não pague duas vezes pela mesma saída
O vazamento de custo mais insidioso é a regeneração — pagar o preço cheio por uma saída que você já tem:
- Baixe os resultados imediatamente. As URLs de saída das tarefas têm prazo de validade. Se você armazena links diretos em vez de arquivos e o link expira, a única solução é pagar pela regeneração. Detalhes e padrões de download estão aqui.
- Distinga “a tarefa falhou” de “minha consulta desistiu”. Uma tarefa que só teve sucesso depois que o cliente atingiu o tempo limite é dinheiro gasto em uma saída que ninguém coletou. Defina o tempo limite de consulta bem acima do tempo real de conclusão do modelo — antes de presumir falha, veja aqui como diagnosticar tarefas travadas.
- Reutilize sua própria biblioteca. Antes da quinta geração de “foto limpa de estúdio em fundo branco”, verifique os ativos pelos quais você já pagou. Um bucket compartilhado com prompts pesquisáveis é o modelo mais barato da sua stack.
Lista de verificação de controle de custos
- Orce na unidade nativa do modelo: por imagem, por segundo, por 1.000 caracteres.
- Escolha um modelo de faixa de rascunho e um de faixa de entrega para cada tipo de mídia; encaminhe conforme a fase do trabalho.
- Para vídeo, questione cada padrão de duração — os segundos são um multiplicador.
- Despache rascunhos via
/v1/tasks; promova apenas as vencedoras para renderização premium. - Imponha um teto rígido de gastos no código, não no painel que você verifica semanalmente.
- Baixe cada saída imediatamente; nunca armazene URLs que expiram.
Os preços dos modelos mudam à medida que novas versões são lançadas, então comece pela página de preços ao vivo, escolha seus modelos de faixa de rascunho e de entrega no catálogo de modelos e conecte o padrão de despacho acima ao seu pipeline — o primeiro lote de tarefas que você executar dirá exatamente qual é o custo real de cada ativo utilizável.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores