
Guide d'utilisation
Guide d'utilisation d'ElevenLabs Text to Dialogue : soumettre un audio de dialogue entre deux personnes via le tableau dialogue
Du découpage d'un script à deux personnages à la requête de timbre par réplique, soumettre et valider selon le contrat HiAPI actuel
Sur cette page
Vérifiez d'abord qu'il s'agit d'une synthèse de dialogue et non d'une lecture d'un seul bloc
Si votre matériau est un script de dialogue à deux (ou plusieurs) personnages, la solution la plus directe consiste souvent à synthétiser chaque réplique séparément, puis à les assembler dans l'ordre. Les problèmes de cette approche n'apparaissent qu'à la livraison : chaque réplique forme un audio indépendant, et les pauses, l'enchaînement du débit et la cohérence des timbres doivent être rattrapés au niveau de l'assemblage ; dès que les personnages se multiplient, l'ordre d'assemblage et les erreurs de timbre deviennent la principale source de bugs.
elevenlabs/text-to-dialogue a pour vocation de représenter tout un dialogue en une seule requête. Vous découpez le script complet en un tableau dialogue et le soumettez ; le modèle réalise le dialogue multi-timbres au sein d'une même génération et produit une seule piste audio complète. Par rapport à « plusieurs synthèses séparées + assemblage », cette approche intègre le mapping des rôles et l'ordre des répliques directement dans le corps de la requête : à la validation, il suffit de contrôler un seul résultat.
Faites donc d'abord ce test :
- si le contenu est une lecture continue par un même locuteur, la synthèse vocale classique suffit, le tableau
dialoguen'est pas nécessaire ; - si le contenu est un dialogue alterné entre deux personnages ou plus et que vous souhaitez une écoute globale homogène, utilisez le tableau
dialoguede cette interface ; - si le contenu est un dialogue mais que le nombre total de caractères dépasse largement la limite, découpez-le par segments sémantiques et soumettez-le par lots, plutôt que de revenir à une synthèse réplique par réplique.
Une fois confirmé que vous êtes dans le deuxième cas, il faut comprendre la structure du tableau lui-même.
Structure du tableau dialogue : text et voice pour chaque ligne
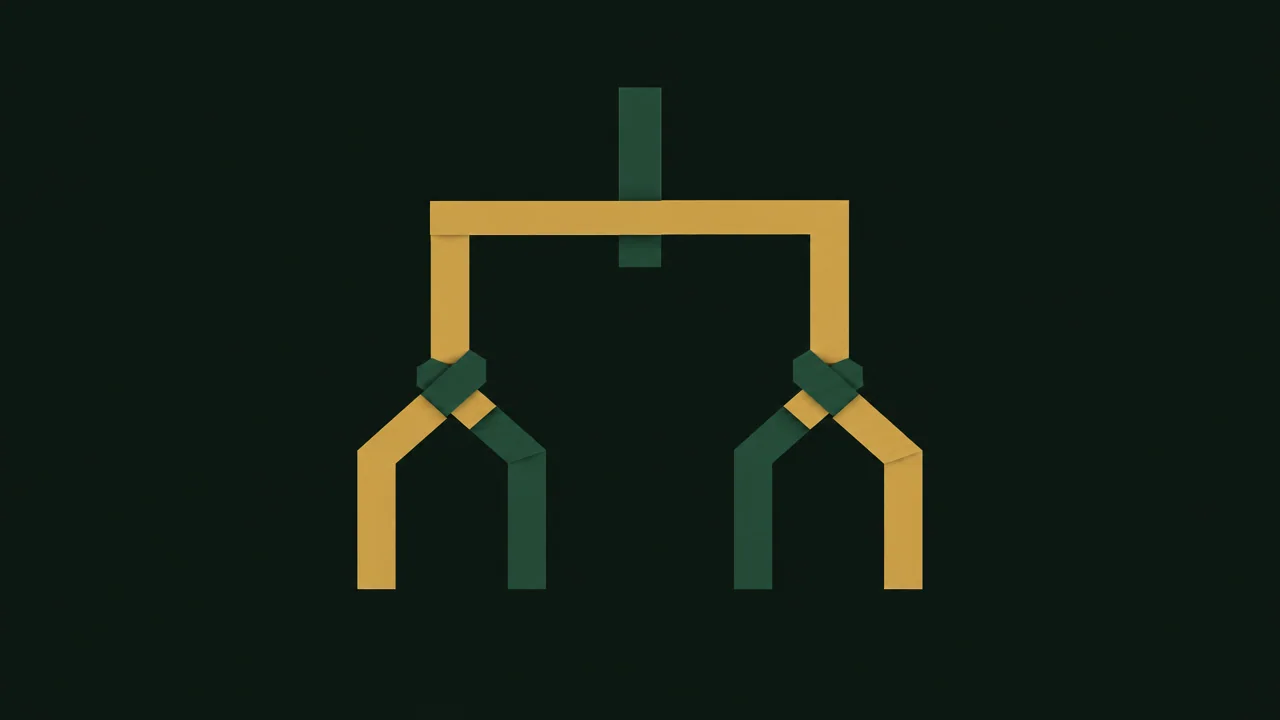
Dans le contrat HiAPI, l'entrée de elevenlabs/text-to-dialogue repose sur un seul champ obligatoire : dialogue. C'est un tableau d'au moins 1 élément ; chaque élément est une ligne de dialogue et contient deux sous-champs obligatoires :
text: le texte de la réplique, chaîne de caractères, minimum 1 caractère ;voice: le timbre utilisé pour cette ligne, chaîne de caractères, pouvant contenir un nom de timbre prédéfini ou unvoice_id, valeur par défautEkK5I93UQWFDigLMpZcX.
Les deux champs sont obligatoires — même si vous ne voulez utiliser que le timbre par défaut, il est recommandé d'écrire explicitement voice pour que le corps de la requête soit auto-explicatif. Voici une requête minimale à deux personnages :
{
  "dialogue": [
    { "text": "Où en est ton avancement ?", "voice": "EkK5I93UQWFDigLMpZcX" },
    { "text": "Je peux livrer une première version cette semaine.", "voice": "Z3R5wn05IrDiVCyEkUrK" },
    { "text": "Très bien, je te transmets d'abord la liste de validation.", "voice": "EkK5I93UQWFDigLMpZcX" }
  ]
}
Notez que l'ordre du tableau correspond à l'ordre du dialogue : l'interface n'a pas de champ « locuteur » supplémentaire, les rôles sont distingués uniquement par voice. C'est le point à concevoir en amont le plus important de toute l'intégration.
Découper un script à deux personnages en entrées par réplique
Pour passer du texte du script au tableau dialogue, il est conseillé de suivre un pipeline fixe afin d'éviter les erreurs de JSON écrit à la main.
Étape 1 : découper par ligne et annoter le locuteur
Organisez le script en paires « locuteur + réplique », une réplique par entrée ; ne fusionnez pas les répliques de deux personnages dans un même text — dans ce cas un élément ne peut porter qu'un seul voice, et une fois fusionnées, les rôles ne sont plus distinguables. Les narrations et indications scéniques entre parenthèses ne font pas partie des répliques : retirez-les séparément et ne les mettez pas dans text.
Étape 2 : nettoyer le texte
Vérifiez chaque entrée : supprimez les espaces en début et fin, uniformisez la ponctuation et les sauts de ligne, supprimez les lignes vides. La longueur minimale de text est de 1 caractère ; une chaîne vide déclenche directement un échec de validation. Si une ligne ne contient qu'une interjection (par exemple « Hum », « Oui »), vous pouvez la conserver ; mais si après nettoyage elle devient une chaîne vide, il faut confirmer avec l'équipe de contenu s'il faut supprimer cette ligne.
Étape 3 : établir le mapping des rôles et générer le tableau
Chaque étiquette de locuteur est associée à un timbre unique, puis les éléments sont générés dans l'ordre des lignes. Le pseudo-code ressemble à ceci :
speaker_voice = {
    "A": "EkK5I93UQWFDigLMpZcX",
    "B": "Z3R5wn05IrDiVCyEkUrK",
}

dialogue = [
    {"text": line.text, "voice": speaker_voice[line.speaker]}
    for line in script
]
Pièges courants
- Un même personnage utilise deux timbres différents à deux endroits : la rupture d'écoute est nette ;
- L'oubli de
voicefait retomber tout le passage sur le timbre par défaut, et le dialogue à deux devient « une seule personne jouant deux rôles » ; - L'ordre du tableau est perturbé par une logique de tri ou de dédoublonnage : la sémantique du dialogue est brisée.
Après génération, affichez d'abord les premières entrées pour une vérification manuelle, puis passez à l'étape du budget de caractères.
Mapping de timbre fixe : un seul voice par personnage
La raison pour laquelle voice doit être « fixe » est qu'il détermine à la fois le timbre lui-même et la sémantique de « qui parle ». Si un même personnage utilise deux valeurs voice différentes dans tout le dialogue, l'auditeur croira à un changement de personne ; inversement, si deux personnages se retrouvent avec le même voice, le dialogue perd sa distinction.
En pratique, il est recommandé de maintenir dans le code une table de constantes de mapping rôle → timbre, plutôt que de disperser des littéraux de chaîne dans chaque réplique :
const VOICE = {
  host: "EkK5I93UQWFDigLMpZcX",
  guest: "Z3R5wn05IrDiVCyEkUrK",
};
Toutes les lignes prennent leur valeur uniquement depuis cette table ; les retours à la ligne ou les réorganisations du script ne brisent pas la cohérence. voice accepte un nom de timbre prédéfini ou un voice_id ; si l'équipe dispose déjà de son propre système de nommage des timbres, vous pouvez faire une conversion dans la couche de configuration et tout ramener à une valeur acceptée par l'interface au moment de l'envoi. Le contrat fournit une énumération des timbres ; validez une fois avec cette énumération avant la soumission pour bloquer les erreurs basiques comme les fautes de frappe — les valeurs hors énumération ne sont pas silencieusement traitées comme valeur par défaut.
Un autre point souvent négligé est la stabilité entre les segments. Lorsque le nombre total de caractères dépasse la limite et qu'il faut découper en plusieurs requêtes, la table de mapping des timbres doit être réutilisée telle quelle, sans choisir de nouveaux timbres dans les nouvelles requêtes, sinon le même personnage présentera des différences audibles d'un segment à l'autre.
Budget de caractères et découpage des requêtes
L'interface impose une contrainte ferme sur le volume : le nombre total de caractères de tous les champs text du tableau dialogue ne doit pas dépasser 5000. Il s'agit bien de la somme de tous les textes du tableau, et non de la longueur d'une ligne ni du nombre d'éléments. Le chinois, l'anglais et la ponctuation sont généralement comptés en caractères ; pour l'estimation, mieux vaut prévoir une marge selon l'interprétation la plus large.
La logique de comptage doit être écrite après la génération du tableau et avant l'envoi de la requête :
total = sum(len(item["text"]) for item in dialogue)
assert total <= 5000
En cas de dépassement, la bonne approche consiste à découper selon les frontières sémantiques en plusieurs sous-dialogues, à les soumettre séparément, à obtenir chaque audio séparément, puis à les combiner selon les besoins métier ; il ne faut ni tronquer les répliques ni supprimer des lignes. Trois points à respecter lors du découpage :
- placez les points de coupe aux changements de scène ou de sujet, en évitant de séparer une question et sa réponse entre deux requêtes ;
- comptez chaque sous-segment individuellement, en respectant également la limite de 5000 ;
- lors de la reconstruction du tableau pour chaque fragment, conservez l'ordre des lignes et le mapping des timbres par rôle.
Si le contenu est lui-même un long dialogue, il est conseillé de l'organiser dès la phase de contenu par « actes » ou « chapitres », de sorte que chaque acte tienne naturellement dans le budget et que l'on réduise les ruptures d'écoute dues à des découpages tardifs.
Paramètres optionnels : stability et language_code
Outre dialogue, l'interface propose deux paramètres optionnels, dont l'usage dépend du type de contenu.
stability
stability est un paramètre numérique pouvant prendre 0, 0.5 ou 1, avec 0.5 par défaut. Sa signification est la stabilité du timbre :
- plus la valeur est faible, plus l'émotion est riche et variée, ce qui convient aux dialogues avec des variations émotionnelles et aux contenus narratifs ;
- plus la valeur est élevée, plus la sortie est stable et homogène, ce qui convient aux annonces de marque, aux scripts de service client et autres scénarios exigeant une écoute uniforme ;
- la valeur par défaut 0.5 est un compromis entre les deux.
Notez qu'il s'agit d'un paramètre au niveau de la requête entière, et non d'un réglage par ligne. Si les différences émotionnelles entre personnages sont importantes dans un même dialogue, il faut soit accepter une valeur de compromis, soit faire en sorte que les différents fragments utilisent des stability différentes lors du découpage.
language_code
language_code est un code de langue au format ISO, chaîne vide par défaut ; laisser vide signifie détection automatique de la langue. Lorsque la langue du contenu est claire et que l'on souhaite éviter les écarts de détection, il est plus sûr de la spécifier explicitement, par exemple zh pour un contenu chinois. Le contrat fournit une énumération complète des codes de langue ; il convient de valider une fois avant la soumission pour éviter de transmettre une valeur non prise en charge.
Les deux paramètres sont facultatifs ; si le contenu n'a pas d'exigence particulière, les omettre et utiliser le comportement par défaut est tout à fait acceptable.
Soumission et validation : contrôler selon le contrat orienté tâche
Cette interface soumet sous forme de tâche : vous envoyez une entrée, obtenez un résultat de tâche, puis validez autour de ce résultat. Cela implique deux choses.
Premièrement, le contrat d'entrée doit être validé par vous-même. Avant l'envoi, vérifiez point par point : dialogue est un tableau d'au moins 1 élément ; chaque élément possède à la fois un text et un voice non vides ; le nombre total de caractères de tous les text ne dépasse pas 5000 ; stability ne prend que 0/0.5/1 ; language_code appartient à l'énumération ou est vide. Placer ces contrôles côté client réduit significativement les soumissions invalides.
Deuxièmement, ne supposez pas de comportements non déclarés dans le contrat. La documentation de l'interface ne garantit ni nouvelle tentative automatique, ni clé d'idempotence, ni compensation en cas d'échec ; ne comptez donc pas sur « la resoumission de la même requête » comme filet de sécurité — chaque soumission doit être considérée comme une tâche indépendante. En ingénierie, l'approche sûre consiste à :
- enregistrer avant la soumission un résumé de l'entrée (nombre d'éléments du tableau, nombre total de caractères, version du mapping des timbres) pour faciliter la comparaison a posteriori ;
- après réception du résultat, confirmer d'abord que l'audio est exploitable, que la durée est raisonnable et que les rôles sont distinguables, avant toute distribution en aval ;
- en cas de nouvelle exécution, refaire toute la validation d'entrée plutôt que de réutiliser un ancien corps de requête non vérifié.
La validation porte sur « le résultat correspond-il aux attentes », et non sur une supposition du fonctionnement interne du service. Sur HiAPI, vous pouvez consulter le contrat actuel depuis la page du modèle elevenlabs/text-to-dialogue avant de commencer.
Liste d'auto-contrôle avant mise en ligne
Intégrez le groupe de contrôles suivant dans un processus automatique avant soumission ; il couvre l'essentiel des causes d'échec :
dialogueest un tableau, nombre d'éléments ≥ 1 ;- chaque élément contient à la fois
textetvoice, et aucun n'est une chaîne vide ; - chaque
voiceappartient à l'énumération du contrat, et un même personnage utilise globalement une seule valeur ; - l'ordre du tableau correspond à l'ordre des lignes du script, sans intervention d'une logique de tri ou de dédoublonnage ;
- le nombre total de caractères de tous les
textest ≤ 5000, et le contenu excédentaire a été découpé selon la sémantique ; - si définis explicitement,
stability∈ {0, 0.5, 1} etlanguage_code∈ énumération ou vide ; - le résumé de l'entrée (nombre d'éléments, nombre de caractères, version du mapping) est enregistré pour faciliter la comparaison lors de la validation.
Au-delà de cette liste, une règle empirique s'applique : commencez par valider de bout en bout sur un échantillon court, puis passez à l'échelle du script complet. Les problèmes de mapping des rôles et de budget de caractères se révèlent dès un échantillon de quelques dizaines de lignes ; inutile d'attendre la soumission de tout le contenu pour les découvrir.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage avec gpt-6.2-sol : limites de capacité, intégration API et tarification par token
Points de décision et de pratique pour l'intégration par les équipes d'ingénierie
-

Guide d'utilisation
Guide de prise en main de gpt-6.2-astra : limites de capacités du modèle texte, points d'intégration et maîtrise des coûts
-

Guide d'utilisation
Guide de prise en main de Tripo H3.1 : trois modes d'entrée, paramètres et choix tarifaires
Décision d'intégration et maîtrise des coûts de la génération 3D pour les développeurs