
Guide d'utilisation
Guide de démarrage pour flux-3-video : limites de capacités, intégration API et maîtrise des coûts
Du text-to-video au video-to-video : capacités, prix et points d'intégration du point de vue du développeur
Qu'est-ce que flux-3-video et à qui s'adresse-t-il
flux-3-video est un modèle de génération vidéo lancé par Black Forest Labs, dont le type de sortie est un simple fichier vidéo. Il couvre en une seule fois trois modalités d'entrée : text-to-video, image-to-video et video-to-video. Cela signifie que vous n'avez pas à chercher des modèles différents pour les situations « sans matériel source » et « avec matériel source » : un seul et même modèle prend en charge la génération à partir de zéro comme la réécriture à partir de matériel existant.
Pour déterminer s'il appartient à la catégorie de modèle que vous recherchez, posez-vous trois questions :
- Votre produit a-t-il besoin de vidéo comme livrable, et non d'images ou de texte ? Si vous ne voulez que des contenus statiques, les modèles d'image sont moins chers et plus rapides.
- Vos conditions de matériel source relèvent-elles de l'un des trois : text, image, video ? Il suffit d'en satisfaire un pour disposer d'une entrée correspondante.
- Acceptez-vous une forme d'appel asynchrone à longue durée ? La génération vidéo n'est pas une requête en millisecondes ; la chaîne doit être conçue comme une tâche asynchrone.
Pour les équipes qui produisent en masse des supports marketing, génèrent des brouillons de vidéos courtes ou réécrivent le style de matériels, un modèle prenant en charge simultanément trois modalités coûte généralement moins cher en intégration que l'assemblage de plusieurs modèles spécialisés. En revanche, pour les scénarios extrêmement sensibles à la latence et nécessitant un retour en temps réel, il ne convient pas à une intégration directe.
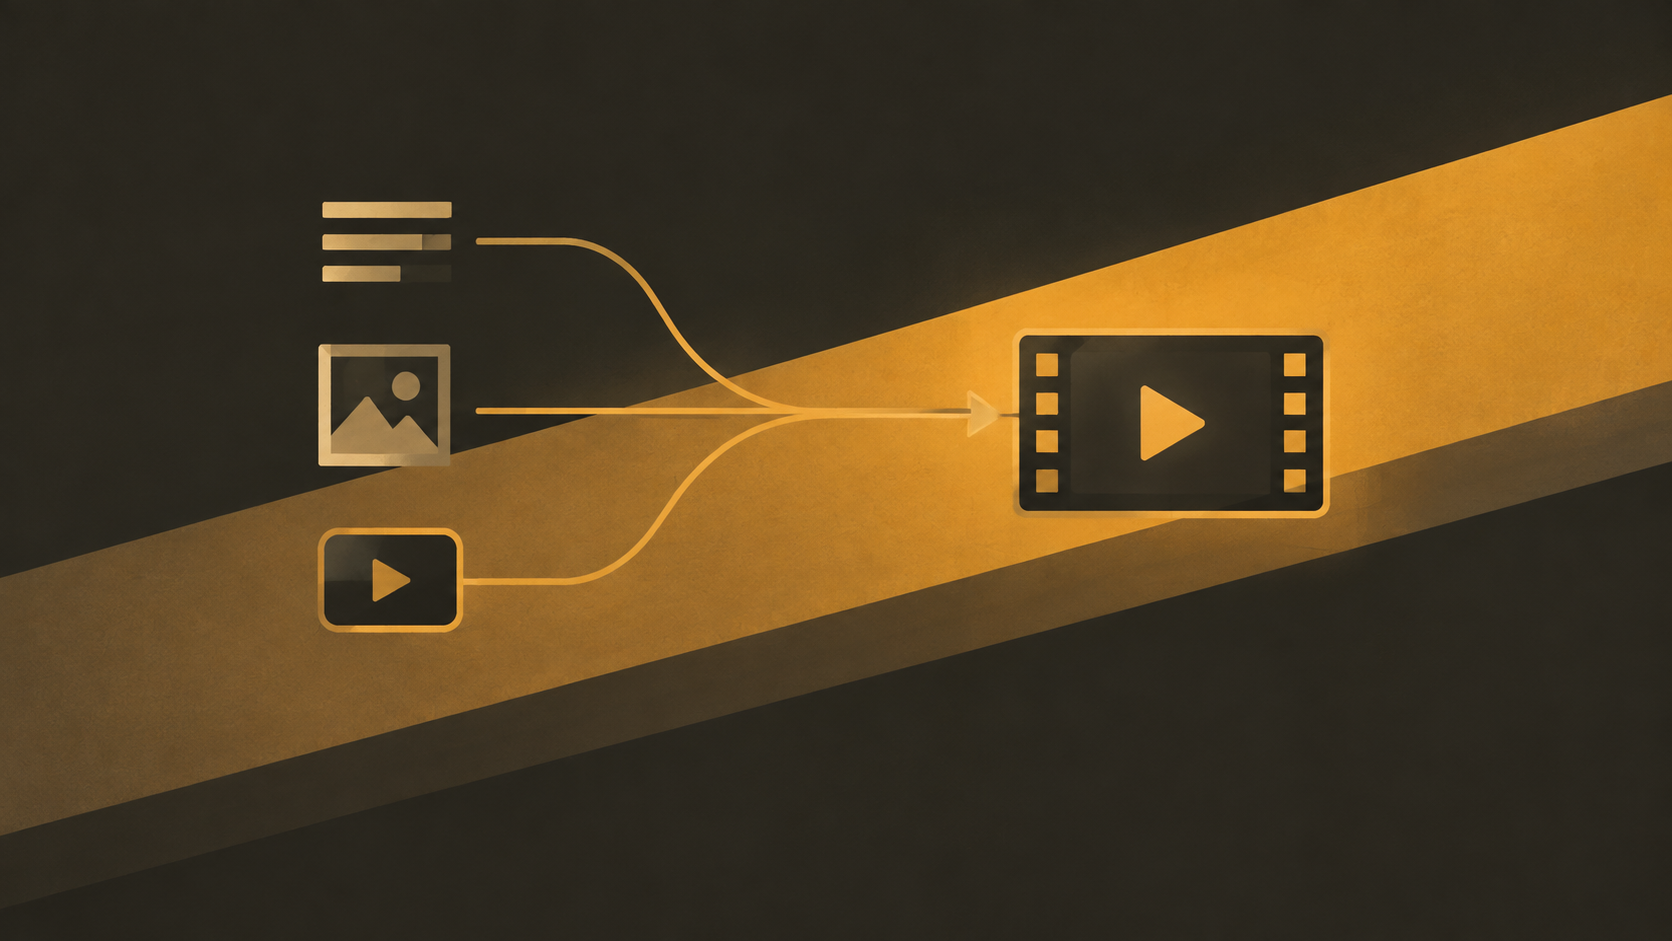
Trois parcours de génération : texte-vers-vidéo, image-vers-vidéo et vidéo-vers-vidéo
La différence entre les trois entrées réside dans ce que vous possédez déjà et dans ce que vous souhaitez que le modèle complète.
text-to-video
L'entrée est un prompt textuel, la sortie est une vidéo entièrement nouvelle. Les cas d'usage incluent les démonstrations de concepts, les brouillons de storyboard et l'exploration créative sans matériel de départ. L'avantage est de ne dépendre d'aucun matériel préalable ; l'inconvénient est la plus faible contrôlabilité : les détails de l'image sont entièrement guidés par le prompt, et plusieurs passes d'essai sont nécessaires pour s'approcher du résultat attendu.
image-to-video
L'entrée est une image de référence plus un prompt textuel, la sortie est une vidéo animée qui se déploie à partir de cette image. Convient aux scénarios où une image finalisée (photo produit, affiche, design de personnage) doit « s'animer ». Par rapport au texte-vers-vidéo, la cohérence visuelle est mieux garantie, car la composition et le sujet sont déjà fixés par l'image ; le texte ne sert qu'à décrire le mouvement et la caméra.
video-to-video
L'entrée est une vidéo existante, la sortie est une vidéo réécrite. Convient au transfert de style, à la refonte de matériel et au retraitement de séquences existantes. C'est le parcours le plus sensible à la qualité du matériel source : la résolution, la fréquence d'images et la complexité du contenu de la vidéo d'entrée influencent tous la prévisibilité du résultat.
La règle empirique pour choisir le parcours est la suivante : si vous avez une vidéo, utilisez video-to-video ; si vous avez une image, utilisez image-to-video ; ce n'est qu'en l'absence de tout matériel qu'il faut recourir à text-to-video. Plus le matériel source est concret, plus la contrôlabilité est élevée, moins il y a d'essais et plus le coût est faible.
Comment se calcule la facturation à la seconde : modèle de coût à 0,25 $/seconde
flux-3-video est facturé au nombre de secondes de vidéo produite, au prix unitaire de 0,25 $/seconde. Le coût est strictement linéaire par rapport à la durée :
coût total = nombre de secondes produites × prix unitaire
Cette droite entraîne deux conséquences directes.
Premièrement, la durée est le premier levier de coût. Passer de 5 à 30 secondes multiplie le coût par six, au lieu d'être facturé « à la requête ». Pour établir un budget, ne raisonnez pas en nombre d'appels, mais en volume total de secondes : estimez la production journalière → convertissez-la en total de secondes → puis multipliez par le prix unitaire.
Deuxièmement, les tentatives répétées s'ajoutent directement au coût. Si une nouvelle tentative après échec a déjà produit des secondes de sortie, le coût est réellement engagé. Le modèle de coût doit donc prévoir un budget d'échec, et non supposer que chaque appel réussit du premier coup.
Quelques pistes de réduction des coûts, classées par rapport qualité-prix :
- Raccourcir la durée : validez d'abord le prompt et les paramètres avec la durée minimale utilisable, puis allongez une fois l'effet confirmé.
- Réduire les essais inutiles : versionnez les prompts, les images de référence et les paramètres pour éviter de déboguer plusieurs fois la même configuration.
- Fixer une durée maximale par scénario : limitez au niveau métier le nombre maximal de secondes par requête pour éviter qu'une entrée anormale ne déclenche une tâche trop longue.
- Distinguer aperçu et version finale : utilisez des durées courtes en phase de brouillon, puis générez la version complète une fois le résultat arrêté.
Pour le prix unitaire exact, référez-vous au panneau tarifaire du site ; pour la planification de capacité, convertissez selon les valeurs en temps réel affichées sur ce panneau.
Paramètres et conventions d'entrée à définir avant l'intégration
Avant d'écrire la première ligne de code, clarifiez le contrat : cela permet d'économiser beaucoup de retouches. Voici les catégories de points à préciser :
Durée et spécifications de sortie
La plage de durées prise en charge par requête, les résolutions et fréquences d'images disponibles, la manière de spécifier le rapport d'aspect : tout cela relève des limites de capacités du modèle et doit être confirmé dans la documentation officielle, sans supposition empirique. Les modèles vidéo imposent souvent des contraintes sur la taille d'entrée ; un dépassement peut entraîner un rejet ou un ajustement silencieux.
Conventions de forme du matériel d'entrée
Les trois modalités ont des exigences d'entrée différentes : longueur et langue du prompt textuel, format et dimensions de l'image de référence, encodage et limite de durée de la vidéo d'entrée doivent être vérifiés un par un. En particulier pour video-to-video, la vidéo d'entrée peut elle-même avoir une limite de secondes, ce qui affecte directement l'éventail de matériels traitables.
Mode d'obtention de la sortie
La vidéo est un gros fichier binaire, généralement non renvoyé directement dans le corps de la réponse, mais via une URL de résultat téléchargeable ou une référence au produit de la tâche. À l'intégration, vérifiez : la durée de validité de l'URL de résultat, la nécessité d'une authentification supplémentaire, la durée de conservation du fichier. Cela détermine votre stratégie de stockage : transfert immédiat vers votre propre stockage objet, ou dépendance à un lien temporaire.
Avantages d'une interface unifiée
Lors de l'intégration via l'interface unifiée de HiAPI.ai, le mode d'authentification, la soumission de tâches et l'obtention de résultats restent cohérents avec les autres modèles ; changer ou ajouter un modèle ne nécessite pas de réécrire la couche d'appel. Les noms de paramètres et les plages de valeurs restent fondés uniquement sur la documentation officielle ; cet article n'émet aucune supposition sur des champs non confirmés.
Orchestration des appels et gestion des échecs pour les tâches longues
La génération vidéo est une tâche asynchrone longue typique et ne peut être conçue comme une requête synchrone. La chaîne recommandée est en trois étapes : « soumettre → interroger → télécharger » :
1. Soumettre la tâche et obtenir l'identifiant de tâche
2. Interroger l'état de la tâche à intervalle fixe
3. Si l'état est réussi, télécharger le résultat et le transférer
4. Si l'état est échoué, décider selon la stratégie s'il faut réessayer
Phase de soumission
La requête de soumission doit comporter une clé d'idempotence (dérivable d'un ID unique côté métier) pour éviter les tâches en double lorsque le client renvoie une requête à cause d'une instabilité réseau. Après une soumission réussie, enregistrez immédiatement en base l'identifiant de tâche et les paramètres de requête : c'est la base de la réconciliation ultérieure.
Phase d'interrogation
L'interrogation doit suivre une stratégie de repli : intervalle initial court, allongement progressif à mesure que la durée augmente, avec un plafond de délai total. N'utilisez pas d'interrogation à haute fréquence fixe, qui gaspille les quotas et ne maîtrise pas les tâches à longue traîne. Concevez la machine d'état d'interrogation comme récupérable : après un redémarrage de processus, les tâches inachevées doivent pouvoir être extraites de la base pour continuer le suivi.
Délais d'attente et nouvelles tentatives
Distinguez deux types d'échecs :
- Échecs réessayables : erreurs réseau, limitation de débit, indisponibilité temporaire du serveur. Ceux-ci doivent être réessayés avec un repli exponentiel et un nombre maximal de tentatives.
- Échecs non réessayables : paramètres invalides, matériel d'entrée non conforme, contenu refusé. Réessayer n'a pas de sens et ne fait qu'amplifier le coût ; l'erreur doit être renvoyée directement à l'appelant pour correction.
Traitement du résultat
Après un rappel de succès ou l'obtention de l'état réussi par interrogation, transférez immédiatement la vidéo vers votre propre stockage et ne dépendez pas durablement d'un lien temporaire. L'échec du transfert doit également faire l'objet d'une nouvelle tentative distincte, pour éviter qu'une tâche réussie ne perde son produit.
Coûts cachés des nouvelles tentatives et des appels inutiles
La facturation à la seconde combinée aux nouvelles tentatives asynchrones est une combinaison courante de dérive des coûts. Deux types de dépenses cachées méritent une attention particulière :
Les tâches ayant produit des secondes mais jugées en échec. Certains échecs surviennent en cours de génération, alors que le coût est déjà engagé. Si votre stratégie de nouvelle tentative ne distingue pas les types d'échec, ces tâches seront relancées à répétition et la dépense augmentera de façon exponentielle.
Les appels inutiles dus à une validation insuffisante des paramètres. Durée hors limite, format de matériel non conforme, prompt vide : ces problèmes auraient pu être bloqués côté client, mais échouent après un cycle complet côté serveur.
Il existe quatre moyens de contrôle :
- Clé d'idempotence : une même requête métier ne doit autoriser qu'une seule tâche valide, pour éliminer la double facturation causée par un renvoi client.
- Budget d'échec : fixez à chaque ligne métier un quota total de nouvelles tentatives (en secondes ou en nombre), au-delà duquel on déclenche un disjoncteur et une alerte, plutôt que de réessayer indéfiniment.
- Validation préalable : validez côté client la plage de durées, le format et la taille du matériel, les champs obligatoires, afin de bloquer hors facturation les requêtes manifestement invalides.
- Journal des appels : enregistrez pour chaque soumission les paramètres de requête, l'identifiant de tâche, l'état final et les secondes produites, puis synthétisez chaque jour un rapport de coûts. Sans journal, impossible d'identifier quels types de requêtes coûtent cher.
Une pratique utile consiste à suivre en continu l'indicateur de santé « secondes produites avec succès ÷ total de secondes consommées ». Si ce ratio baisse, cela signifie que les nouvelles tentatives ou le gaspillage augmentent.
Scénarios de mise en œuvre typiques et liste des bonnes pratiques
Tableau des scénarios
- text-to-video : brouillons de films conceptuels marketing, prévisualisation de storyboards, exploration de contenus courts pour réseaux sociaux. Convient aux équipes partant de zéro.
- image-to-video : animation de photos produit e-commerce, transformation d'affiches en vidéos courtes, animation de designs de personnages. Convient aux marques disposant déjà d'actifs visuels.
- video-to-video : refonte de style de matériel existant, rajeunissement d'anciennes vidéos, réécriture en plusieurs versions. Convient aux équipes de contenu disposant d'une bibliothèque de vidéos.
Liste de vérification avant mise en production
- Un modèle de coût a été établi sur la base des secondes produites, avec un budget d'échec intégré
- La durée maximale par requête est limitée au niveau métier
- La chaîne d'appel est conçue comme une tâche asynchrone, avec repli d'interrogation et plafond de délai
- Les requêtes de soumission comportent une clé d'idempotence, un renvoi ne crée pas de tâche en double
- Les échecs sont traités par catégorie : réessayables et non réessayables
- La vidéo de résultat est immédiatement transférée vers votre propre stockage, sans dépendre d'un lien temporaire
- Chaque appel est journalisé, avec synthèse quotidienne des secondes produites et des coûts
- Les noms de paramètres et les plages de valeurs ont été confirmés dans la documentation officielle, sans champ supposé
Rythme de mise en œuvre
Commencez par valider la chaîne de bout en bout avec la durée la plus courte et un seul parcours, confirmez que le prompt et les paramètres produisent une vidéo stable, puis élargissez progressivement la durée et la résolution, et enfin seulement passez à la production en masse. Cet ordre permet de fonder chaque montée en charge sur des effets déjà validés.
Du point de vue des limites de capacités, la valeur de flux-3-video réside dans la couverture de trois modalités d'entrée par un seul modèle ; du point de vue de l'ingénierie, le véritable obstacle se situe dans l'orchestration asynchrone et la discipline de coûts. Pour commencer par valider la chaîne, vous pouvez lancer une courte tâche depuis la page du modèle sur HiAPI.ai.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax