
Benutzerhandbuch
flux-3-video 上手指南:能力边界、API 接入与成本控制
Von Text-to-Video bis Video-to-Video:Fähigkeiten, Preise und Integrationspunkte aus Entwicklersicht
Was ist flux-3-video und für wen ist es geeignet
flux-3-video ist ein von Black Forest Labs entwickeltes Videogenerierungsmodell, dessen Ausgabetyp eine reine Videodatei ist. Es deckt drei Eingabemodalitäten auf einmal ab: Text-to-Video, Image-to-Video und Video-to-Video. Das bedeutet, dass du nicht für die beiden Situationen „kein Material“ und „vorhandenes Material“ jeweils ein separates Modell suchen musst – dasselbe Modell kann sowohl die Generierung von Grund auf als auch die Bearbeitung auf Basis von Material übernehmen.
Ob es zur gewünschten Modellkategorie gehört, lässt sich anhand von drei Fragen beurteilen:
- Benötigt dein Produkt Video als Ergebnis und nicht Bild oder Text? Wenn du nur statisches Material brauchst, sind Bildmodelle günstiger und schneller.
- Fällt dein Material in eine der drei Kategorien Text, Bild oder Video? Solange eine davon erfüllt ist, gibt es einen passenden Einstieg.
- Kannst du die langlaufende asynchrone Aufrufform akzeptieren? Videogenerierung ist keine Anfrage im Millisekundenbereich; die Pipeline muss als asynchrone Aufgabe konzipiert sein.
Für Teams, die Marketingmaterial in großem Umfang produzieren, Kurzvideostücke entwerfen oder Material stilistisch umarbeiten, spart ein Modell mit Unterstützung aller drei Modalitäten in der Regel Integrationskosten im Vergleich zum Zusammensetzen mehrerer Spezialmodelle. Für Szenarien, die extrem latenzempfindlich sind und Echtzeitantworten erfordern, ist es dagegen nicht für die direkte Integration geeignet.
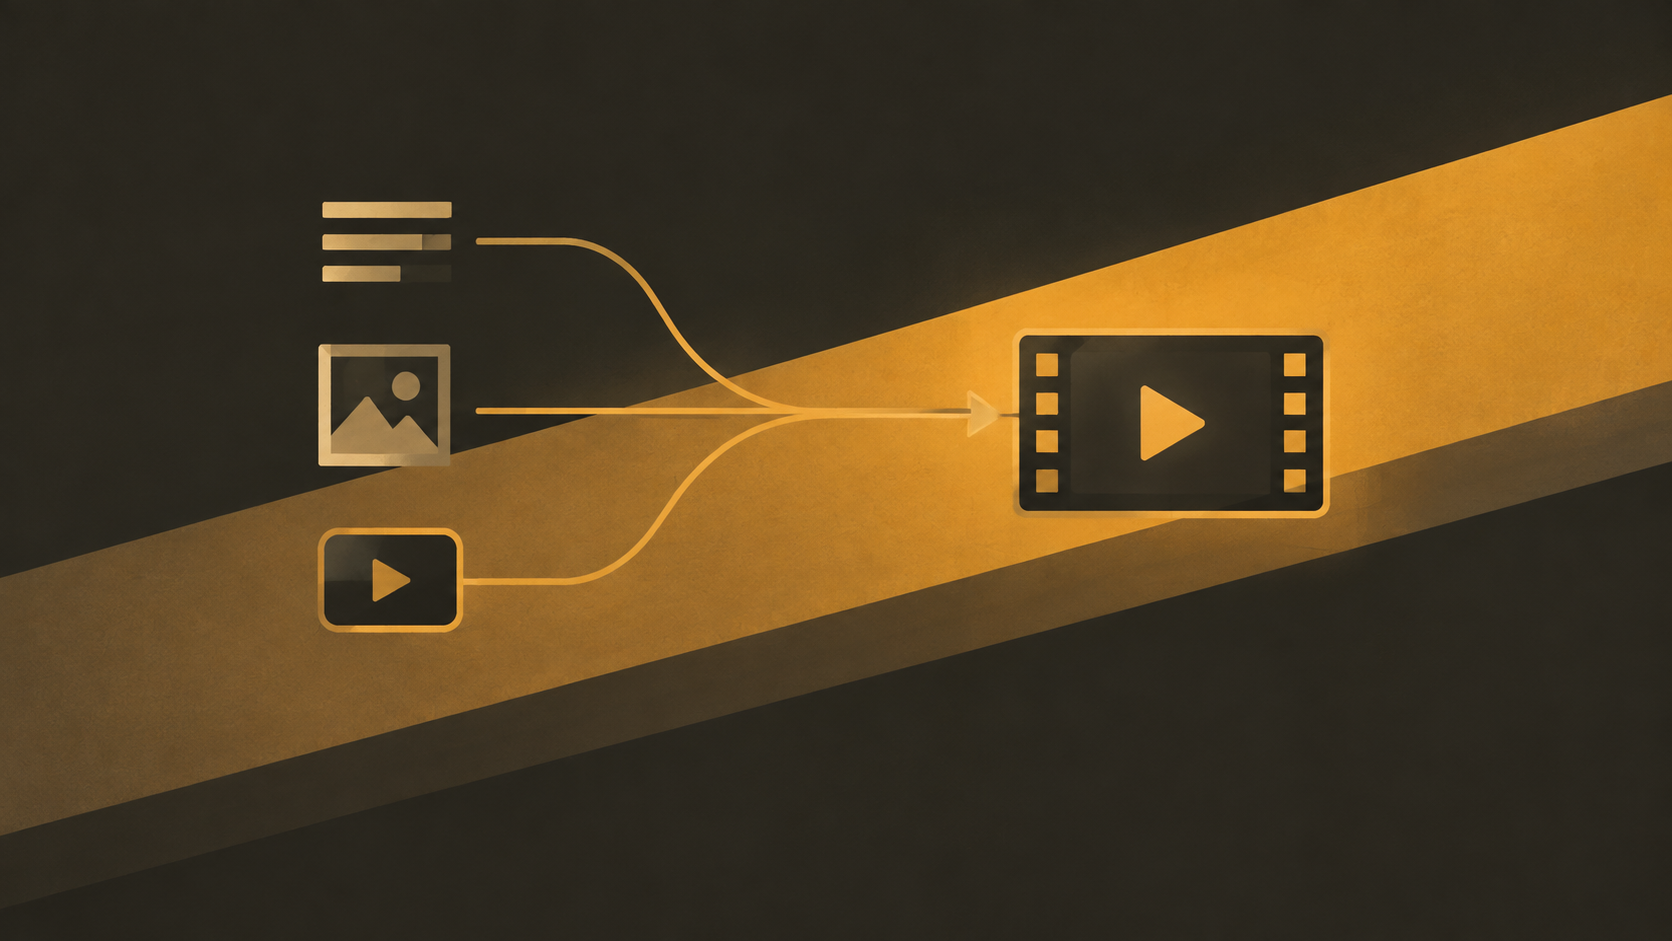
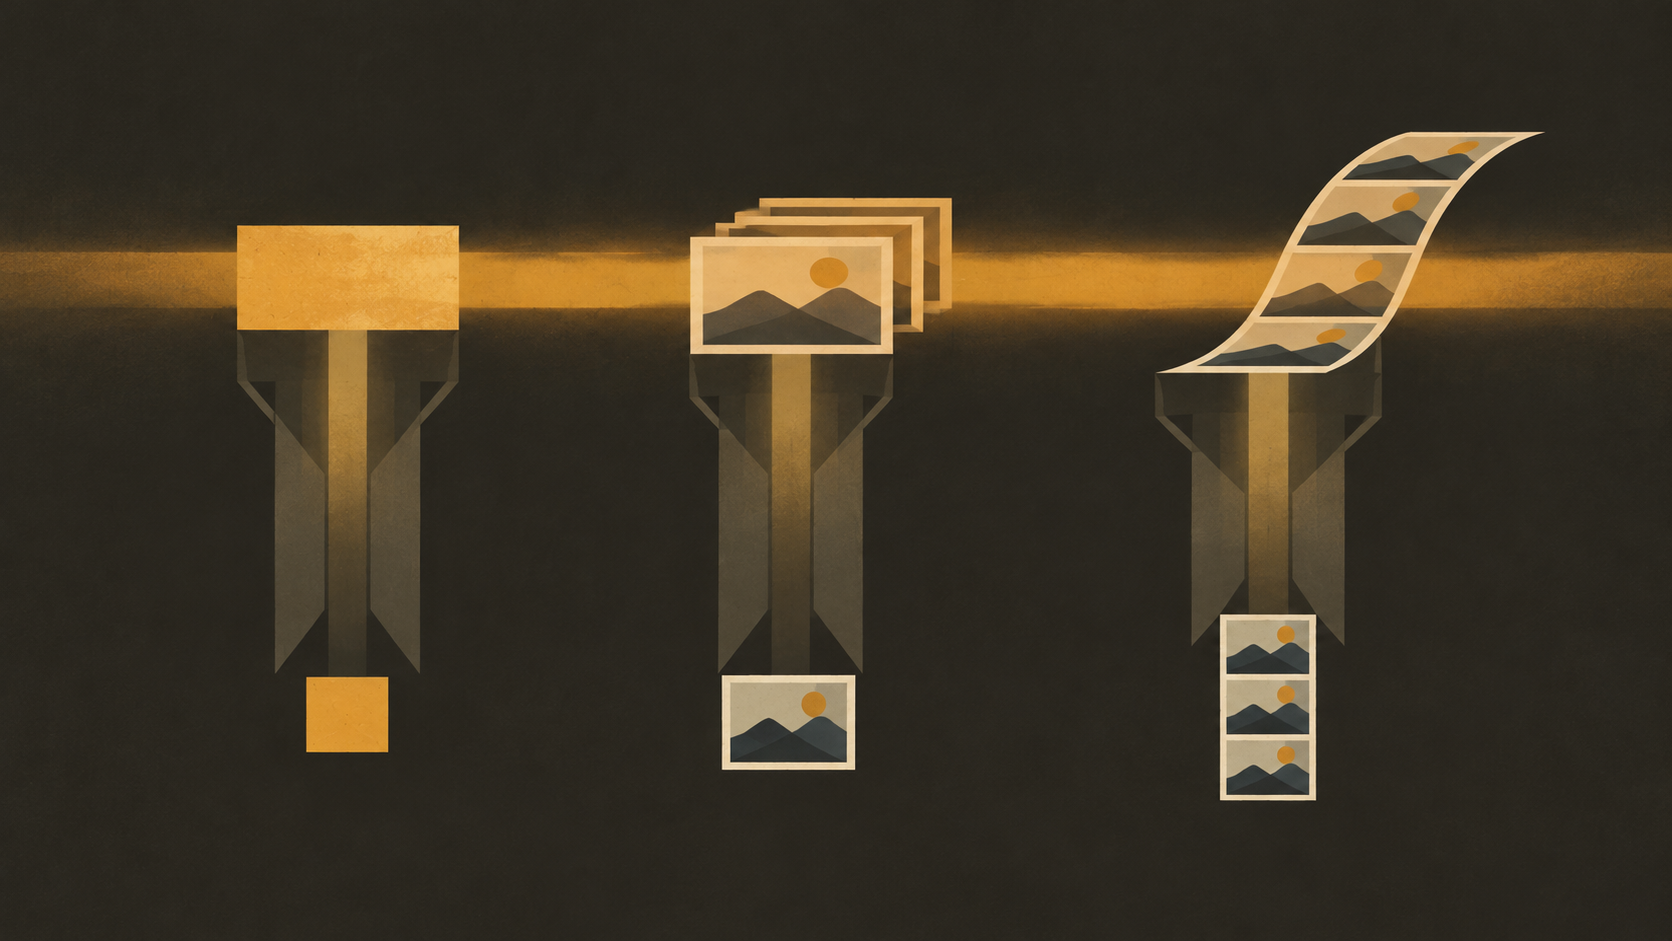
Drei Generierungspfade: Text-to-Video, Image-to-Video und Video-to-Video
Der Unterschied zwischen den drei Einstiegen liegt darin, was du bereits hast und was das Modell ergänzen soll.
Text-to-Video
Die Eingabe ist ein Text-Prompt, die Ausgabe ein völlig neues Video. Geeignete Szenarien sind Konzeptdemonstrationen, Storyboard-Entwürfe und kreative Erkundung ohne vorhandenes Material. Der Vorteil ist die Unabhängigkeit von jeglichem Ausgangsmaterial, der Nachteil die schwächste Steuerbarkeit – die Bilddetails werden vollständig vom Prompt gelenkt, und es braucht mehrere Testläufe, um sich den Erwartungen zu nähern.
Image-to-Video
Die Eingabe ist ein Referenzbild plus Text-Prompt, die Ausgabe ein dynamisches Video, das von diesem Bild ausgehend erweitert wird. Geeignet für Szenarien, in denen ein fertiges Bild (Produktaufnahme, Poster, Charakterdesign) „in Bewegung“ gebracht werden soll. Im Vergleich zu Text-to-Video ist die visuelle Konsistenz besser gesichert, da Komposition und Motiv bereits durch das Bild festgelegt sind und der Text nur Bewegung und Kameraführung beschreibt.
Video-to-Video
Die Eingabe ist ein vorhandenes Video, die Ausgabe ein umgeschriebenes Video. Geeignet für Stiltransfer, Material-Neuerstellung und die Nachbearbeitung bestehender Sequenzen. Es reagiert am empfindlichsten auf die Qualität des Ausgangsmaterials: Auflösung, Bildrate und inhaltliche Komplexität des Eingabevideos beeinflussen die Vorhersehbarkeit des Ergebnisses.
Die Faustregel für die Pfadwahl lautet: Wenn du ein Video hast, nutze Video-to-Video; wenn du ein Bild hast, nutze Image-to-Video; nur wenn du nichts hast, nutze Text-to-Video. Je konkreter das Material, desto höher die Steuerbarkeit, desto weniger Testläufe und desto niedriger die Kosten.
Wie die sekundenbasierte Abrechnung funktioniert: Kostenmodell bei $0,25/Sekunde
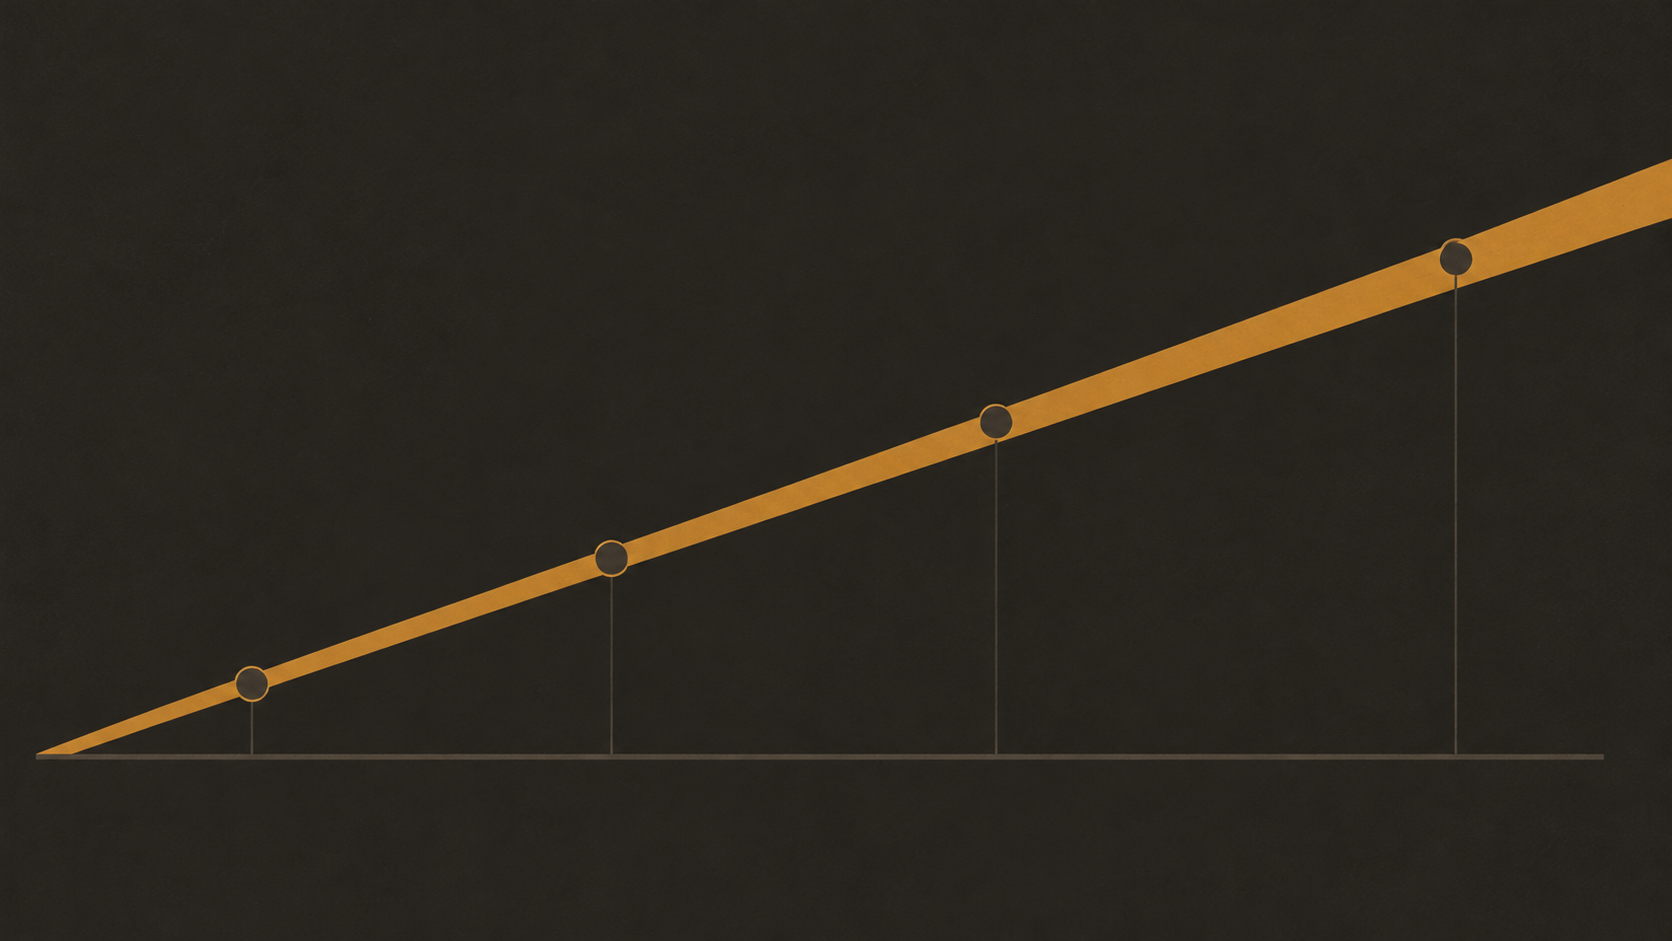
flux-3-video rechnet nach Sekunden des Ausgabevideos ab, der Stückpreis beträgt $0,25/Sekunde. Die Kosten stehen in streng linearer Beziehung zur Dauer:
Gesamtkosten = Ausgabesekunden × Stückpreis
Diese Gerade führt zu zwei unmittelbaren Schlussfolgerungen.
Erstens ist die Dauer der wichtigste Kostenhebel. Von 5 Sekunden auf 30 Sekunden bedeutet eine Versechsfachung der Kosten, nicht eine Abrechnung pro „Anfrage“. Bei der Budgetierung sollte nicht nach Aufrufanzahl geschätzt werden, sondern nach Gesamtsekundenzahl: geschätzte Tagesproduktion → Umrechnung in Gesamtsekunden → Multiplikation mit dem Stückpreis.
Zweitens addieren sich Wiederholungen direkt zu den Kosten. Wenn ein fehlgeschlagener Wiederholungslauf bereits Ausgabesekunden erzeugt hat, sind die Kosten tatsächlich entstanden. Daher muss das Kostenmodell ein Fehlerbudget vorsehen, statt anzunehmen, dass jeder Aufruf beim ersten Versuch erfolgreich ist.
Einige Richtungen zur Kostensenkung, nach Preis-Leistungs-Verhältnis geordnet:
- Dauer verkürzen: Zuerst mit der kürzesten nutzbaren Dauer Prompt und Parameter validieren, nach Bestätigung des Ergebnisses verlängern.
- Unnötige Testläufe reduzieren: Prompt, Referenzbild und Parameter versionieren, um wiederholtes Debuggen derselben Konfiguration zu vermeiden.
- Dauerobergrenzen je Szenario festlegen: Auf Geschäftsebene die maximale Sekundenzahl pro Anfrage begrenzen, um zu verhindern, dass fehlerhafte Eingaben überlange Aufgaben auslösen.
- Vorschau und Endprodukt trennen: In der Entwurfsphase kurze Dauer verwenden, nach der Finalisierung die vollständige Version generieren.
Der konkrete Stückpreis richtet sich nach dem Preispaneel der Website; bei der Kapazitätsplanung ist die dort tagesaktuelle Angabe maßgeblich.
Parameter und Eingabekonventionen, die vor der Integration festgelegt werden müssen
Bevor du die erste Codezeile schreibst, solltest du den Vertrag klarstellen – das spart viel Nacharbeit. Einige Punkte müssen eindeutig geklärt werden:
Dauer und Ausgabespezifikationen
Welcher Dauerbereich pro Anfrage unterstützt wird, welche Auflösungen und Bildraten wählbar sind und wie das Seitenverhältnis angegeben wird – all das gehört zu den Fähigkeitsgrenzen des Modells und muss anhand der offiziellen Dokumentation bestätigt werden; verlasse dich nicht auf Erfahrungswerte. Videomodelle haben oft Einschränkungen bei den Eingabegrößen; Überschreitungen können abgelehnt oder stillschweigend angepasst werden.
Konventionen für Eingabematerial
Die drei Modalitäten haben unterschiedliche Anforderungen an die Eingabe: Länge und Sprache des Text-Prompts, Format und Größe des Referenzbilds, Kodierung und Dauerbeschränkung des Eingabevideos – alles muss einzeln geprüft werden. Besonders bei Video-to-Video kann das Eingabevideo selbst eine Sekundenobergrenze haben, was den Umfang des verarbeitbaren Materials direkt beeinflusst.
Wie die Ausgabe abgerufen wird
Videos sind große Binärdateien und werden üblicherweise nicht direkt im Antwortkörper eingebettet zurückgegeben, sondern als herunterladbare Ergebnisadresse oder Aufgabenprodukt-Referenz. Bei der Integration muss geklärt werden: Gültigkeitsdauer der Ergebnisadresse, ob zusätzliche Authentifizierung erforderlich ist, wie lange die Datei aufbewahrt wird. Das bestimmt deine Speicherstrategie – sofortige Übertragung in deinen eigenen Objektspeicher oder Abhängigkeit von temporären Links.
Vorteile einer einheitlichen Schnittstelle
Bei der Integration über die einheitliche Schnittstelle von HiAPI.ai bleiben Authentifizierungsmethode sowie Aufrufform für Aufgabenübermittlung und Ergebnisabruf konsistent mit anderen Modellen; ein Wechsel oder Hinzufügen von Modellen erfordert kein Umschreiben der Aufrufschicht. Parameternamen und Wertebereiche richten sich weiterhin ausschließlich nach der offiziellen Dokumentation; dieser Artikel spekuliert nicht über unbestätigte Felder.
Aufruforchestrierung und Fehlerbehandlung bei langlaufenden Aufgaben
Videogenerierung ist eine typische asynchrone Langlaufaufgabe und darf nicht als synchrone Anfrage konzipiert werden. Empfohlen wird eine dreistufige Kette „Übermitteln → Abfragen → Herunterladen“:
1. Aufgabe übermitteln und Aufgabenkennung erhalten
2. Aufgabenstatus in festen Intervallen abfragen
3. Bei Status Erfolg: Ergebnis herunterladen und übertragen
4. Bei Status Fehler: je nach Strategie über Wiederholung entscheiden
Übermittlungsphase
Die Übermittlungsanfrage sollte einen Idempotenzschlüssel enthalten (ableitbar aus einer eindeutigen Geschäfts-ID), um zu verhindern, dass Netzwerkstörungen beim erneuten Senden durch den Client doppelte Aufgaben erzeugen. Nach erfolgreicher Übermittlung sofort Aufgabenkennung und Anfrageparameter in der Datenbank speichern – das ist die Grundlage für die spätere Abgleichsprüfung.
Abfragephase
Die Abfrage braucht eine Backoff-Strategie: kurzes Anfangsintervall, mit zunehmender Dauer schrittweise verlängern und eine Gesamt-Timeout-Obergrenze festlegen. Keine feste hochfrequente Abfrage verwenden – das verschwendet Kontingent und hält Langschwanzaufgaben nicht im Griff. Der Abfrage-Zustandsautomat sollte wiederaufnehmbar sein – nach einem Prozessneustart müssen unvollendete Aufgaben aus der Datenbank geholt und weiterverfolgt werden können.
Timeout und Wiederholung
Zwei Arten von Fehlern unterscheiden:
- Wiederholbare Fehler: Netzwerkfehler, Ratenbegrenzung, vorübergehende Nichtverfügbarkeit des Dienstes. Diese sollten mit exponentiellem Backoff wiederholt werden, mit einer Höchstanzahl.
- Nicht wiederholbare Fehler: ungültige Parameter, nicht konformes Eingabematerial, abgelehnter Inhalt. Eine Wiederholung ist hier sinnlos und erhöht nur die Kosten; der Fehler sollte direkt an den Aufrufer zur Korrektur weitergegeben werden.
Ergebnisverarbeitung
Nach erfolgreichem Callback oder erfolgreichem Abfragestatus das Video sofort in den eigenen Speicher übertragen und sich nicht langfristig auf temporäre Links verlassen. Auch die Übertragung selbst muss separat wiederholt werden, damit eine erfolgreiche Aufgabe nicht wegen eines verlorenen Produkts scheitert.
Versteckte Kosten durch Wiederholungen und unwirksame Aufrufe
Sekundenbasierte Abrechnung kombiniert mit asynchronen Wiederholungen ist eine häufige Kombination für außer Kontrolle geratende Kosten. Zwei Arten versteckter Ausgaben verdienen besondere Aufmerksamkeit:
Aufgaben, die bereits Sekunden erzeugt haben, aber als fehlgeschlagen gelten. Manche Fehler treten während der Generierung auf, die Kosten sind bereits entstanden. Wenn deine Wiederholungsstrategie Fehlertypen nicht unterscheidet, werden solche Aufgaben wiederholt neu ausgeführt und die Ausgaben wachsen um ein Vielfaches.
Unwirksame Aufrufe durch unzureichende Parametervalidierung. Dauerüberschreitung, nicht passendes Materialformat, leerer Prompt – diese Probleme hätten clientseitig abgefangen werden können, scheitern aber erst nach einem vollständigen Durchlauf auf dem Server.
Es gibt vier Kontrollmaßnahmen:
- Idempotenzschlüssel: Pro Geschäftsanfrage darf nur eine gültige Aufgabe existieren, um doppelte Abrechnung durch erneutes Senden des Clients auszuschließen.
- Fehlerbudget: Für jede Geschäftslinie ein Gesamtwiederholungskontingent (nach Sekunden oder Anzahl) festlegen; bei Überschreitung Schmelzsicherung und Alarm statt endloser Wiederholungen.
- Vorabvalidierung: Vor der Übermittlung clientseitig Dauerbereich, Materialformat und -größe sowie Pflichtfelder prüfen, um offensichtlich ungültige Anfragen von der Abrechnung fernzuhalten.
- Aufrufprotokoll: Anfrageparameter, Aufgabenkennung, Endstatus und Ausgabesekunden jedes Aufrufs erfassen und täglich zu einem Kostenbericht zusammenfassen. Ohne Protokoll lässt sich nicht feststellen, welche Art von Anfragen Geld verbrennt.
Eine praktische Vorgehensweise ist, „Sekunden pro erfolgreicher Ausgabe ÷ insgesamt verbrauchte Sekunden“ als Gesundheitskennzahl zu verwenden und kontinuierlich zu verfolgen. Sinkt dieses Verhältnis, nehmen Wiederholungen oder Verschwendung zu.
Typische Einsatzszenarien und Best-Practice-Checkliste
Szenariovergleich
- Text-to-Video: Entwürfe für Marketing-Konzeptfilme, Storyboard-Previsualisierung, Erkundung von Kurzinhalten für soziale Medien. Geeignet für Teams, die ohne Material beginnen.
- Image-to-Video: Dynamisierung von E-Commerce-Produktbildern, Umwandlung von Postern in Kurzvideos, Belebung von Charakterdesigns. Geeignet für Markeninhaber mit vorhandenen visuellen Assets.
- Video-to-Video: Stilistische Neuerstellung vorhandenen Materials, Auffrischung alter Filme, Stapelumwandlung in mehrere Versionen. Geeignet für Content-Teams mit einer Videomaterialbibliothek.
Selbstprüfliste vor dem Go-live
- Kostenmodell nach Ausgabesekunden aufgestellt und Fehlerbudget eingerechnet
- Maximale Dauer pro Anfrage auf Geschäftsebene begrenzt
- Aufrufkette als asynchrone Aufgabe konzipiert, mit Abfrage-Backoff und Timeout-Obergrenze
- Übermittlungsanfrage mit Idempotenzschlüssel, erneutes Senden erzeugt keine doppelten Aufgaben
- Fehler nach wiederholbar und nicht wiederholbar klassifiziert behandelt
- Ergebnisvideo sofort in eigenen Speicher übertragen, keine Abhängigkeit von temporären Links
- Jeder Aufruf wird protokolliert, tägliche Zusammenfassung von Ausgabesekunden und Kosten möglich
- Parameternamen und Wertebereiche anhand der offiziellen Dokumentation bestätigt, keine spekulativen Felder
Einführungsrhythmus
Zunächst mit kürzester Dauer und einem einzigen Pfad die End-to-End-Kette zum Laufen bringen, bestätigen, dass Prompt und Parameter stabil Videos erzeugen, dann schrittweise Dauer und Auflösung freigeben und erst zuletzt die Serienproduktion anschließen. Diese Reihenfolge sorgt dafür, dass jede Skalierung auf bereits validierten Ergebnissen aufbaut.
Aus Sicht der Fähigkeitsgrenzen liegt der Wert von flux-3-video darin, dass ein Modell drei Eingabemodalitäten abdeckt; aus technischer Sicht liegt die eigentliche Hürde in der asynchronen Orchesterierung und der Kostendisziplin. Wer zuerst die Kette zum Laufen bringen will, kann auf der Modellseite von HiAPI.ai mit einer kurzen Aufgabe starten.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte