
Guida all'uso
Guida introduttiva a flux-3-video: limiti delle capacità, integrazione API e controllo dei costi
Dal text-to-video al video-to-video: capacità, prezzi e punti chiave di integrazione dal punto di vista dello sviluppatore
Che cos'è flux-3-video e a chi è destinato
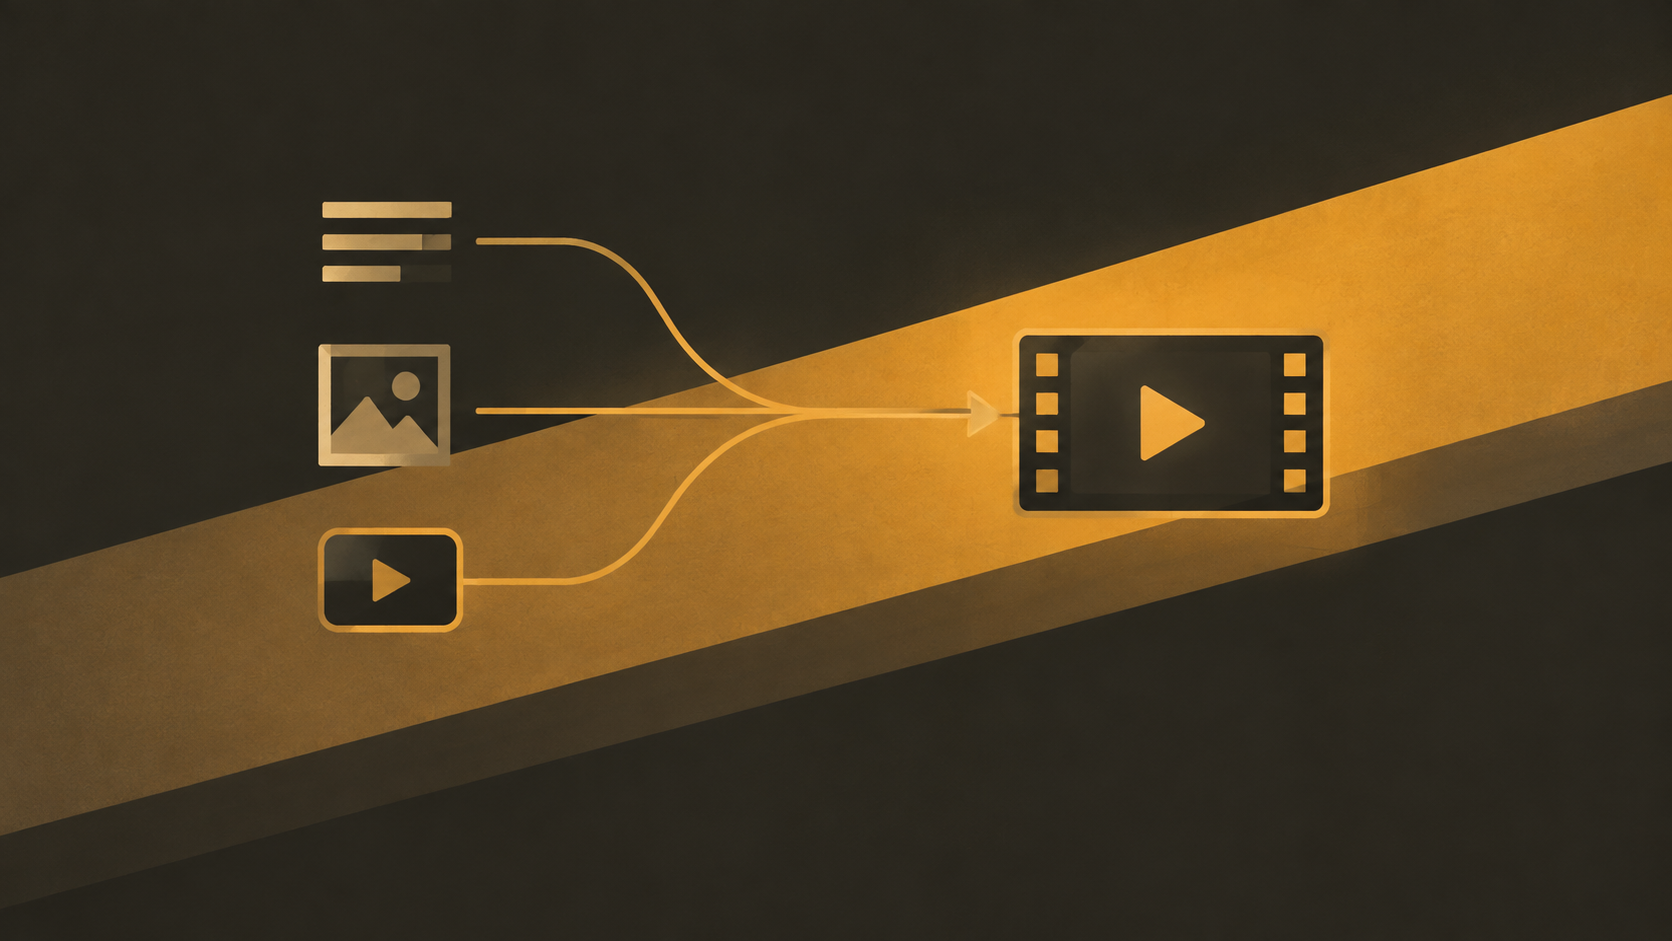
flux-3-video è un modello di generazione video lanciato da Black Forest Labs, il cui tipo di output è un semplice file video. Copre in un'unica soluzione tre modalità di input: text-to-video, image-to-video e video-to-video. Ciò significa che non devi cercare modelli diversi per le due situazioni «senza materiale» e «con materiale già disponibile»: lo stesso modello può gestire sia la generazione da zero sia la riscrittura basata su materiale esistente.
Per capire se appartiene alla categoria di modello che cerchi, puoi farti tre domande:
- Il tuo prodotto richiede un video come output, e non immagini o testo? Se ti servono solo materiali statici, un modello per immagini è più economico e più veloce.
- Le condizioni del tuo materiale rientrano in una delle tre categorie text, image, video? Basta soddisfarne una per avere un ingresso corrispondente.
- Puoi accettare una modalità di chiamata asincrona e a lunga durata? La generazione video non è una richiesta da millisecondi: la catena va progettata come task asincrono.
Per i team che producono materiali marketing in massa, generano bozze di video brevi o riscrivono lo stile dei materiali, un modello che supporta contemporaneamente le tre modalità di solito riduce i costi di integrazione rispetto all'assemblaggio di più modelli specializzati. Per scenari estremamente sensibili alla latenza che richiedono risposte in tempo reale, invece, non è adatto all'integrazione diretta.
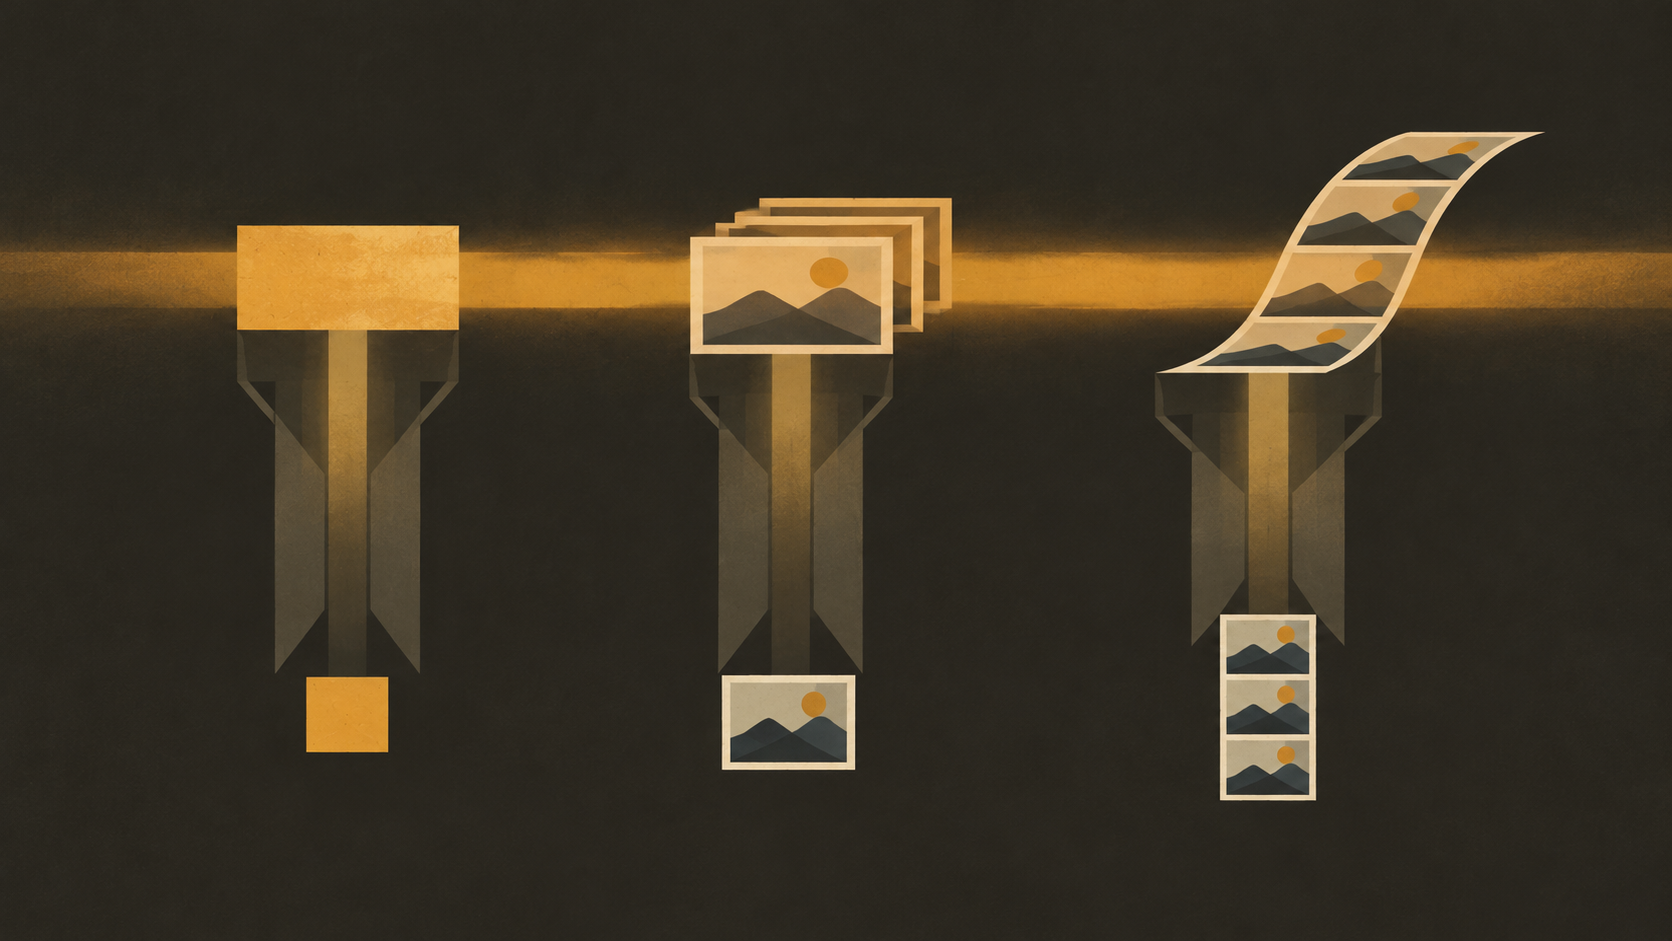
Tre percorsi di generazione: text-to-video, image-to-video e video-to-video
La differenza tra i tre ingressi sta in ciò che hai già a disposizione e in ciò che vuoi che il modello completi.
text-to-video
L'input è un prompt testuale, l'output è un video completamente nuovo. Gli scenari d'uso includono dimostrazioni concettuali, bozze di storyboard ed esplorazione creativa partendo da zero. Il vantaggio è che non dipende da alcun materiale preesistente; lo svantaggio è che il controllo è minimo: i dettagli delle immagini sono guidati interamente dal prompt e servono più tentativi per avvicinarsi al risultato atteso.
image-to-video
L'input è un'immagine di riferimento più un prompt testuale, e l'output è un video dinamico che parte da quell'immagine. È adatto a scenari in cui un'immagine già definita (foto prodotto, poster, character design) deve «prendere vita». Rispetto al text-to-video, la coerenza visiva è più garantita, perché composizione e soggetto sono già fissati dall'immagine e il testo descrive solo il movimento e la ripresa.
video-to-video
L'input è un video esistente, l'output è il video riscritto. È adatto al trasferimento di stile, al rifacimento di materiali e alla rielaborazione di clip già esistenti. È il più sensibile alla qualità del materiale a monte: risoluzione, frame rate e complessità del contenuto del video di input influenzano la prevedibilità del risultato.
La regola empirica per scegliere il percorso è: se hai un video usa video-to-video, se hai un'immagine usa image-to-video, solo se non hai nulla usa text-to-video. Più il materiale è concreto, maggiore è il controllo, minori sono i tentativi e più basso è il costo.
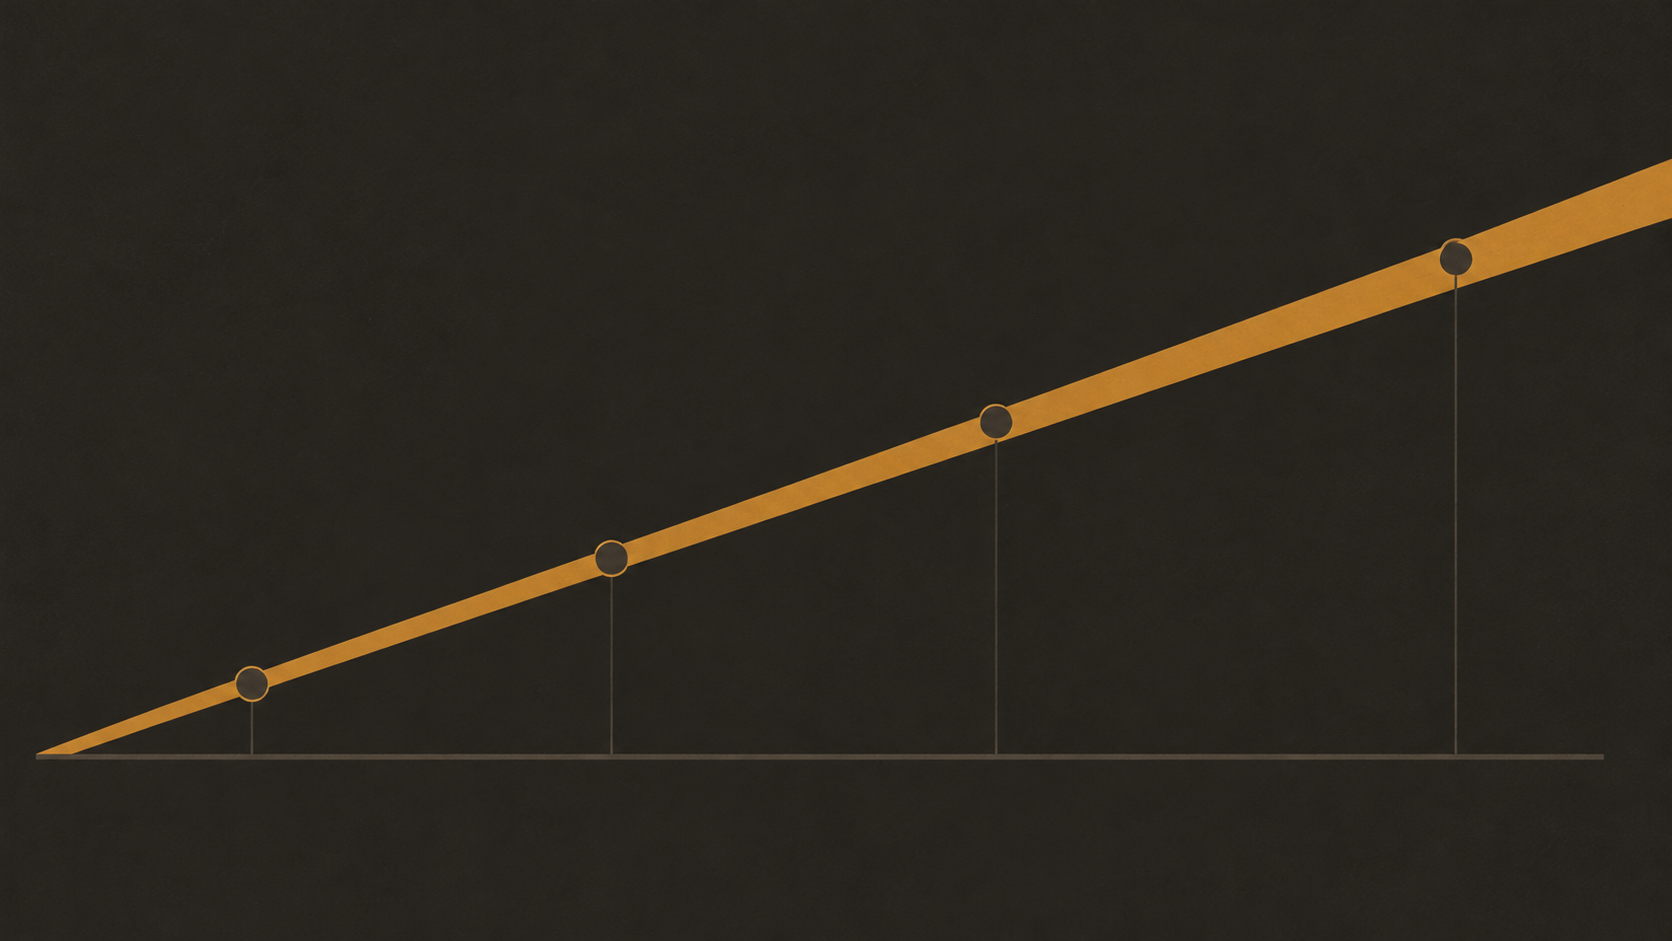
Come si calcola la fatturazione al secondo: modello di costo a $0,25/secondo
flux-3-video fattura in base ai secondi di video prodotto, con un prezzo unitario di $0,25/secondo. Il costo è in relazione strettamente lineare con la durata:
costo totale = secondi di output × prezzo unitario
Questa linea retta porta a due conseguenze dirette.
Primo: la durata è la prima leva sul costo. Passando da 5 secondi a 30 secondi, il costo si moltiplica per sei, non si fattura «a richiesta». Quando fai budget non stimare in base al numero di chiamate, ma in base al totale dei secondi: stima la produzione giornaliera → convertila in secondi totali → moltiplica per il prezzo unitario.
Secondo: i tentativi ripetuti si sommano direttamente al costo. Se una riesecuzione dopo un errore ha già prodotto secondi di output, il costo si è realmente verificato. Perciò nel modello di costo devi prevedere un budget per gli errori, invece di assumere che ogni chiamata vada a buon fine al primo colpo.
Alcune direzioni per ridurre i costi, ordinate per rapporto qualità-prezzo:
- Accorcia la durata: verifica prima prompt e parametri con la durata minima utilizzabile, poi allunga una volta confermato il risultato.
- Riduci i tentativi inutili: versiona prompt, immagini di riferimento e parametri per evitare di ripetere il debug della stessa configurazione.
- Imposta un limite massimo di durata per scenario: limita a livello di business i secondi massimi per singola richiesta, per evitare che input anomali attivino task troppo lunghi.
- Distingui anteprima e versione finale: usa durate brevi in fase di bozza e genera la versione completa solo dopo la definizione.
Per il prezzo unitario effettivo fai riferimento al pannello prezzi del sito e, per la pianificazione della capacità, converti secondo i valori in tempo reale indicati nel pannello.
Parametri e convenzioni di input da definire prima dell'integrazione
Prima di scrivere la prima riga di codice, chiarisci bene il contratto: ti risparmierà molto lavoro di rifacimento. Ecco le categorie di aspetti da definire:
Durata e specifiche di output
L'intervallo di durata supportato per singola richiesta, le risoluzioni e i frame rate disponibili, come specificare il rapporto d'aspetto: questi sono limiti delle capacità del modello e vanno confermati sulla documentazione ufficiale, senza ipotesi basate sull'esperienza. I modelli video hanno spesso vincoli sulle dimensioni di input; valori fuori intervallo possono essere rifiutati o modificati silenziosamente.
Convenzioni sulla forma dei materiali di input
Le tre modalità hanno requisiti di input diversi: lunghezza e lingua del prompt testuale, formato e dimensioni dell'immagine di riferimento, codifica e limiti di durata del video di input vanno verificati uno per uno. In particolare per il video-to-video, anche il video di input può avere un limite di secondi, il che influisce direttamente sulla gamma di materiali trattabili.
Come ottenere l'output
Il video è un file binario di grandi dimensioni e di solito non viene restituito direttamente nel corpo della risposta, ma tramite un indirizzo di risultato scaricabile o un riferimento al prodotto del task. In fase di integrazione verifica: la validità dell'indirizzo del risultato, se serve un'autenticazione aggiuntiva e per quanto tempo il file viene conservato. Questo determina la tua strategia di archiviazione: trasferire subito nel tuo object storage o affidarti a link temporanei.
I vantaggi dell'interfaccia unificata
Integrando tramite l'interfaccia unificata di HiAPI.ai, modalità di autenticazione, invio del task e recupero del risultato restano coerenti con gli altri modelli, e cambiare o aggiungere modelli non richiede di riscrivere il livello di chiamata. I nomi dei parametri e gli intervalli di valori restano basati esclusivamente sulla documentazione ufficiale; questo articolo non fa supposizioni su campi non confermati.
Orchestrazione delle chiamate e gestione degli errori per task a lunga durata
La generazione video è un tipico task asincrono a lunga durata e non può essere progettata come una richiesta sincrona. La catena consigliata è in tre fasi: «invio → polling → download»:
1. Invia il task e ottieni l'identificativo del task
2. Esegui il polling dello stato del task a intervalli regolari
3. Se lo stato è di successo, scarica il risultato e trasferiscilo
4. Se lo stato è di errore, decidi secondo la strategia se riprovare
Fase di invio
La richiesta di invio deve includere una chiave di idempotenza (derivabile da un ID univoco lato business) per evitare che un re-invio del client dovuto a problemi di rete generi task duplicati. Dopo l'invio, registra subito su database l'identificativo del task e i parametri della richiesta: è la base per la successiva riconciliazione.
Fase di polling
Il polling deve avere una strategia di backoff: intervallo iniziale breve, allungato progressivamente con l'aumentare della durata, con un limite massimo di timeout totale. Non usare polling fisso ad alta frequenza: spreca quota e non gestisce i task con coda lunga. Rendi la macchina a stati del polling ripristinabile: dopo un riavvio del processo deve poter recuperare dal database i task non completati e continuare a monitorarli.
Timeout e tentativi
Distingui due tipi di errore:
- Errori ritentabili: errori di rete, limitazione di frequenza, indisponibilità temporanea del server. Vanno ritentati con backoff esponenziale e un numero massimo di tentativi.
- Errori non ritentabili: parametri non validi, materiale di input non conforme, contenuto rifiutato. Ritentare non ha senso e aumenta solo i costi: l'errore va restituito direttamente al chiamante perché lo corregga.
Gestione del risultato
Dopo una callback di successo o dopo aver rilevato lo stato di successo tramite polling, trasferisci immediatamente il video nel tuo storage, senza affidarti a lungo a link temporanei. Anche il fallimento del trasferimento va ritentato separatamente, per evitare che un task riuscito perda il prodotto.
Costi nascosti dovuti a tentativi ripetuti e chiamate inutili
Fatturazione al secondo più tentativi asincroni è una combinazione frequente di costi fuori controllo. Due tipi di spese nascoste meritano attenzione separata:
Task che hanno già prodotto secondi ma vengono giudicati falliti. Alcuni errori avvengono durante la generazione, quando il costo si è già verificato. Se la strategia di retry non distingue i tipi di errore, questi task vengono rieseguiti più volte e la spesa cresce in modo esponenziale.
Chiamate inutili dovute a validazione insufficiente dei parametri. Durata fuori limite, formato del materiale non conforme, prompt vuoto: problemi che si potrebbero bloccare sul client, ma che falliscono solo dopo un ciclo completo lato server.
Gli strumenti di controllo sono quattro:
- Chiave di idempotenza: per la stessa richiesta business deve esistere un solo task valido, eliminando la doppia fatturazione causata dai re-invii del client.
- Budget per gli errori: assegna a ogni linea di business un tetto massimo di tentativi (in secondi o in numero), oltre il quale scatta il circuit breaker e l'allarme, invece di riprovare all'infinito.
- Validazione preventiva: prima dell'invio, valida sul client intervallo di durata, formato e dimensioni del materiale, campi obbligatori, tenendo fuori dalla fatturazione le richieste palesemente non valide.
- Log delle chiamate: registra per ogni invio i parametri della richiesta, l'identificativo del task, lo stato finale e i secondi prodotti, aggregandoli quotidianamente in un report dei costi. Senza log non puoi individuare quale tipo di richiesta sta bruciando budget.
Una pratica utile è assumere «secondi prodotti con successo ÷ secondi totali consumati» come indicatore di salute e monitorarlo nel tempo. Se questo rapporto cala, significa che aumentano i tentativi o gli sprechi.
Scenari tipici di applicazione e checklist delle best practice
Confronto degli scenari
- text-to-video: bozze di video concettuali marketing, previsualizzazione di storyboard, esplorazione di contenuti brevi per i social. Adatto a team che partono da zero con i materiali.
- image-to-video: animazione di foto prodotto per l'e-commerce, conversione di poster in video brevi, animazione di character design. Adatto a brand che hanno già asset visivi.
- video-to-video: riscrittura dello stile di materiali esistenti, rinnovo di vecchi filmati, riscrittura in batch di più versioni. Adatto a team di contenuti con una libreria di video.
Checklist di autoverifica prima del lancio
- È stato costruito un modello di costo basato sui secondi di output, includendo il budget per gli errori
- Il limite massimo di durata per singola richiesta è limitato a livello di business
- La catena di chiamate è progettata come task asincrono, con backoff del polling e limite massimo di timeout
- La richiesta di invio include una chiave di idempotenza, così il re-invio non genera task duplicati
- Gli errori sono gestiti distinguendo ritentabili e non ritentabili
- Il video risultante viene trasferito immediatamente nello storage proprietario, senza dipendere da link temporanei
- Ogni chiamata è registrata nei log e si possono aggregare quotidianamente secondi prodotti e costi
- Nomi dei parametri e intervalli di valori sono stati confermati sulla documentazione ufficiale, senza campi ipotizzati
Ritmo di adozione
Inizia con la durata minima e un unico percorso per far funzionare la catena end-to-end, verifica che prompt e parametri producano video in modo stabile, poi estendi gradualmente durata e risoluzione e solo alla fine passa alla produzione in batch. Questo ordine permette di basare ogni aumento di scala su risultati già validati.
Dal punto di vista dei limiti delle capacità, il valore di flux-3-video sta nel coprire tre modalità di input con un unico modello; dal punto di vista ingegneristico, la vera soglia sta nell'orchestrazione asincrona e nella disciplina sui costi. Se vuoi prima far funzionare la catena, puoi iniziare dalla pagina del modello su HiAPI.ai provando un task di breve durata.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori