
Guide d'utilisation
Guide de prise en main de gemini-4-hydrogen : périmètre de capacités, paramètres clés et mise en œuvre
Référence d'intégration et de sélection de modèles texte pour les équipes d'ingénierie
Sur cette page
Positionnement et périmètre de capacités de gemini-4-hydrogen
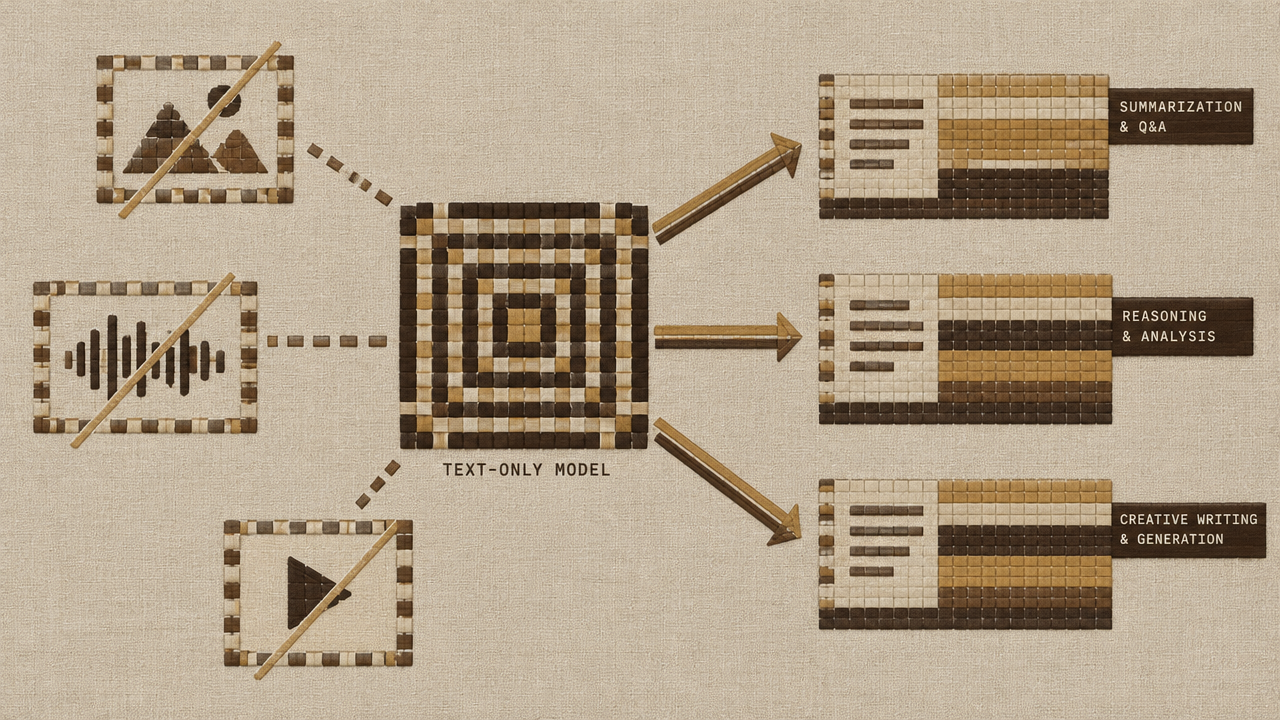
gemini-4-hydrogen est un modèle texte proposé par Google. Son type de sortie est du texte brut — ce qui détermine où le placer dans votre architecture : dans les étapes texte en entrée, texte en sortie, et non comme un maillon d'un pipeline multimodal.
Ce pour quoi il est adapté
Du point de vue de l'ingénierie, un modèle à sortie texte brut trouve ses applications les plus typiques dans les tâches où « le produit intermédiaire est un texte » :
- Extraction et conversion structurées : transformer du texte non structuré en JSON, en lignes de tableau, en listes de champs et autres formats convenus ;
- Résumé et réécriture : compression de documents longs, ajustement du ton, unification de la formulation multilingue ;
- Classification et décision : identification d'intention, classification de contenu, routage de tickets, avec une sortie courte pour un faible temps de latence ;
- Assistance à la génération : rédaction de brouillons, complétion de commentaires de code, enrichissement de prompts et autres étapes préalables à une relecture humaine ;
- Dialogue et questions-réponses : organisation des réponses à partir d'un contexte de recherche documentaire.
Ces tâches partagent les caractéristiques suivantes : l'entrée peut être sérialisée en texte, la sortie peut être analysée par un programme en aval, et le résultat peut être vérifié par échantillonnage.
Ce pour quoi il n'est pas adapté
Toujours du point de vue de l'ingénierie, il faut délimiter le périmètre à l'avance :
- N'attendez pas qu'il produise directement des images, de l'audio ou de la vidéo. Le format de sortie est du texte ; les chaînes impliquant une génération multimodale doivent être assemblées ailleurs ;
- Ne le considérez pas comme une calculatrice fortement déterministe. Les calculs arithmétiques précis et les validations de règles strictes doivent être confiés au code, pas au modèle ;
- Ne lui faites pas porter d'affirmations factuelles sans contexte. Pour les scénarios nécessitant des connaissances externes, placez d'abord les documents dans l'entrée via la recherche, puis laissez-le organiser la réponse ;
- Ne le considérez pas comme la seule source d'information sur des événements en temps réel. Les connaissances internes du modèle ont une date limite ; les contenus à forte exigence d'actualité doivent être injectés par votre système.
Inscrire ces points dans le document de conception de l'équipe coûte bien moins cher que de corriger le tir en aval après coup.
Points à confirmer avant l'intégration
Avant d'écrire la première ligne de code d'appel, il vaut la peine de clarifier certains points, sous peine de multiplier les investigations inutiles pendant la phase de débogage.
Clarifier la forme de la tâche et le contrat de sortie
Répondez d'abord à trois questions : l'entrée est-elle en un seul tour ou en plusieurs tours ? La sortie est-elle du texte libre ou doit-elle respecter une certaine structure ? En cas d'échec, le système en aval peut-il tolérer une nouvelle tentative ? Ces trois réponses déterminent directement la manière d'écrire le prompt, de fixer la limite de longueur de sortie et d'effectuer la validation.
Identifiants et point d'entrée des appels
Quel que soit le mode d'intégration final, vous avez besoin d'un ensemble d'identifiants API gérables et renouvelables, et il ne faut pas écrire les identifiants dans le code front-end ni les committer dans le dépôt. La pratique recommandée : placer les identifiants dans des variables d'environnement côté serveur ou dans un service de gestion de secrets, faire appeler le modèle par le back-end comme point de sortie unique, et faire communiquer le front-end uniquement avec votre back-end. Cela évite les fuites et facilite ensuite la mise en place de quotas et d'audits par dimension métier.
Réseau et budget de timeout
La durée d'une requête à un modèle texte varie selon la longueur de l'entrée et de la sortie. Avant la mise en production, déterminez : quel est le temps de réponse maximal acceptable pour votre activité ? Déduisez-en le timeout de requête, le nombre de tentatives et la stratégie de dégradation. Beaucoup de retours « le modèle est instable » correspondent en réalité à un décalage entre le paramétrage du timeout et les attentes métier.
L'observabilité avant les fonctionnalités
Avant d'écrire la logique métier, définissez les champs de log : ID de requête, quantité de tokens en entrée, quantité de tokens en sortie, durée, code d'erreur. Ces éléments sont quasiment indispensables plus tard pour le calcul des coûts et le diagnostic des problèmes ; les ajouter après coup oblige souvent à modifier tout un pan de code.
Conformité et périmètre des données
Vérifiez si les contenus que vous allez envoyer contiennent des informations sensibles telles que des données personnelles d'utilisateurs, des clés ou des documents internes, et identifiez les champs qui doivent être anonymisés avant l'envoi au modèle.
Paramètres d'appel et organisation des requêtes
Un appel typique se compose de trois parties : le contenu d'entrée, les paramètres de contrôle et le résultat renvoyé. Seuls quelques paramètres influencent réellement la qualité du résultat et le coût.
Comment organiser le contenu d'entrée
Considérez l'entrée comme trois couches : « instruction + contexte + données à traiter » :
- Placez l'instruction en premier, en précisant le rôle et l'objectif de la tâche ;
- Placez le contexte (documents récupérés, historique de conversation) au milieu, avec une séparation claire ;
- Placez les données à traiter en dernier, à proximité immédiate de l'objet visé par l'instruction.
Pour les conversations multi-tours, conservez les derniers tours plutôt que d'empiler indéfiniment l'historique — plus l'historique est long, plus la consommation côté entrée augmente, et le bruit dilue les informations clés. Pour les contenus nécessitant une mémoire à long terme, il est recommandé de les résumer avant de les injecter, plutôt que de les transporter intégralement en texte brut.
Paramètres clés
- Limite de longueur de sortie : c'est le paramètre le plus souvent négligé, qui affecte pourtant à la fois le coût et l'expérience. Une valeur trop petite tronque la réponse ; une valeur trop grande laisse au modèle un espace de « bavardage ». Il est recommandé de définir des paliers par type de tâche : une limite très faible pour les tâches de classification, et une ouverture plus large uniquement pour la génération de textes longs.
- Paramètres d'échantillonnage du type température/top-p : pour l'extraction, la classification, la conversion de format et autres tâches nécessitant une sortie stable, réduisez l'aléa ; pour la génération de textes, vous pouvez l'ouvrir modérément. Restez cohérent au sein d'une même activité pour faciliter les comparaisons de régression.
- Conditions d'arrêt : si votre système en aval exige que la sortie se termine à un endroit précis (par exemple ne récupérer que le premier bloc JSON), contraindre via une séquence d'arrêt est plus fiable qu'un découpage par expression régulière après coup.
- Contraintes de sortie structurée : lorsque le résultat doit être analysé par un programme, indiquez dans l'instruction les noms de champs, les types et des exemples, et précisez explicitement « ne produire que du JSON, sans explication ».
Quelques bonnes pratiques d'organisation des requêtes
- Séparez les prompts du code métier et transformez-les en modèles versionnables, pour faciliter les comparaisons A/B ;
- Prévoyez un filet de sécurité pour l'analyse de la sortie : en cas d'échec d'analyse, journalisez la réponse brute plutôt que de renvoyer directement une erreur à l'utilisateur ;
- Définissez une clé d'idempotence pour chaque requête, afin d'éviter la double facturation et les effets de bord en double causés par les nouvelles tentatives ;
- Pour les entrées longues, effectuez d'abord un découpage et un filtrage, et tenez les paragraphes non pertinents à l'écart du modèle — c'est le moyen le plus direct d'économiser.
Comment estimer et maîtriser les coûts avec une facturation au token
gemini-4-hydrogen est facturé au token. Cela signifie que votre coût dépend presque entièrement de deux choses : combien de tokens sont envoyés à chaque requête et combien de tokens le modèle produit. Pour les montants, référez-vous au panneau de tarifs du site ; nous ne parlons ici que de méthode.
Prendre l'habitude d'estimer
Ne vous fiez pas à l'intuition. La méthode : exécutez d'abord un lot d'échantillons réels, enregistrez le nombre de tokens en entrée et en sortie de chaque requête, puis calculez la moyenne et les quantiles par scénario métier. Utilisez « nombre moyen de tokens × volume d'appels quotidien » pour obtenir une estimation d'ordre de grandeur, puis regardez le P95 pour le pire cas. Vous constaterez que les distributions varient énormément d'un scénario à l'autre ; une estimation avec une moyenne unique est souvent très biaisée.
Leviers concrets de maîtrise des coûts
- Compresser l'entrée : supprimez les prompts système redondants, élaguez le contexte non pertinent, résumez d'abord les documents longs avant de les envoyer. Le côté entrée est généralement le poste de coût principal, et le gain y est le plus direct ;
- Limiter la sortie : via la limite de longueur de sortie et des instructions du type « répondez de manière concise », éliminez directement les sorties redondantes ;
- Appels par paliers : les classifications simples et les validations de format se règlent avec de petites requêtes, et l'appel complet n'est utilisé que lorsque la capacité de génération est réellement nécessaire ;
- Cache et déduplication : mettez en cache les résultats de requêtes identiques ou très similaires, en particulier pour les tâches batch hors ligne ;
- Batch et asynchrone : regroupez le traitement des tâches non temps réel pour réduire la part de surcoût fixe répétée.
Transformer le coût en indicateur observable
Journalisez la consommation de tokens par ligne métier et réalisez un tableau de bord des tendances journalières/hebdomadaires. Lorsqu'une hausse anormale de la consommation survient un jour donné, elle correspond généralement à trois causes : augmentation du volume d'appels, allongement de l'entrée (par exemple modification de la logique d'assemblage du contexte), allongement de la sortie (par exemple modification du prompt). Faire de ces trois points des éléments de surveillance permet d'économiser beaucoup de recherches a posteriori.
Un dernier rappel : n'optimisez pas les coûts au détriment de la qualité de sortie. Mettez d'abord en place un jeu d'évaluation, puis parlez de compression.
Intégration sur une plateforme d'API agrégée et comparaison multi-modèles
Pour la plupart des équipes, le coût le plus élevé lors de la phase de sélection n'est pas l'écriture de code, mais le fait de devoir « modifier toute la couche d'intégration à chaque changement de modèle ». Une intégration via un point d'entrée unifié permet de réduire ce coût au minimum.
Les avantages d'une interface unifiée
Sur une plateforme d'API agrégée, l'appel des modèles est unifié autour d'une même structure de requête : même mode d'authentification, même format de message, même logique d'analyse de la réponse. Lors d'un changement de modèle, il suffit généralement de modifier l'identifiant du modèle, le code métier restant pratiquement inchangé. Les bénéfices directs sont :
- la couche d'intégration n'est écrite qu'une fois et partagée par plusieurs modèles ;
- la phase d'évaluation permet une comparaison transversale à faible coût ;
- en production, il est possible de faire du déploiement progressif et du retour arrière rapide — en cas de problème avec un modèle, basculer vers une alternative ne demande qu'un changement de configuration.
Les informations d'intégration et la disponibilité de ce modèle sont accessibles depuis la page du modèle : /models/gemini-4-hydrogen.
Réaliser une comparaison sur une même question
Ne vous contentez pas des classements. La méthode consiste à préparer votre propre jeu d'évaluation, couvrant 20 à 50 échantillons représentatifs de la distribution réelle de votre activité, incluant des cas simples, des cas limites et des cas à entrée longue, puis :
- exécutez plusieurs modèles candidats avec le même modèle de prompt ;
- enregistrez la qualité de sortie (notation humaine ou par règles), la durée et la consommation de tokens ;
- regardez surtout le taux de réussite et les modes d'échec, plutôt que la note moyenne ;
- analysez les causes des écarts marqués sur certains échantillons : problème de suivi d'instruction, problème de format, ou troncature de contexte long.
Stratégie de bascule et de coexistence
La conclusion d'une évaluation n'est souvent pas « n'utiliser qu'un seul modèle », mais « répartir par scénario ». Par exemple : un modèle à faible latence pour la classification et l'extraction, un modèle de meilleure qualité de sortie pour la génération de textes longs. Le point d'entrée unifié permet d'exprimer cette répartition au niveau de la configuration, sans maintenir plusieurs SDK. Il est également recommandé de conserver dans la couche d'intégration un interrupteur de configuration pour l'identifiant du modèle, et de déployer progressivement via une publication progressive.
Checklist de validation avant mise en production et dépannage des problèmes courants
Checklist de validation avant mise en production
Exécutez ces étapes dans l'ordre avant d'envisager une montée en charge :
- Test de fumée : une requête minimale renvoie-t-elle correctement une réponse, l'authentification et le réseau sont-ils fonctionnels ;
- Validation de format : dans les scénarios à sortie structurée, quel est le taux de réussite d'analyse sur un lot d'échantillons, et à quoi ressemblent les réponses en cas d'échec d'analyse ;
- Entrées limites : comportement sur entrée très longue, entrée vide, entrée contenant des caractères spéciaux et plusieurs langues ;
- Longueur de sortie : dans le pire cas, la sortie est-elle tronquée, et le système en aval peut-il le détecter ;
- Concurrence et timeout : sous la concurrence de pointe attendue, le taux de timeout et le taux d'erreur sont-ils acceptables ;
- Chemin de dégradation : lorsque le modèle principal est indisponible, la chaîne de bascule vers une alternative ou de retour à un résultat de repli fonctionne-t-elle réellement ;
- Base de coût : enregistrez la consommation de tokens sur un cycle de trafic typique comme référence pour la surveillance ultérieure.
Problèmes courants et ordre d'investigation
Timeout de requête : vérifiez d'abord si l'entrée est trop longue (notamment si un document entier y a été inséré), puis si la limite de sortie n'est pas trop élevée, et enfin si la stratégie de timeout et de nouvelle tentative côté client est raisonnable. Les nouvelles tentatives doivent intégrer un backoff pour éviter un effet avalanche.
Sortie tronquée : vérifiez la limite de longueur de sortie et si le prompt demande un contenu trop long ; il arrive aussi qu'une séquence d'arrêt mal définie provoque une fin prématurée.
Sortie instable, format irrégulier : réduisez en priorité l'aléa d'échantillonnage ; vérifiez ensuite si l'instruction est explicite (noms de champs, types et exemples au complet) ; puis vérifiez si l'entrée contient des exemples contradictoires.
Contenu qui s'écarte de l'instruction : la cause fréquente est un contexte trop long qui dilue l'instruction clé. Déplacer l'instruction à la fin de l'entrée et la répéter, ou compresser le contexte, permet généralement d'améliorer la situation.
Hausse anormale des coûts : procédez à l'attribution selon les trois points mentionnés précédemment — volume d'appels, longueur d'entrée, longueur de sortie — en les comparant un à un aux tendances des logs.
Résultats non reproductibles : enregistrez les paramètres de requête et la version du modèle de prompt ; la sortie du modèle est intrinsèquement aléatoire, n'attendez pas une reproduction au caractère près, et basez la validation sur des règles ou une notation humaine.
Intégrer cette checklist au processus de publication est bien plus stable que d'improviser à chaque mise en production. Pour les détails concrets de sélection et d'intégration, commencez par vérifier la page du modèle /models/gemini-4-hydrogen.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de génération d'images par texte avec Nano Banana version de base : format, espaces réservés et usage des prompts
Utiliser les champs aspect_ratio et prompt de l'API de tâche pour générer des images à composition claire pour bannières et cartes sociales
-

Guide d'utilisation
Gestion des réponses Kimi K3 en pratique : JSON complet, interruption de flux et limites de la logique de retry
-

Guide d'utilisation
GLM 5.3 en pratique pour l'extraction structurée : chaque champ JSON adossé à un extrait du texte source
Extraction de champs en mode objet JSON : valeurs manquantes, citations et validation métier pour bloquer les erreurs avant l'insertion en base