
Guide d'utilisation
Guide de prise en main de gpt-5.6-sol : limites de capacité, intégration API et maîtrise des coûts
Du choix du modèle au dépannage de l'intégration : un parcours pratique pour les équipes d'ingénierie
Comprendre d'abord ce qu'est gpt-5.6-sol, et ce qu'il n'est pas
Dans une discussion de sélection de modèle, l'erreur la plus fréquente n'est pas « ce modèle est-il puissant ? », mais « est-ce bien le type d'outil qu'il me faut ? ». gpt-5.6-sol est fourni par OpenAI et produit du texte en sortie. Ces deux faits semblent anodins, mais ils déterminent directement toutes vos décisions d'ingénierie en aval.
C'est un modèle texte en entrée, texte en sortie
Lorsque vous placez gpt-5.6-sol dans une architecture système, sa position est claire : il reçoit du texte en entrée et renvoie du texte en sortie. Toute évaluation de ses capacités doit s'articuler autour de cette chaîne — côté entrée, des prompts, des extraits de contexte, des données structurées sérialisées en chaînes ; côté sortie, du langage naturel, du JSON, des extraits de code, des étiquettes de classification, etc.
Ce n'est pas un canal d'entrée/sortie multimodal
Cela signifie que les besoins suivants ne doivent pas être présumés couverts par ce modèle : transcription vocale, compréhension d'images, génération d'images, traitement vidéo, flux audio temps réel. Si votre processus métier comporte à la fois des étapes textuelles et non textuelles, la bonne approche consiste à confier les étapes non textuelles à des composants spécialisés, puis à sérialiser les résultats intermédiaires en texte pour les soumettre à gpt-5.6-sol afin qu'il effectue le raisonnement et l'organisation, plutôt que de lui faire porter toute la chaîne.
Trois questions avant de décider de l'intégrer
Premièrement, votre tâche peut-elle s'exprimer comme « étant donné un texte, produire un autre texte » ? Résumé, reformulation, extraction, classification, dialogue, complétion de code, génération de données structurées : tous ces cas conviennent.
Deuxièmement, avez-vous besoin d'une sortie déterministe strictement reproductible ? La sortie d'un modèle génératif de texte présente naturellement une certaine variabilité. Si votre activité exige une idempotence au mot près (par exemple la réconciliation comptable ou des messages signés), il ne convient pas comme exécuteur unique ; il est plus adapté à la génération de candidats, suivie d'une validation par des règles.
Troisièmement, votre budget de latence autorise-t-il une inférence complète du modèle ? Les modèles de texte ne conviennent généralement pas aux chaînes synchrones à l'échelle de la microseconde. Les scénarios asynchrones, par lots ou interactifs avec cache sont leur zone de confort.
Si les trois questions passent, ce modèle mérite d'entrer dans votre vivier de candidats ; si l'une bloque, il faut d'abord résoudre la conception de la chaîne, et non espérer que les paramètres du modèle sauvent la situation.
Préparation avant l'intégration et parcours de validation minimal
Beaucoup d'incidents d'intégration ne viennent pas du modèle, mais du fait que le code est mis en production avant que la préparation soit terminée. Parcourez d'abord ce chemin minimal, puis parlez d'intégration.
Phase de préparation : définir les limites, puis obtenir les identifiants
- Définir la sortie de service : tous les appels au modèle passent par l'interface unifiée de HiAPI.ai ; les équipes ne doivent pas multiplier des scripts d'accès direct, sinon la gestion des identifiants, l'observation des quotas et le dépannage deviennent incontrôlables.
- Demander et conserver les identifiants : la clé API ne réside que dans des variables d'environnement côté serveur ou dans un service de gestion de secrets ; ne jamais l'inscrire dans le code front-end, ne jamais la committer dans le dépôt.
- Confirmer l'identifiant du modèle : le nom de modèle utilisé lors de l'appel doit correspondre à l'identifiant indiqué dans la documentation, afin d'éviter un échec de routage dû à une différence d'orthographe.
- Fixer les quotas et les délais d'attente : définissez dès le client le délai d'attente par requête et le nombre maximal de tentatives ; ne laissez pas la stratégie de nouvelle tentative à la valeur par défaut.
Parcours de validation minimal : une requête, quatre points de contrôle
Avant l'intégration officielle, validez la chaîne avec une requête minimale. Il est recommandé de vérifier les points suivants dans l'ordre et de s'arrêter pour investiguer dès qu'une étape échoue, sans empiler davantage de code.
curl -sS https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.6-sol",
    "messages": [{"role": "user", "content": "用一句话说明你收到的指令。"}]
  }'
Point de contrôle 1 : connectivité. La requête obtient une réponse HTTP, et non un dépassement de délai ni un échec DNS. En cas d'échec de connexion, vérifiez d'abord la sortie réseau et la configuration du proxy, sans soupçonner le modèle.
Point de contrôle 2 : authentification. La réponse n'est pas 401/403. Un échec d'authentification vient généralement d'une faute de frappe dans la clé, d'une variable d'environnement non injectée ou d'une clé expirée ; éliminez-les une à une.
Point de contrôle 3 : structure de la réponse. La structure du corps de réponse correspond à la documentation et permet de localiser le champ du contenu textuel. Une structure non conforme indique souvent un nom de champ erroné dans le corps de requête ou une incohérence de version d'interface.
Point de contrôle 4 : pertinence du contenu. La sortie est une réponse normale à l'instruction. C'est seulement à ce stade que la chaîne est réellement validée.
Inscrivez ces quatre points de contrôle dans la checklist de prise en main de l'équipe : les nouveaux arrivants n'ont qu'à la suivre, ce qui évite beaucoup de temps perdu en échanges du type « la documentation est la même, pourquoi ça ne marche pas chez moi ? ».
Décisions clés sur les paramètres de requête et le contrôle de la sortie
Les paramètres d'appel d'un modèle de texte sont peu nombreux, mais chacun correspond à un arbitrage d'ingénierie. Voici un cadre de décision « quel paramètre ajuster dans quel cas » ; les plages de valeurs exactes sont celles de la documentation HiAPI.ai, ne remplissez pas de mémoire.
Instruction et contexte : prioritaires sur tout autre paramètre
Lorsque la sortie n'est pas conforme, la première action est toujours de réécrire le prompt, pas d'ajuster des paramètres. Écrire clairement l'objectif de la tâche, les limites des données d'entrée et le format de sortie attendu est généralement plus efficace que n'importe quel réglage. Dans les scénarios multi-tours, la stratégie de découpage de l'historique (combien de tours conserver, comment résumer et compresser) pèse souvent plus sur la qualité et le coût qu'un micro-ajustement ponctuel des paramètres.
Plafond de longueur de sortie : à définir selon l'usage, pas selon l'humeur
- Tâches d'extraction, de classification, d'étiquetage : réduisez le plafond au strict nécessaire, la marge excédentaire serait gaspillée en continuations inutiles.
- Tâches de résumé ou de reformulation : ajoutez une marge raisonnable à la longueur cible.
- Génération ouverte : c'est là qu'il faut élargir le plafond.
Le plafond de longueur de sortie influence à la fois le coût et la latence — plus la sortie est longue, plus le décodage prend du temps ; les deux varient dans le même sens.
Paramètres liés au hasard : distinguer « stabilité » et « diversité »
Les tâches d'extraction, de décision ou de sortie formatée visent des résultats aussi stables que possible : il faut réduire le caractère aléatoire. Seules les tâches d'écriture créative, de brainstorming ou de génération de candidats nécessitent de l'ouvrir. Mieux vaut inscrire cette convention dans la couche d'encapsulation du code, plutôt que de laisser chaque point d'appel fixer ses propres valeurs.
Sortie structurée : échanger de la stabilité contre des contraintes
Si l'aval doit analyser le résultat, le schéma doit être explicite dans le prompt, avec une validation stricte et une gestion d'échec côté code. Ne croyez pas « le modèle dit qu'il produit du JSON » ; faites toujours passer une fois par un parseur. En cas d'échec d'analyse, une stratégie de nouvelle tentative (seconde requête avec un indice de correction) est plus rentable qu'une boucle infinie.
Conditions d'arrêt et retour en flux
Configurez des séquences d'arrêt lorsque vous devez contrôler le point de troncature ; pour une interface utilisateur interactive, le retour en flux réduit la latence du premier caractère, tandis qu'un traitement par lots en arrière-plan n'a pas besoin de flux et y gagne même en simplicité. Ce sont des décisions liées au scénario, pas un optimum global.
Structure de coût sous facturation au token
gpt-5.6-sol est facturé au token. Comprendre cela est plus important que de mémoriser un prix unitaire quelconque — car les prix changent, la logique de mesure non.
Une requête est facturée en deux segments
Tokens d'entrée : le prompt système, l'historique des messages, le contexte récupéré, la saisie de l'utilisateur pour ce tour, tout est compté. Tokens de sortie : le contenu généré par le modèle, compté selon la longueur effectivement produite. Les deux segments sont mesurés et facturés séparément ; le prix unitaire exact est celui du panneau tarifaire du site HiAPI.ai.
On en tire un modèle mental très utile : coût ≈ volume d'entrée × consommation côté entrée + volume de sortie × consommation côté sortie. La grande majorité des anomalies de facturation en production se retrouve dans ces deux multiplicateurs.
Les quatre points de fuite de coût les plus fréquents
- Inflation du contexte : insérer un document entier ou un journal complet dans le prompt sans découpage, ce qui fait croître linéairement les tokens d'entrée sans forcément améliorer le résultat.
- Accumulation sans limite de l'historique : sans gestion de fenêtre dans les conversations multi-tours, chaque requête coûte plus cher à mesure que les tours s'accumulent, et le coût croît de façon non linéaire avec la longueur du dialogue.
- Sortie incontrôlée : sans plafond de longueur, le modèle s'exprime librement et les tokens de sortie brûlent pour rien.
- Tempête de nouvelles tentatives : des retries sans temporisation ni limite transforment une simple secousse en une facture supplémentaire.
Mettre en place l'observabilité, plutôt que de s'étonner après coup
Enregistrez de manière unifiée, dans la couche d'encapsulation, les tokens d'entrée, les tokens de sortie, la durée et l'identifiant métier de chaque appel, agrégés par interface, par locataire et par fonctionnalité. Une maîtrise des coûts sans observabilité est une non-maîtrise. Il est recommandé d'implémenter trois garde-fous de base — « plafond de tokens par requête », « plafond cumulé quotidien par utilisateur », « alerte en cas de dérive anormale » — dans la passerelle ou la couche d'encapsulation, et non dispersés dans le code métier.
La place du cache et du traitement par lots
Les requêtes identiques ou très similaires peuvent mettre leurs résultats en cache, et un appel qui touche le cache est simplement évité ; les tâches hors ligne gagnent à être regroupées en lots pour réduire les frais répétés de prompt système. Ces deux optimisations apportent généralement un gain plus direct que le réglage des paramètres.
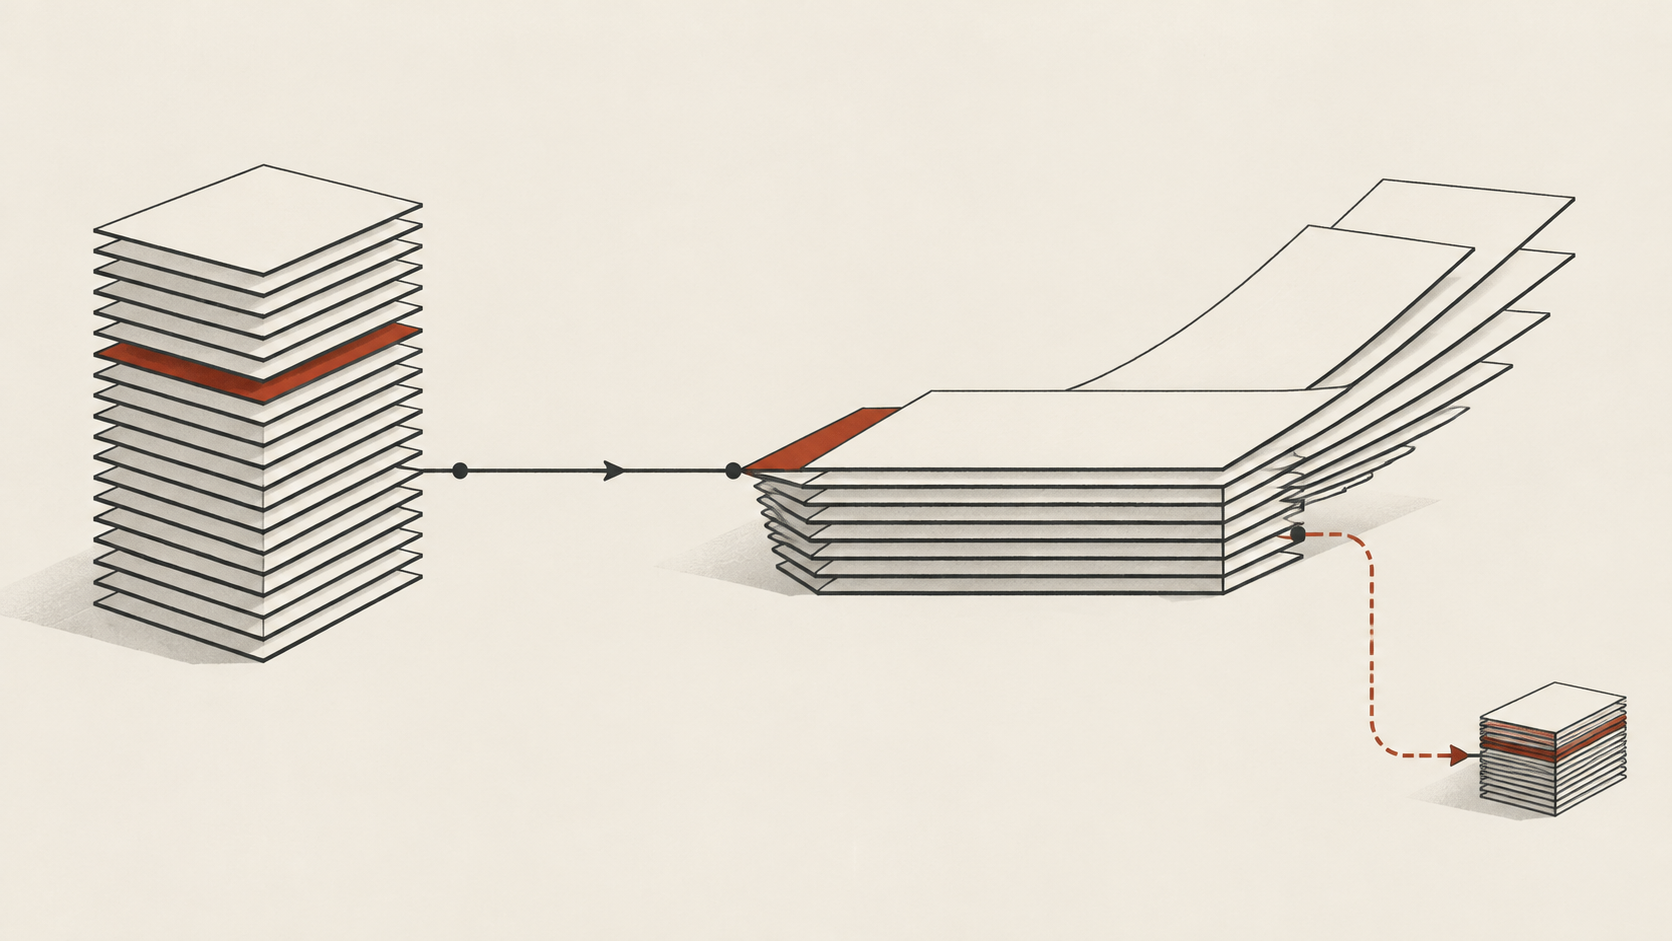
Usages typiques et techniques d'amplification de la qualité
Avec le même modèle, une structure de prompt d'un cran inférieur peut produire une qualité décalée d'un ordre de grandeur. Les schémas suivants sont les plus réutilisés dans les activités de type texte.
Extraction et structuration : définir le schéma, puis donner des exemples
Écrivez clairement les champs cibles, les types et les plages de valeurs, et joignez un ou deux exemples d'entrée-sortie. Les exemples sont bien plus efficaces que les adjectifs. Validez ensuite la sortie avec un parseur : en cas de champ manquant ou de type incorrect, passez par une nouvelle tentative corrective plutôt que d'accepter un résultat à moitié fait.
Classification et décision : expliciter les critères de jugement
Ne vous contentez pas de « détermine si ce commentaire est négatif » : énumérez les frontières de décision — quelles formulations comptent comme négatives, comment traiter les cas neutres, dans quelle catégorie ranger les cas ambigus. Plus les critères sont explicites, meilleure est la cohérence entre lots.
Traitement de textes longs : approche en deux temps, découpage puis synthèse
Pour un document dépassant la longueur confortable, traitez d'abord par segments pour obtenir des conclusions locales, puis effectuez une synthèse globale. Cela maîtrise le volume d'entrée par appel et rend la sortie de chaque étape vérifiable et rejouable.
Tâches de génération : produire des candidats, puis sélectionner
Demandez au modèle de fournir plusieurs candidats en une fois, puis sélectionnez par règles ou par un second appel. La qualité de génération s'améliore avec le nombre de candidats, la stabilité est garantie par l'étape de sélection.
Trois enseignements sur la structure du prompt
- Séparer le rôle et la tâche : écrivez séparément « qui tu es » et « ce que tu dois faire », pour éviter qu'ils se diluent mutuellement.
- Placer les contraintes en tête : les exigences de format, les interdits, les limites de longueur doivent figurer au début, car le modèle respecte généralement mieux les contraintes placées en amont.
- L'exemple fait office de spécification : plutôt que dix phrases de description, donnez un bon couple entrée-sortie.
Capitaliser ces schémas dans une bibliothèque de modèles de prompts interne, et réutiliser en priorité pour les nouveaux scénarios plutôt que de repartir de zéro, est le moyen le plus économique d'amplifier la qualité.
Observation et ordre de dépannage après la mise en production
En production, ce qui coûte le plus cher n'est pas de réparer, mais de trouver. Un ordre de diagnostic fixe permet de réduire au minimum le temps de localisation.
Premier niveau : déterminer s'il s'agit d'un « échec de connexion » ou d'un « résultat incorrect »
Échec de connexion désigne une requête en échec : dépassement de délai, limitation de débit, erreur d'authentification, 5xx côté serveur. Résultat incorrect désigne une requête réussie mais une qualité de sortie anormale. Les chemins de diagnostic de ces deux catégories sont totalement différents : commencez par les distinguer.
Deuxième niveau : en cas d'échec de connexion, remonter la chaîne
- Regarder le code d'erreur : pour un 4xx, soupçonnez d'abord les identifiants, le format du corps de requête ou l'identifiant du modèle ; pour un 5xx ou un dépassement de délai, soupçonnez d'abord une secousse ou un problème de capacité en amont.
- Regarder la distribution temporelle : échec total ou échec sur une plage horaire ou un locataire particulier. Un échec total résulte généralement d'un changement de configuration ; un échec local ressemble davantage à un problème de quota ou de réseau.
- Regarder les changements récents : rotation de clés, configuration de passerelle, montée de version de dépendances — la grande majorité des incidents soudains se rattache à un changement.
- Dégrader plutôt que s'acharner : lorsqu'il est confirmé que l'amont est indisponible, empruntez le chemin de repli prévu (voir la section suivante), pour que les nouvelles tentatives n'aggravent pas le problème.
Troisième niveau : en cas de résultat incorrect, remonter l'entrée
Une baisse de qualité de sortie est liée dans plus de neuf cas sur dix à l'entrée :
- Le prompt a-t-il été modifié : mise à jour de modèle, erreur d'assemblage de variables, problème d'échappement peuvent modifier silencieusement la sémantique.
- Le contexte est-il pollué : les extraits récupérés sont-ils pertinents, y a-t-il des phrases tronquées ?
- La distribution des données a-t-elle dérivé : l'entrée métier elle-même a changé, l'ancien prompt devient naturellement inefficace.
- Les paramètres ont-ils été mal réglés : un paramètre de hasard augmenté, un plafond de sortie trop bas se manifestent tous par « le modèle est devenu bête ».
Quatrième niveau : surveiller les courbes de latence et de coût
Une latence qui bondit avec un taux d'erreur normal indique souvent une sortie plus longue ou une file d'attente en amont ; un coût qui bondit avec un volume d'appels normal indique souvent un volume de requête unitaire plus gros. Placez les trois courbes — latence, consommation de tokens, taux d'erreur — sur le même tableau de bord, et les anomalies apparaîtront d'elles-mêmes.
Recommandation : transformez l'ordre ci-dessus en un runbook, chaque étape associée à une requête concrète ou à un lien de tableau de bord, afin que l'astreinte n'ait qu'à le suivre sans dépendre de l'expérience individuelle.
Quand changer de modèle ou dégrader
Lier le système à un modèle unique revient à confier sa disponibilité à l'humeur d'autrui. La coexistence de plusieurs modèles n'est pas une sur-ingénierie, c'est du bon sens d'ingénierie.
Les trois signaux qui appellent une dégradation
Signal 1 : instabilité de disponibilité. Le taux d'erreur ou de dépassement de délai franchit le seuil et ne se rétablit pas à court terme : il faut basculer automatiquement vers un modèle de secours ou simplifier le processus (restitution du résultat en cache, passage en file d'attente humaine, par exemple).
Signal 2 : dérive des coûts. Le coût par unité de production d'une ligne métier grimpe durablement, ce qui suggère que ce scénario n'a peut-être pas besoin du niveau de capacité actuel : envisagez de rediriger une partie des requêtes vers un modèle plus léger.
Signal 3 : latence non conforme. Les scénarios interactifs sont sensibles à la latence du premier caractère ; lorsque la réponse du modèle dépasse structurellement le budget de latence, il faut découper par scénario plutôt que subir globalement.
Mise en œuvre de la dégradation : par niveaux, pas uniforme
Établissez dans la couche d'encapsulation une table de niveaux de modèles : modèle principal, modèle de secours, modèle léger. Le routage se fonde sur les étiquettes de scénario métier et l'état de santé en temps réel, et non sur des valeurs codées en dur dans le code métier. Ainsi, le basculement ne demande qu'un changement de configuration, sans déploiement.
Critères pour décider d'une nouvelle sélection de modèle
Faites régulièrement (par exemple chaque trimestre) un bilan de la sélection, autour de trois questions :
- La capacité est-elle excédentaire : si un modèle léger suffit à atteindre les objectifs de façon stable pour la tâche actuelle, continuer avec un modèle haut de gamme est un pur gaspillage de coût.
- La capacité est-elle insuffisante : si de nombreuses requêtes nécessitent des prompts complexes de rattrapage et que le taux de nouvelle tentative reste élevé, le modèle ne correspond pas à la tâche.
- Le risque de dépendance est-il maîtrisé : existe-t-il un chemin de substitution clair, et disposez-vous d'un jeu de tests de régression exécutable pour valider l'alternative.
Le jeu de tests de régression est l'infrastructure du bilan de sélection. Sans un ensemble d'échantillons réels annotés, tout jugement « ce modèle est meilleur » relève de l'impression. Commencez à accumuler des échantillons dès le premier jour de production, et exécutez une comparaison à chaque changement de modèle.
Principe en une phrase
Faites du modèle un composant remplaçable, pas la fondation du système. Faire converger les appels vers une interface unifiée, les prompts et paramètres vers la couche d'encapsulation, et l'évaluation vers un jeu de tests — avec ces trois points, changer de modèle n'est qu'un changement de configuration, pas une refonte.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax