
Benutzerhandbuch
gpt-5.6-sol Einstiegsleitfaden: Fähigkeitsgrenzen, API-Anbindung und Kostenkontrolle
Von der Fähigkeitsbewertung bis zur Integrationsfehlersuche – ein praktischer Fahrplan für Engineering-Teams
Zuerst klären, was gpt-5.6-sol ist und was nicht
Der häufigste Fehler in Auswahlgesprächen ist nicht die Frage „Ist dieses Modell stark?“, sondern „Ist es überhaupt die Art von Sache, die ich brauche?“. gpt-5.6-sol wird von OpenAI bereitgestellt, der Ausgabetyp ist Text. Diese beiden Tatsachen wirken banal, bestimmen aber direkt alle späteren Engineering-Entscheidungen.
Es ist ein Modell mit Texteingabe und Textausgabe
Wenn gpt-5.6-sol in die Systemarchitektur eingebettet wird, kann es folgende Position einnehmen: Texteingaben entgegennehmen und Textausgaben zurückgeben. Alle Fähigkeitsbewertungen sollten sich um diese Kette drehen – auf der Eingabeseite stehen Prompts, Kontextfragmente und serialisierte Strings strukturierter Daten; auf der Ausgabeseite natürliche Sprache, JSON, Codefragmente, Klassifikationslabels und andere Textformen.
Es ist kein multimodaler Eingabe-/Ausgabekanal
Das bedeutet, dass die folgenden Anforderungen nicht standardmäßig von ihm erwartet werden sollten: Sprachnotation, Bildverständnis, Bildgenerierung, Videoverarbeitung, Echtzeit-Audiostreaming. Wenn in Ihrem Geschäftsprozess sowohl Text- als auch Nicht-Text-Abschnitte existieren, besteht der richtige Ansatz darin, die Nicht-Text-Abschnitte an spezialisierte Verarbeitungskomponenten zu übergeben und die Zwischenergebnisse als Text zu serialisieren, damit gpt-5.6-sol die Inferenz und Organisation übernimmt – statt zu versuchen, ihm die gesamte Kette aufzubürden.
Drei Fragen, bevor Sie über eine Anbindung entscheiden
Erstens: Lässt sich Ihre Aufgabe als „Gegeben ein Textstück, erzeuge ein anderes Textstück“ ausdrücken? Zusammenfassung, Umschreibung, Extraktion, Klassifikation, Dialog, Codevervollständigung, Generierung strukturierter Daten – all das passt.
Zweitens: Benötigen Sie streng reproduzierbare deterministische Ausgaben? Die Ausgaben generativer Textmodelle schwanken naturgemäß. Wenn das Geschäft wortgenaue Idempotenz verlangt (etwa Abgleich, signierte Nachrichten), eignet es sich nicht als alleiniger Ausführender, sondern besser als Stufe zur Kandidatengenerierung mit anschließender Regelvalidierung.
Drittens: Erlaubt Ihr Latenzbudget eine vollständige Modellinferenz? Textmodelle eignen sich in der Regel nicht für synchrones Routing im Mikrosekundenbereich. Asynchrone Verarbeitung, Batch-Verarbeitung und interaktive Szenarien mit Caching sind ihre Komfortzone.
Bestehen alle drei Fragen, verdient das Modell einen Platz in Ihrem Kandidatenpool; bleibt eine hängen, sollten Sie zuerst das Ketten-Design lösen, statt auf Modellparameter zu hoffen.
Vorbereitung vor der Anbindung und minimaler Verifikationspfad
Viele Anbindungsunfälle sind kein Modellproblem, sondern das Ergebnis davon, dass die Vorbereitung nicht abgeschlossen war, bevor Produktionscode deployed wurde. Gehen Sie den folgenden kürzesten Pfad vollständig durch, bevor Sie über die Integration sprechen.
Vorbereitungsphase: Erst Grenzen festlegen, dann Zugangsdaten holen
- Service-Ausgangspunkt klären: Alle Modellaufrufe laufen über die einheitliche Schnittstelle von HiAPI.ai; im Team sollten keine verstreuten Direktverbindungsskripte existieren, sonst geraten Zugangsdatenverwaltung, Quotenbeobachtung und Fehlersuche außer Kontrolle.
- Zugangsdaten beantragen und verwahren: Der API Key existiert nur in serverseitigen Umgebungsvariablen oder einem Secret-Management-Dienst, niemals im Frontend-Code, niemals im Repository.
- Modellbezeichner bestätigen: Der beim Aufruf verwendete Modellname muss mit dem in der Dokumentation angegebenen Bezeichner übereinstimmen, um Routing-Fehler durch Schreibabweichungen zu vermeiden.
- Quoten und Timeouts festlegen: Legen Sie clientseitig Timeout pro Anfrage und maximale Wiederholungsversuche fest; überlassen Sie die Retry-Strategie nicht den Standardwerten.
Minimaler Verifikationspfad: eine Anfrage, vier Prüfpunkte
Bevor Sie die formale Integration beginnen, durchlaufen Sie die Kette mit einer minimalen Anfrage. Bestätigen Sie die folgenden Punkte der Reihe nach; bleibt ein Schritt stecken, halten Sie an und suchen Sie die Ursache, statt weiteren Code darauf zu stapeln.
curl -sS https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.6-sol",
    "messages": [{"role": "user", "content": "Erkläre in einem Satz die Anweisung, die du erhalten hast."}]
  }'
Prüfpunkt eins: Konnektivität. Die Anfrage erhält eine HTTP-Antwort, nicht einen Verbindungs-Timeout oder DNS-Fehler. Bei fehlender Verbindung prüfen Sie zuerst Netzwerkausgang und Proxy-Konfiguration, statt das Modell zu verdächtigen.
Prüfpunkt zwei: Authentifizierung. Die Rückgabe ist kein 401/403. Authentifizierungsfehler sind meist Key-Schreibfehler, nicht injizierte Umgebungsvariablen oder abgelaufene Keys – schließen Sie sie einzeln aus.
Prüfpunkt drei: Antwortstruktur. Die Struktur des Antwortkörpers entspricht der Dokumentation, das Textinhaltsfeld ist auffindbar. Passt die Struktur nicht, deutet das oft auf falsche Feldnamen im Request-Body oder inkonsistente API-Versionen hin.
Prüfpunkt vier: Sinnhaftigkeit des Inhalts. Die Ausgabe ist eine normale Antwort auf die Anweisung. Erst an diesem Punkt ist die Kette wirklich durchgängig.
Schreiben Sie diese vier Prüfpunkte in die Onboarding-Checkliste Ihres Teams; neue Kolleginnen und Kollegen können sie befolgen und sparen sich viel Kommunikationsaufwand à la „Warum funktioniert es bei mir nicht, obwohl die Doku doch gleich ist“.
Schlüsselentscheidungen zu Anforderungsparametern und Ausgabesteuerung
Textmodelle haben wenige Aufrufparameter, aber jeder entspricht einer Art von Engineering-Abwägung. Im Folgenden finden Sie den Entscheidungsrahmen „Wann dreht man an was“; konkrete Wertebereiche entnehmen Sie bitte der HiAPI.ai-Dokumentation, füllen Sie keine Zahlen aus dem Gedächtnis ein.
Anweisung und Kontext: vor allen anderen Parametern
Wenn die Ausgabe nicht den Erwartungen entspricht, ist die erste Priorität immer das Umschreiben des Prompts, nicht das Drehen an Parametern. Formulieren Sie Aufgabenziel, Grenzen der Eingabedaten und erwartetes Ausgabeformat klar – das ist meist wirksamer als jede Parametertuning. In mehrstufigen Dialogszenarien hat die Kürzungsstrategie der Verlaufsnachrichten (wie viele Runden behalten, wie zusammenfassen und komprimieren) oft größeren Einfluss auf Ergebnis und Kosten als die Feinabstimmung einzelner Parameter.
Maximale Ausgabelänge: nach Verwendungszweck setzen, nicht nach Laune
- Extraktions-, Klassifikations- und Scoring-Aufgaben: Das Limit so knapp wie nötig setzen; überschüssiger Spielraum wird für sinnloses Weiterplappern verschwendet.
- Zusammenfassungs- und Umschreibungsaufgaben: Zieltextlänge plus angemessenen Puffer.
- Offene Generierung: nur hier muss das Limit gelockert werden.
Die maximale Ausgabelänge beeinflusst sowohl Kosten als auch Latenz – je länger die Ausgabe, desto länger die Dekodierzeit; beide ändern sich gleichsinnig.
Parameter zur Zufälligkeit: „stabil“ und „vielfältig“ unterscheiden
Aufgaben wie Extraktion, Beurteilung und formatierte Ausgabe wünschen sich möglichst stabile Ergebnisse, sollten die Zufälligkeit niedrig halten; kreatives Schreiben, Brainstorming und Kandidatengenerierung benötigen erst Spielraum. Am besten schreibt das Team diese Vereinbarung in die Kapselungsschicht des Codes, statt dass jede Aufrufstelle eigene Werte setzt.
Strukturierte Ausgabe: Stabilität durch Einschränkungen erkaufen
Wenn die nachgelagerte Verarbeitung Ergebnisse parsen muss, sollte das Schema im Prompt explizit angegeben und im Code streng validiert sowie bei Fehlern abgesichert werden. Verlassen Sie sich nicht darauf, dass „das Modell sagt, es gebe JSON aus“ – lassen Sie immer einen Parser einmal drüberlaufen. Eine Retry-Strategie bei Parse-Fehlern (zweite Anfrage mit Korrekturhinweis) ist günstiger als unbegrenztes Wiederholen.
Stoppbedingungen und Streaming-Rückgabe
Wenn die Abbruchstelle gesteuert werden muss, konfigurieren Sie Stoppsequenzen; für benutzerorientierte interaktive Oberflächen senkt Streaming die Latenz bis zum ersten Zeichen, während Batch-Verarbeitung im Hintergrund kein Streaming braucht und dadurch nur die Verarbeitungskomplexität erhöht. Beides sind Szenarioentscheidungen, keine globalen Optima.
Kostenstruktur unter tokenbasierter Abrechnung
gpt-5.6-sol wird pro Token abgerechnet. Dies zu verstehen ist wichtiger als sich jeden Einzelpreis zu merken – denn Preise ändern sich, die Messlogik nicht.
Eine Anfrage wird in zwei Abrechnungsabschnitte geteilt
Eingabe-Tokens: System-Prompt, Verlaufsnachrichten, abgerufener Kontext, aktuelle Benutzereingabe – alles zählt. Ausgabe-Tokens: vom Modell generierter Inhalt, gezählt nach tatsächlicher Ausgabelänge. Beide Abschnitte werden getrennt gemessen und bepreist; konkrete Stückpreise entnehmen Sie dem Preispaneel der HiAPI.ai-Website.
Daraus ergibt sich ein sehr nützliches mentales Modell: Kosten ≈ Eingabevolumen × Eingabeseitenverbrauch + Ausgabevolumen × Ausgabeseitenverbrauch. Die überwiegende Mehrheit der Online-Rechnungsanomalien lässt sich in diesen beiden Multiplikatoren finden.
Vier häufige Stellen für Kostenlecks
- Kontextaufblähung: ein ganzes Dokument oder einen ganzen Logabschnitt ungekürzt in den Prompt stopfen; die Eingabe-Tokens steigen linear, ohne dass das Ergebnis unbedingt besser wird.
- Unbegrenzte Ansammlung der Historie: mehrstufige Sitzungen ohne Fensterverwaltung; je mehr Runden, desto teurer die einzelne Anfrage, die Kosten wachsen nichtlinear mit der Dialogänge.
- Entgleitende Ausgabe: kein Längenlimit gesetzt, das Modell plaudert ausgiebig, Ausgabe-Tokens werden sinnlos verbrannt.
- Retry-Sturm: fehlgeschlagene Wiederholungen ohne Backoff und Obergrenze; ein einzelnes Wackeln wird zu einer ganzen Rechnungsrunde ausgeweitet.
Observability aufbauen statt nachträglich zu staunen
Zeichnen Sie in der Kapselungsschicht einheitlich Eingabe-Tokens, Ausgabe-Tokens, Dauer und Geschäftskennung jedes Aufrufs auf, aggregiert nach Schnittstelle, Mandant und Funktionsdimension. Kostenkontrolle ohne Beobachtung ist keine Kontrolle. Empfohlen sind die drei Grundleitplanken „Token-Obergrenze pro Anfrage“, „Tagesobergrenze pro Nutzer“ und „Alarm bei anormaler Vervielfachung“, implementiert im Gateway oder in der Kapselungsschicht, statt verstreut im Geschäftscode.
Wo Caching und Batching hingehören
Gleiche oder hochähnliche Anfragen können Ergebnisse cachen; ein Cache-Treffer überspringt den Aufruf. Offline-Aufgaben sollten möglichst zu Batch-Verarbeitung zusammengefasst werden, um wiederholten System-Prompt-Overhead zu reduzieren. Der Nutzen dieser beiden Optimierungen ist meist direkter als Parameter-Tuning.
Typische Anwendungsmuster und Techniken zur Wirkungsverstärkung
Beim selben Modell kann die Ausgabequalität um eine Größenordnung variieren, wenn die Prompt-Struktur eine Stufe schlechter ist. Die folgenden Muster haben in textbasierten Geschäften die höchste Wiederverwendbarkeit.
Extraktion und Strukturierung: erst Schema, dann Beispiele
Schreiben Sie Zielfelder, Typen und Wertebereiche klar auf und fügen Sie ein bis zwei Ein-/Ausgabebeispiele bei. Beispiele sind viel wirksamer als Adjektive. Validieren Sie die Ausgabe anschließend mit einem Parser; bei fehlenden Feldern oder Typabweichungen gehen Sie in den Korrektur-Retry, statt Halbfertiges zu akzeptieren.
Klassifikation und Beurteilung: Beurteilungskriterien explizit machen
Sagen Sie nicht nur „Beurteile, ob dieser Kommentar negativ ist“, sondern listen Sie die Beurteilungsgrenzen auf: Welche Ausdrücke zählen als negativ, wie wird neutral behandelt, zu welcher Kategorie gehören unklare Fälle. Je expliziter die Kriterien, desto besser die Konsistenz über Batches hinweg.
Langtextverarbeitung: zweistufig mit Segmentierung + Zusammenfassung
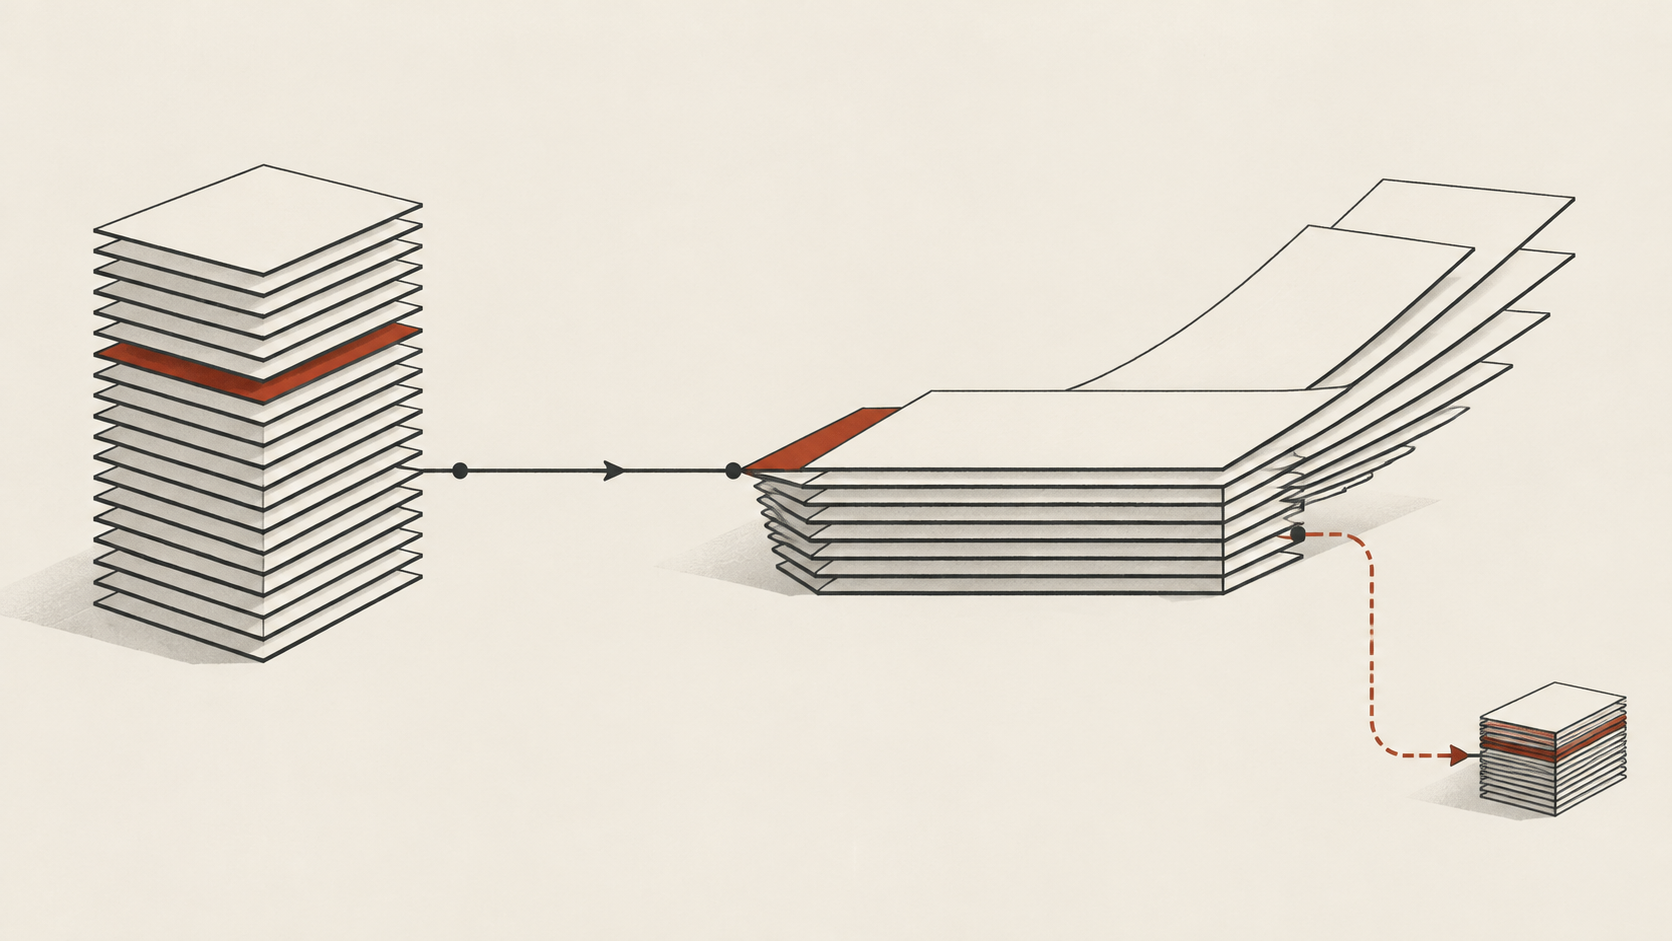
Bei Dokumenten, die die Komfortlänge überschreiten, erzeugen Sie zuerst durch segmentierte Verarbeitung lokale Schlussfolgerungen und führen dann eine Zusammenfassung durch. So kontrollieren Sie das Eingabevolumen pro Anfrage und machen die Ergebnisse jedes Schritts überprüfbar und wiederholbar.
Generierungsaufgaben: erst Kandidaten, dann Auswahl
Lassen Sie das Modell auf einmal mehrere Kandidaten liefern und wählen Sie dann per Regel oder zweitem Aufruf den besten aus. Die Generierungsqualität steigt mit der Kandidatenzahl, die Stabilität wird durch die Auswahlstufe gewährleistet.
Drei Erfahrungen zur Prompt-Struktur
- Rolle und Aufgabe trennen: Schreiben Sie „Wer bist du“ und „Was sollst du tun“ getrennt, damit sie sich nicht gegenseitig verwässern.
- Einschränkungen voranstellen: Formatanforderungen, Verbote und Längenlimits an vorderer Position platzieren; Modelle halten vorgezogene Einschränkungen in der Regel besser ein.
- Beispiel ist Spezifikation: Statt zehn Sätze zu beschreiben, geben Sie lieber ein gutes Ein-/Ausgabepaar.
Diese Muster in einer internen Prompt-Vorlagenbibliothek zu sammeln und bei neuen Szenarien vorrangig wiederzuverwenden statt von Null zu schreiben, ist die müheloseste Methode zur Wirkungsverstärkung.
Beobachtung und Fehlersuche-Reihenfolge nach dem Go-Live
Wenn online Probleme auftreten, ist das Teuerste nicht das Reparieren, sondern das Finden. Eine feste Fehlersuche-Reihenfolge verkürzt die Lokalisierungszeit auf ein Minimum.
Erste Ebene: zuerst klären, ob „nicht erreichbar“ oder „nicht korrekt“
Nicht erreichbar bedeutet fehlgeschlagene Anfrage: Timeout, Rate-Limiting, Authentifizierungsfehler, Server-5xx. Nicht korrekt bedeutet erfolgreiche Anfrage, aber anormale Ausgabequalität. Die Fehlersuchpfade dieser beiden Klassen sind völlig unterschiedlich – erst unterscheiden, dann handeln.
Zweite Ebene: bei Nichterreichbarkeit die Kette rückwärts prüfen
- Fehlercode ansehen: Bei 4xx zuerst Zugangsdaten, Request-Body-Format und Modellbezeichner verdächtigen; bei 5xx und Timeouts zuerst Upstream-Schwankungen und Kapazitätsprobleme.
- Zeitverteilung ansehen: Scheitern alle oder nur bestimmte Zeitfenster, bestimmte Mandanten? Vollständiges Scheitern deutet meist auf Konfigurationsänderungen; lokales Scheitern eher auf Quoten- oder Netzwerkprobleme.
- Jüngste Änderungen ansehen: Key-Rotation, Gateway-Konfiguration, Dependency-Upgrades – die überwiegende Mehrheit plötzlicher Störungen lässt sich einer Änderung zuordnen.
- Degradieren statt aushalten: Wenn bestätigt ist, dass der Upstream nicht verfügbar ist, den vorab entworfenen Rückfallpfad gehen (siehe nächster Abschnitt); lassen Sie nicht zu, dass Retries das Problem vergrößern.
Dritte Ebene: bei „nicht korrekt“ die Eingabe rückwärts prüfen
Qualitätsverschlechterung der Ausgabe hängt zu über neunzig Prozent mit der Eingabe zusammen:
- Wurde der Prompt geändert: Template-Updates, fehlerhafte Variablenzusammensetzung, Escaping-Probleme verändern die Semantik unbemerkt.
- Ist der Kontext verunreinigt: Sind abgerufene Fragmente relevant, gibt es durch Kürzung verursachte halbe Sätze?
- Driftet die Datenverteilung: Die Geschäftseingabe selbst hat sich geändert, der alte Prompt wird natürlich ungültig.
- Wurden Parameter falsch gesetzt: Zufälligkeitsparameter hochgedreht, Ausgabelimit zu niedrig gedrückt – beides zeigt sich als „das Modell ist dümmer geworden“.
Vierte Ebene: Latenz- und Kostenkurven ansehen
Plötzlicher Latenzanstieg bei normaler Fehlerrate deutet meist auf längere Ausgaben oder Upstream-Warteschlangen; plötzlicher Kostenanstieg bei normalem Aufrufvolumen meist auf größeres Anfragevolumen pro Aufruf. Legen Sie die drei Kurven Latenz, Token-Verbrauch und Fehlerrate auf ein gemeinsames Dashboard – Anomalien treten dann von selbst hervor.
Empfehlung: Gießen Sie die obige Reihenfolge in ein Runbook, jeder Schritt mit konkreten Abfragen oder Dashboard-Links, sodass der Bereitschaftsdienst einfach folgen kann, ohne von individueller Erfahrung abhängig zu sein.
Wann das Modell gewechselt oder degradiert werden sollte
Ein System fest an ein einziges Modell zu binden heißt, die Verfügbarkeit der Laune anderer zu überlassen. Mehrere Modelle parallel zu betreiben ist kein Overengineering, sondern Engineering-Grundwissen.
Drei Signale für Degradierung
Signal eins: Verfügbarkeitsschwankungen. Fehlerrate oder Timeout-Rate überschreitet die Schwelle und erholt sich kurzfristig nicht – automatisch auf ein Ersatzmodell wechseln oder den Ablauf vereinfachen (etwa gecachte Ergebnisse zurückgeben, an eine menschliche Warteschlange übergeben).
Signal zwei: Kostenüberschreitung. Die Kosten pro Output einer Geschäftslinie steigen kontinuierlich – das Szenario braucht möglicherweise nicht die Fähigkeiten der aktuellen Modellstufe; einen Teil der Anfragen an ein leichteres Modell umleiten.
Signal drei: Latenz verfehlt Ziel. Interaktive Szenarien sind empfindlich gegenüber der Latenz bis zum ersten Zeichen; wenn die Modellantwort strukturell das Budget überschreitet, sollte nach Szenario aufgeteilt werden, statt global zu dulden.
Umsetzung der Degradierung: Stufung statt pauschaler Abschaltung
Bauen Sie in der Kapselungsschicht eine Modell-Stufungstabelle auf: Hauptmodell, Ersatzmodell, Leichtmodell. Die Routing-Entscheidung richtet sich nach Geschäftsszenario-Labels und Echtzeit-Gesundheitsstatus, nicht nach fest im Geschäftscode verdrahteten Werten. So besteht der Wechsel nur aus einer Konfigurationsänderung, nicht aus einem Release.
Kriterien für eine erneute Modellwahl
Führen Sie regelmäßig (etwa quartalsweise) eine Auswahl-Retrospektive durch und betrachten Sie drei Fragen:
- Sind die Fähigkeiten überdimensioniert: Wenn die aktuelle Aufgabe mit einem Leichtmodell stabil erfüllbar ist, ist die weitere Nutzung eines High-End-Modells reine Kostenverschwendung.
- Sind die Fähigkeiten unzureichend: Wenn viele Anfragen komplexe Prompt-Rettungsaktionen brauchen und die Retry-Rate hoch bleibt, passt das Modell nicht zur Aufgabe.
- Ist das Bindungsrisiko beherrschbar: Gibt es einen klaren alternativen Pfad, gibt es ein lauffähiges Regressionstestset zur Validierung der Alternative?
Das Regressionstestset ist die Infrastruktur der Auswahl-Retrospektive. Ohne eine Reihe annotierter echter Stichproben ist jedes Urteil „das andere Modell ist besser“ reines Gefühl. Beginnen Sie am besten schon am ersten Tag nach dem Go-Live mit dem Sammeln von Stichproben und führen Sie bei jedem Modellwechsel zuerst einen Vergleichslauf durch.
Ein Satz als Prinzip
Lassen Sie das Modell eine austauschbare Komponente sein, nicht das Fundament des Systems. Aufrufe auf eine einheitliche Schnittstelle konzentrieren, Prompts und Parameter in der Kapselungsschicht bündeln, Evaluation im Testset bündeln – mit diesen drei Punkten ist ein Modellwechsel nur eine Konfigurationsänderung statt eines Refactorings.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte