
使用ガイド
gpt-5.6-sol 入門ガイド:能力の境界、API 接続、コスト管理
能力の見極めから接続時のトラブルシューティングまで、エンジニアリングチーム向けの実践的ロードマップ
まず gpt-5.6-sol が何であり、何でないかを把握する
選定議論で最も間違えやすいのは「このモデルが強力かどうか」ではなく、「それがそもそも自分たちが求めている類のものかどうか」です。gpt-5.6-sol は OpenAI が提供しており、出力タイプはテキストです。この 2 つの事実は素朴に見えますが、その後のすべてのエンジニアリング上の意思決定を直接左右します。
テキスト入力・テキスト出力のモデルである
gpt-5.6-sol をシステムアーキテクチャに組み込む際に占められる位置は、テキスト入力を受け取り、テキスト出力を返すというものです。能力の判断はすべてこの経路を中心に展開すべきです。入力側はプロンプト、コンテキスト断片、構造化データをシリアライズした文字列であり、出力側は自然言語、JSON、コード断片、分類ラベルなどのテキスト形式の結果です。
マルチモーダル入力/出力チャネルではない
つまり、次のような要件をデフォルトでこれに期待すべきではありません。音声の文字起こし、画像理解、画像生成、動画処理、リアルタイム音声ストリーミングです。ビジネスフローにテキストと非テキストの工程が混在する場合、正しいやり方は非テキスト工程を専用の処理コンポーネントに任せ、中間結果をテキストにシリアライズして gpt-5.6-sol に渡し推論と構成を行わせることです。全経路を担わせようとするべきではありません。
接続すべきか判断する前に 3 つの問いを立てる
第一に、あなたのタスクは「あるテキストが与えられ、別のテキストを生成する」という形で表現できるか? 要約、書き換え、抽出、分類、対話、コード補完、構造化データ生成はすべて該当します。
第二に、厳密に再現可能な決定論的出力が必要か? 生成型テキストモデルの出力には自然な揺らぎがあります。業務が逐語的な冪等性を要求する場合(例:照合、署名付きメッセージ)、唯一の実行者として適しているわけではなく、候補を生成しルールで検証する工程に置くのが適切です。
第三に、レイテンシ予算は 1 回の完全なモデル推論を許容するか? テキストモデルは通常、マイクロ秒レベルの同期経路には適しません。非同期、バッチ処理、キャッシュ付きの対話型シナリオが快適な領域です。
3 つの問いすべてを通過できれば、このモデルは候補プールに入れる価値があります。1 つでも詰まれば、まず経路設計を解決すべきであり、モデルのパラメータに救ってもらうことを期待すべきではありません。
接続前の準備と最小検証パス
接続事故の多くはモデルの問題ではなく、準備が完了しないまま本番コードを動かしてしまうことです。次の最短パスをやり切ってから統合を語りましょう。
準備段階:まず境界を定め、それから認証情報を取得する
- サービスの出口を明確にする:すべてのモデル呼び出しは HiAPI.ai の統一インターフェースを経由するようにし、チーム内で各自が直接接続するスクリプトを散在させないでください。さもないと認証情報管理、利用量の観測、障害調査が制御不能になります。
- 認証情報を申請して保管する:API Key はサーバー側の環境変数またはシークレット管理サービスにのみ存在させ、フロントエンドコードに絶対に書き込まず、リポジトリに絶対にコミットしないでください。
- モデル識別子を確認する:呼び出し時に使うモデル名はドキュメントに記載された識別子と一致させ、綴りの違いによるルーティング失敗を避けてください。
- クォータとタイムアウトを定める:クライアント側で 1 回のリクエストのタイムアウトと最大リトライ回数を設定し、リトライ戦略をデフォルト値に任せないでください。
最小検証パス:1 回のリクエスト、4 つのチェックポイント
本格統合の前に、最小のリクエストで経路を通します。以下の順序で 1 項目ずつ確認し、どれか 1 つでも通らなければ立ち止まって調査し、コードを積み上げ続けないでください。
curl -sS https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.6-sol",
    "messages": [{"role": "user", "content": "用一句话说明你收到的指令。"}]
  }'
チェックポイント 1:疎通性。 リクエストが接続タイムアウトや DNS 失敗ではなく、HTTP レスポンスを取得できること。疎通しない場合はモデルを疑う前に、ネットワーク出口とプロキシ設定を優先して確認してください。
チェックポイント 2:認証。 401/403 が返らないこと。認証失敗は通常、Key の綴り、環境変数が注入されていない、Key が失効している、のいずれかです。1 つずつ排除すれば済みます。
チェックポイント 3:レスポンス構造。 レスポンス本体の構造がドキュメントの記述と一致し、テキスト内容のフィールドを特定できること。構造が合わない場合は、リクエスト本体のフィールド名の誤りやインターフェースバージョンの不一致を意味することが多いです。
チェックポイント 4:内容の妥当性。 出力が指令に対する正常な応答であること。ここまで来て初めて経路が本当に通ったことになります。
この 4 つのチェックポイントをチームの入門チェックリストに書き込み、新しいメンバーが接続する際にその通りに進めれば、「ドキュメントと同じなのになぜ通らないのか」というコミュニケーションコストを大幅に削減できます。
リクエストパラメータと出力制御の重要な意思決定
テキストモデルの呼び出しパラメータは多くありませんが、それぞれが一種のエンジニアリング上のトレードオフに対応します。以下は「どんな状況で何を調整するか」という判断フレームワークです。具体的な値の範囲は HiAPI.ai のドキュメントを基準にし、記憶で数値を埋めないでください。
指令とコンテキスト:あらゆるパラメータより優先する
出力が期待に合わない場合、第一優先は常にプロンプトの書き直しであり、パラメータ調整ではありません。タスクの目標、入力データの境界、期待する出力形式を明確に書くことが、通常どんなパラメータ調整よりも有効です。マルチターン対話のシナリオでは、履歴メッセージのトリミング戦略(何ターン保持するか、どう要約圧縮するか)が効果とコストに与える影響は、単発のパラメータ微調整よりも大きいことが多いです。
出力長の上限:用途で決め、気分で決めない
- 抽出、分類、スコアリング系タスク:上限はちょうど足りる程度に抑える。余分な余裕は無意味な続きの生成に浪費されます。
- 要約、書き換え系タスク:目標テキスト長に合理的な余裕を加える。
- オープンエンドな生成:ここで初めて上限を緩める必要があります。
出力長の上限はコストにもレイテンシにも影響します。出力が長いほどデコード時間が長くなり、両者は同じ方向に変化します。
ランダム性関連パラメータ:「安定させたい」と「多様にしたい」を区別する
抽出、判定、フォーマット出力のようなタスクは結果をできるだけ安定させたいので、ランダム性を低く抑えるべきです。クリエイティブライティング、ブレインストーミング、候補生成のようなタスクでこそ緩める必要があります。チーム内ではこの約束をコードのラッパー層に書き込むのが望ましく、各呼び出し箇所がそれぞれ値を設定しないようにしてください。
構造化出力:制約で安定性を買う
下流で結果をパースするなら、プロンプトでスキーマを明示し、コード側で厳密な検証と失敗時のフォールバックを行うべきです。「モデルが JSON を出力したと言っている」ことを信じてはいけません。常にパーサーで 1 回受け止めてください。パース失敗時のリトライ戦略(訂正ヒント付きの 2 回目のリクエスト)は、無限リトライよりも割に合います。
停止条件とストリーミング返却
切り捨て位置を制御する必要がある場合は停止シーケンスを設定します。ユーザー向けの対話インターフェースではストリーミング返却で最初の文字の遅延を下げ、バックグラウンドのバッチ処理ではストリーミングは不要で、かえって処理の複雑さを増します。この 2 つはシナリオごとの意思決定であり、全局的な最適解ではありません。
token 課金におけるコスト構造
gpt-5.6-sol は token 単位で課金されます。この点を理解することは、どんな単価を覚えるよりも重要です。単価は変わりますが、計量ロジックは変わらないからです。
1 回のリクエストは 2 段階に分けて課金される
入力 token:システムプロンプト、履歴メッセージ、検索されたコンテキスト、ユーザーの今回の入力、すべてが計上されます。出力 token:モデルが生成した内容が、実際の産出長に応じて計上されます。2 段階はそれぞれ計量・課金され、具体的な単価は HiAPI.ai サイトの価格パネルを基準にしてください。
ここから非常に有用なメンタルモデルが得られます:コスト ≈ 入力規模 × 入力側消費 + 出力規模 × 出力側消費。オンラインの請求異常のほとんどは、この 2 つの乗数のうちに原因が見つかります。
コスト漏れの 4 つの高頻度ポイント
- コンテキストの膨張:文書全体やログ全体をトリミングせずにプロンプトに詰め込むと、入力 token が線形に増加し、しかも効果が必ずしも良くなるとは限りません。
- 履歴の無制限な累積:マルチターン会話でウィンドウ管理を行わないと、ターンが増えるほど 1 回のリクエストが高くなり、コストは対話長に対して非線形に増加します。
- 出力の暴走:長さの上限を設定しないと、モデルが自由に語り、出力 token が無駄に消費されます。
- リトライの嵐:失敗時のリトライにバックオフと上限がないと、1 回の揺らぎが 1 回分の請求に増幅されます。
事後に驚くのではなく、可観測性を確立する
ラッパー層で毎回の呼び出しの入力 token、出力 token、所要時間、ビジネス識別子を統一的に記録し、インターフェース別、テナント別、機能別に集計します。観測のないコスト管理は管理していないのと同じです。 「単一リクエストの token 上限」「単一ユーザーの日次累計上限」「異常増幅アラート」の 3 つを基本ガードレールとして、ビジネスコードに散在させるのではなく、ゲートウェイまたはラッパー層で実装することを推奨します。
キャッシュとバッチの位置づけ
同一または高度に類似したリクエストは結果をキャッシュし、キャッシュヒット時は呼び出しをスキップできます。オフラインタスクはできるだけバッチ処理にまとめ、重複するシステムプロンプトのオーバーヘッドを減らします。これら 2 つの最適化の收益は、通常パラメータ調整よりも直接的です。
典型的な使い方と効果増幅のテクニック
同じモデルでも、プロンプト構造が一段違うと、産出品質が一桁違うことがあります。以下のパターンはテキスト系業務で再利用度が最も高いものです。
抽出と構造化:まずスキーマを定め、それからサンプルを与える
目標フィールド、型、値の範囲を明確に書き、入力と出力のサンプルを 1〜2 個添えます。サンプルは形容詞よりはるかに有効です。出力後はパーサーで検証し、フィールド欠落や型不一致の場合は訂正リトライを行い、半成品を受け入れないでください。
分類と判定:判断基準を明示化する
「このコメントがネガティブかどうか判定して」と言うだけでなく、判定境界を列挙します。どの表現がネガティブに該当するか、中立はどう扱うか、曖昧なケースはどのカテゴリに帰すか。基準が明示的であるほど、バッチ間の一貫性が良くなります。
長文処理:分割 + 集約の 2 段階方式
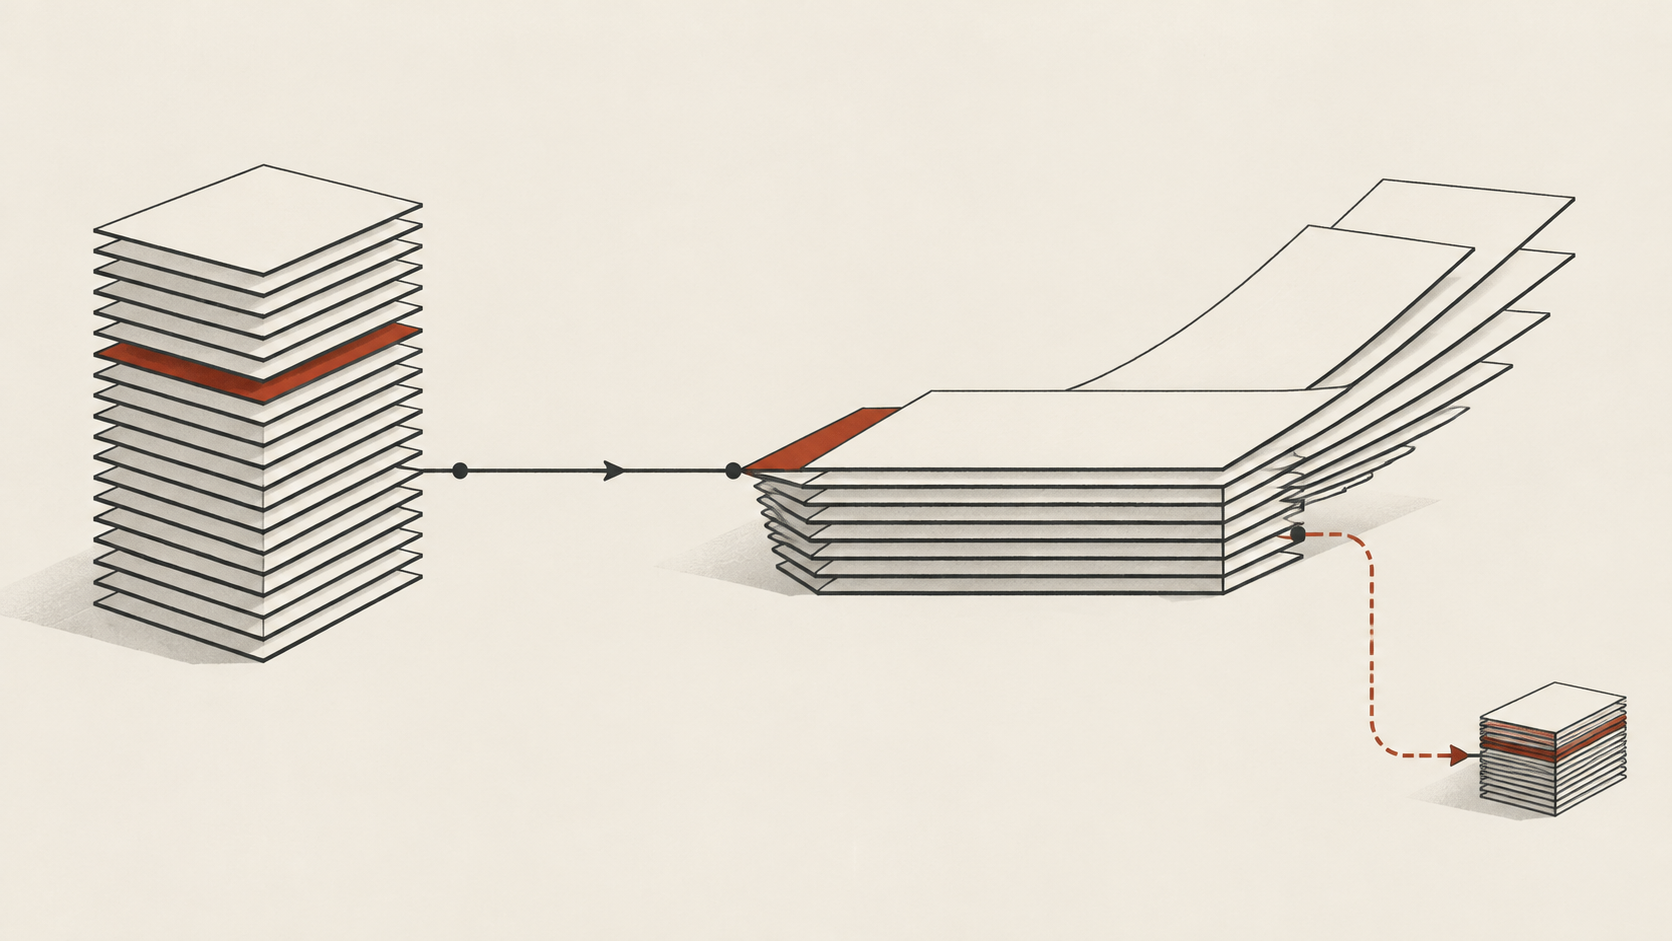
快適な長さを超える文書は、まず分割処理で局所的な結論を得て、それから 1 回集約と归纳を行います。これにより単回の入力規模を制御しつつ、各ステップの産出を検証可能・再実行可能にします。
生成系タスク:まず候補を出し、それから選別する
モデルに一度に複数の候補を出させ、ルールまたは 2 回目の呼び出しで優劣を選びます。生成品質は候補数で高め、安定性は選別工程で担保します。
プロンプト構造の 3 つの経験則
- 役割とタスクを分離する:「あなたは誰か」と「あなたは何をするか」を分けて書き、互いに希釈し合わないようにします。
- 制約を前置する:形式要件、禁止事項、長さ制限を前の方に置きます。モデルは前置された制約への遵守度が通常より高いです。
- サンプル即仕様:10 文で説明するより、良い入力と出力のペアを 1 つ与える方が有効です。
これらのパターンをチーム内部のプロンプトテンプレートライブラリとして蓄積し、新しいシナリオではゼロから書くのではなく優先的に再利用することが、最も省力な効果増幅手段です。
リリース後の観測とトラブルシューティングの順序
オンラインで問題が起きたとき、最も高くつくのは修正ではなく発見です。トラブルシューティングの順序を固定すれば、特定時間を最短に抑えられます。
第一層:まず「通らない」のか「正しくない」のかを確認する
通らないとはリクエストの失敗を指します。タイムアウト、レート制限、認証エラー、サーバー側の 5xx。正しくないとはリクエストは成功したが出力品質が異常なことを指します。この 2 種類は調査経路がまったく異なるため、まず区別してから動いてください。
第二層:通らない場合は経路を逆にたどる
- エラーコードを見る:4xx は認証情報、リクエスト本体の形式、モデル識別子を優先的に疑う。5xx とタイムアウトは上流の揺らぎと容量問題を優先的に疑う。
- 時間分布を見る:全部失敗か、特定の時間帯や特定のテナントの失敗か。全量失敗は通常、設定変更が原因。局所的な失敗はクォータやネットワーク問題に近い。
- 最近の変更を見る:キーのローテーション、ゲートウェイ設定、依存関係のアップグレード。突発的な障害のほとんどは 1 回の変更に対応付けられます。
- 耐えるのではなくフォールバックする:上流が利用不可と確認できたら、事前に設計したフォールバック経路(次の節を参照)に従う。リトライで問題を増幅させないでください。
第三層:正しくない場合は入力を逆にたどる
出力品質の低下は、9 割以上が入力と関係しています:
- プロンプトが変更されていないか:テンプレートの更新、変数の組み立てミス、エスケープ問題は、いずれも知らぬ間に意味を変えます。
- コンテキストが汚染されていないか:検索された断片が関連しているか、切り捨てによる文の途切れがないか。
- データ分布が漂移していないか:業務入力そのものが変わり、古いプロンプトが自然と無効になっていないか。
- パラメータが誤設定されていないか:ランダム性パラメータが高くされ、出力上限が低く抑えられると、いずれも「モデルが馬鹿になった」ように見えます。
第四層:レイテンシとコストの曲線を見る
レイテンシが急増してもエラー率が正常なら、通常は出力が長くなったか上流で待ち行列が発生しています。コストが急増しても呼び出し量が正常なら、通常は単一リクエストのサイズが大きくなっています。レイテンシ、token 使用量、エラー率の 3 本の曲線を同じダッシュボードに置けば、異常は自然と浮かび上がります。
推奨:上記の順序を runbook として固定化し、各項目に対応する具体的なクエリ文やダッシュボードリンクを付け、当番のメンバーがその通りに進められるようにし、個人の経験に依存しないようにしてください。
いつモデルを切り替えるべきか、いつフォールバックすべきか
システムを単一モデルに縛り付けることは、可用性を他人の気分に委ねることです。マルチモデル共存は過剰設計ではなく、エンジニアリングの常識です。
フォールバックすべき 3 つのシグナル
シグナル 1:可用性の揺らぎ。 エラー率またはタイムアウト率が閾値を越え、かつ短時間で回復できない場合は、自動的にバックアップモデルに切り替えるか、フローを簡素化する(例:キャッシュ結果を返す、有人キューに回す)べきです。
シグナル 2:コストの越線。 ある業務ラインの単位産出コストが継続的に上昇しているなら、そのシナリオには現在のグレードのモデル能力が不要である可能性を示します。リクエストの一部をより軽量なモデルに分流することを検討できます。
シグナル 3:レイテンシが基準未達。 対話型シナリオは最初の文字の遅延に敏感です。モデルの応答が構造的に予算を超える場合は、全局的に我慢するのではなく、シナリオ別に分割すべきです。
フォールバックの実装方法:一刀切りではなく段階化
ラッパー層にモデルの段階表を確立します。主モデル、バックアップモデル、軽量モデル。ルーティングの根拠は業務シナリオのタグとリアルタイムの健康度であり、ビジネスコードにハードコードしません。これにより切り替え操作は設定変更だけで済み、リリースは不要です。
再選定すべき判断基準
定期的(例:四半期ごと)に選定の振り返りを行い、3 つの問いを見ます:
- 能力が過剰か:現在のタスクが軽量モデルでも安定して基準を満たせるなら、高グレードのモデルを使い続けるのは純粋なコスト浪費です。
- 能力が不足か:多数のリクエストが複雑なプロンプトによる補救を必要とし、リトライ率が高いままなら、モデルとタスクが不適合であることを示します。
- バインドリスクが制御可能か:明確な代替経路があるか、代替案を検証する実行可能な回帰テストセットがあるか。
回帰テストセットは選定振り返りのインフラストラクチャです。 ラベル付きの実サンプル群がなければ、どんな「モデルを替えた方が良い」という判断も感覚です。リリース初日からサンプルを蓄積し、モデルを替えるたびにまず比較を一通り実行することを推奨します。
一言原則
モデルを代替可能なコンポーネントにし、システムの土台にしないこと。呼び出しを統一インターフェースに集約し、プロンプトとパラメータをラッパー層に集約し、評価をテストセットに集約する。この 3 点を実現すれば、モデルの切り替えは再構築ではなく 1 回の設定変更にすぎません。


