
Guida all'uso
Guida introduttiva a gpt-5.6-sol: limiti delle capacità, integrazione API e controllo dei costi
Dal giudizio sulle capacità alla risoluzione dei problemi di integrazione: un percorso pratico per i team di ingegneria
Prima di tutto, chiarire cosa è e cosa non è gpt-5.6-sol
Nelle discussioni sulla scelta del modello, l'errore più frequente non è «questo modello è potente o no», ma «è davvero il tipo di cosa che mi serve». gpt-5.6-sol è fornito da OpenAI e il tipo di output è testo. Questi due fatti sembrano banali, ma determinano direttamente tutte le tue decisioni ingegneristiche successive.
È un modello testo-in, testo-out
Quando inserisci gpt-5.6-sol nell'architettura del sistema, la posizione che può occupare è: riceve input testuali e restituisce output testuali. Tutte le valutazioni sulle capacità dovrebbero svilupparsi attorno a questa catena: sul lato input ci sono prompt, frammenti di contesto, stringhe serializzate da dati strutturati; sul lato output ci sono risultati in forma testuale come linguaggio naturale, JSON, frammenti di codice, etichette di classificazione.
Non è un canale di input/output multimodale
Ciò significa che non dovresti dare per scontato che gestisca esigenze come: trascrizione vocale, comprensione di immagini, generazione di immagini, elaborazione video, streaming audio in tempo reale. Se nel tuo flusso di business coesistono fasi testuali e non testuali, l'approccio corretto è affidare le fasi non testuali a componenti dedicati e poi serializzare i risultati intermedi in testo da passare a gpt-5.6-sol per l'inferenza e l'organizzazione, invece di cercare di fargli coprire l'intera catena.
Per decidere se integrarlo, poni prima tre domande
Primo: il tuo compito può essere espresso come «dato un testo, produrne un altro»? Riassunto, riscrittura, estrazione, classificazione, dialogo, completamento di codice, generazione di dati strutturati: tutti rientrano.
Secondo: hai bisogno di output deterministici strettamente riproducibili? Gli output dei modelli generativi testuali presentano naturalmente una certa variabilità. Se il business richiede idempotenza carattere per carattere (ad esempio riconciliazioni, messaggi firmati), non è adatto come unico esecutore; è più adatto in una fase in cui genera candidati e poi le regole li validano.
Terzo: il tuo budget di latenza consente un'inferenza completa del modello? I modelli testuali di solito non sono adatti a catene sincrone a livello di microsecondi. Il loro ambiente ideale sono scenari asincroni, a batch e interattivi con cache.
Se superi tutte e tre le domande, questo modello merita di entrare nel tuo pool di candidati; se una si blocca, dovresti prima risolvere il design della catena, non sperare che i parametri del modello ti salvino.
Preparazione prima dell'integrazione e percorso di verifica minimo
Molti incidenti di integrazione non dipendono dal modello, ma dal fatto che il codice di produzione è stato distribuito senza completare i preparativi. Segui questo percorso minimo prima di parlare di integrazione.
Fase di preparazione: prima definisci i confini, poi ottieni le credenziali
- Definisci l'uscita del servizio: tutte le chiamate al modello passano dall'interfaccia unificata di HiAPI.ai; non lasciare che nel team ognuno abbia script di connessione diretta sparsi, altrimenti la gestione delle credenziali, il monitoraggio delle quote e la risoluzione dei guasti sfuggiranno al controllo.
- Richiedi e custodisci le credenziali: la API Key esiste solo nelle variabili d'ambiente lato server o nel servizio di gestione delle chiavi, mai nel codice frontend, mai committata nel repository.
- Conferma l'identificativo del modello: il nome del modello usato nelle chiamate deve corrispondere all'identificativo indicato nella documentazione, per evitare errori di routing dovuti a differenze di ortografia.
- Definisci quote e timeout: imposta già nel client il timeout per singola richiesta e il numero massimo di tentativi; non lasciare la strategia di retry ai valori predefiniti.
Percorso di verifica minimo: una richiesta, quattro checkpoint
Prima dell'integrazione formale, usa una richiesta minima per aprire la catena. Si consiglia di verificare i punti nell'ordine seguente; se uno non passa, fermati e indaga, non continuare ad aggiungere codice.
curl -sS https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.6-sol",
    "messages": [{"role": "user", "content": "Spiega in una frase l'istruzione che hai ricevuto."}]
  }'
Checkpoint uno: connettività. La richiesta ottiene una risposta HTTP, non un timeout di connessione o un errore DNS. Se non si connette, controlla prima l'uscita di rete e la configurazione del proxy, non sospettare del modello.
Checkpoint due: autenticazione. La risposta non è 401/403. Un errore di autenticazione di solito è dovuto a una API Key scritta male, a una variabile d'ambiente non iniettata o a una chiave scaduta; escludili uno per uno.
Checkpoint tre: struttura della risposta. La struttura del corpo della risposta corrisponde a quanto descritto nella documentazione e si riesce a individuare il campo del contenuto testuale. Una struttura diversa spesso indica un nome di campo errato nel corpo della richiesta o una versione dell'interfaccia incoerente.
Checkpoint quattro: sensatezza del contenuto. L'output è una risposta normale all'istruzione. A questo punto la catena è davvero aperta.
Inserisci questi quattro checkpoint nella checklist di onboarding del team; i nuovi colleghi possono seguirli e si risparmia molto costo di comunicazione del tipo «la documentazione è la stessa, perché a me non funziona».
Decisioni chiave su parametri di richiesta e controllo dell'output
I parametri di chiamata di un modello testuale non sono molti, ma ognuno corrisponde a un tipo di compromesso ingegneristico. Quella che segue è una griglia decisionale del tipo «in quale situazione regolare cosa»; gli intervalli di valori specifici fanno fede la documentazione di HiAPI.ai, non inserire numeri a memoria.
Istruzioni e contesto: prima di ogni parametro
Quando l'output non è quello atteso, la prima priorità è sempre riscrivere il prompt, non regolare i parametri. Scrivere chiaramente l'obiettivo del compito, i confini dei dati di input e il formato di output atteso è di solito più efficace di qualsiasi tuning. Negli scenari multi-turno, la strategia di ritaglio della cronologia (quanti turni mantenere, come riassumere e comprimere) ha spesso un impatto maggiore su qualità e costi rispetto alla messa a punto dei singoli parametri.
Limite massimo di lunghezza dell'output: impostalo in base all'uso, non all'umore
- Compiti di estrazione, classificazione e scoring: abbassa il limite a quanto basta, il margine in eccesso viene sprecato in continuazioni senza senso.
- Compiti di riassunto e riscrittura: aggiungi una ridondanza ragionevole alla lunghezza del testo obiettivo.
- Solo per la generazione aperta è necessario allargare il limite.
Il limite massimo dell'output influenza sia i costi sia la latenza: più lungo è l'output, più tempo richiede la decodifica; i due variano nella stessa direzione.
Parametri legati alla casualità: distinguere «stabilità» e «varietà»
Compiti come estrazione, decisione e output formattati desiderano risultati il più possibile stabili e dovrebbero ridurre la casualità; solo compiti come scrittura creativa, brainstorming e generazione di candidati richiedono di allargarla. È meglio scrivere questa convenzione nel layer di incapsulamento del team, invece di lasciare che ogni punto di chiamata imposti valori propri.
Output strutturato: scambiare stabilità con vincoli
Se il downstream deve analizzare i risultati, bisogna specificare chiaramente lo schema nel prompt e fare validazione rigorosa e fallback in caso di errore nel codice. Non fidarti del fatto che «il modello dice che sta producendo JSON»: fai sempre passare il risultato da un parser. In caso di parsing fallito, una strategia di retry (seconda richiesta con prompt correttivo) è più conveniente di un retry infinito.
Condizioni di stop e risposta in streaming
Configura le sequenze di stop quando devi controllare il punto di troncamento; usa lo streaming nelle interfacce utente interattive per ridurre la latenza del primo carattere, mentre per l'elaborazione batch in background non serve lo streaming, che anzi aumenta la complessità. Queste sono decisioni legate allo scenario, non soluzioni ottimali globali.
La struttura dei costi con la tariffazione a token
gpt-5.6-sol è tariffato a token. Capire questo punto è più importante che memorizzare qualsiasi prezzo unitario, perché il prezzo unitario cambia, la logica di misurazione no.
Una richiesta è suddivisa in due segmenti di addebito
Token di input: prompt di sistema, messaggi storici, contesto recuperato, input dell'utente nel turno corrente, tutto conteggiato. Token di output: il contenuto generato dal modello, conteggiato in base alla lunghezza effettivamente prodotta. I due segmenti sono misurati e tariffati separatamente; i prezzi unitari specifici fanno fede il pannello prezzi del sito HiAPI.ai.
Da qui si ricava un modello mentale molto utile: costo ≈ dimensione input × consumo lato input + dimensione output × consumo lato output. La stragrande maggioranza delle anomalie di fatturazione online può trovare la causa in questi due moltiplicatori.
I quattro punti più frequenti di dispersione dei costi
- Gonfiamento del contesto: inserire interi documenti o interi log nel prompt senza ritaglio fa crescere linearmente i token di input, e il risultato non è necessariamente migliore.
- Accumulo illimitato della cronologia: nelle conversazioni multi-turno senza gestione della finestra, più turni significano richieste singole più costose, con costi che crescono in modo non lineare con la lunghezza della conversazione.
- Output fuori controllo: senza limite di lunghezza, il modello parla liberamente e i token di output vengono bruciati inutilmente.
- Tempesta di retry: retry senza backoff e senza limite trasformano una singola oscillazione in una bolletta.
Costruisci l'osservabilità, invece di stupirti dopo
Nel layer di incapsulamento registra in modo unificato per ogni chiamata i token di input, i token di output, il tempo di esecuzione e l'identificativo di business; aggrega per interfaccia, per tenant, per funzionalità. Controllo dei costi senza osservabilità equivale a nessun controllo. Si consiglia di implementare come protezioni di base tre regole: «limite massimo di token per richiesta», «limite massimo cumulativo giornaliero per utente», «allarme per amplificazione anomala», nel gateway o nel layer di incapsulamento, non sparse nel codice di business.
Dove collocare cache e batch
Richieste identiche o molto simili possono essere messe in cache e, se la cache colpisce, si salta la chiamata; i compiti offline vanno per quanto possibile raggruppati in batch per ridurre il costo ripetuto del prompt di sistema. Il guadagno di queste due ottimizzazioni è di solito più diretto del tuning dei parametri.
Utilizzi tipici e tecniche per amplificare i risultati
Con lo stesso modello, se la struttura del prompt è un livello diversa, la qualità del risultato può differire di un ordine di grandezza. I seguenti schemi sono quelli più riutilizzati nei business testuali.
Estrazione e strutturazione: prima definisci lo schema, poi fornisci esempi
Scrivi chiaramente campi obiettivo, tipi e intervalli di valori, e allega uno o due esempi di input/output. Gli esempi sono molto più efficaci degli aggettivi. Dopo l'output, valida con un parser; se un campo manca o il tipo non corrisponde, fai un retry correttivo invece di accettare un risultato a metà.
Classificazione e decisione: rendi espliciti i criteri
Non dire solo «giudica se questo commento è negativo», ma elenca i confini decisionali: quali espressioni contano come negative, come trattare i casi neutri, in quale categoria inserire i casi ambigui. Più espliciti sono i criteri, migliore è la coerenza tra batch.
Elaborazione di testi lunghi: due fasi, segmentazione + sintesi
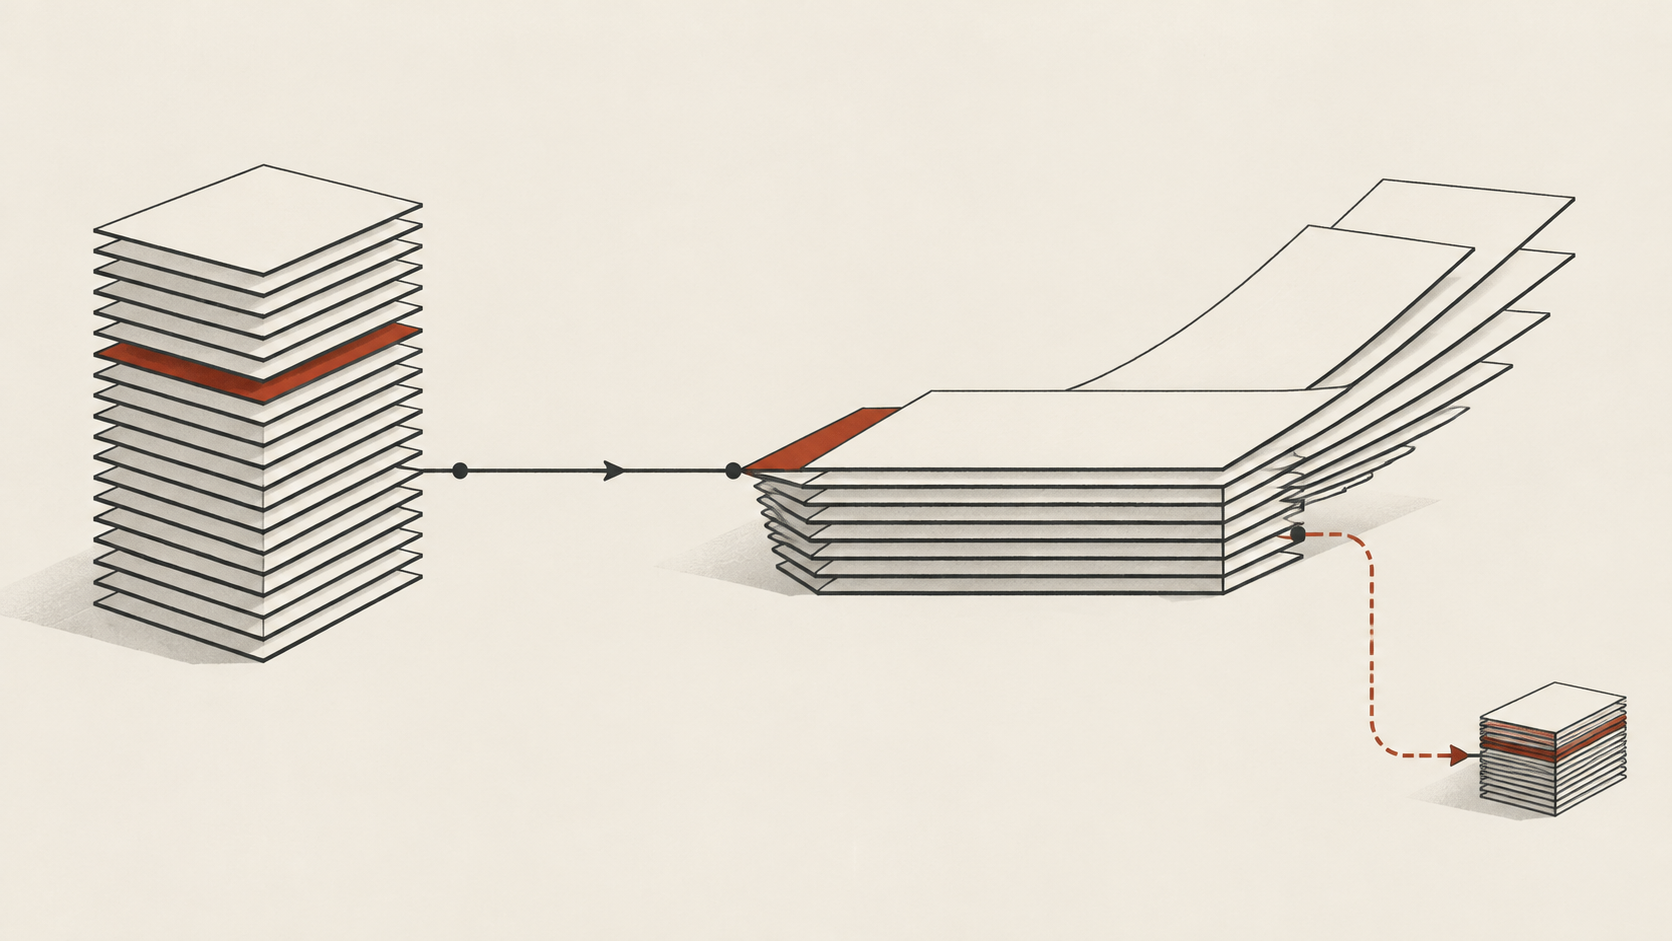
Per documenti che superano la lunghezza comfort, prima usa l'elaborazione a segmenti per ottenere conclusioni locali, poi fai una sintesi complessiva. Così si controlla la dimensione dell'input singolo e ogni passo produce risultati verificabili e rieseguibili.
Compiti generativi: prima produci candidati, poi seleziona
Chiedi al modello di produrre più candidati in una volta, poi usa regole o una seconda chiamata per scegliere il migliore. La qualità della generazione migliora con il numero di candidati, la stabilità è garantita dalla fase di selezione.
Tre esperienze sulla struttura del prompt
- Separare ruolo e compito: scrivi separatamente «chi sei» e «cosa devi fare», per evitare che si diluiscano a vicenda.
- Vincoli in testa: requisiti di formato, divieti e limiti di lunghezza vanno nelle prime posizioni; il modello di solito rispetta meglio i vincoli iniziali.
- L'esempio è la specifica: invece di descrivere in dieci frasi, fornisci una buona coppia input/output.
Consolidare questi schemi in una libreria di template di prompt interna al team, e riutilizzarli per i nuovi scenari invece di scrivere da zero, è il modo più semplice per amplificare i risultati.
Osservazione e ordine di troubleshooting dopo il go-live
Quando sorgono problemi online, la cosa più costosa non è correggere, ma trovare. Un ordine di indagine fisso può ridurre al minimo il tempo di localizzazione.
Primo livello: conferma prima se è «non funziona» o «non è corretto»
Non funziona significa richiesta fallita: timeout, rate limit, errore di autenticazione, 5xx lato server. Non è corretto significa richiesta riuscita ma qualità dell'output anomala. I percorsi di indagine per questi due tipi sono completamente diversi; prima distinguili, poi agisci.
Secondo livello: se non funziona, risali la catena
- Guarda il codice di errore: per 4xx sospetta prima credenziali, formato del corpo della richiesta, identificativo del modello; per 5xx e timeout sospetta prima oscillazioni upstream e problemi di capacità.
- Guarda la distribuzione temporale: falliscono tutti o solo in fasce orarie specifiche, o per tenant specifici. Un fallimento totale di solito deriva da un cambio di configurazione; un fallimento parziale assomiglia più a un problema di quota o di rete.
- Guarda le modifiche recenti: rotazione delle chiavi, configurazione del gateway, aggiornamento delle dipendenze — la stragrande maggioranza dei guasti improvvisi corrisponde a una modifica.
- Degrada invece di resistere: se confermi che l'upstream non è disponibile, segui il percorso di fallback predefinito (vedi sezione successiva), non lasciare che i retry amplifichino il problema.
Terzo livello: se non è corretto, risali dall'input
Il calo della qualità dell'output è in oltre il 90% dei casi legato all'input:
- Il prompt è stato modificato: aggiornamenti dei template, errori di assemblaggio delle variabili, problemi di escaping cambiano silenziosamente la semantica.
- Il contesto è contaminato: i frammenti recuperati sono pertinenti, ci sono frasi troncate a metà.
- La distribuzione dei dati è cambiata: l'input di business stesso è cambiato, il vecchio prompt non è più valido.
- I parametri sono stati impostati male: parametri di casualità alzati, limite di output troppo basso, si manifestano come «il modello è diventato stupido».
Quarto livello: guarda le curve di latenza e costi
Latenza improvvisamente aumentata ma tasso di errore normale di solito significa output più lunghi o code upstream; costi improvvisamente aumentati ma volume di chiamate normale di solito significa richieste singole più grandi. Metti le tre curve di latenza, consumo di token e tasso di errore sulla stessa dashboard: le anomalie emergeranno da sole.
Consiglio: consolida l'ordine sopra in un runbook, con ogni voce collegata alla query o al link della dashboard specifica, così il collega di turno può seguirlo senza dipendere dall'esperienza personale.
Quando cambiare modello o fare degrado
Legare il sistema a un unico modello significa affidare la disponibilità all'umore di qualcun altro. La coesistenza di più modelli non è over-engineering, ma buon senso ingegneristico.
Tre segnali per fare degrado
Segnale uno: oscillazione della disponibilità. Il tasso di errore o di timeout supera la soglia e non si ripristina in breve tempo: bisogna passare automaticamente a un modello di riserva o semplificare il flusso (ad esempio restituire risultati in cache, passare a una coda manuale).
Segnale due: costi fuori linea. Il costo per unità di output di una linea di business continua a salire: significa che quello scenario potrebbe non richiedere le capacità del modello di fascia attuale, si può valutare di dirottare parte delle richieste verso modelli più leggeri.
Segnale tre: latenza fuori target. Gli scenari interattivi sono sensibili alla latenza del primo carattere; quando la risposta del modello supera strutturalmente il budget, bisogna separare per scenario, non sopportare globalmente.
Come implementare il degrado: a livelli, non tutto o niente
Crea nel layer di incapsulamento una tabella di livelli dei modelli: modello principale, modello di riserva, modello leggero. Il routing si basa su etichette di scenario di business e sullo stato di salute in tempo reale, non è codificato nel codice di business. Così il cambio richiede solo una modifica di configurazione, non un rilascio.
Criteri per decidere se riselezionare il modello
Fai periodicamente (ad esempio ogni trimestre) una revisione della scelta del modello, guardando tre domande:
- Le capacità sono eccessive: se il compito attuale può essere raggiunto in modo stabile con un modello leggero, continuare a usare un modello di fascia alta è puro spreco di costo.
- Le capacità sono insufficienti: se molte richieste richiedono prompt complessi per essere recuperate e il tasso di retry resta alto, il modello e il compito non sono allineati.
- Il rischio di lock-in è controllabile: esiste un percorso alternativo chiaro, esiste un set di test di regressione eseguibile per validare l'alternativa.
Il set di test di regressione è l'infrastruttura della revisione della scelta del modello. Senza un set di campioni reali annotati, qualsiasi giudizio «cambiare modello è meglio» è solo una sensazione. Si consiglia di iniziare a raccogliere campioni dal primo giorno del go-live e di eseguire un confronto a ogni cambio di modello.
Un principio in una frase
Fai del modello un componente sostituibile, non le fondamenta del sistema. Convogliare le chiamate verso un'interfaccia unificata, convogliare prompt e parametri nel layer di incapsulamento, convogliare la valutazione nel set di test: fatto questo, cambiare modello è solo una modifica di configurazione, non un refactoring.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori