
Comparatif et évaluation
gpt-image-2.6-sunburst/text-to-image 选型指南:按每张图定价做横向对比
De la granularité de facturation à la forme de sortie en passant par le coût d'intégration, aidez l'équipe d'ingénierie à décider s'il faut l'utiliser
Sur cette page
Ce modèle résout quel problème
Commençons par le positionnement. gpt-image-2.6-sunburst/text-to-image est fourni par OpenAI, son type de sortie est l'image, et son périmètre de capacités se limite au text-to-image : on fournit un prompt textuel, on reçoit une image. Sa tarification adopte une granularité à la pièce.
Il ne prend pas en charge l'image-to-image, l'inpainting, l'édition multi-images ni la compréhension d'image ; ces sujets sortent du cadre de cet article. Cet article ne reprend pas non plus les formules promotionnelles génériques de la fiche modèle, mais répond à trois questions du point de vue d'une équipe d'ingénierie : comment la facturation à la pièce influence le modèle de coût, quelles dimensions examiner lors d'une comparaison transversale, et quel coût implique une migration depuis un modèle existant.
En une phrase, le périmètre d'application : si votre activité est une production standardisée de type « prompt en entrée, image finie en sortie », et que le coût unitaire peut être extrapolé linéairement avec le volume de requêtes, alors la forme de ce modèle est adaptée ; si vous avez besoin d'étapes intermédiaires contrôlables (par exemple spécifier le nombre d'étapes d'échantillonnage, contrôler les paliers de résolution pour une tarification fine), il faut d'abord vérifier si ces capacités existent, sans les présupposer.
Pour les détails de paramètres, limites de contexte, quotas de concurrence, etc., référez-vous à la page de détails du modèle et à la documentation de l'API ; cet article ne traite que du jugement au niveau du choix.
Le contrat minimal entrée/sortie
Du point de vue de l'intégration, le contrat de ce type d'API est très simple : le corps de la requête contient le prompt, éventuellement accompagné de champs optionnels comme la taille ou le nombre (voir la documentation), et la réponse contient le résultat image, qui peut être un flux binaire ou une URL à expiration. Lors du choix, il faut d'abord clarifier ce contrat, car il détermine votre stratégie de stockage, de nouvelle tentative et votre conception d'idempotence en aval.
Ce que signifie la facturation à la pièce
La caractéristique centrale de la facturation à la pièce : l'unité de facturation est le nombre d'images produites avec succès, et non le nombre de tokens consommés, d'étapes d'échantillonnage ou de secondes GPU. Le prix connu est de 0,023 $ par image ; cet article ne fait de calculs qu'à cette granularité, sans extrapoler aucune règle tarifaire non publiée.
Formule de coût
Coût d'une requête = nombre d'images demandées × prix unitaire. Coût mensuel = nombre d'images produites avec succès dans le mois × prix unitaire. Cette formule est si simple qu'elle semble inutile à écrire, mais elle entraîne deux conséquences d'ingénierie.
Premièrement, le coût est fortement lié à la « partie réussie des requêtes ». Si les requêtes échouées ne génèrent pas de facturation, le coût n'est pas affecté ; si une facturation partielle a lieu, il faut la distinguer dans les logs. La première chose à faire en ingénierie est de séparer trois indicateurs : « nombre de requêtes émises », « nombre d'images produites avec succès » et « nombre d'images facturées », plutôt que de les fusionner dans une vue QPS unique.
Deuxièmement, une nouvelle tentative équivaut directement à un risque de doublement du coût. Toute nouvelle tentative non idempotente peut produire en double et facturer en double. Les retries doivent donc avoir une limite, porter une clé d'idempotence, et pouvoir identifier le cas « la tentative précédente a en fait réussi, mais la réponse a expiré ».
Le surcoût des retries doit être modélisé séparément
Supposons qu'une requête métier déclenche en moyenne r tentatives (première comprise) ; le coût effectif comptable est alors multiplié par environ (1 + taux de tentatives supplémentaires). Ce coefficient est généralement dilué sur les modèles facturés au token, car un appel individuel est bon marché et l'incrément absolu d'un échec est faible ; mais avec une facturation à la pièce, chaque image est une unité de facturation complète, et l'ampleur absolue du surcoût de retry doit être inscrite dans le budget.
Différences avec la facturation à l'usage
Les modèles facturés sur des dimensions d'usage comme la résolution, les étapes ou les tokens ont une courbe de coût plus fine, mais plus difficile à prévoir : il faut d'abord connaître la distribution des requêtes typiques pour calculer une moyenne. L'avantage de la facturation à la pièce est sa prévisibilité — le métier dit « ce mois-ci, il faut produire 100 000 images », le budget est immédiatement calculable. L'inconvénient est le manque d'élasticité : vous ne pouvez pas réduire le coût unitaire en baissant la résolution, les seuls leviers de maîtrise des coûts sont « réduire le nombre d'images produites » et « augmenter le taux de réussite au premier essai ».
Protection contre les échecs et les quotas
Avec une facturation à la pièce, l'épuisement de quota et les erreurs de limitation ont un coût plus élevé, car leur fenêtre de retry contient un coût réel. Il est recommandé de fixer côté client une limite de concurrence, des quotas par image (et non par requête) par ligne métier, et de basculer vers des résultats en cache plutôt que de continuer à appeler l'API lorsque le quota approche de sa limite.
Quelles dimensions examiner en comparaison transversale
Ne comparez pas seulement les noms de modèles et les prix unitaires. L'ensemble de dimensions ci-dessous ne dépend d'aucun paramètre concret et peut être directement repris dans une grille d'évaluation.
Type de sortie et limites de capacités
Confirmez d'abord la forme de sortie : image seule, image plus description textuelle, ou prise en charge de plusieurs images en entrée. Confirmez ensuite le périmètre : uniquement text-to-image, ou incluant édition, retouche, extension. Plus les capacités sont étroites, plus l'API est stable, mais plus les besoins combinés du métier devront être assemblés par vous. L'avantage d'un text-to-image unique est la clarté des responsabilités, adapté à « une couche de capacité » plutôt qu'à « un produit ».
Mode d'appel
Retour synchrone, tâche asynchrone, retour en streaming : ces trois formes imposent des exigences totalement différentes à l'architecture client. L'API synchrone est la plus simple, mais les timeouts et les échecs en queue de distribution sont plus marqués ; la tâche asynchrone nécessite des requêtes de statut et des callbacks, coûteuse à intégrer mais plus contrôlable. Au moment du choix, demandez-vous : ma pile d'appels dispose-t-elle déjà d'une infrastructure de polling de tâches ?
Granularité de facturation
C'est la dimension centrale de cet article. Classez les modèles candidats en deux catégories : facturation à la pièce/à l'appel, et facturation sur des dimensions d'usage. La première convient aux activités de masse à coût prévisible, la seconde aux scénarios où la distribution des requêtes est très inégale et où une erreur d'estimation est acceptable. Ne comparez pas les deux avec le même modèle de coût, sinon la conclusion sera nécessairement fausse.
Besoins de contrôlabilité
Le métier exige-t-il des paliers de taille spécifiés, une cohérence de style, des graines aléatoires reproductibles ? Plus la contrôlabilité est forte, plus les paramètres d'API sont nombreux, plus le coût de migration est élevé. Inversement, si le métier a de faibles exigences de cohérence (par exemple des illustrations de contenu en volume), un modèle à capacité unique est plus simple à gérer.
Sensibilité à la latence
Distinguez « l'utilisateur attend en présence » et « le traitement par lots hors ligne ». Le premier est sensible à la latence de queue et nécessite une dégradation sur timeout et une image de secours ; le second tolère une latence de l'ordre de la minute et convient mieux à une forme de tâche asynchrone. Un même modèle peut obtenir des scores très différents dans ces deux types de scénarios.
Risque de verrouillage fournisseur
Évaluez trois choses : le protocole d'API est-il standard, les résultats retournés sont-ils directement migrables (URL ou binaire), et peut-on basculer entre plusieurs fournisseurs via un point d'entrée unifié. Ce dernier point détermine votre capacité future de négociation et de reprise après sinistre, et mérite d'être inscrit comme contrainte d'architecture dès la phase de choix.
Données et conformité
La stratégie de conservation des prompts et des productions, l'attribution de la responsabilité de la modération de contenu : ces éléments n'entrent pas dans la table de coûts mais peuvent bloquer la mise en production. Les clarifier à l'avance coûte bien moins cher que de découvrir une semaine avant le lancement qu'il faut modifier la chaîne.
Dans quels cas il est plus adapté
Compte tenu de la capacité unique de text-to-image et de la prévisibilité de la facturation à la pièce, les critères de décision sont assez clairs pour les types de scénarios suivants.
Production d'images en masse
Lorsque le besoin métier est « une production d'illustrations qui croît linéairement avec le volume de contenu », le modèle de coût linéaire de la facturation à la pièce est le plus adapté. Vous pouvez établir directement le budget par « nombre d'images prévues × prix unitaire », sans échantillonnage préalable de la distribution des requêtes. C'est son avantage le plus concret par rapport à la facturation à l'usage.
Validation de prototype et expérimentation en dark launch
Au stade où l'on valide « si la capacité de génération texte-image mérite d'être intégrée au produit », un modèle à API simple et à unité de facturation claire réduit au maximum le cycle de validation. L'équipe n'a pas besoin de construire d'abord un système de paliers de résolution, ni de régler des paramètres pour économiser.
Production de contenu à bas coût en volume
Pour les scénarios à faible exigence de cohérence et où un échec peut être relancé (illustrations de pages de liste, premières versions de supports marketing, illustrations de plateformes de contenu), la facturation à la pièce combinée à une limite de retries constitue une structure de coût acceptable.
À l'inverse, dans quels cas ne pas le choisir
Premièrement, les scénarios nécessitant un contrôle fin des paliers de coût unitaire. Si le produit exige « un aperçu basse définition sur un canal bon marché, un rendu haute définition sur un canal coûteux », et que le modèle n'expose pas ces paliers, vous ne pourrez que sous-échantillonner en post-traitement, sans obtenir l'avantage de coût.
Deuxièmement, les scénarios nécessitant édition d'image, inpainting, itérations multiples. Une capacité text-to-image unique ne peut les couvrir ; un assemblage forcé entraînera des appels multiples, et avec la facturation à la pièce, chaque tour est une unité de facturation complète, le coût total dépassera rapidement les prévisions.
Troisièmement, les scénarios à forte exigence de cohérence de sortie, par exemple une série de supports exigeant un style strictement uniforme. Dans ce cas, le poids de la contrôlabilité dépasse celui du prix unitaire ; privilégiez les solutions plus contrôlables.
Quatrièmement, les scénarios temps réel extrêmement sensibles à la latence et sans solution de secours. Si après un timeout aucune dégradation n'est possible, les retries sous facturation à la pièce amplifieront à la fois la latence et le coût.
Un ordre de décision simple
Demandez d'abord « le nombre d'images en sortie est-il prévisible », puis « faut-il des capacités d'édition », enfin « exige-t-on une forte cohérence ». Si l'une des trois réponses est négative, il faut élargir la liste des candidats plutôt que de forcer le choix.
Implémentation de l'intégration et pièges courants
Voici la chaîne minimale viable d'intégration d'un text-to-image, indépendante des paramètres concrets, directement applicable.
Authentification et construction des requêtes
La clé ne doit résider que côté serveur, jamais côté client. Dans le corps de la requête, le prompt est le seul champ obligatoire ; tous les autres champs doivent être explicitement transmis avec leur valeur par défaut, pour éviter une dérive implicite due à un changement de comportement par défaut en amont. Générez une clé d'idempotence côté métier pour chaque requête, consignée dans les logs et dans l'en-tête (ou un champ de métadonnées, voir la documentation) : c'est la base de la sécurité des retries ultérieurs.
Timeout, retry et idempotence
for attempt in 1..max_attempts:
  resp = call_api(prompt, idempotency_key, timeout=T)
  if resp.ok: break
  if resp.status in (400, 401, 403): break   # non réessayable
  if resp.status == 429 or resp.status >= 500: sleep(backoff(attempt)); continue
Trois points essentiels :
- Un timeout n'est pas un échec. Après un timeout, consultez d'abord le résultat (si l'API permet une requête par clé d'idempotence ou ID de tâche), puis décidez de renvoyer ou non.
- Les 4xx ne sont jamais réessayés, en particulier les erreurs de paramètres et d'authentification ; un retry ne ferait que consommer du quota.
- La limite de retries doit être codée en dur, et sous facturation à la pièce, une alerte de coût « cette requête a déjà été réessayée N fois » est nécessaire.
Stockage des résultats
Ne dépendez pas à long terme des URL temporaires retournées. Dès réception du résultat, transférez-le immédiatement vers votre propre stockage objet, et enregistrez dans la table métier la correspondance « clé d'idempotence → chemin de stockage → nombre d'images facturées ». Cette correspondance est la seule base du rapprochement ultérieur.
Quatre pièges courants
Piège 1 : traiter un timeout comme un échec et renvoyer directement. En amont, l'image a en fait déjà été produite et facturée ; un renvoi double le coût.
Piège 2 : absence de quota par nombre d'images. En limitant seulement le QPS sans limiter le nombre d'images, une seule tâche de lot peut faire exploser le budget mensuel.
Piège 3 : versionnage absent des prompts assemblés. En cas de fluctuation de qualité, impossible de déterminer si le prompt ou le modèle a changé ; aucun retour arrière possible. Attribuez un numéro de version aux modèles de prompt.
Piège 4 : insérer une API synchrone dans le chemin de requête utilisateur. Une instabilité en amont se transforme directement en timeout de page, sans possibilité de dégradation. Passez par une tâche asynchrone ou ajoutez une image de secours.
Ébauche d'une couche d'appel unifiée
Il est recommandé d'ajouter une fine couche d'adaptation entre le code métier et l'API du modèle, en abstraant au minimum trois méthodes : generate(prompt, opts), poll(taskId), estimateCost(n). Les deux premières isolent les différences de protocole, la troisième permet au métier de voir le coût estimé en nombre d'images avant de soumettre la tâche, évitant une dérive budgétaire.
Points d'attention pour la migration et le basculement progressif
Pour passer d'un modèle d'image existant à gpt-image-2.6-sunburst/text-to-image, l'ordre importe plus que la vitesse.
Première étape : comparaison en trafic fantôme
Ne basculez pas immédiatement le trafic réel. Dupliquez les requêtes en production vers le nouveau modèle, en les stockant sans les renvoyer à l'utilisateur. Comparez deux choses : la qualité des images produites satisfait-elle le seuil minimal métier, et quelle est la différence de coût effectif par image avec la solution actuelle. La stratégie de retry en phase fantôme doit être strictement identique, sinon la comparaison des coûts n'a pas de sens.
Deuxième étape : bascule progressive par ligne métier
Choisissez d'abord une ligne métier la moins sensible à la qualité et dont l'échec a le moindre impact, puis augmentez progressivement la proportion. Pendant la phase progressive, surveillez trois indicateurs : le taux de réussite au premier essai, le nombre moyen de tentatives, et le nombre réel d'images facturées pour mille requêtes métier. Le troisième indicateur est le chiffre que cet article souhaite vous voir surveiller.
Troisième étape : ajuster les quotas en dernier
N'ajustez les quotas et les lignes budgétaires qu'après stabilisation du nombre d'images facturées en phase progressive. Un ajustement anticipé masquerait les retries anormaux de la phase progressive derrière le budget, et le problème n'éclaterait qu'au passage en production complète.
Ce qu'il faut abstraire lors de la migration
- Abstraction des capacités : le code métier ne dépend que de la sémantique « générer une image », pas des noms de champs d'un modèle particulier.
- Abstraction de la mesure de facturation : chaque adaptateur de modèle implémente lui-même
estimateCost(n), la couche supérieure raisonne toujours en « nombre d'images » et non en « montant » pour ses décisions budgétaires. - Normalisation des erreurs : mapper les codes d'erreur de chaque fournisseur en quelques catégories unifiées (erreur de paramètre, limitation de débit, panne amont, timeout) ; la stratégie de retry ne reconnaît que ces catégories normalisées.
- Normalisation de la forme des résultats : que l'amont retourne une URL ou un binaire, uniformiser en interne en « chemin de stockage ».
Deux points souvent négligés lors du basculement
Premièrement, la compatibilité des prompts. Les différents modèles ont des tolérances différentes à la longueur, à la langue et aux symboles spéciaux des prompts ; avant la migration, faites une batterie de régressions avec des échantillons de prompts réels, en particulier les modèles contenant du chinois et des descriptions structurées.
Deuxièmement, le chemin de retour arrière. Pendant la phase progressive, un commutateur de retour à l'ancien modèle en un clic doit être conservé, et le quota de l'ancien modèle ne doit pas être libéré immédiatement. Un retour arrière n'est pas un échec, c'est une partie de la conception.
Pour basculer entre plusieurs modèles via un point d'entrée agrégé, la couche d'abstraction ci-dessus est pratiquement réutilisable telle quelle ; c'est la principale raison d'inscrire la « couche d'appel unifiée » comme contrainte d'architecture.
Une grille de choix directement utilisable
À passer point par point en revue, puis à archiver après validation.
Côté besoins
- Le métier a seulement besoin de « texte en entrée, image en sortie », sans édition, retouche ni entrée multi-images.
- Le nombre d'images produites est prévisible selon le volume métier, une fourchette mensuelle peut être donnée.
- Les exigences de cohérence de sortie sont faibles, ou le risque métier d'incohérence est accepté.
- Les chaînes où l'utilisateur attend en présence disposent déjà d'une image de secours ou d'une solution asynchrone.
Côté coûts
- Le budget est établi sur « nombre d'images produites avec succès × prix unitaire » et non sur le nombre de requêtes.
- Le coefficient d'amplification des retries est inscrit au budget (estimé selon le nombre moyen de tentatives).
- Les quotas sont alloués en nombre d'images, pas en QPS.
- Il est confirmé si les requêtes échouées sont facturées, et les trois compteurs sont distingués dans les logs.
Côté ingénierie
- Le serveur détient la clé, le client n'y a pas accès.
- Chaque requête porte une clé d'idempotence, consignée dans les logs et la table de résultats.
- En cas de timeout, on ne renvoie pas directement, on consulte d'abord le résultat.
- La limite de retries est codée en dur, les 4xx ne sont pas réessayés.
- Les résultats sont transférés vers un stockage propre, sans dépendance aux URL temporaires.
- Les modèles de prompt portent un numéro de version.
Côté migration
- La comparaison en trafic fantôme est terminée, avec des données sur la qualité et le coût.
- La bascule progressive avance par ligne métier, l'indicateur suivi est le nombre d'images facturées pour mille requêtes.
- L'ajustement des quotas est planifié après stabilisation de la phase progressive.
- Le commutateur de retour arrière en un clic est conservé, le quota de l'ancien modèle n'est pas libéré à l'avance.
Côté architecture
- Le code métier ne dépend d'aucun champ de modèle concret.
- L'API d'estimation de coût prend le nombre d'images en entrée.
- Les codes d'erreur sont normalisés en quatre catégories, la stratégie de retry ne reconnaît que ces catégories.
- La forme des résultats est uniformisée en interne en chemin de stockage.
Si plus de trois lignes de cette grille ne peuvent être confirmées, il est conseillé de ne pas passer en phase progressive avant d'avoir comblé les lacunes. L'essence du choix n'est pas de sélectionner un modèle au prix unitaire plus bas, mais un modèle dont votre modèle de coût, votre modèle de retry et votre modèle de retour arrière concordent. Après avoir complété la grille, l'implémentation peut commencer ; les détails ultérieurs de paramètres et de versions relèvent de la page de détails du modèle et de la documentation de l'API.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Liste de contrôle pour le choix de Gemini Omni 1.2 Flash : modes d'entrée, spécifications et budget
Vérifier les modes d'entrée, les spécifications, le budget et les limites d'effet, puis finaliser le choix avec vos propres échantillons
-
Comparatif et évaluation
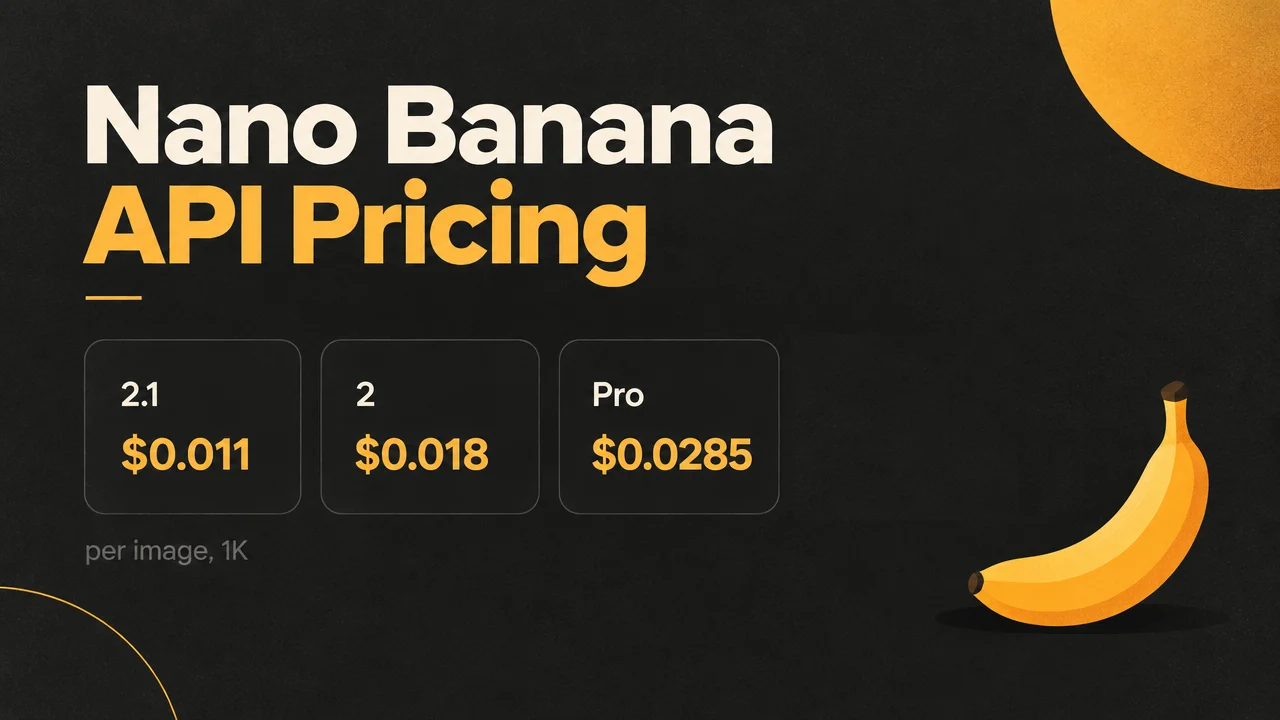
Nano Banana Black Friday : moins de 1 centime par image — comparaison de 2.1, 2 et Pro sur un même prompt
Prix normaux et prix Black Friday des trois versions 2.1, 2 et Pro, avec des images générées à partir du même prompt
-
Comparatif et évaluation
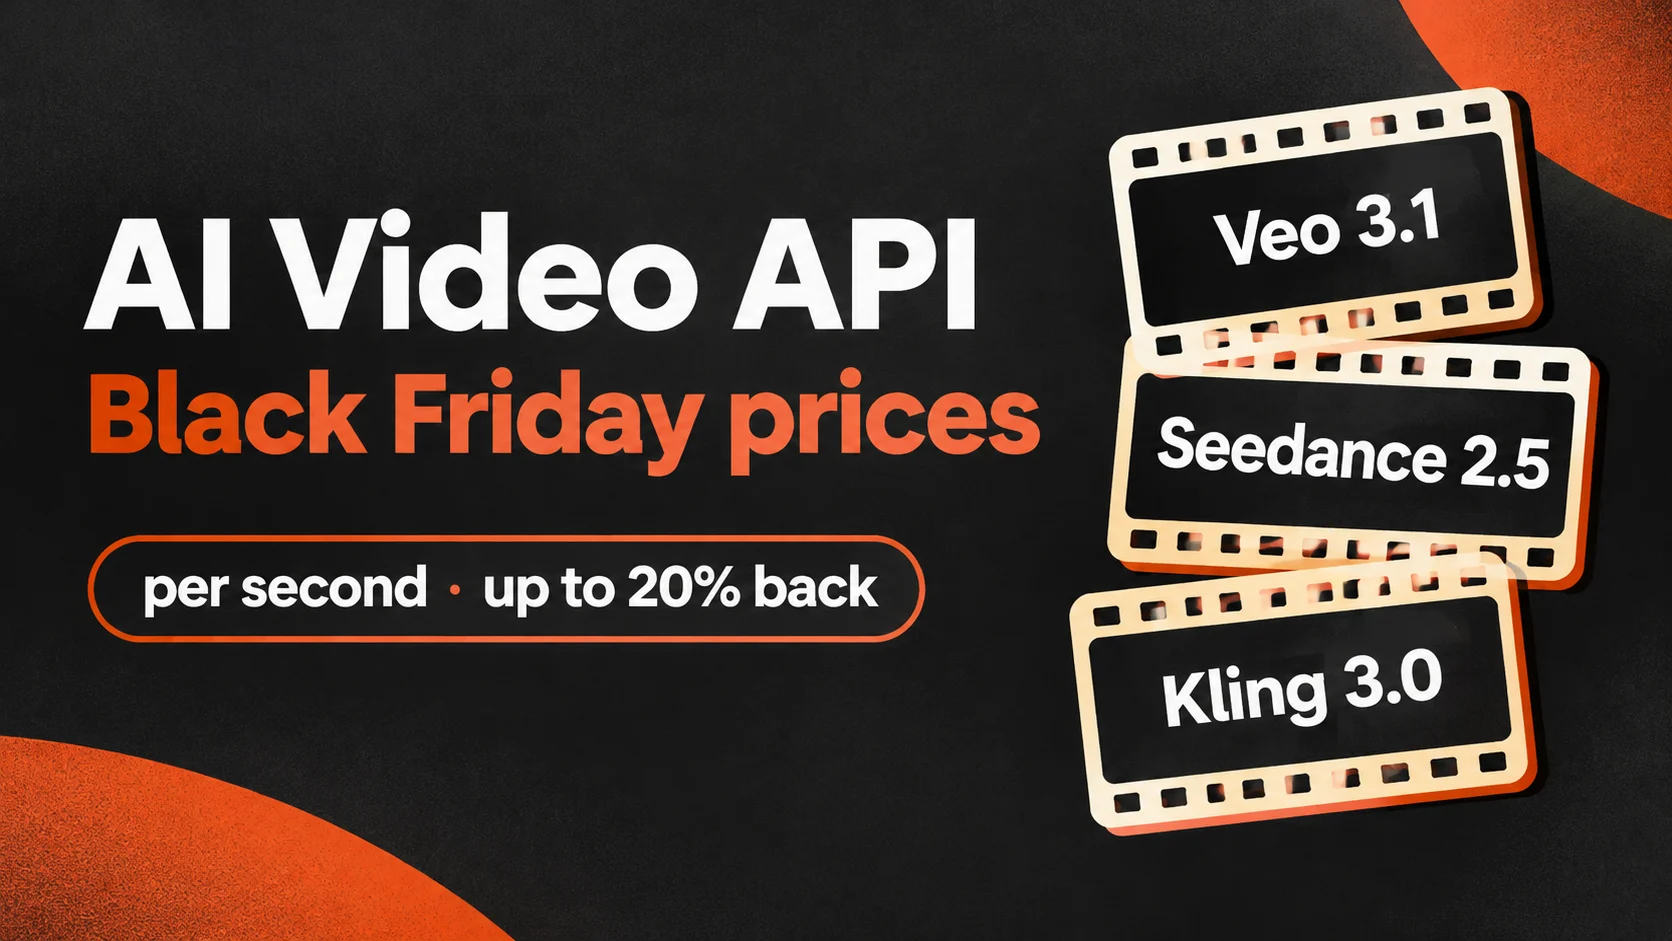
Prix des API de vidéo IA pour le Black Friday : jusqu'à environ 23 % d'économie par seconde avec Veo, Seedance et Kling
Prix à la seconde et à la vidéo de Veo 3.1, Seedance et Kling 3.0, et tarifs convertis pour le Black Friday