
Confronto e valutazione
gpt-image-2.6-sunburst/text-to-image guida alla scelta: confronto orizzontale basato sul prezzo per immagine
Dalla granularità di fatturazione alla forma di output fino ai costi di integrazione: aiutare il team di ingegneria a decidere se usarlo
In questa pagina
Quale problema risolve questo modello
Partiamo dal posizionamento. gpt-image-2.6-sunburst/text-to-image è fornito da OpenAI, il tipo di output è immagine e l'ambito di capacità è text-to-image: dato un prompt testuale, restituisce un'immagine. La sua tariffazione adotta una granularità di addebito per immagine.
Non si occupa di image-to-image, inpainting locale, editing multi-immagine o comprensione delle immagini: questi non rientrano nell'ambito del presente articolo. Il testo non ripete nemmeno gli slogan generici della scheda del modello, ma risponde a tre domande dal punto di vista del team di ingegneria: come la tariffazione per immagine influisce sul modello di costo, quali dimensioni considerare nel confronto orizzontale e quali costi comporta il passaggio da un modello esistente.
In sintesi, il confine di applicabilità: se il tuo business è una produzione standardizzata «prompt in ingresso, immagine finita in uscita» e il costo per singola immagine può essere estrapolato linearmente dal volume di richieste, la forma di questo modello è adatta; se invece hai bisogno di passaggi intermedi controllabili (ad esempio specificare il numero di step di campionamento o controllare i livelli di risoluzione per una fascia di costo fine), devi prima verificare se queste capacità esistono, senza darle per scontate.
Per dettagli su parametri, limiti di contesto, quote di concorrenza e altro, fanno fede la pagina dei dettagli del modello e la documentazione dell'interfaccia; questo articolo si limita al giudizio a livello di selezione.
Il contratto minimo di input/output
Dal punto di vista dell'integrazione, il contratto di questo tipo di interfaccia è molto semplice: nel corpo della richiesta c'è il prompt, eventualmente con campi opzionali come dimensioni o quantità (secondo la documentazione); nella risposta c'è il risultato immagine, che può essere un flusso binario o un URL con scadenza. In fase di selezione occorre prima chiarire bene questo contratto, perché determina la strategia di archiviazione, la strategia di retry e il design dell'idempotenza che adotterai in seguito.
Cosa significa la tariffazione per immagine
La caratteristica centrale della tariffazione per immagine è che l'unità di addebito equivale al numero di immagini prodotte con successo, non ai token consumati, agli step di campionamento o ai secondi di GPU. Il prezzo noto è $0,023 per immagine; questo articolo fa aritmetica solo su questa granularità e non estrapola alcuna regola di prezzo non pubblicata.
Formula del costo
Costo di una singola richiesta = numero di immagini richieste × prezzo unitario. Costo mensile = numero di immagini generate con successo nel mese × prezzo unitario. La formula è così semplice che sembra non valga la pena scriverla, ma comporta due conseguenze ingegneristiche.
Primo, il costo è fortemente legato alla «parte riuscita delle richieste». Le richieste fallite che non generano addebito non influiscono sul costo; se generano un addebito parziale, occorre distinguerle nei log. La prima cosa da fare a livello ingegneristico è separare i tre indicatori «richieste inviate», «immagini generate con successo» e «immagini addebitate», invece di fonderli in un'unica vista QPS.
Secondo, il retry equivale direttamente al rischio di raddoppiare il costo. Qualsiasi retry non idempotente può generare immagini duplicate e addebiti duplicati. Quindi il retry deve avere un limite massimo, deve portare una chiave di idempotenza e deve saper riconoscere il caso «la volta precedente in realtà era già riuscita, solo che la risposta è andata in timeout».
Il costo del retry va modellato separatamente
Supponendo che una richiesta di business attivi in media r tentativi (incluso il primo), il costo effettivo a bilancio viene moltiplicato per circa (1 + tasso di tentativi aggiuntivi). Questo coefficiente di solito si diluisce sui modelli tariffati a token, perché la singola chiamata costa poco e l'incremento assoluto di un retry fallito è piccolo; ma con la tariffazione per immagine ogni immagine è un'unità di addebito completa, e il valore assoluto amplificato dai retry è qualcosa che devi necessariamente mettere a budget.
Differenze rispetto alla tariffazione a consumo
I modelli tariffati per dimensioni di utilizzo come risoluzione, step o token hanno una curva di costo più fine, ma più difficile da prevedere: devi prima conoscere la distribuzione delle richieste tipiche per calcolare la media. Il vantaggio della tariffazione per immagine è la prevedibilità: se il business dice «questo mese dobbiamo produrre 100.000 immagini», il budget è subito calcolabile. Lo svantaggio è la mancanza di elasticità: non puoi abbassare il costo unitario riducendo la risoluzione, e gli unici strumenti di controllo del costo restano «ridurre il numero di immagini» e «aumentare il tasso di successo al primo tentativo».
Protezione da fallimenti e quote
Con la tariffazione per immagine, l'esaurimento delle quote e gli errori di rate limiting costano di più, perché nelle loro finestre di retry si annida un costo reale. Si consiglia di impostare sul client un limite di concorrenza, quote in numero di immagini per linea di business (non quote di richieste), e di degradare ai risultati in cache invece di continuare a chiamare l'interfaccia quando la quota si avvicina al limite.
Quali dimensioni considerare nel confronto orizzontale
Non confrontare solo nomi dei modelli e prezzo unitario. L'insieme di dimensioni seguente non dipende da alcun parametro specifico e può essere trasferito direttamente nella tabella di valutazione.
Tipo di output e confini di capacità
Prima conferma la forma dell'output: solo immagine, immagine più descrizione testuale, o supporto all'input multi-immagine. Poi conferma l'ambito di capacità: solo text-to-image, o anche editing, inpainting, outpainting. Più stretta è la capacità, più stabile è l'interfaccia, ma più è probabile che le esigenze combinate del business richiedano che sia tu a comporle. Il vantaggio di un text-to-image unico è la chiarezza delle responsabilità: adatto a essere «un livello di capacità» e non «un prodotto».
Modalità di chiamata
Ritorno sincrono, task asincrono, ritorno in streaming: le tre forme hanno requisiti completamente diversi per l'architettura client. L'interfaccia sincrona è la più comoda, ma timeout e fallimenti in coda sono più evidenti; il task asincrono richiede interrogazione del task e callback, con costi di integrazione più alti ma maggiore controllo. In fase di selezione chiediti: la mia stack di chiamate dispone già di un'infrastruttura di polling dei task?
Granularità di fatturazione
Questa è la dimensione centrale dell'articolo. Dividi i modelli candidati in due categorie: tariffazione per immagine/per chiamata e tariffazione per dimensione di utilizzo. La prima è adatta a business batch con costi prevedibili, la seconda a scenari con distribuzione delle richieste molto irregolare e margini di errore di stima accettabili. Non confrontare le due con lo stesso modello di costo, altrimenti la conclusione sarà certamente sbagliata.
Esigenze di controllabilità
Se il business richiede di specificare i livelli di dimensione, coerenza di stile, seed casuali riproducibili. Più forte è la controllabilità, più parametri ha l'interfaccia, più alto è il costo di migrazione. Viceversa, se il business ha basse esigenze di coerenza (ad esempio produzione massiva di immagini di accompagnamento ai contenuti), un modello a capacità unica è più semplice da gestire.
Sensibilità alla latenza
Distingui «utente in attesa» e «elaborazione batch offline». Il primo è sensibile alla latenza di coda, richiede supporto per degradazione su timeout e immagini di fallback; il secondo tollera latenze nell'ordine dei minuti ed è più adatto alla forma di task asincrono. Lo stesso modello può avere valutazioni molto diverse nei due tipi di scenario.
Rischio di lock-in del fornitore
Valuta tre cose: se il protocollo dell'interfaccia è standard, se i risultati restituiti sono direttamente migrabili (URL o binario), e se è possibile passare tra più fornitori tramite un punto di accesso unificato. L'ultimo punto determina la tua capacità futura di negoziazione e disaster recovery, e vale la pena inserirlo nei vincoli architetturali già in fase di selezione.
Dati e conformità
Le politiche di conservazione di prompt e prodotti, l'attribuzione della responsabilità della moderazione dei contenuti: questi non entrano nella tabella dei costi ma bloccano il lancio. Chiarirli in anticipo costa molto meno che scoprire una settimana prima del lancio che bisogna cambiare la catena.
In quali casi è più adatto
Combinando la capacità unica di text-to-image con la prevedibilità della tariffazione per immagine, i criteri di giudizio per i seguenti tipi di scenario sono relativamente chiari.
Produzione batch di immagini
Quando l'esigenza del business è «produzione di immagini di accompagnamento che cresce linearmente con il volume di contenuti», il modello di costo lineare della tariffazione per immagine è il più adatto. Puoi calcolare direttamente il budget come «numero di immagini previste × prezzo unitario», senza prima campionare la distribuzione delle richieste. Questo è il suo vantaggio più concreto rispetto alla tariffazione a consumo.
Validazione di prototipi e test graduali
Nella fase in cui si valuta «se la capacità di generazione testo-immagine merita di entrare nel prodotto», un modello con interfaccia semplice e unità di addebito chiara riduce al minimo il ciclo di validazione. Il team non deve prima costruire un sistema di livelli di risoluzione né fare tuning dei parametri per risparmiare.
Produzione massiva a basso costo sul lato contenuti
Per scenari con basse esigenze di coerenza e in cui un fallimento può essere accettato con una nuova esecuzione (immagini di accompagnamento per pagine di elenco, bozze di materiali marketing, illustrazioni per piattaforme di contenuti), la tariffazione per immagine combinata con un limite di retry è una struttura di costo accettabile.
Al contrario, quando non sceglierlo
Primo, scenari che richiedono un controllo fine a fasce del costo unitario. Se il prodotto richiede «anteprima a bassa risoluzione su canale economico, prodotto ad alta risoluzione su canale costoso» e il modello non espone questi livelli, puoi solo fare downsampling in post-processing e non ottieni il vantaggio di costo.
Secondo, scenari che richiedono editing delle immagini, inpainting locale, iterazioni multiple. Una capacità text-to-image unica non può coprirli, e una composizione forzata comporta chiamate multiple: con la tariffazione per immagine ogni round è un'unità di addebito completa, e il costo totale supera rapidamente le attese.
Terzo, scenari con forti requisiti di coerenza dell'output, ad esempio serie di materiali che richiedono uno stile rigorosamente uniforme. In questo caso il peso della controllabilità supera quello del prezzo unitario, e si dovrebbe dare priorità a soluzioni con controllabilità maggiore.
Quarto, scenari in tempo reale estremamente sensibili alla latenza e senza fallback. Se dopo un timeout non è possibile degradare, i retry con tariffazione per immagine amplificano sia la latenza che il costo.
Un semplice ordine di valutazione
Chiediti prima «il numero di immagini in output è prevedibile», poi «sono necessarie capacità di editing», infine «è richiesta una forte coerenza». Se una delle tre risposte è negativa, è il momento di ampliare la lista dei candidati invece di forzare la scelta.
Implementazione dell'integrazione e problemi comuni
Di seguito la catena minima praticabile per l'integrazione di text-to-image, indipendente dai parametri specifici e direttamente applicabile.
Autenticazione e costruzione della richiesta
La chiave va tenuta solo sul server, mai sul client. Nel corpo della richiesta metti il prompt come unico campo obbligatorio, e per tutti gli altri campi passa esplicitamente i valori predefiniti, per evitare derive implicite dovute a cambiamenti del comportamento predefinito a monte. Per ogni richiesta genera una chiave di idempotenza lato business, scrivila nei log e nell'header della richiesta (o in un campo di metadati, secondo la documentazione): è la base per la sicurezza dei retry successivi.
Timeout, retry e idempotenza
for attempt in 1..max_attempts:
  resp = call_api(prompt, idempotency_key, timeout=T)
  if resp.ok: break
  if resp.status in (400, 401, 403): break   # 不可重试
  if resp.status == 429 or resp.status >= 500: sleep(backoff(attempt)); continue
I punti chiave sono tre:
- Il timeout non è un fallimento. Dopo un timeout, prima interroga il risultato (se l'interfaccia supporta la ricerca per chiave di idempotenza o ID del task), poi decidi se reinviare.
- Nessun retry per i 4xx, in particolare errori di parametri e fallimenti di autenticazione: i retry consumano solo quota.
- Il limite massimo di retry deve essere codificato in modo fisso, e con la tariffazione per immagine deve esserci un allarme di costo per «questa richiesta ha già effettuato N retry».
Archiviazione dei risultati
Non dipendere a lungo dagli URL temporanei restituiti. Appena ottenuto il risultato, trasferiscilo subito nel tuo object storage e registra nella tabella di business la mappatura «chiave di idempotenza → percorso di archiviazione → numero di immagini addebitate». Questa mappatura è l'unica base per la riconciliazione successiva.
I quattro problemi più comuni
Problema uno: trattare il timeout come fallimento e reinviare subito. A monte l'immagine è già stata generata e addebitata; reinviando paghi il costo di due immagini.
Problema due: nessuna quota basata sul numero di immagini. Limitare solo i QPS e non il numero di immagini: un singolo task batch può sforare il budget mensile.
Problema tre: concatenazione dei prompt senza versione. Quando la qualità dell'output oscilla non riesci a capire se è cambiato il prompt o il modello, e il rollback diventa impossibile. Assegna un numero di versione ai template di prompt.
Problema quattro: inserire l'interfaccia sincrona nella catena delle richieste utente. Un'oscillazione a monte diventa direttamente un timeout della pagina, senza vie di degradazione. O usi task asincroni o aggiungi immagini di fallback.
L'abbozzo di un livello di chiamata unificato
Si consiglia di aggiungere un sottile adattatore tra il codice di business e le interfacce dei modelli, astraendo almeno tre metodi: generate(prompt, opts), poll(taskId), estimateCost(n). I primi due isolano le differenze di protocollo, il terzo permette al business di vedere il costo stimato in numero di immagini prima di inviare il task, evitando budget fuori controllo.
Note sulla migrazione e sul passaggio graduale
Passando da un modello di immagine esistente a gpt-image-2.6-sunburst/text-to-image, l'ordine conta più della velocità.
Primo passo: confronto con traffico ombra
Non passare subito il traffico reale. Copia le richieste di produzione e inviale al nuovo modello, salvando solo su database senza restituire all'utente. Confronta due cose: se la qualità dell'output soddisfa la soglia minima del business e la differenza tra il costo effettivo per immagine e la soluzione attuale. Nella fase ombra la strategia di retry deve essere perfettamente identica, altrimenti il confronto dei costi non ha senso.
Secondo passo: rilascio graduale per linea di business
Scegli una linea di business il meno sensibile alla qualità e con il minor impatto in caso di fallimento, e aumenta gradualmente la percentuale. Durante il rilascio graduale monitora tre indicatori: tasso di successo al primo tentativo, numero medio di tentativi e numero effettivo di immagini addebitate ogni mille richieste di business. Il terzo indicatore è il numero su cui questo articolo vuole che tu tenga lo sguardo.
Terzo passo: regolare le quote solo alla fine
Solo dopo che il numero di immagini addebitate in fase di rilascio graduale si è stabilizzato, passa a regolare quote e voci di budget. Adeguare le quote in anticipo farebbe sì che i retry anomali della fase di rilascio graduale vengano mascherati dal budget, rimandando l'emergere del problema al momento del rilascio completo.
Cosa astrarre durante la migrazione
- Astrazione della capacità: il codice di business dipende solo dalla semantica «genera un'immagine», non dai nomi dei campi di un modello specifico.
- Astrazione della metrica di fatturazione: ogni adattatore di modello implementa da sé
estimateCost(n), e il livello superiore prende sempre decisioni di budget in «numero di immagini» e non in «importo». - Normalizzazione degli errori: mappa i codici di errore dei vari fornitori a monte in poche categorie unificate (errore di parametri, rate limiting, guasto a monte, timeout); la strategia di retry riconosce solo le categorie normalizzate.
- Normalizzazione della forma dei risultati: che il fornitore restituisca URL o binario, internamente si unifica in «percorso di archiviazione».
Due punti facilmente trascurati nel passaggio
Primo, la compatibilità dei prompt. Modelli diversi hanno tolleranze diverse per lunghezza, lingua e simboli speciali dei prompt; prima della migrazione esegui una batteria di regressione con campioni reali di prompt, soprattutto per i template con cinese e descrizioni strutturate.
Secondo, il percorso di rollback. Durante il rilascio graduale deve esserci un interruttore per tornare al vecchio modello con un clic, e la quota del vecchio modello non deve essere rilasciata immediatamente. Il rollback non è un fallimento, è parte del design.
Quando si effettua il cambio multi-modello tramite un punto di accesso aggregato, il livello di astrazione di cui sopra è in gran parte direttamente riutilizzabile: è anche la ragione principale per inserire il «livello di chiamata unificato» nei vincoli architetturali.
Una checklist di selezione direttamente utilizzabile
Da scorrere punto per punto in riunione di valutazione e archiviare dopo la conferma.
Lato requisiti
- Il business richiede solo «testo in ingresso, immagine in uscita», senza editing, inpainting o input multi-immagine.
- Il numero di immagini è prevedibile in base al volume di business e si può fornire un intervallo mensile.
- Le esigenze di coerenza dell'output sono basse, o il rischio di business di incoerenza è già accettato.
- La catena in cui l'utente attende ha già immagini di fallback o una soluzione asincrona.
Lato costi
- Il budget è calcolato con «numero di immagini generate con successo × prezzo unitario», non con il numero di richieste.
- Il coefficiente di amplificazione dei retry è già stato inserito nel budget (stimato sul numero medio di tentativi).
- Le quote sono assegnate in numero di immagini, non in QPS.
- È già stato confermato se le richieste fallite vengono addebitate, e nei log si distinguono i tre conteggi.
Lato ingegneria
- Il server detiene la chiave, il client non vi accede.
- Ogni richiesta porta una chiave di idempotenza, e la chiave è inserita nei log e nella tabella dei risultati.
- In caso di timeout non si reinvia subito, ma si interroga prima il risultato.
- Il limite massimo di retry è codificato in modo fisso, nessun retry per i 4xx.
- I risultati vengono trasferiti nello storage proprietario, senza dipendere da URL temporanei.
- I template di prompt portano un numero di versione.
Lato migrazione
- Il confronto con traffico ombra è completato, con dati sia sulla qualità che sui costi.
- Il rilascio graduale procede per linea di business, e l'indicatore monitorato è il numero di immagini addebitate ogni mille richieste.
- La regolazione delle quote è prevista dopo la stabilizzazione del rilascio graduale.
- È mantenuto l'interruttore di rollback con un clic, e la quota del vecchio modello non è stata rilasciata in anticipo.
Lato architettura
- Il codice di business non dipende dai campi di alcun modello specifico.
- L'interfaccia di stima dei costi prende in input il numero di immagini.
- I codici di errore sono normalizzati in quattro categorie, e la strategia di retry riconosce solo le categorie normalizzate.
- La forma dei risultati è uniformata internamente in un percorso di archiviazione.
Se in questa checklist ci sono più di tre righe che non riesci a confermare, si consiglia di non procedere ancora al rilascio graduale, ma di colmare prima le lacune. L'essenza della selezione non è scegliere un modello con prezzo unitario più basso, ma scegliere un modello con cui il tuo modello di costo, modello di retry e modello di rollback sono tutti coerenti. Solo dopo aver completato la checklist si può passare all'implementazione; per dettagli successivi su parametri e versioni fanno fede la pagina dei dettagli del modello e la documentazione dell'interfaccia.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Checklist di selezione di Gemini Omni 1.2 Flash: modalità di input, specifiche e budget
Verifica modalità di input, specifiche, budget e confini degli effetti, e completa la validazione di selezione con i tuoi campioni
-
Confronto e valutazione
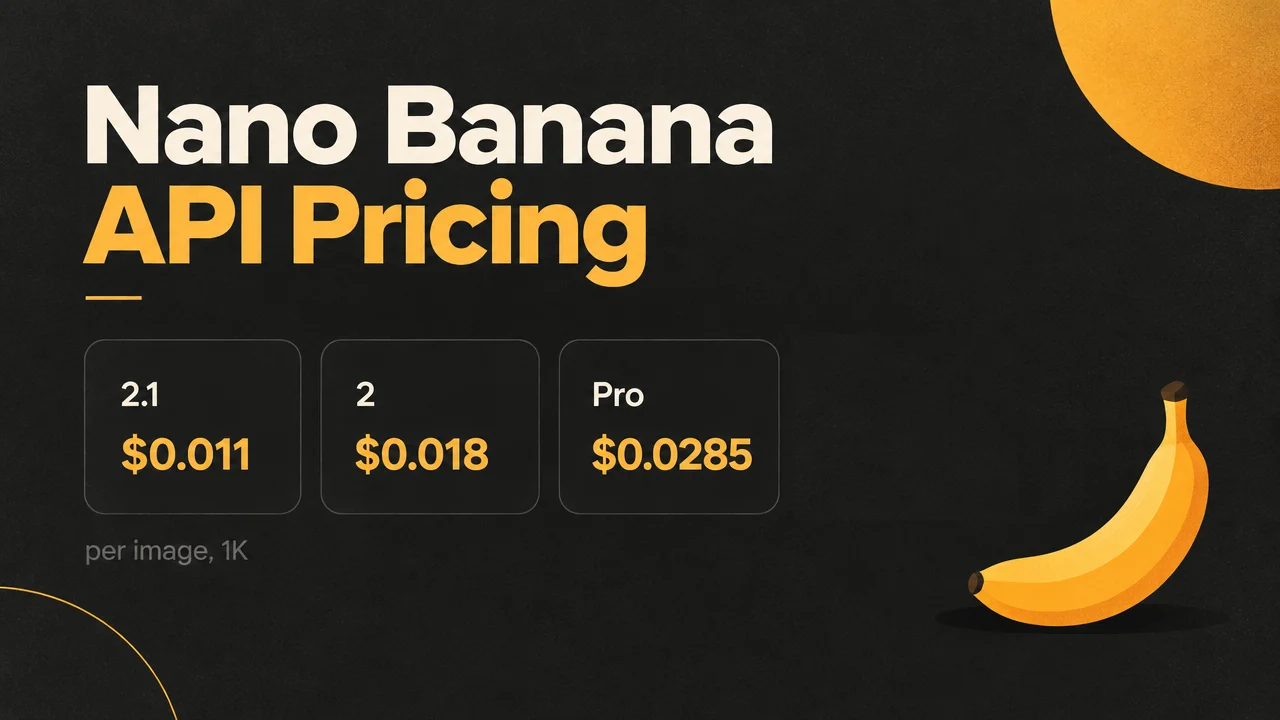
Nano Banana Black Friday, meno di 1 centesimo per immagine: confronto tra 2.1, 2 e Pro con lo stesso prompt
Prezzo pieno e prezzo Black Friday delle tre versioni 2.1, 2 e Pro, con confronto delle immagini generate dallo stesso prompt
-
Confronto e valutazione
Prezzi delle API video AI per il Black Friday: Veo, Seedance e Kling costano fino al 23% in meno al secondo
Prezzi al secondo e per video di Veo 3.1, Seedance e Kling 3.0, con i prezzi scontati del Black Friday