
Tutoriel
Comment utiliser l'API HeyGen Avatar IV ? Faites parler une photo en 5 minutes
Une photo et un texte ou un audio, et vous générez une vidéo parlante. Avec des commandes cURL et Python prêtes à l'emploi, toutes les valeurs par défaut des paramètres, l'usage de l'arrière-plan et les points à vérifier avant la mise en production.
TL;DR
- C'est quoi : un avatar photo signé HeyGen. Une photo de portrait plus un texte (ou un audio) génèrent un MP4 où la personne de la photo parle. Déjà disponible sur HiAPI, ouvrez la page du modèle et téléversez une photo pour générer.
- Combien ça coûte : facturation à la seconde de vidéo, $0.15 par seconde, même prix en 720p et 1080p, 10 secondes pour $1.50.
- Comment appeler l'API :
POST https://api.hiapi.ai/v1/tasks, mettezheygen-avatar-ivdansmodel, passez l'URL de la photo et le texte, récupérez letaskIdpuis interrogez le statut : votre première vidéo tourne en 5 minutes.
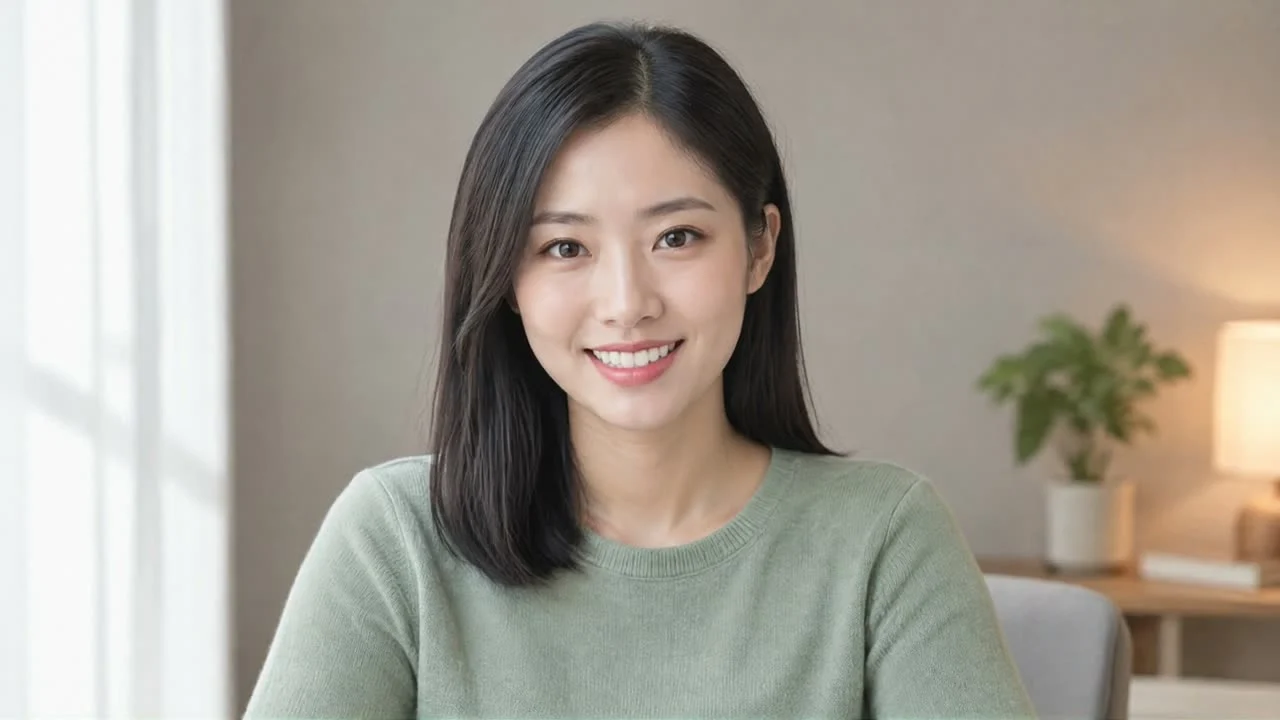
Regardez d'abord un exemple fini. Cette présentation horizontale de 9 secondes utilise une photo en buste avec un pull et un texte en anglais :
1080p / 16:9, 9 secondes, voix Cute Chloe - Friendly. Le pull, la coiffure et la pièce de la photo sont conservés, la synchronisation labiale, les clignements et les légers hochements de tête suivent la voix.
Texte d'origine :
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
Générer avec ce texte → Le texte est déjà rempli, téléversez votre propre photo et générez.
À qui s'adresse HeyGen Avatar IV ?
Si vous avez une photo et voulez que « cette personne » parle face caméra, c'est l'outil qu'il vous faut. Usages courants :
- Présentation produit et recommandations : même photo, textes différents, production en série de vidéos courtes avec des arguments distincts.
- Cours et formations : le professeur enregistre une photo une fois, puis ne rédige plus que le script de chaque leçon.
- Annonces d'entreprise et vidéos de service client : l'image du conseiller, du médecin ou du gérant reste fixe, le contenu se met à jour à tout moment.
- Illustrations et personnages 3D : il suffit d'un visage net, même un personnage de dessin animé peut parler.
Si vous ne voulez pas utiliser votre propre image, préférez choisir parmi des avatars prédéfinis, ou avez besoin d'un fond transparent, de sous-titres ou de 4K, choisissez HeyGen Avatar V, au même prix.
Essayez d'abord sur la page du modèle
Avant d'écrire du code, générez une vidéo sur le site pour voir le rendu de votre photo :
- Cliquez sur « Générer avec ce texte » ci-dessus, le texte se remplit automatiquement.
- Téléversez une photo d'une seule personne, de face, avec un éclairage uniforme.
- Choisissez 1080p, 16:9 ; la voix est facultative, par défaut Warm Pro Narrator.
- Cliquez sur générer, prévisualisez en ligne une fois terminé, et téléchargez si le résultat vous convient.
10 secondes coûtent $1.50 ; avec $10 vous générez environ 66 secondes de vidéo, de quoi comparer plusieurs photos et plusieurs voix.
Trois choses à préparer avant d'appeler l'API
- Une clé API : à créer dans la console, au format
sk-..., à placer dans l'en-têteAuthorization: Bearer. - Un lien HTTPS public vers la photo : une photo d'une seule personne, de face, sans traits du visage masqués, avec un éclairage uniforme et une bouche naturellement fermée, donne les meilleurs résultats. L'API lit la photo via le lien : téléversez d'abord l'image sur votre propre stockage ou CDN.
- Un texte ou un audio, au choix : avec un texte, c'est la voix choisie qui le lit ; avec un audio (
audio_url), la synchronisation labiale suit votre enregistrement.
Requête minimale : version cURL
Le lien de photo ci-dessous est directement utilisable ; remplacez simplement votre clé pour l'exécuter :
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
      "prompt": "Hi, I'\''m Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
      "voice": "Cute Chloe - Friendly",
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
L'ID de tâche renvoyé se trouve dans data.taskId :
{"code":200,"data":{"taskId":"tk-hiapi-..."},"message":"success"}
Pas besoin de passer la durée : avec un texte, elle dépend de la longueur du texte et du débit de la voix ; avec un audio, elle est identique à celle de l'audio.
Récupérer le résultat
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer sk-YOUR_KEY"
Quand data.status passe à success, cherchez dans data.output l'élément dont type vaut video : son url est le MP4 :
{
  "code": 200,
  "data": {
    "taskId": "tk-hiapi-...",
    "status": "success",
    "model": "heygen-avatar-iv",
    "output": [
      {"type": "video", "url": "https://temp.hiapi.ai/.../...-0.mp4"}
    ]
  },
  "message": "success"
}
Exemple Python complet : création, interrogation, téléchargement
import time
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer sk-YOUR_KEY"}

payload = {
    "model": "heygen-avatar-iv",
    "input": {
        "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
        "prompt": "Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
        "voice": "Cute Chloe - Friendly",
        "resolution": "1080p",
        "aspect_ratio": "16:9",
    },
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=30)
task_id = resp.json()["data"]["taskId"]
print("task:", task_id)

while True:
    data = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(8)

if data["status"] == "success":
    video_url = next(o["url"] for o in data["output"] if o["type"] == "video")
    with open("avatar-iv.mp4", "wb") as f:
        f.write(requests.get(video_url, timeout=120).content)
    print("saved avatar-iv.mp4")
else:
    print(data.get("error"))
Aperçu des paramètres
| Paramètre | Obligatoire | Valeur par défaut | Description |
|---|---|---|---|
image_url |
Oui | — | Lien HTTPS public vers la photo de portrait, avec un visage net |
prompt |
Au choix | — | Texte, 5000 caractères maximum, en chinois ou en anglais |
voice |
Non | Warm Pro Narrator |
102 voix prédéfinies, utilisé uniquement avec un texte |
audio_url |
Au choix | — | Audio qui pilote la synchronisation labiale, 600 secondes maximum |
resolution |
Non | 720p |
720p ou 1080p, même prix |
aspect_ratio |
Non | 16:9 |
16:9, 9:16, 4:5, 5:4, 1:1, auto (reprend le ratio de la photo) |
background |
Non | Blanc | {"type": "color" ou "image", "value": ...}, remplit les marges du cadre |
callback |
Non | — | {"url": "...", "when": "final"}, envoie l'objet tâche à l'état final |
La liste complète des voix se trouve dans la documentation en chinois.
Les deux modes de pilotage et l'usage de l'arrière-plan
Pilotage par texte : passez prompt et voice, idéal pour changer le contenu en série. Cette vidéo verticale face caméra utilise une photo déjà au format 9:16, le cadre de sortie est donc entièrement rempli :
1080p / 9:16, 8 secondes, voix Andrew.
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.
Générer avec ce texte → Le texte est déjà rempli, téléversez votre photo verticale, choisissez 9:16 et générez.
Pilotage par audio : si vous avez déjà enregistré une voix off, ou voulez utiliser votre propre voix, remplacez prompt et voice par audio_url : la synchronisation labiale et les pauses suivent l'enregistrement.
Arrière-plan : quand le format de sortie diffère du ratio de la photo, des marges apparaissent ; remplissez-les avec background. Pour une couleur unie, passez {"type": "color", "value": "#F5EFE6"} ; pour une image, {"type": "image", "value": "https://..."}. Cette vidéo place une photo horizontale de professeur dans un cadre vertical, avec une image de tableau noir en haut et en bas :
1080p / 9:16, 11 secondes, voix Professor Dean, background avec une image de tableau noir.
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
Générer avec ce texte → Le texte est déjà rempli, téléversez votre photo et générez.
3 points à vérifier avant la mise en production
- Utilisez le callback côté serveur. Ajoutez
"callback": {"url": "https://yourapp.com/webhook", "when": "final"}à la requête : le résultat est envoyé automatiquement à la fin de la tâche, sans interrogation répétée. - Ne refaites pas de POST après avoir obtenu le
taskId. ChaquePOST /v1/taskscrée une nouvelle tâche et est facturé séparément. En cas de délai réseau, vérifiez d'abord si vous avez bien stocké letaskId; si oui, continuez à interroger le statut ou attendez le callback. - Téléchargez dès que c'est terminé. Les liens de sortie expirent : dès que vous avez le résultat, enregistrez le MP4 sur votre propre stockage.
Comment se fait la facturation ?
$0.15 par seconde, réglé sur le nombre réel de secondes de la vidéo générée ; la résolution n'influence pas le prix, autant utiliser 1080p. À la création, une durée estimée est prélevée ; une fois terminé, on ajuste selon les secondes réelles (remboursement ou complément). Les tâches échouées sont intégralement remboursées.
| Durée de la vidéo | Coût |
|---|---|
| 5 secondes | $0.75 |
| 10 secondes | $1.50 |
| 30 secondes | $4.50 |
| 60 secondes | $9.00 |
Le coût ne dépend que du nombre de secondes : pour économiser, écrivez des textes plus courts. 300 vidéos face caméra de 10 secondes par mois coûtent environ $450 ; 20 cours de 60 secondes environ $180. Le tarif complet est sur la page des tarifs.
La vidéo de 9 secondes de Lin au début a coûté $1.35. Générer avec le même texte → Le texte est déjà rempli, téléversez votre photo et calculez combien de secondes durera votre vidéo.
Questions fréquentes
Peut-on utiliser un texte en chinois ?
Oui. prompt accepte le chinois et l'anglais, 5000 caractères maximum.
Peut-on utiliser sa propre voix ?
Oui. Envoyez un enregistrement à audio_url, 600 secondes maximum : la synchronisation labiale suit votre enregistrement.
Quel type de photo donne le meilleur résultat ? Une photo d'une seule personne, de face, sans traits du visage masqués, avec un éclairage uniforme et une bouche naturellement fermée. Les illustrations et personnages 3D fonctionnent aussi, à condition d'avoir un visage net. Pour les profils de trois quarts, les masques, les photos de groupe ou les visages trop petits, essayez une autre photo ; les tâches dont la reconnaissance échoue sont intégralement remboursées.
Ma photo est horizontale, comment obtenir une vidéo verticale ?
Réglez aspect_ratio sur 9:16, puis remplissez les marges en haut et en bas avec background, comme pour la vidéo du tableau noir ci-dessus.
Combien de temps faut-il pour une vidéo ? La génération est asynchrone : plus le texte est long et la résolution élevée, plus l'attente est longue. Côté serveur, utilisez le callback pour recevoir le résultat automatiquement à la fin.
Liens utiles sur HeyGen Avatar IV
- Page du modèle HeyGen Avatar IV : téléversez une photo pour générer en ligne
- Documentation chinoise de HeyGen Avatar IV : tous les paramètres et les 102 voix
- Page du modèle HeyGen Avatar V : 497 avatars prédéfinis, fond transparent et sous-titres pris en charge
- Page des tarifs HiAPI : prix à la seconde et à l'image de tous les modèles
Essayez maintenant : trouvez une photo de vous de face, générez avec le texte de Lin →, le texte est déjà rempli, téléversez la photo, choisissez 1080p et 16:9 : une vidéo d'environ 9 secondes coûte $1.35.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat