
チュートリアル
HeyGen Avatar IV API の使い方:5分で写真が喋り出す
1枚の写真とセリフまたは音声で、喋る動画を生成。そのまま実行できる cURL と Python、全パラメータのデフォルト値、背景の使い方、公開前の注意点付き。
TL;DR
- これは何か:HeyGen 製の写真デジタルヒューマン。1枚の人物写真とセリフ(または音声)で、写真の中の人が喋る MP4 を生成。すでに HiAPI で公開済みで、モデルページを開き 写真をアップロードすれば生成できます。
- 料金:動画の秒数で課金、1秒 $0.15、720p と 1080p は同価格、10秒の1本で $1.50。
- API の呼び方:
POST https://api.hiapi.ai/v1/tasks、modelにheygen-avatar-ivを指定、写真リンクとセリフを送り、taskIdを取得してから結果を照会。5分で最初の1本が動きます。
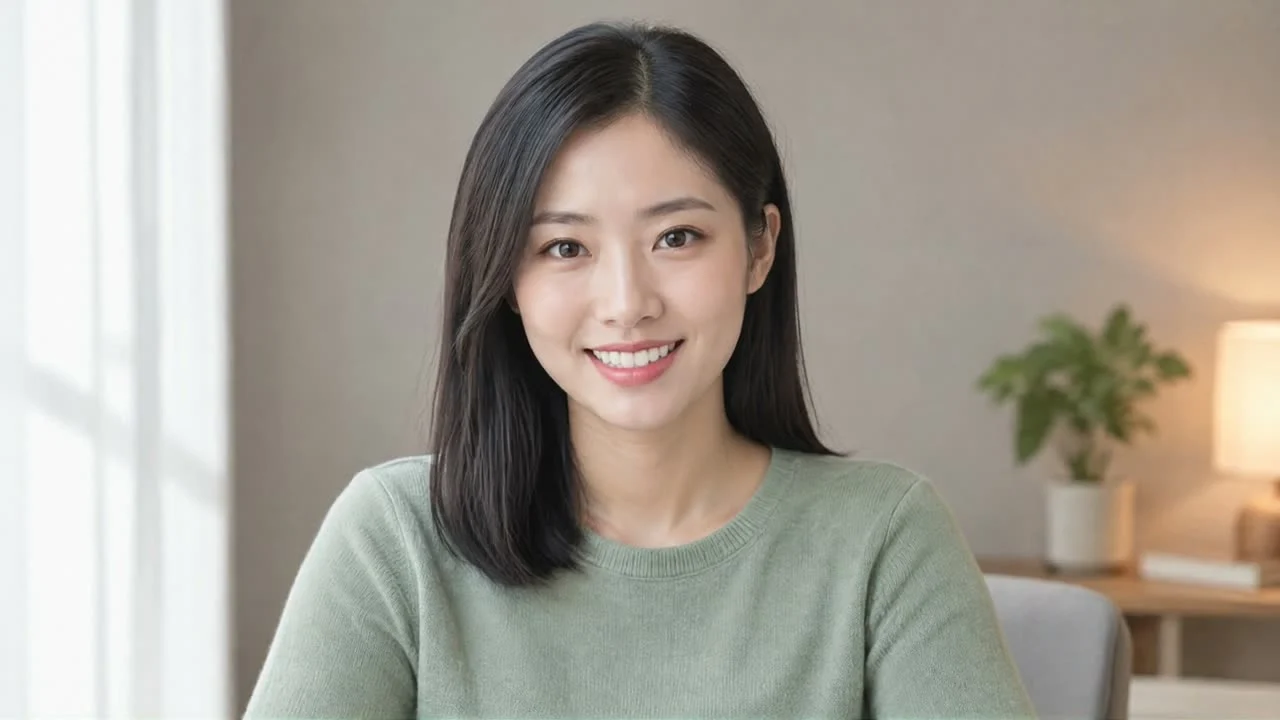
まずは完成した動画を1本。以下の9秒の横長解説は、セーター姿の半身写真と英語のセリフを使っています:
1080p / 16:9、9秒、音声は Cute Chloe - Friendly。写真のセーター、髪型、部屋はそのままに、口の動き、まばたき、軽いうなずきが音声に合わせて動きます。
セリフ原文:
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
このセリフで生成 → セリフは入力済みなので、自分の写真をアップロードするだけで生成できます。
HeyGen Avatar IV は誰に向いている?
手元に1枚の写真があり、その「人」に出演して喋らせたいならこれを使います。よくある使い方:
- 商品解説と口コミ紹介:同じ写真でセリフだけ変え、訴求点の異なるショート動画を量産。
- 講座と研修:講師が一度写真を撮れば、あとは各回の講義原稿を書くだけ。
- 企業のお知らせと客服動画:顧問、医師、店長のイメージを固定し、内容はいつでも更新。
- イラストや3Dキャラクター:はっきりした顔があれば、カートゥーン形象も喋らせられます。
自分のイメージが不要でプリセットのデジタルヒューマンから選びたい、あるいは透明背景、字幕、4K が必要なら、HeyGen Avatar V を選んでください。価格は同じです。
まずモデルページで一度試す
コードを書く前に、Web 上で1本出して、自分の写真の仕上がりを確認しましょう:
- 上の「このセリフで生成」をクリックすると、セリフが自動で入力されます。
- 正面向き、光が均一な単独の人物写真をアップロードします。
- 1080p、16:9 を選び、音声は未選択でも構いません(デフォルトは Warm Pro Narrator)。
- 生成をクリックし、完了後にオンラインプレビューで確認、満足したらダウンロード。
10秒の1本で $1.50、$10 で約66秒の動画を生成でき、数枚の写真や数種類の音声で仕上がりを比較するのに十分です。
API を呼ぶ前に用意する3つ
- API Key:コンソール で作成、形式は
sk-...、Authorization: Bearerリクエストヘッダーに入れます。 - 写真の公開 HTTPS リンク:正面向き、五官が隠れていない、光が均一、口が自然に閉じた単独の人物写真が最も安定します。API はリンクから写真を読み込むので、先に画像を自分のストレージや CDN にアップロードしてください。
- セリフまたは音声、どちらか一方:セリフを渡せば選択した音声で読み上げ、音声(
audio_url)を渡せば口の動きがあなたの録音に合わせます。
最小リクエスト:cURL 版
以下の写真リンクはそのまま使えます。自分のキーに差し替えれば実行できます:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
      "prompt": "Hi, I'\''m Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
      "voice": "Cute Chloe - Friendly",
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
返却されるタスク ID は data.taskId にあります:
{"code":200,"data":{"taskId":"tk-hiapi-..."},"message":"success"}
長さは渡す必要はありません:セリフを使う場合はセリフの長さと話速で決まり、音声を使う場合は音声と同じ長さになります。
結果の照会
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer sk-YOUR_KEY"
data.status が success になったら、data.output の中から type が video の項目を探し、その url が MP4 です:
{
  "code": 200,
  "data": {
    "taskId": "tk-hiapi-...",
    "status": "success",
    "model": "heygen-avatar-iv",
    "output": [
      {"type": "video", "url": "https://temp.hiapi.ai/.../...-0.mp4"}
    ]
  },
  "message": "success"
}
Python 完全例:作成、ポーリング、ダウンロード
import time
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer sk-YOUR_KEY"}

payload = {
    "model": "heygen-avatar-iv",
    "input": {
        "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
        "prompt": "Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
        "voice": "Cute Chloe - Friendly",
        "resolution": "1080p",
        "aspect_ratio": "16:9",
    },
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=30)
task_id = resp.json()["data"]["taskId"]
print("task:", task_id)

while True:
    data = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(8)

if data["status"] == "success":
    video_url = next(o["url"] for o in data["output"] if o["type"] == "video")
    with open("avatar-iv.mp4", "wb") as f:
        f.write(requests.get(video_url, timeout=120).content)
    print("saved avatar-iv.mp4")
else:
    print(data.get("error"))
パラメータ一覧
| パラメータ | 必須 | デフォルト値 | 説明 |
|---|---|---|---|
image_url |
はい | — | 人物写真の公開 HTTPS リンク、はっきりした顔が1つ必要 |
prompt |
どちらか一方 | — | セリフ、最大5000文字、中国語も英語も可 |
voice |
いいえ | Warm Pro Narrator |
102個のプリセット音声、セリフ使用時のみ有効 |
audio_url |
どちらか一方 | — | 口の動きを駆動する音声、最長600秒 |
resolution |
いいえ | 720p |
720p または 1080p、同価格 |
aspect_ratio |
いいえ | 16:9 |
16:9、9:16、4:5、5:4、1:1、auto(写真の比率を継承) |
background |
いいえ | 白色 | {"type": "color" または "image", "value": ...}、画面の余白を埋める |
callback |
いいえ | — | {"url": "...", "when": "final"}、終了状態でタスクオブジェクトをプッシュ |
完全な音声リストは 中国語ドキュメント を参照。
2つの駆動方式と背景の使い方
セリフ駆動:prompt と voice を渡す、内容を大量に差し替えるのに適しています。以下の縦長ナレーションは、写真自体が 9:16 で、出力画面がちょうど埋まります:
1080p / 9:16、8秒、音声 Andrew。
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.
このセリフで生成 → セリフは入力済み、縦長の写真をアップロードし、9:16 を選べば生成できます。
音声駆動:すでにナレーションを録音済み、または自分の声を使いたい場合は、prompt と voice を audio_url に置き換えると、口の動きも間の取り方も録音に合わせます。
背景:出力画幅と写真の比率が異なる場合、画面に余白ができるので background で埋めます。単色なら {"type": "color", "value": "#F5EFE6"}、画像なら {"type": "image", "value": "https://..."} を渡します。以下の例は横長の先生写真を縦画面に入れ、上下を黒板画像で埋めています:
1080p / 9:16、11秒、音声 Professor Dean、background に黒板画像を使用。
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
このセリフで生成 → セリフは入力済みなので、自分の写真をアップロードするだけで生成できます。
公開前の注意点3つ
- サーバー側はコールバックを使う。 リクエストに
"callback": {"url": "https://yourapp.com/webhook", "when": "final"}を追加すると、タスク終了時に自動でプッシュされ、ポーリングを省けます。 taskIdを取得したら POST を繰り返さない。POST /v1/tasksのたびに新しいタスクが作られ、個別に課金されます。ネットワークタイムアウト時はまず自分がtaskIdを保存しているか確認し、あれば照会を続けるかコールバックを待ちます。- 成功したらすぐダウンロード。 出力リンクは期限切れになるので、結果を取得したら MP4 を自分のストレージに保存します。
課金の仕組みは?
1秒 $0.15、生成動画の実際の秒数で精算、解像度は価格に影響しないので 1080p をそのまま使えます。タスク作成時に推定時間で仮引きし、完了後に実際の秒数で差額を返金または追加請求、失敗したタスクは全額返金されます。
| 動画の長さ | 費用 |
|---|---|
| 5秒 | $0.75 |
| 10秒 | $1.50 |
| 30秒 | $4.50 |
| 60秒 | $9.00 |
費用は秒数だけに関係するので、節約したいならセリフを短く書きましょう。月300本の10秒ナレーションで約 $450、20本の60秒講座で約 $180。完全な価格表は 料金ページ を参照。
冒頭の小林の9秒動画は $1.35 かかりました。同じセリフで生成 → セリフは入力済み、自分の写真をアップロードして、自分の動画が何秒になるか計算してみましょう。
よくある質問
中国語のセリフは使えますか?
使えます。prompt は中国語と英語に対応、最大5000文字です。
自分の声は使えますか?
使えます。録音を audio_url に渡すと、最長600秒、口の動きがあなたの録音に合わせます。
どんな写真が最も良い結果になりますか? 正面向き、五官が隠れていない、光が均一、口が自然に閉じた単独の人物写真。イラストや3Dキャラクターも可ですが、はっきりした顔が必要です。横顔、マスク着用、複数人の集合写真、顔が小さい写真は別の写真で再試行してください。認識失敗したタスクは全額返金されます。
写真が横長で、縦長動画を作りたい場合は?
aspect_ratio を 9:16 に設定し、background で上下の余白を埋めます。上の黒板の例のように。
1本の動画にどれくらいかかりますか? 生成は非同期で、セリフが長いほど、解像度が高いほど待ち時間が長くなります。サーバー側はコールバックを使えば、終了時に自動でプッシュされます。
HeyGen Avatar IV 関連リンク
- HeyGen Avatar IV モデルページ:写真をアップロードしてオンライン生成
- HeyGen Avatar IV 中国語ドキュメント:全パラメータと102個の音声
- HeyGen Avatar V モデルページ:497個のプリセットデジタルヒューマン、透明背景と字幕に対応
- HiAPI 料金ページ:全モデルの秒課金、枚課金の価格
今すぐ試す:自分の正面向きの写真を用意し、小林のこのセリフで生成 →、セリフは入力済み、写真をアップロードし、1080p、16:9 を選べば、9秒ほどの動画が $1.35 です。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする