
튜토리얼
HeyGen Avatar IV API 사용법? 5분 만에 사진이 말을 하게 만들기
사진 한 장과 대사 또는 오디오만 있으면 말하는 영상이 생성됩니다. 바로 실행 가능한 cURL과 Python, 모든 파라미터 기본값, 배경 사용법, 출시 전 주의사항을 담았습니다.
TL;DR
- 무엇인가: HeyGen이 만든 사진 디지털 휴먼. 인물 사진 한 장과 대사(또는 오디오)로 사진 속 인물이 말하는 MP4를 생성합니다. 이미 HiAPI에 출시되었으며, 모델 페이지 열기에서 사진을 업로드하면 바로 생성할 수 있습니다.
- 얼마인가: 영상 초 단위로 과금, 초당 $0.15, 720p와 1080p 동일 가격, 10초 한 편에 $1.50.
- API 호출 방법:
POST https://api.hiapi.ai/v1/tasks,model에heygen-avatar-iv입력, 사진 링크와 대사를 전달하고taskId를 받아 조회하면 5분 만에 첫 실행이 가능합니다.
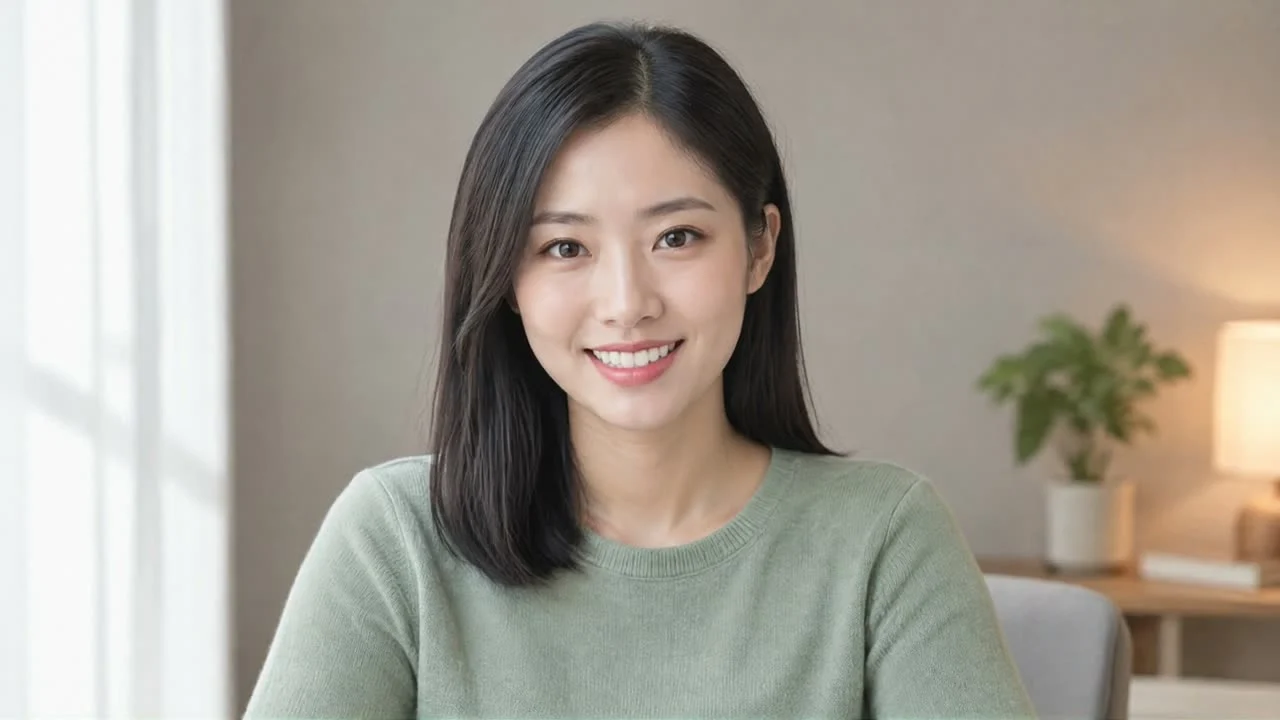
먼저 완성 영상 하나를 보겠습니다. 아래 9초짜리 가로형 설명 영상은 스웨터 반신 사진 한 장과 영어 대사 한 줄을 사용했습니다:
1080p / 16:9, 9초, 음성 Cute Chloe - Friendly. 사진 속 스웨터, 헤어스타일, 방은 그대로 유지되고 입 모양, 눈 깜빡임, 가벼운 끄덕임이 음성을 따라갑니다.
대사 원문:
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
이 대사로 생성 → 대사가 입력되어 있으니, 본인 사진을 업로드하면 생성할 수 있습니다.
HeyGen Avatar IV는 누구에게 적합한가?
사진 한 장이 있고 "이 사람"이 화면에 나와 말하게 하고 싶다면 이 모델을 쓰면 됩니다. 일반적인 용도:
- 제품 설명과 구매 유도: 같은 사진에 대사만 바꿔서 다양한 셀링 포인트의 숏폼 영상을 대량 제작.
- 강의와 교육: 강사가 한 번 사진을 녹화하면, 매 수업마다 강의 원고만 작성.
- 기업 공지와 고객센터 영상: 컨설턴트, 의사, 점장의 이미지는 고정하고 내용은 수시로 업데이트.
- 일러스트와 3D 캐릭터: 선명한 얼굴만 있으면 카툰 캐릭터도 말할 수 있습니다.
본인 이미지가 필요 없거나, 프리셋 디지털 휴먼 중에서 고르거나, 투명 배경·자막·4K가 필요하다면 HeyGen Avatar V를 선택하세요. 가격은 같습니다.
먼저 모델 페이지에서 한 번 시도하기
코드를 작성하기 전에 웹에서 한 편 생성해서 사진의 효과를 확인해 보세요:
- 위의 "이 대사로 생성"을 클릭하면 대사가 자동으로 입력됩니다.
- 정면, 균일한 조명의 1인 사진을 업로드합니다.
- 1080p, 16:9를 선택하고, 음성은 선택하지 않아도 되며 기본값은 Warm Pro Narrator입니다.
- 생성을 클릭하고 완료 후 온라인 미리보기로 확인하고, 만족하면 다운로드합니다.
10초 한 편에 $1.50, $10이면 약 66초 영상을 생성할 수 있으니, 사진 몇 장과 음성 몇 가지로 효과를 비교하기에 충분합니다.
API 호출 전 준비할 세 가지
- API Key: 콘솔에서 생성, 형식은
sk-...,Authorization: Bearer요청 헤더에 넣습니다. - 사진의 공인 HTTPS 링크: 정면, 이목구비 가림 없음, 균일한 조명, 입을 자연스럽게 다문 1인 사진이 가장 안정적입니다. 인터페이스는 링크로 사진을 읽으므로, 먼저 이미지를 본인의 스토리지나 CDN에 업로드하세요.
- 대사 또는 오디오, 둘 중 하나: 대사를 주면 선택한 음성으로 읽어줍니다. 오디오(
audio_url)를 주면 입 모양이 녹음에 맞춰 움직입니다.
최소 요청: cURL 버전
아래 사진 링크는 바로 사용 가능하며, 본인의 Key로 교체하면 실행됩니다:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
      "prompt": "Hi, I'\''m Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
      "voice": "Cute Chloe - Friendly",
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
반환된 작업 ID는 data.taskId에 있습니다:
{"code":200,"data":{"taskId":"tk-hiapi-..."},"message":"success"}
길이는 전달할 필요가 없습니다: 대사를 사용하면 대사 길이와 말 속도로 결정되고, 오디오를 사용하면 오디오와 같은 길이가 됩니다.
결과 조회
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer sk-YOUR_KEY"
data.status가 success로 바뀌면 data.output에서 type이 video인 항목을 찾으면, url이 MP4입니다:
{
  "code": 200,
  "data": {
    "taskId": "tk-hiapi-...",
    "status": "success",
    "model": "heygen-avatar-iv",
    "output": [
      {"type": "video", "url": "https://temp.hiapi.ai/.../...-0.mp4"}
    ]
  },
  "message": "success"
}
Python 전체 예제: 생성, 폴링, 다운로드
import time
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer sk-YOUR_KEY"}

payload = {
    "model": "heygen-avatar-iv",
    "input": {
        "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
        "prompt": "Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
        "voice": "Cute Chloe - Friendly",
        "resolution": "1080p",
        "aspect_ratio": "16:9",
    },
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=30)
task_id = resp.json()["data"]["taskId"]
print("task:", task_id)

while True:
    data = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(8)

if data["status"] == "success":
    video_url = next(o["url"] for o in data["output"] if o["type"] == "video")
    with open("avatar-iv.mp4", "wb") as f:
        f.write(requests.get(video_url, timeout=120).content)
    print("saved avatar-iv.mp4")
else:
    print(data.get("error"))
파라미터 일람
| 파라미터 | 필수 | 기본값 | 설명 |
|---|---|---|---|
image_url |
예 | — | 인물 사진의 공인 HTTPS 링크, 선명한 얼굴이 필요 |
prompt |
택 1 | — | 대사, 최대 5000자, 중국어와 영어 모두 가능 |
voice |
아니오 | Warm Pro Narrator |
102개의 프리셋 음성, 대사를 사용할 때만 적용 |
audio_url |
택 1 | — | 입 모양을 구동하는 오디오, 최대 600초 |
resolution |
아니오 | 720p |
720p 또는 1080p, 동일 가격 |
aspect_ratio |
아니오 | 16:9 |
16:9, 9:16, 4:5, 5:4, 1:1, auto(사진 비율 유지) |
background |
아니오 | 흰색 | {"type": "color" 또는 "image", "value": ...}, 화면 여백 채우기 |
callback |
아니오 | — | {"url": "...", "when": "final"}, 종료 시 작업 객체 푸시 |
전체 음성 목록은 중국어 문서에서 확인하세요.
두 가지 구동 방식과 배경 사용법
대사 구동: prompt와 voice를 전달, 콘텐츠를 대량으로 교체하기에 적합합니다. 아래 세로형 구두 방송은 사진 자체가 9:16이라 출력 화면이 꽉 차게 채워집니다:
1080p / 9:16, 8초, 음성 Andrew.
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.
이 대사로 생성 → 대사가 입력되어 있으니, 본인의 세로형 사진을 업로드하고 9:16을 선택하면 생성할 수 있습니다.
오디오 구동: 내레이션을 이미 녹음했거나 본인 목소리를 사용하려면 prompt와 voice를 audio_url로 교체하면 입 모양과 멈춤이 모두 녹음을 따라갑니다.
배경: 출력 화면 비율과 사진 비율이 다르면 여백이 생기는데, background로 채웁니다. 단색은 {"type": "color", "value": "#F5EFE6"}, 이미지는 {"type": "image", "value": "https://..."}를 전달합니다. 아래 영상은 가로형 선생님 사진을 세로 화면에 넣고 위아래를 칠판 이미지로 채웠습니다:
1080p / 9:16, 11초, 음성 Professor Dean, background에 칠판 이미지 사용.
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
이 대사로 생성 → 대사가 입력되어 있으니, 본인 사진을 업로드하면 생성할 수 있습니다.
출시 전 주의할 3가지
- 서버에서는 콜백을 사용하세요. 요청에
"callback": {"url": "https://yourapp.com/webhook", "when": "final"}를 추가하면 작업 종료 시 자동으로 푸시되어 폴링을 생략할 수 있습니다. taskId를 받은 후 POST를 반복하지 마세요.POST /v1/tasks를 할 때마다 새 작업이 생성되고 별도로 과금됩니다. 네트워크 타임아웃 시 먼저taskId를 저장했는지 확인하고, 있으면 계속 조회하거나 콜백을 기다리세요.- 성공 후 즉시 다운로드하세요. 출력 링크는 만료되므로, 결과를 받으면 MP4를 본인의 스토리지에 저장하세요.
과금 방식은?
초당 $0.15, 생성된 영상의 실제 초 단위로 정산, 해상도는 가격에 영향 없으므로 그냥 1080p를 사용하세요. 작업 생성 시 예상 길이로 선차감하고, 완료 후 실제 초 단위로 차액 정산(환불 또는 추가 청구), 실패한 작업은 전액 환불됩니다.
| 영상 길이 | 비용 |
|---|---|
| 5초 | $0.75 |
| 10초 | $1.50 |
| 30초 | $4.50 |
| 60초 | $9.00 |
비용은 초 수에만 비례하므로, 절약하려면 대사를 짧게 작성하세요. 월 300편의 10초 구두 방송은 약 $450, 20편의 60초 강의는 약 $180입니다. 전체 가격표는 가격 페이지에서 확인하세요.
도입부의 샤오린 씨 9초 영상은 $1.35가 들었습니다.같은 대사로 생성 → 대사가 입력되어 있으니, 본인 사진을 업로드하고 본인 영상의 길이를 계산해 보세요.
자주 묻는 질문
중국어 대사를 사용할 수 있나요?
가능합니다. prompt는 중국어와 영어를 지원하며, 최대 5000자입니다.
본인 목소리를 사용할 수 있나요?
가능합니다. 녹음을 audio_url로 전달하면 최대 600초, 입 모양이 녹음을 따라갑니다.
어떤 사진이 가장 효과가 좋은가요? 정면, 이목구비 가림 없음, 균일한 조명, 입을 자연스럽게 다문 1인 사진입니다. 일러스트와 3D 캐릭터도 가능하며, 선명한 얼굴이 있어야 합니다. 옆얼굴, 마스크 착용, 여러 명이 함께 찍은 사진, 얼굴이 너무 작은 사진은 다른 사진으로 교체 후 다시 시도하세요. 인식 실패한 작업은 전액 환불됩니다.
사진은 가로인데 세로 영상을 만들고 싶다면?
aspect_ratio를 9:16으로 설정하고, background로 위아래 여백을 채우세요. 위의 칠판 영상처럼 하면 됩니다.
한 편의 영상에 얼마나 걸리나요? 생성은 비동기이며, 대사가 길수록, 해상도가 높을수록 더 오래 걸립니다. 서버에서는 콜백을 사용하면 종료 시 자동으로 푸시됩니다.
HeyGen Avatar IV 관련 링크
- HeyGen Avatar IV 모델 페이지: 사진 업로드로 온라인 생성
- HeyGen Avatar IV 중국어 문서: 전체 파라미터와 102개 음성
- HeyGen Avatar V 모델 페이지: 497개 프리셋 디지털 휴먼, 투명 배경과 자막 지원
- HiAPI 가격 페이지: 모든 모델의 초 단위, 장 단위 가격
지금 바로 시도해 보세요: 본인의 정면 사진을 찾아 샤오린 씨의 이 대사로 생성 →, 대사가 입력되어 있으니, 사진을 업로드하고 1080p, 16:9를 선택하면 약 9초 영상 한 편에 $1.35입니다.
관련 글
모든 아티클 보기 →-

튜토리얼
HiAPI API로 hailuo-2.3-fast/image-to-video 호출하는 방법: curl과 Python 실전
빠르고 저렴한 이미지-투-비디오 등급의 첫 실행 요청 — 모델 ID부터 MP4 다운로드까지
-

튜토리얼
HiAPI API로 hailuo-2.3/text-to-video를 호출하는 방법: curl, Python 및 실행 가능한 요청 예시
-

튜토리얼
HiAPI에서 Kandinsky 6.0 Pro 텍스트-투-비디오 사용하기: curl 및 Python 튜토리얼
요청 우선 실전 데모: 프롬프트에서 비디오 클립까지의 호출 구성, 요청 제출, 완료 상태 폴링 및 결과 다운로드