
Tutorial
Wie verwende ich die HeyGen Avatar IV API? In 5 Minuten bringst du ein Foto zum Sprechen
Ein Foto plus ein Skript oder eine Audiodatei – und du erzeugst ein sprechendes Video. Inklusive direkt ausführbarem cURL und Python, allen Standardwerten der Parameter, der Verwendung von Hintergründen und Hinweisen vor dem Livegang.
TL;DR
- Was es ist: Ein Foto-Digitalhuman von HeyGen. Ein Porträtfoto plus ein Skript (oder eine Audiodatei) erzeugt ein MP4, in dem die Person auf dem Foto zu sprechen beginnt. Bereits auf HiAPI verfügbar – Modellseite öffnen, Foto hochladen und generieren.
- Was es kostet: Abrechnung nach Videosekunden, $0.15 pro Sekunde, 720p und 1080p zum gleichen Preis, ein 10-Sekunden-Video kostet $1.50.
- Wie man die API aufruft:
POST https://api.hiapi.ai/v1/tasks,modelaufheygen-avatar-ivsetzen, Foto-Link und Skript übergeben,taskIderhalten und abfragen – in 5 Minuten läuft dein erstes Video.
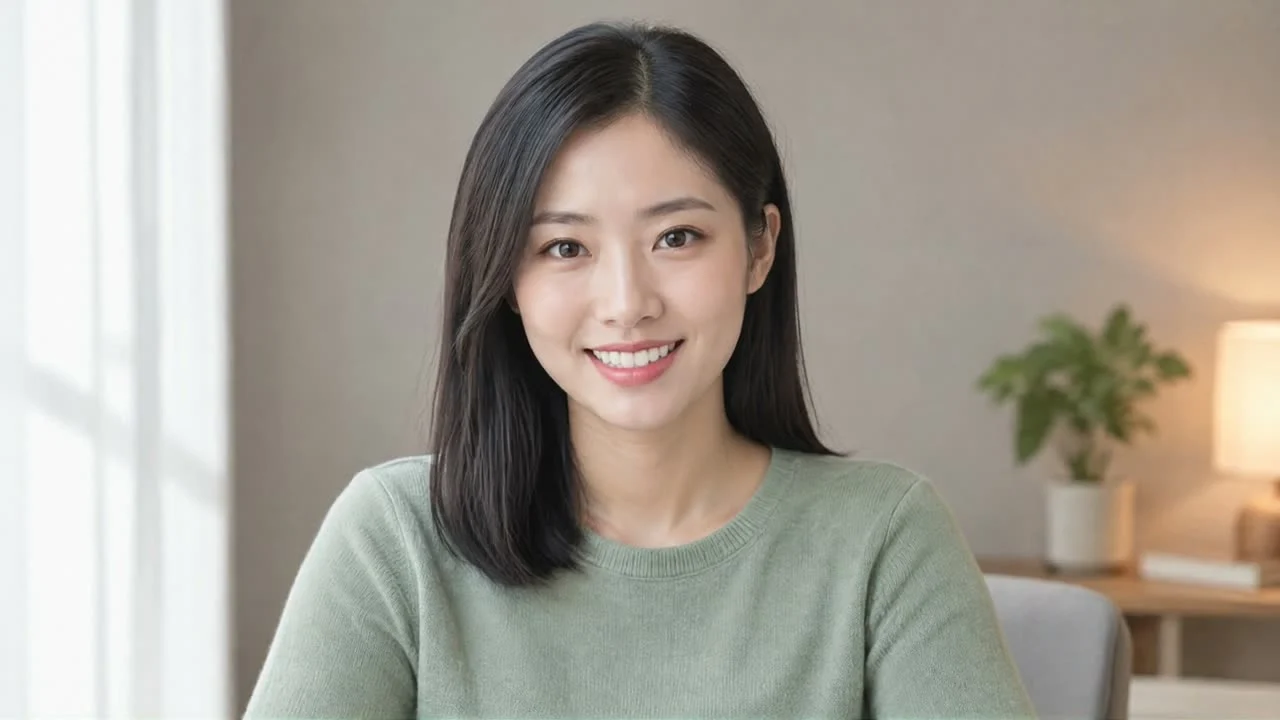
Schauen wir uns zuerst ein fertiges Video an. Dieser 9-sekündige Querformat-Clip nutzt ein Halbporträt im Pullover plus einen englischen Satz als Skript:
1080p / 16:9, 9 Sekunden, Stimme Cute Chloe - Friendly. Pullover, Frisur und Raum aus dem Foto bleiben erhalten, Lippenbewegungen, Blinzeln und leichtes Nicken folgen der Stimme.
Der Originaltext des Skripts:
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
Mit diesem Skript generieren → Das Skript ist bereits eingetragen, lade einfach dein eigenes Foto hoch und generiere.
Für wen ist HeyGen Avatar IV geeignet?
Wenn du ein Foto hast und „diese Person" sprechen lassen willst, ist es das richtige Werkzeug. Typische Anwendungen:
- Produkterklärungen und Empfehlungsvideos: Dasselbe Foto mit wechselnden Skripten, in Serie kurze Videos mit verschiedenen Verkaufsargumenten.
- Kurse und Schulungen: Die Lehrkraft nimmt einmal ein Foto auf, danach wird pro Lektion nur das Skript geschrieben.
- Unternehmensmitteilungen und Kundenservice-Videos: Die Erscheinung von Beratern, Ärzten oder Filialleitern bleibt gleich, der Inhalt wird jederzeit aktualisiert.
- Illustrationen und 3D-Charaktere: Solange ein klares Gesicht vorhanden ist, können auch Comicfiguren sprechen.
Wenn du keine eigene Erscheinung brauchst, aus vorgefertigten Digitalhumans wählen möchtest oder transparente Hintergründe, Untertitel oder 4K benötigst, wähle HeyGen Avatar V – zum gleichen Preis.
Zuerst einmal auf der Modellseite testen
Bevor du Code schreibst, erzeuge ein Video auf der Webseite, um zu sehen, wie dein Foto wirkt:
- Klicke oben auf „Mit diesem Skript generieren", das Skript wird automatisch eingetragen.
- Lade ein Einzelporträt mit frontalem Gesicht und gleichmäßiger Beleuchtung hoch.
- Wähle 1080p, 16:9; die Stimme kannst du weglassen, Standard ist Warm Pro Narrator.
- Klicke auf Generieren, sieh dir nach Abschluss die Online-Vorschau an und lade herunter, wenn es dir gefällt.
Ein 10-Sekunden-Video kostet $1.50, mit $10 kannst du etwa 66 Sekunden Video erzeugen – genug, um mehrere Fotos und Stimmen zu vergleichen.
Drei Dinge vor dem API-Aufruf vorbereiten
- API Key: Im Dashboard erstellen, Format
sk-..., im Request-HeaderAuthorization: Bearerablegen. - Öffentlicher HTTPS-Link zum Foto: Am zuverlässigsten ist ein Einzelporträt mit frontalem Gesicht, unverdeckten Gesichtszügen, gleichmäßiger Beleuchtung und natürlich geschlossenem Mund. Die Schnittstelle liest das Foto über den Link, lade das Bild zuerst in deinen eigenen Speicher oder dein CDN hoch.
- Skript oder Audio, eines von beiden: Gibst du ein Skript an, wird es von der gewählten Stimme vorgelesen; gibst du eine Audiodatei (
audio_url) an, folgen die Lippenbewegungen deiner Aufnahme.
Minimaler Request: cURL-Version
Der folgende Foto-Link kann direkt verwendet werden, tausche einfach deinen Key ein und los geht's:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
      "prompt": "Hi, I'\''m Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
      "voice": "Cute Chloe - Friendly",
      "resolution": "1080p",
      "aspect_ratio": "16:9"
    }
  }'
Die zurückgegebene Task-ID steht in data.taskId:
{"code":200,"data":{"taskId":"tk-hiapi-..."},"message":"success"}
Die Dauer musst du nicht übergeben: Bei einem Skript ergibt sie sich aus Länge und Sprechtempo, bei einer Audiodatei ist sie so lang wie die Audiodatei.
Ergebnis abfragen
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer sk-YOUR_KEY"
Sobald data.status zu success wird, suche in data.output den Eintrag, dessen type gleich video ist – die url ist das MP4:
{
  "code": 200,
  "data": {
    "taskId": "tk-hiapi-...",
    "status": "success",
    "model": "heygen-avatar-iv",
    "output": [
      {"type": "video", "url": "https://temp.hiapi.ai/.../...-0.mp4"}
    ]
  },
  "message": "success"
}
Vollständiges Python-Beispiel: Erstellen, Abfragen, Herunterladen
import time
import requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer sk-YOUR_KEY"}

payload = {
    "model": "heygen-avatar-iv",
    "input": {
        "image_url": "https://static.hiapi.ai/blog/heygen-avatar-iv/portrait-landscape.jpg",
        "prompt": "Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
        "voice": "Cute Chloe - Friendly",
        "resolution": "1080p",
        "aspect_ratio": "16:9",
    },
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=30)
task_id = resp.json()["data"]["taskId"]
print("task:", task_id)

while True:
    data = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(8)

if data["status"] == "success":
    video_url = next(o["url"] for o in data["output"] if o["type"] == "video")
    with open("avatar-iv.mp4", "wb") as f:
        f.write(requests.get(video_url, timeout=120).content)
    print("saved avatar-iv.mp4")
else:
    print(data.get("error"))
Parameterübersicht
| Parameter | Erforderlich | Standardwert | Beschreibung |
|---|---|---|---|
image_url |
Ja | — | Öffentlicher HTTPS-Link zum Porträtfoto, ein klares Gesicht ist erforderlich |
prompt |
Eines von beiden | — | Skript, maximal 5000 Zeichen, Chinesisch und Englisch möglich |
voice |
Nein | Warm Pro Narrator |
102 vorgefertigte Stimmen, wirkt nur bei Verwendung eines Skripts |
audio_url |
Eines von beiden | — | Audiodatei, die die Lippenbewegungen steuert, maximal 600 Sekunden |
resolution |
Nein | 720p |
720p oder 1080p, gleicher Preis |
aspect_ratio |
Nein | 16:9 |
16:9, 9:16, 4:5, 5:4, 1:1, auto (übernimmt das Fotoformat) |
background |
Nein | Weiß | {"type": "color" oder "image", "value": ...}, füllt den Leerraum der Bildfläche |
callback |
Nein | — | {"url": "...", "when": "final"}, sendet das Task-Objekt im Endzustand |
Die vollständige Stimmenliste findest du in der chinesischen Dokumentation.
Zwei Steuerungsarten und die Verwendung von Hintergründen
Skriptgesteuert: Übergib prompt und voice, ideal für das serienweise Wechseln von Inhalten. Der folgende vertikale Sprechclip – das Foto selbst ist bereits 9:16, sodass die Ausgabe das Bild genau ausfüllt:
1080p / 9:16, 8 Sekunden, Stimme Andrew.
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.
Mit diesem Skript generieren → Das Skript ist bereits eingetragen, lade dein Hochformat-Foto hoch und wähle 9:16, dann kannst du generieren.
Audiogesteuert: Wenn du bereits einen Off-Kommentar aufgenommen hast oder deine eigene Stimme verwenden willst, ersetze prompt und voice durch audio_url, Lippenbewegungen und Pausen folgen der Aufnahme.
Hintergrund: Wenn Ausgabeformat und Fotoformat nicht übereinstimmen, bleibt Leerraum, den du mit background füllst. Für Volltonfarbe übergib {"type": "color", "value": "#F5EFE6"}, für ein Bild {"type": "image", "value": "https://..."}. Das folgende Video setzt ein Querformat-Lehrerfoto in das Hochformat und füllt oben und unten mit einem Tafelbild:
1080p / 9:16, 11 Sekunden, Stimme Professor Dean, background mit einem Tafelbild.
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.
Mit diesem Skript generieren → Das Skript ist bereits eingetragen, lade einfach dein Foto hoch und generiere.
Diese 3 Dinge vor dem Livegang beachten
- Serverseitig Callbacks verwenden. Füge im Request
"callback": {"url": "https://yourapp.com/webhook", "when": "final"}hinzu, um bei Abschluss automatisch benachrichtigt zu werden und das Polling zu sparen. - Nach Erhalt der
taskIdnicht erneut POSTen. JedesPOST /v1/taskslegt einen neuen Task an und wird separat abgerechnet. Prüfe bei Netzwerk-Timeout zuerst, ob du dietaskIdgespeichert hast; wenn ja, frage weiter ab oder warte auf den Callback. - Nach Erfolg sofort herunterladen. Ausgabe-Links laufen ab; sobald du das Ergebnis hast, speichere das MP4 in deinem eigenen Speicher.
Wie wird abgerechnet?
$0.15 pro Sekunde, abgerechnet nach den tatsächlichen Sekunden des generierten Videos, die Auflösung beeinflusst den Preis nicht – verwende also direkt 1080p. Beim Anlegen eines Tasks wird eine Schätzung der Dauer vorab berechnet, nach Abschluss wird anhand der tatsächlichen Sekunden nachberechnet, fehlgeschlagene Tasks werden vollständig zurückerstattet.
| Videodauer | Kosten |
|---|---|
| 5 Sekunden | $0.75 |
| 10 Sekunden | $1.50 |
| 30 Sekunden | $4.50 |
| 60 Sekunden | $9.00 |
Die Kosten hängen nur von den Sekunden ab – spare Geld, indem du das Skript kurz hältst. 300 Sprechclips à 10 Sekunden pro Monat kosten etwa $450, 20 Kurse à 60 Sekunden etwa $180. Die vollständige Preisliste findest du auf der Preisseite.
Das 9-sekündige Video von Lin am Anfang hat $1.35 gekostet. Mit demselben Skript generieren → Das Skript ist bereits eingetragen, lade dein Foto hoch und rechne aus, wie viele Sekunden dein Video braucht.
Häufige Fragen
Kann ich ein chinesisches Skript verwenden?
Ja. prompt unterstützt Chinesisch und Englisch, maximal 5000 Zeichen.
Kann ich meine eigene Stimme verwenden?
Ja. Übergib die Aufnahme an audio_url, maximal 600 Sekunden, die Lippenbewegungen folgen deiner Aufnahme.
Welche Fotos liefern die besten Ergebnisse? Einzelporträts mit frontalem Gesicht, unverdeckten Gesichtszügen, gleichmäßiger Beleuchtung und natürlich geschlossenem Mund. Illustrationen und 3D-Charaktere funktionieren auch, solange ein klares Gesicht vorhanden ist. Bei Seitenprofil, Mundschutz, Gruppenfotos oder Fotos mit sehr kleinem Gesicht lade ein anderes Foto und versuche es erneut; fehlgeschlagene Erkennungen werden vollständig zurückerstattet.
Das Foto ist im Querformat, aber ich möchte ein Hochformat-Video – was tun?
Setze aspect_ratio auf 9:16 und fülle den Leerraum oben und unten mit background, wie im Tafel-Beispiel oben.
Wie lange dauert ein Video? Die Generierung ist asynchron: Je länger das Skript und je höher die Auflösung, desto länger die Wartezeit. Verwende serverseitig Callbacks, um bei Abschluss automatisch benachrichtigt zu werden.
Relevante Links zu HeyGen Avatar IV
- HeyGen Avatar IV Modellseite: Foto hochladen und online generieren
- HeyGen Avatar IV chinesische Dokumentation: alle Parameter und 102 Stimmen
- HeyGen Avatar V Modellseite: 497 vorgefertigte Digitalhumans, unterstützt transparente Hintergründe und Untertitel
- HiAPI Preisseite: sekunden- und stückbasierte Preise aller Modelle
Jetzt ausprobieren: Such dir ein frontales Porträtfoto von dir, generiere mit diesem Skript von Lin →, das Skript ist bereits eingetragen, lade dein Foto hoch, wähle 1080p, 16:9 – ein etwa 9-sekündiges Video kostet $1.35.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses