
Guide d'utilisation
Générer des vidéos courtes avec heygen-avatar-iv via l'API HiAPI : guide du développeur
Entrées d'avatar et d'audio, rythme du script, format d'image et durée, et génération par lots — avec des requêtes HiAPI exécutables
Sur cette page
Pourquoi choisir heygen-avatar-iv pour les vidéos courtes
Les vidéos courtes sont devenues le canal de diffusion par défaut pour les lancements de produits, les annonces de mises à jour, les explications de documentation et les clips pour les réseaux sociaux. Pour la plupart des équipes d'ingénierie, le goulot d'étranglement n'est pas le montage — mais la production régulière de séquences de présentation avec un humain à l'écran, sans avoir à réserver un studio ni à échanger des médias avec un présentateur humain.
C'est exactement le vide que comble la génération de vidéos d'avatar numérique. Vous fournissez l'apparence visuelle et la source audio/voix, et le modèle renvoie un clip rendu de cet avatar lisant le script. heygen-avatar-iv est le point de terminaison du catalogue HiAPI dédié à ce flux de travail : des clips courts, prioritairement verticaux, où un présentateur parle face caméra.
Ce modèle convient aux scénarios suivants :
- Vous devez produire à grande échelle. Dix versions localisées d'une même annonce, ou un clip quotidien à chaque publication : c'est une boucle, pas une séance de tournage.
- Le contenu est piloté par un script. Si le message est dans le texte, un présentateur numérique suffit.
- Vous voulez de la reproductibilité. Une requête produit un fichier, que vous pouvez comparer, versionner et réexécuter — contrairement à une session d'enregistrement.
- Vous appelez déjà l'API. Un simple appel HTTP s'intègre à votre pipeline existant, sans introduire un nouvel outil avec une interface dédiée.
Il ne convient pas aux performances improvisées avec de grands gestes, ni aux scénarios où la présence physique d'une personne spécifique est l'argument de vente. Considérez heygen-avatar-iv comme un moteur de rendu : avec les mêmes entrées, il doit produire le même type de sortie, ce qui le rend scriptable.
Le reste de ce guide passe d'un appel de test unique à une boucle par lots, avec des exemples curl et Python exécutables que vous pouvez adapter. Les détails du modèle et les paramètres sont sur la page du modèle heygen-avatar-iv.
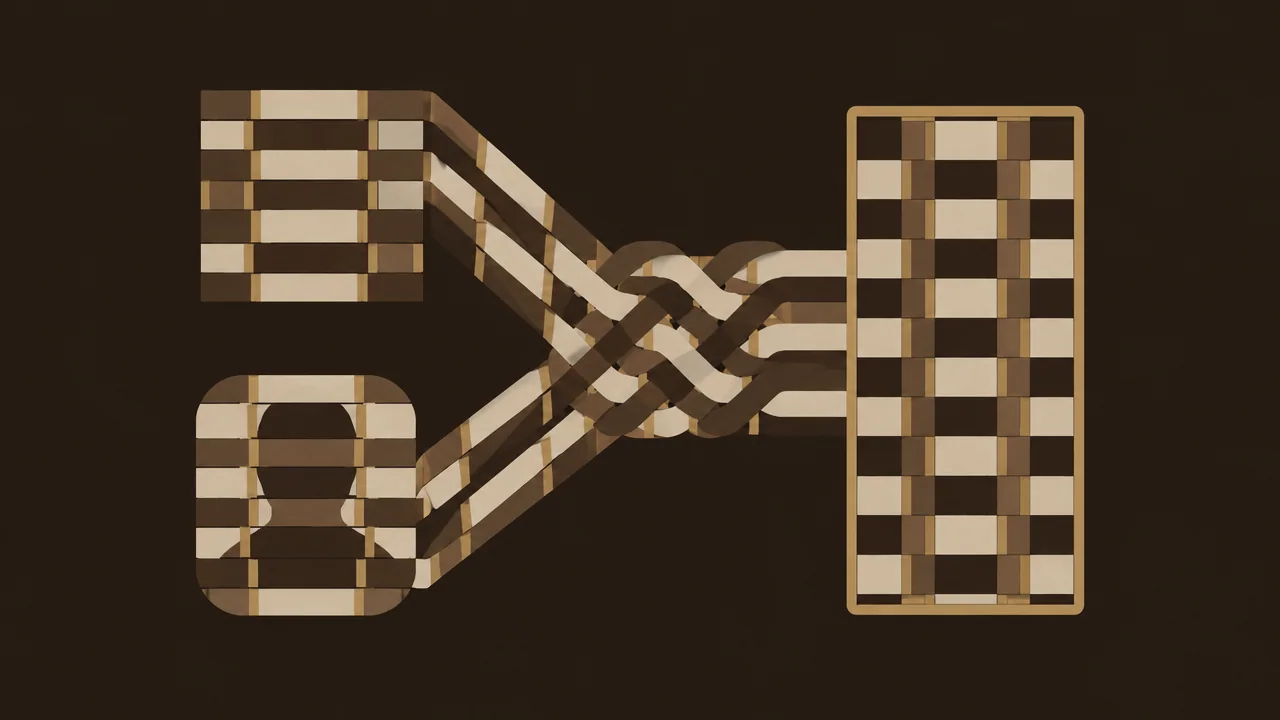
Composition d'une requête heygen-avatar-iv
Avant d'écrire du code de génération, modélisez la requête en deux groupes d'entrées distincts. Presque tous les bugs précoces viennent de leur confusion.
Groupe 1 : l'apparence visuelle
C'est qui apparaît — le choix d'avatar numérique qui détermine le visage du présentateur, la composition et l'apparence générale. Gardez ce groupe stable au sein d'une campagne. Si vous produisez cinq clips sur le même produit, ils doivent partager le même bloc d'apparence pour que la série paraisse incarnée par le même présentateur.
Groupe 2 : l'audio et la voix
C'est ce qui est dit et comment. Selon la requête, la source audio peut être un choix de voix lisant votre script, ou une piste audio fournie. Ce groupe varie à chaque clip : nouveau script, nouveau rythme, parfois nouvelle voix pour une localisation.
Comment ils se mappent à l'appel
La requête HiAPI envoie les deux groupes dans la même charge utile vers le point de terminaison de génération. Conceptuellement :
requête
├── bloc avatar / identité   → stable au sein d'une série
└── bloc audio / voix        → varie à chaque clip
        └── texte du script ou source audio
Cette séparation conduit à deux règles pratiques :
- Paramétrez le groupe audio, figez le groupe apparence. Dans le code, gardez l'apparence comme constante au niveau du module, et passez le script et la voix comme arguments de fonction. Cela garantit structurellement la cohérence visuelle d'une série.
- En débogage, ne changez qu'un groupe à la fois. Si le clip semble incorrect, remplacez uniquement l'apparence ; si le son est incorrect, remplacez uniquement le groupe audio. Un débogage à deux variables sur des appels de rendu payants coûte cher.
Déterminez également dès le départ si votre groupe audio est piloté par le texte ou par une piste audio, car ce choix détermine le rythme de la section suivante — une piste fournie impose le timing, tandis que la voix générée suit votre script.
Les noms exacts des champs, les valeurs acceptées et les valeurs par défaut sont listés sur la page du modèle ; lisez-les et fixez-les dans un objet de configuration plutôt que de disperser des littéraux dans le code.
Lancer votre premier appel avec curl
Commencez par un clip court. L'objectif de cet appel n'est pas la qualité de sortie — mais de valider de bout en bout les identifiants, la forme de la charge utile et le chemin de téléchargement, avant toute automatisation.
Placez la clé dans une variable d'environnement pour qu'elle n'apparaisse jamais en clair dans l'historique du shell :
export HIAPI_API_KEY="your_key_here"
Envoyez ensuite une requête minimale. Remplacez par votre propre choix d'avatar et un script d'une ligne :
curl -X POST "https://api.hiapi.ai/v1/generate" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "avatar": "<avatar_identifier>",
      "script": "Ceci est un test de trente secondes pour le pipeline d'avatar numérique. Si vous pouvez lire cette phrase à l'écran, la forme de la requête est correcte.",
      "voice": "<voice_identifier>",
      "aspect_ratio": "9:16",
      "duration": 30
    }
  }'
Vérifiez dans l'ordre :
- Authentification. Une erreur d'identifiants ici signifie qu'il faut s'arrêter — tout le reste en aval n'a pas d'importance.
- Validation de la charge utile. Une erreur de schéma indique le champ problématique. Corrigez un champ à la fois.
- Acceptation de la tâche. Un appel réussi renvoie une référence de job ou de tâche, pas nécessairement le fichier final. La génération est asynchrone ; enregistrez cet identifiant.
- Récupération du résultat. Selon le contrat de réponse de la page du modèle, interrogez l'état ou récupérez l'URL du résultat avec la référence renvoyée.
- Lecture. Téléchargez le clip et regardez-le. Vérifiez que la composition, l'orientation et le contenu lu correspondent au script.
Conservez cette commande curl dans un fichier de brouillon avec vos vrais identifiants. Elle servira de test de contrôle : quand la version Python pose problème, relancez le curl pour déterminer si le problème vient de votre code ou des entrées.
Passer à Python pour une génération reproductible
Une fois l'appel curl réussi, encapsulez-le dans une fonction. L'intérêt n'est pas l'abstraction pour elle-même — mais de rendre chaque paramètre explicite, afin que le clip soit entièrement décrit par le point d'appel.
import os
import requests

API_URL = "https://api.hiapi.ai/v1/generate"
API_KEY = os.environ["HIAPI_API_KEY"]

# Stable au sein d'une série
AVATAR = "<avatar_identifier>"


def generate_clip(script: str, voice: str, aspect_ratio: str = "9:16",
                  duration: int = 30) -> dict:
    payload = {
        "model": "heygen-avatar-iv",
        "input": {
            "avatar": AVATAR,
            "script": script,
            "voice": voice,
            "aspect_ratio": aspect_ratio,
            "duration": duration,
        },
    }
    resp = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    return resp.json()


if __name__ == "__main__":
    job = generate_clip(
        script="Ceci est un test de trente secondes pour le pipeline d'avatar numérique.",
        voice="<voice_identifier>",
    )
    print(job)
Points de conception utiles à long terme :
- Les valeurs par défaut reflètent vos clips les plus courants. Si la plupart des sorties sont des clips verticaux courts, faites-en les valeurs par défaut et ne les surchargez que rarement.
- L'apparence au niveau du module. Le choix d'avatar n'existe qu'à un seul endroit ; un changement de marque ne nécessite qu'une ligne.
- Renvoyez la réponse complète. N'extrayez pas immédiatement l'URL en jetant l'objet job ; vous aurez besoin de cet identifiant pour les logs et les réessais.
- Levez une exception sur erreur HTTP. Un échec silencieux dans une boucle par lots est pire qu'un plantage.
- Gérez explicitement l'étape asynchrone. Ajoutez un petit assistant
poll(job_id)plutôt que de dormir à l'intérieur de la fonction de génération.
Alignez la logique de traitement de la réponse sur le contrat documenté sur la page du modèle — les noms de champs pour l'état du job et la récupération du résultat sont les plus susceptibles de différer de vos suppositions.
Rédiger le script de présentation et contrôler le rythme
Une vidéo d'avatar numérique est audio-first. Un script qui se lit bien sur le papier est souvent trop long à l'oral, et couper après génération signifie payer le rendu de texte que vous allez supprimer.
Écrivez d'abord selon la longueur, puis coupez
Estimez la durée avant d'appeler l'API. Un débit confortable est d'environ 130 à 160 mots par minute ; pour du contenu technique que le public doit suivre, utilisez la fourchette basse. Ainsi, un clip de 30 secondes nécessite environ 65 à 80 mots, et un clip de 60 secondes environ 130 à 160 mots. Rédigez selon ce budget, lisez à voix haute avec un chronomètre, puis coupez. Si vous devez couper, supprimez des phrases entières plutôt que des mots — la coupe au niveau de la phrase préserve le rythme.
Écrivez pour l'oreille
- Phrases courtes. Une idée par phrase. C'est dans les propositions subordonnées que la compréhension chute.
- Évitez les références purement visuelles. « Comme illustré ci-dessous » ne fonctionne pas sans diapositive.
- Mettez l'essentiel en premier. Le public des vidéos courtes décide dans les premières secondes ; placez l'argument dans la première phrase.
- Épelez ce que la synthèse vocale lirait mal. Les abréviations, les chaînes de version et les noms de produits aux majuscules inhabituelles doivent être écrits comme ils doivent être prononcés.
Contrôlez le rythme selon la chronologie
Répartissez le script en blocs temporels selon la longueur cible :
0–5 s    accroche : l'argument ou le problème
5–20 s   corps : le mécanisme, deux ou trois phrases
20–28 s  détail : un chiffre ou un exemple à retenir
28–30 s  conclusion : un seul appel à l'action
Cette structure en blocs sert aussi d'artefact de revue — un relecteur peut rejeter un bloc sans que vous ayez à tout re-rendre. Conservez le script de chaque clip dans un fichier séparé, versionné avec le code qui le rend, et la boucle par lots de la section suivante devient entièrement reproductible.
Définir le format d'image, la durée et la sortie
Avant le premier rendu, décidez de l'orientation et de la longueur en fonction de la plateforme cible. Re-rendre un clip fini dans une seconde orientation est un pur gaspillage, et re-monter un clip trop long signifie régénérer aussi l'audio.
Format d'image
- 9:16 vertical — le format par défaut des fils de vidéos courtes : shorts, reels, stories et emplacements mobiles. Concevez la composition pour ce format en priorité ; découpez les autres ratios à partir du master vertical quand c'est possible.
- 16:9 horizontal — lecteurs intégrés, pages d'atterrissage, vidéos de documentation et présentations.
- 1:1 carré — emplacements de fil préférant le carré. Bon pour une déclinaison secondaire.
Si votre campagne nécessite deux orientations, traitez-les comme deux tâches distinctes avec des scripts différents, plutôt que de rendre deux fois le même script — une phrase adaptée à un vertical de 30 secondes laisse souvent un blanc dans un montage carré plus court.
Durée
Définissez la durée en fonction du budget de script de la section précédente, pas l'inverse. Transmettez une durée correspondant à la longueur réelle de la lecture ; un clip rempli ou coupé en milieu de phrase semble cassé. Placez les cibles par plateforme dans la configuration pour les ajuster facilement :
TARGETS = {
    "vertical": {"aspect_ratio": "9:16", "duration": 30},
    "horizontal": {"aspect_ratio": "16:9", "duration": 45},
}
Sortie
Téléchargez et stockez vous-même les clips finis, plutôt que de dépendre d'URL de résultats temporaires. Une convention simple — {clip_id}-{orientation}-{version}.mp4 — garde les déclinaisons traçables et rend les fichiers obsolètes évidents. Enregistrez l'identifiant de job avec le fichier, pour que chaque clip puisse être rattaché à sa requête exacte.
La facturation s'applique aux générations demandées — selon la durée et le nombre de clips — donc affiner le script avant le rendu est l'optimisation la moins chère à votre disposition. Les tarifs actuels figurent dans le panneau de tarification.
Générer plusieurs clips par lots
Avec une fonction opérationnelle, le traitement par lots n'est qu'une boucle sur une liste de tâches. L'essentiel est que chaque tâche décrive complètement un clip.
JOBS = [
    {"id": "launch-vertical", "script_file": "scripts/launch.txt",
     "voice": "<voice_a>", "aspect_ratio": "9:16", "duration": 30},
    {"id": "launch-square", "script_file": "scripts/launch_sq.txt",
     "voice": "<voice_a>", "aspect_ratio": "1:1", "duration": 20},
    {"id": "changelog-vertical", "script_file": "scripts/changelog.txt",
     "voice": "<voice_b>", "aspect_ratio": "9:16", "duration": 30},
]

results = []
for job in JOBS:
    with open(job["script_file"]) as f:
        script = f.read().strip()
    print(f"submitting {job['id']} ({len(script.split())} words)")
    resp = generate_clip(
        script=script,
        voice=job["voice"],
        aspect_ratio=job["aspect_ratio"],
        duration=job["duration"],
    )
    results.append({"id": job["id"], "job": resp})
Modèles à adopter :
- Scripts en fichiers, pas en littéraux de chaîne. Ils peuvent être relus, comparés et réutilisés entre orientations.
- Journal du nombre de mots. Afficher le nombre de mots de chaque tâche permet de repérer avant le rendu les scripts qui dépasseront la durée.
- Identifiants de job stables. Utilisez-les dans les noms de fichiers de sortie et les logs, pour identifier les clips en échec parmi vingt exécutions.
- Échec souple, puis rapport. Entourez chaque soumission d'un try/except, collectez les échecs et continuez — un mauvais script ne doit pas interrompre tout le lot.
- Respectez les limites de débit et la concurrence. Commencez en série ; n'ajoutez un pool de threads borné qu'une fois l'exécution en série stable.
- Persistez la liste des résultats. Écrivez les identifiants de job dans un fichier JSON pour qu'un lot partiellement terminé puisse reprendre au lieu de redémarrer.
Points de défaillance courants et vérifications
Voici les problèmes qui apparaissent en premier. Chacun a une vérification d'isolement peu coûteuse.
Erreur de format d'entrée
Les erreurs de schéma sont l'échec initial le plus courant. Vérification : exécutez la commande curl d'origine avec les mêmes identifiants. Si curl réussit et que Python échoue, le bug est dans votre sérialisation — souvent un type incorrect, par exemple une chaîne passée là où un entier duration est attendu, ou un saut de ligne supplémentaire en fin de fichier de script.
Incohérence entre audio et script
Si la voix ne dit pas ce qui est attendu à l'écran, ou si le clip est muet, le groupe audio est incorrect. Vérification : confirmez si la requête est pilotée par le texte ou par une piste audio, et assurez-vous de transmettre le champ correspondant. Fournir à la fois une piste audio et un champ script est un conflit silencieux classique — décidez lequel prime et retirez l'autre.
Orientation incorrecte ou bandes noires
Le clip revient avec des bandes noires ou un cadre inattendu. Vérification : vérifiez que aspect_ratio atteint bien la charge utile — une valeur par défaut dans la fonction peut silencieusement écraser celle que vous pensiez transmettre. Journalisez la charge utile assemblée avant l'envoi.
Durée incohérente
Le clip est coupé en milieu de phrase ou traîne. Vérification : comparez le nombre de mots du script au budget de durée. Corrigez le script plutôt que la durée, sauf si la cible elle-même est erronée.
Dérive d'apparence dans une série
Des clips d'une même campagne semblent avoir des présentateurs différents. Vérification : assurez-vous que l'identifiant d'avatar provient d'une seule constante, et non d'une configuration par tâche.
Sortie tronquée ou manquante
Le job réussit mais le fichier est incomplet. Vérification : avant de télécharger, confirmez que le job a atteint l'état final de succès, et que vous suivez le contrat de récupération de la page du modèle plutôt que de deviner l'URL.
Règle générale : un clip de test, une requête curl, une variable à la fois. Validez d'abord de bout en bout avec un court rendu vertical via le modèle heygen-avatar-iv, puis laissez la boucle s'étendre.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage avec gpt-6.2-sol : limites de capacité, intégration API et tarification par token
Points de décision et de pratique pour l'intégration par les équipes d'ingénierie
-

Guide d'utilisation
Guide de prise en main de gpt-6.2-astra : limites de capacités du modèle texte, points d'intégration et maîtrise des coûts
-

Guide d'utilisation
Guide de prise en main de Tripo H3.1 : trois modes d'entrée, paramètres et choix tarifaires
Décision d'intégration et maîtrise des coûts de la génération 3D pour les développeurs