
Tutoriel
mirelo-sfx-2.0 en pratique : 5 scénarios d'application à forte valeur pour un modèle audio et points clés d'intégration
De la facturation à la seconde à la mise en production : découpage des scénarios et points de mise en œuvre du point de vue du développeur
Pourquoi un modèle audio mérite une évaluation dédiée
Dans une stack technique, les modèles de texte et d'image ont des paradigmes d'intégration relativement matures : on saisit un prompt, on obtient des tokens ou des pixels, et la dimension de facturation est claire. Les modèles produisant de l'audio sont souvent relégués au rang de « multimodal » sans plus de détail, jusqu'à ce qu'une équipe doive réellement produire des effets sonores, des doublages ou de l'audio dynamique et découvre que leurs contraintes d'intégration sont totalement différentes.
La différence fondamentale réside dans l'unité de mesure du résultat. Le texte se facture au token, l'image au nombre d'images ou à la résolution, tandis que l'unité naturelle de l'audio est la durée (en secondes). Cela signifie qu'un appel ne produit pas « un résultat », mais « une portion de timeline plus ou moins longue » ; le coût croît linéairement avec la durée de l'audio, et non avec le nombre d'appels. Cela change directement la méthode d'estimation : on ne peut plus se contenter de suivre les QPS, il faut suivre le « nombre total de secondes générées ».
La deuxième différence est que le temps de génération dépend de la durée. Un audio de plusieurs dizaines de secondes ne peut souvent pas être renvoyé dans la fenêtre de timeout d'une requête synchrone classique ; un modèle audio est donc naturellement plus adapté à un mode de tâches asynchrones : soumettre une tâche, interroger par polling ou callback, récupérer l'URL du résultat. Ce point est facile à négliger au stade du prototype et ne se révèle qu'en production sous forme de timeouts et de tempêtes de retries.
La troisième différence est que les résultats doivent être stockés et réutilisés. Un fichier audio est bien plus volumineux qu'un texte, et un même effet sonore est souvent réutilisé de nombreuses fois dans un produit. Sans cache ni gestion d'actifs, la régénération répétée amplifie directement le coût facturé à la seconde.
Un modèle audio mérite donc une évaluation dédiée : ce n'est pas une simple « modalité ajoutée », mais un pipeline indépendant de génération asynchrone + gestion d'actifs. Avec mirelo-sfx-2.0 par exemple, le type de sortie est l'audio et la base de facturation est le nombre de secondes produites, ce qui détermine la forme d'ingénierie de tous les scénarios qui suivent. Le critère pour décider de l'intégrer à la stack est lui aussi très concret : votre produit comporte-t-il une étape qui « a besoin d'un son jouable », et cette durée comme la fréquence d'appel peuvent-elles être mesurées et encadrées ?
Commencer par le coût : ce que signifie une facturation à la seconde
Facturer à la seconde revient essentiellement à remplacer la fonction de coût « nombre d'appels × prix unitaire » par « secondes produites × prix par seconde ». Cette conversion paraît simple, mais elle modifie sensiblement la forme du modèle budgétaire.
Formule de coût
Coût d'un appel ≈ secondes d'audio produites × prix par seconde. Coût mensuel ≈ total des secondes générées dans le mois × prix par seconde. Attention, le mot clé est produites : ce qui détermine la facture est la durée finale de l'audio obtenu, et non le nombre de requêtes émises. Un effet sonore de 30 secondes et trente effets d'une seconde sont équivalents en secondes, mais totalement différents en surcoût d'appel, en taux de cache et en complexité d'ingénierie.
Trois sources de dérive faciles
Premièrement, l'amplification par les retries. Les retries de tâches asynchrones échouées, les clics répétés des utilisateurs et les déclenchements erronés du polling côté front-end font générer plusieurs fois le même audio. Si chaque échec relance intégralement la tâche, la facture double à chaque retry.
Deuxièmement, l'explosion linéaire des audios longs. Doubler la durée double le coût, sans rendement décroissant. Pour les contenus longs comme les podcasts ou les livres audio, il faut d'abord calculer la durée totale avant de décider d'une génération complète.
Troisièmement, la longue traîne des appels expérimentaux. Les tests A/B et les essais de matériaux génèrent souvent beaucoup de courts extraits ; le coût unitaire semble faible, mais le nombre de versions multiplié par le nombre d'extraits donne un volume considérable.
Méthode d'estimation
Il est conseillé d'établir un modèle de coût simple avant l'intégration : estimer le total mensuel de secondes avec « durée moyenne d'un audio × nombre de générations prévues par jour × 30 », puis multiplier par le prix unitaire. Ajoutez deux garde-fous : une durée maximale par tâche et une alerte sur le quota mensuel de secondes. Le débat budgétaire passe ainsi de « est-ce cher ? » à « peut-on réduire le total de secondes ? ». Les leviers de réduction sont clairs : réutiliser le cache, raccourcir la durée par défaut, n'appeler le modèle que pour les extraits nécessaires — pour le prix exact, référez-vous au panneau tarifaire du site ; côté ingénierie, la variable à surveiller est le nombre de secondes.
Scénario 1 : génération d'effets sonores en masse pour vidéos courtes et publicités
Le pipeline de production de contenu est le scénario où un modèle audio affiche le plus facilement son ROI : vidéos courtes standardisées, publicités dans les fils d'actualité, vidéos de fiches produits e-commerce ont besoin d'effets sonores « en volume, homogènes et générables en masse ».
Forme de mise en œuvre
Intégrez la génération audio dans le pipeline de rendu existant : une fois le modèle de matériau défini, découpez les besoins d'effets sonores par plan ou par scène (transitions, clics, nappes d'ambiance), soumettez les tâches de génération en lot, écrivez les résultats dans le stockage objet et enregistrez-les dans la bibliothèque d'actifs, puis faites référence aux ID par le service de rendu. L'essentiel est de découpler la génération audio du rendu vidéo pour qu'ils s'exécutent en parallèle et éviter que l'audio ne ralentisse tout le pipeline.
Contrôle de la concurrence
L'erreur la plus fréquente en mode batch est d'envoyer des centaines de tâches d'un coup. Une approche plus robuste : maintenir une file de tâches bornée, soumettre à vitesse constante selon une limite de concurrence, et placer les tâches échouées dans une file de retry dédiée avec un nombre de tentatives limité. Chaque tâche porte un ID métier et une clé d'idempotence pour éviter les générations en double.
Réutilisation du cache
Les effets sonores sont des actifs hautement réutilisables. Il est conseillé de construire la clé de cache à partir de « sémantique de l'effet + durée + paramètres » et de renvoyer directement l'URL du résultat existant en cas de hit. Une même série de modèles vidéo partage souvent le même jeu d'effets sonores ; le taux de cache peut alors être très élevé, ce qui en fait le levier d'économie le plus efficace sous facturation à la seconde.
Points de livraison
Côté résultats, unifiez le format et les conventions de nommage, et conservez les métadonnées de génération pour faciliter les remplacements et la traçabilité. En mode batch, on ne recherche pas la créativité extrême d'un clip isolé, mais la stabilité, la reproductibilité et le remplacement en masse — traitez le modèle audio comme une usine à effets sonores, pas comme un outil de création.
Scénario 2 : effets sonores dynamiques pour jeux et produits interactifs
Les jeux et produits interactifs ont un besoin d'effets sonores piloté par les événements : ramassage d'objet, lancement de compétence, retour d'interface, ambiance, chaque événement correspond à un son. Le piège le plus courant dans ce type de scénario est d'assimiler directement « piloté par les événements » à « appel du modèle en temps réel ».
La couche de correspondance événement → audio
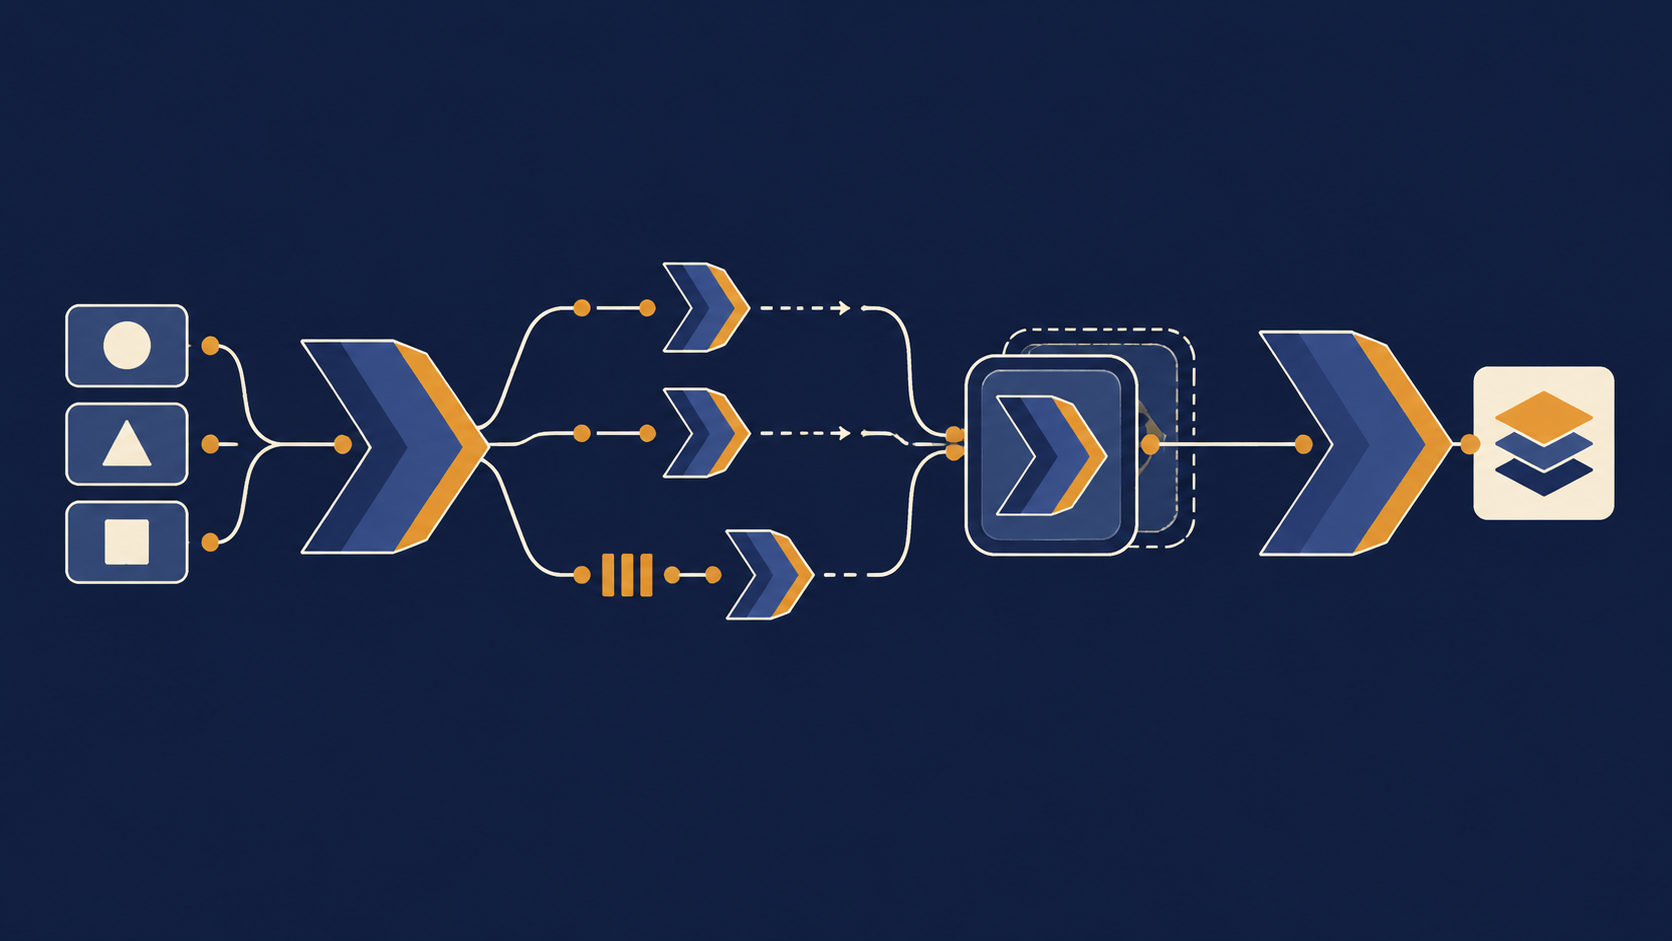
La bonne approche consiste à ajouter une couche de correspondance entre l'événement et le modèle : l'événement de jeu ne transporte qu'un tag sémantique (par exemple « collision métallique - court »), et la couche de correspondance consulte une table pour obtenir l'actif audio. Ce n'est qu'en cas d'absence qu'on passe par la génération du modèle, puis on réinjecte le résultat dans la table d'actifs. Ainsi, l'immense majorité des interactions charge des ressources locales ou depuis un CDN, plutôt que d'émettre des requêtes de génération réseau.
Pourquoi on ne peut pas appeler à chaque interaction
La génération audio est fondamentalement asynchrone, avec une latence bien supérieure au budget d'une frame de jeu ; or le joueur attend un effet sonore en quelques millisecondes. La couche de cache n'est donc pas une optimisation, mais une condition de correction. Pré-générer les effets courants, les empaqueter par scène et les précharger pendant les phases de chargement sont des pratiques standard pour ce type de produit.
La frontière de valeur de la génération à la demande
La génération à la demande garde de la valeur, mais dans deux cas limités : les événements de longue traîne (compétences combinées, objets rares), dont la fréquence est trop faible pour justifier une pré-génération ; et les variantes dynamiques (hauteur, durée ajustées selon l'état), qui demandent une certaine différenciation. Pour ces deux cas, fixez un budget de génération et un temps de refroidissement afin d'éviter que les actions répétées des joueurs ne fassent exploser le nombre de secondes.
Contraintes d'ingénierie
Ajoutez priorités et dégradation aux tâches de génération : les événements à haute priorité peuvent attendre de façon bloquante, les événements à basse priorité se dégradent silencieusement en silence ou en son de remplacement après timeout. Tous les résultats de génération doivent être enregistrés dans la table d'actifs avec un numéro de version pour faciliter les rollbacks.
Scénario 3 : matériaux audio pour contenus parlés et podcasts
L'audio long est indispensable aux contenus parlés, podcasts et cours audio, et c'est aussi le scénario où le coût doit être calculé au plus juste sous facturation à la seconde. Le principe central : ne pas chercher à générer tout un audio long d'un seul coup.
Génération par segments
Découpez l'audio long en segments selon la sémantique ou le temps (par chapitre, par paragraphe, ou selon une durée maximale fixe), et soumettez une tâche de génération indépendante par segment. Le découpage offre trois avantages : la durée par tâche est maîtrisée, un retry n'affecte qu'un seul segment, et le parallélisme est ajustable. Alignez autant que possible les frontières des segments sur les ruptures sémantiques pour réduire la sensation de raccord.
Assemblage et cohérence
Après la génération par segments vient l'assemblage. Il ne s'agit pas d'une simple concaténation binaire : il faut aussi harmoniser le taux d'échantillonnage, les canaux et la sonie, et gérer les silences entre segments. Il est conseillé de faire un contrôle qualité avant et après l'assemblage : vérifier l'intégrité de chaque segment, la conformité de la durée et l'absence de saturation ou de coupure aux jonctions.
Processus de validation qualité
Le coût de reprise sur les contenus longs étant élevé, la validation doit être placée en amont. Processus envisageable : générer d'abord quelques segments d'essai pour confirmer le style et les paramètres à l'écoute, puis lancer la génération en masse ; pendant la phase de masse, effectuer des contrôles automatisés (écart de durée, détection de silence, intégrité des fichiers) et ne faire qu'un contrôle manuel par échantillonnage.
Maîtrise des coûts
Le total de secondes d'un audio long est élevé, et tout gaspillage est amplifié. Trois leviers : fixer une durée maximale par segment pour éviter qu'un segment anormal ne s'allonge ; reprendre à partir du point d'interruption sans régénérer les segments déjà terminés ; et mettre en cache à la fois le résultat final et les segments pour ne régénérer que les segments modifiés lors des révisions. C'est à ce prix que les scénarios de contenu long restent soutenables.
Scénario 4 : compléments sonores pour supports pédagogiques et de présentation
La question que posent le plus souvent les petites équipes est : ce modèle nous sert-il vraiment ? Dans les scénarios à faible fréquence comme la formation, les supports de cours ou les présentations, la réponse ne doit pas venir d'une discussion, mais d'une validation par prototype à faible coût.
Les trois étapes de la validation par prototype
Première étape, identifier un petit besoin réel : par exemple les sons de changement de page, de notification, de bonne ou mauvaise réponse dans un cours. Deuxième étape, générer seulement quelques extraits — chacun très court — couvrant tous les types d'effets sonores. Troisième étape, faire essayer aux utilisateurs réels et recueillir leur jugement : est-ce suffisant, le style correspond-il, est-ce meilleur que la bibliothèque d'actifs existante ?
Pourquoi ce scénario se prête bien à un premier essai
Faible fréquence et durée courte impliquent un total de secondes réduit, donc un coût d'essai maîtrisé ; en outre, ces supports n'exigent pas une « perfection » élevée et valorisent davantage la cohérence et l'utilisabilité, ce qui est justement la zone de confort des modèles audio. Valider avec des extraits permet de répondre rapidement à la question de décision « faut-il poursuivre l'investissement ? ».
Recommandations d'ingénierie pour un essai à petite échelle
Même pour un essai, il est conseillé de suivre le chemin d'intégration officiel : soumettre les tâches via une interface unifiée, récupérer les résultats en asynchrone, stocker les extraits dans un répertoire d'actifs et enregistrer les paramètres. Ainsi, le code d'essai peut évoluer directement en code de production et éviter le « une démo d'un côté, une réécriture à la mise en production de l'autre ».
Critères de décision
Définissez à l'avance les conditions de montée en charge, par exemple : le taux d'utilisabilité des extraits atteint l'objectif, le temps de remplacement manuel d'un matériau baisse sensiblement, le total de secondes reste dans le budget. Si les conditions sont remplies, étendez à l'ensemble des cours ; sinon, arrêtez-vous au stade des extraits — c'est bien plus rationnel que de tout générer d'un coup puis de réduire le budget après coup.
Scénario 5 : expérimentation rapide de matériaux marketing et opérationnels
Les matériaux marketing se caractérisent par de nombreuses versions, une durée de vie courte et un besoin d'itération rapide. La valeur du modèle audio ici n'est pas de « produire le meilleur son », mais de « produire suffisamment de candidats à un coût acceptable ».
Génération de variantes en parallèle
Découpez une itération de matériau en plusieurs variantes : prompts de styles différents, versions de durées différentes, tonalités émotionnelles différentes. Soumettez les tâches en parallèle pour obtenir un ensemble de pistes candidates, puis passez à l'évaluation. Limitez le nombre de variantes, sinon le nombre de secondes croît linéairement avec lui.
Évaluation et sélection
Une fois les candidats générés, il faut les filtrer rapidement. Approche possible : effectuer d'abord des contrôles automatisables (durée, format, passages silencieux), puis faire écouter et noter par un petit groupe d'utilisateurs ou par l'équipe marketing, et ne conserver que les quelques meilleures versions pour la diffusion officielle. Séparez « génération » et « diffusion » pour éviter la mise en ligne de matériaux non filtrés.
Équilibre entre vitesse d'itération et coût
La logique de maîtrise des coûts en expérimentation diffère des précédentes : il ne s'agit pas de réduire la durée d'un clip, mais de réduire les variantes inutiles. Il est conseillé d'enregistrer, pour chaque cycle d'expérimentation, le total de secondes générées et le taux d'adoption final, et de mesurer le rapport intrants/extrants par ce taux d'adoption. Si le taux reste faible plusieurs cycles de suite, la stratégie de prompt ou la définition du besoin pose problème : corrigez la stratégie avant de continuer à générer.
Capitalisation des actifs
Les nombreux candidats produits par les expérimentations ne doivent pas être jetés. Archivez dans la bibliothèque d'actifs, avec des tags, les pistes non retenues mais de qualité suffisante ; les campagnes suivantes pourront les réutiliser directement et éviter des générations redondantes. Ce mécanisme de capitalisation est la clé des économies à long terme dans les scénarios marketing.
Du prototype à la production : checklist d'intégration et pièges courants
En dégageant les points communs des cinq scénarios précédents, les capacités d'ingénierie à compléter avant la mise en production se répartissent globalement en quatre couches.
Couche de traitement des requêtes
Confirmez l'adoption du mode de tâches asynchrones : soumettre la tâche et récupérer un ID, obtenir le résultat par polling ou callback, définir un timeout raisonnable. Toutes les requêtes portent une clé d'idempotence pour éviter les soumissions en double. Fixez une durée audio maximale par tâche : au-delà, refusez directement au lieu de laisser le modèle terminer puis tronquer.
Couche de cache et d'actifs
Mettez en place un cache dont la clé est « sémantique + durée + paramètres », réutilisé directement en cas de hit. Stockez les résultats dans le stockage objet en conservant les paramètres de génération et les numéros de version, avec prise en charge du remplacement et du rollback. La couche de cache est la première écluse d'économie dans les scénarios audio.
Couche de supervision et de coûts
Surveillez trois indicateurs : le taux de réussite des tâches, la durée moyenne de génération et le cumul mensuel de secondes générées. Alertez sur le quota de secondes, et pas seulement sur le nombre d'appels. Comptez séparément les retries : une hausse anormale indique généralement une instabilité en amont ou des paramètres erronés.
Couche de dégradation et de tolérance aux pannes
Définissez un plan de dégradation pour chaque point d'appel : renvoyer un son de remplacement ou du silence en cas de timeout, sauter directement les scénarios non critiques, n'attendre de façon bloquante que pour les scénarios à haute priorité. Limitez le nombre de retries et définissez une stratégie de backoff pour éviter l'amplification des coûts par les échecs.
Pièges courants
Premièrement, utiliser la génération audio comme une interface synchrone, ce qui provoque des timeouts ; deuxièmement, régénérer le même effet sonore sans cache ; troisièmement, négliger le découpage des audios longs, avec une durée par tâche qui dérape ; quatrièmement, ne compter que les appels sans compter les secondes, et ne découvrir le dépassement budgétaire qu'après coup ; cinquièmement, des retries sans idempotence, qui facturent plusieurs fois le même audio. En cochant chaque point de la liste, on évite l'essentiel des incidents de mise en production. La difficulté d'ingénierie d'un modèle audio ne réside pas dans l'appel lui-même, mais dans l'ensemble des contraintes construites autour du « nombre de secondes ».
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat