
Tutorial
mirelo-sfx-2.0 en la práctica: 5 escenarios de alto valor para modelos de audio y puntos clave de integración
De la facturación por segundos a la implementación real: desglose de escenarios y claves de implementación desde la perspectiva del desarrollador
Por qué un modelo de audio merece una evaluación de selección propia
En el stack tecnológico, el paradigma de integración de los modelos de texto y de imagen ya está relativamente madurado: se introduce un prompt, se obtienen tokens o píxeles, y la dimensión de facturación es clara. Los modelos de salida de audio, en cambio, suelen quedar englobados en «multimodal» sin más, hasta que el equipo realmente necesita hacer efectos de sonido, doblaje o audio dinámico y descubre que sus restricciones de integración son completamente distintas.
La diferencia más central está en la unidad de medida del producto. El texto se factura por tokens, la imagen por número de imágenes o resolución, mientras que la unidad natural de medida del audio es la duración (segundos). Esto significa que una llamada no produce «un resultado», sino «una línea temporal que puede ser más larga o más corta»; el coste crece de forma lineal con la duración del audio, no con el número de llamadas. Esto cambia directamente la forma de estimar: no basta con contar QPS, hay que contar «el total de segundos generados».
La segunda diferencia es que el tiempo de generación está relacionado con la duración. Un audio de varias decenas de segundos a menudo no puede devolverse dentro de la ventana de timeout de una petición síncrona convencional, por lo que los modelos de audio son, por naturaleza, más adecuados para el modo de tarea asíncrona: enviar la tarea, consultar por polling o recibir callback, y obtener la URL del producto. Esto se pasa por alto fácilmente en la fase de prototipo y solo se manifiesta como tormenta de timeouts y reintentos tras el lanzamiento.
La tercera diferencia es que el producto requiere almacenamiento y reutilización. Los archivos de audio son mucho más grandes que el texto y, además, un mismo efecto de sonido suele reutilizarse repetidamente en el negocio. Sin caché ni gestión de activos, la generación repetida amplifica directamente el coste de la facturación por segundos.
Por eso un modelo de audio merece una evaluación de selección propia: no es una tarea accesoria de «añadir una modalidad», sino una línea de producción independiente de generación asíncrona + gestión de activos. Tomando mirelo-sfx-2.0 como ejemplo, el tipo de salida es audio y la base de facturación son los segundos de salida, lo que determina la forma de ingeniería de todos los escenarios posteriores. El criterio para decidir si incluirlo en el stack tecnológico también es muy práctico: si en tu negocio existe algún eslabón que «necesite un fragmento de sonido reproducible» y si la duración y la frecuencia de llamadas de ese sonido pueden medirse y acotarse.
Primero, aclarar el coste: qué implica la facturación por segundos
La esencia de la facturación por segundos es cambiar la función de coste de «número de llamadas × precio unitario» a «segundos de salida × precio por segundo». La conversión parece simple, pero cambia notablemente la forma del modelo presupuestario.
Fórmula de coste
Coste por llamada ≈ segundos de audio de salida × precio por segundo. Coste mensual ≈ total de segundos generados en el mes × precio por segundo. La palabra clave es salida: lo que determina la factura es cuánto audio recibes finalmente, no cuántas peticiones lanzaste. Un efecto de sonido de 30 segundos y treinta efectos de 1 segundo son equivalentes en la dimensión de segundos, pero completamente distintos en sobrecarga de llamadas, tasa de aciertos de caché y complejidad de ingeniería.
Tres puntos propensos a descontrolarse
Primero, la amplificación por reintentos. Los reintentos de tareas asíncronas fallidas, los clics repetidos del usuario y los disparos accidentales del polling del frontend hacen que un mismo audio se genere varias veces. Si cada fallo se reejecuta por completo, la factura se duplica según el número de reintentos.
Segundo, la expansión lineal del audio largo. Si la duración del audio se duplica, el coste se duplica, sin rendimientos decrecientes. En escenarios de contenido largo como pódcasts y audiolibros, hay que calcular primero la duración total antes de decidir si se genera todo.
Tercero, la cola larga de llamadas experimentales. Los experimentos A/B y las pruebas de materiales suelen generar una gran cantidad de fragmentos cortos; una sola llamada parece barata, pero tras multiplicar el número de versiones por el número de fragmentos, el total es considerable.
Enfoque de estimación
Se recomienda establecer un modelo de coste sencillo antes de la integración: calcular el total mensual de segundos con «duración media por audio × número estimado de audios generados al día × 30» y multiplicarlo por el precio unitario. Además, imponer dos restricciones: fijar un límite máximo de duración por tarea y establecer una alerta de cuota mensual de segundos. Así la discusión de presupuesto pasa de «me parece caro o no» a «¿podemos reducir el total de segundos?». Las formas de reducir costes también son claras: reutilizar caché, acortar la duración por defecto y llamar al modelo solo para los fragmentos necesarios. Para el precio unitario concreto, consulta el panel de precios del sitio; lo que el equipo de ingeniería debe vigilar es la variable de los segundos.
Escenario 1: generación masiva de efectos de sonido para vídeos cortos y publicidad
La línea de producción de contenido es el escenario donde el ROI del modelo de audio se ve más fácilmente: vídeos cortos con plantilla, anuncios en el feed, vídeos de producto principal de e-commerce; la necesidad de efectos de sonido es «gran volumen, homogénea, por lotes».
Forma de implementación
Incorporar la generación de audio a la línea de renderizado existente: una vez definida la plantilla de material, extraer las necesidades de efectos de sonido por plano o escena (transiciones, clics, fondo ambiental), enviar las tareas de generación por lotes, escribir los productos en el almacenamiento de objetos y registrarlos en la biblioteca de materiales, y finalmente que el servicio de renderizado los referencie por ID. La clave es desacoplar la generación de audio del renderizado de vídeo: ambos en paralelo, para evitar que el audio ralentice toda la línea de producción.
Control de concurrencia
El error más común en escenarios por lotes es lanzar cientos de tareas de golpe. Una práctica más estable es: mantener una cola de tareas acotada, enviar a ritmo constante según el límite de concurrencia, y que las tareas fallidas pasen a una cola de reintentos independiente con un número máximo de reintentos. Cada tarea lleva un ID de negocio y una clave de idempotencia para evitar generaciones duplicadas.
Reutilización mediante caché
Los efectos de sonido son activos altamente reutilizables. Se recomienda generar la clave de caché con «semántica del efecto + duración + parámetros» y, si hay acierto, devolver directamente la URL del producto existente. Los mismos lotes de plantillas de vídeo suelen compartir el mismo conjunto de efectos de sonido, por lo que la tasa de aciertos de caché puede ser muy alta; esta es la forma más eficaz de ahorrar con facturación por segundos.
Puntos clave de entrega
En el lado del producto hay que unificar formatos y convenciones de nombres, y conservar los metadatos de los parámetros de generación para facilitar su sustitución y trazabilidad posteriores. En escenarios por lotes no se busca la creatividad extrema de cada pieza, sino estabilidad, reproducibilidad y sustitución por lotes: tratar el modelo de audio como una fábrica de efectos de sonido, no como una herramienta creativa.
Escenario 2: efectos de sonido dinámicos para juegos y productos interactivos
La necesidad de efectos de sonido en juegos y productos interactivos está dirigida por eventos: recoger un objeto, liberar una habilidad, retroalimentación de interfaz, ambiente; cada evento corresponde a un fragmento de sonido. El punto donde más fácilmente se comete un error de juicio en este tipo de escenarios es equiparar directamente «dirigido por eventos» con «llamar al modelo en tiempo real».
Capa de mapeo de evento a audio
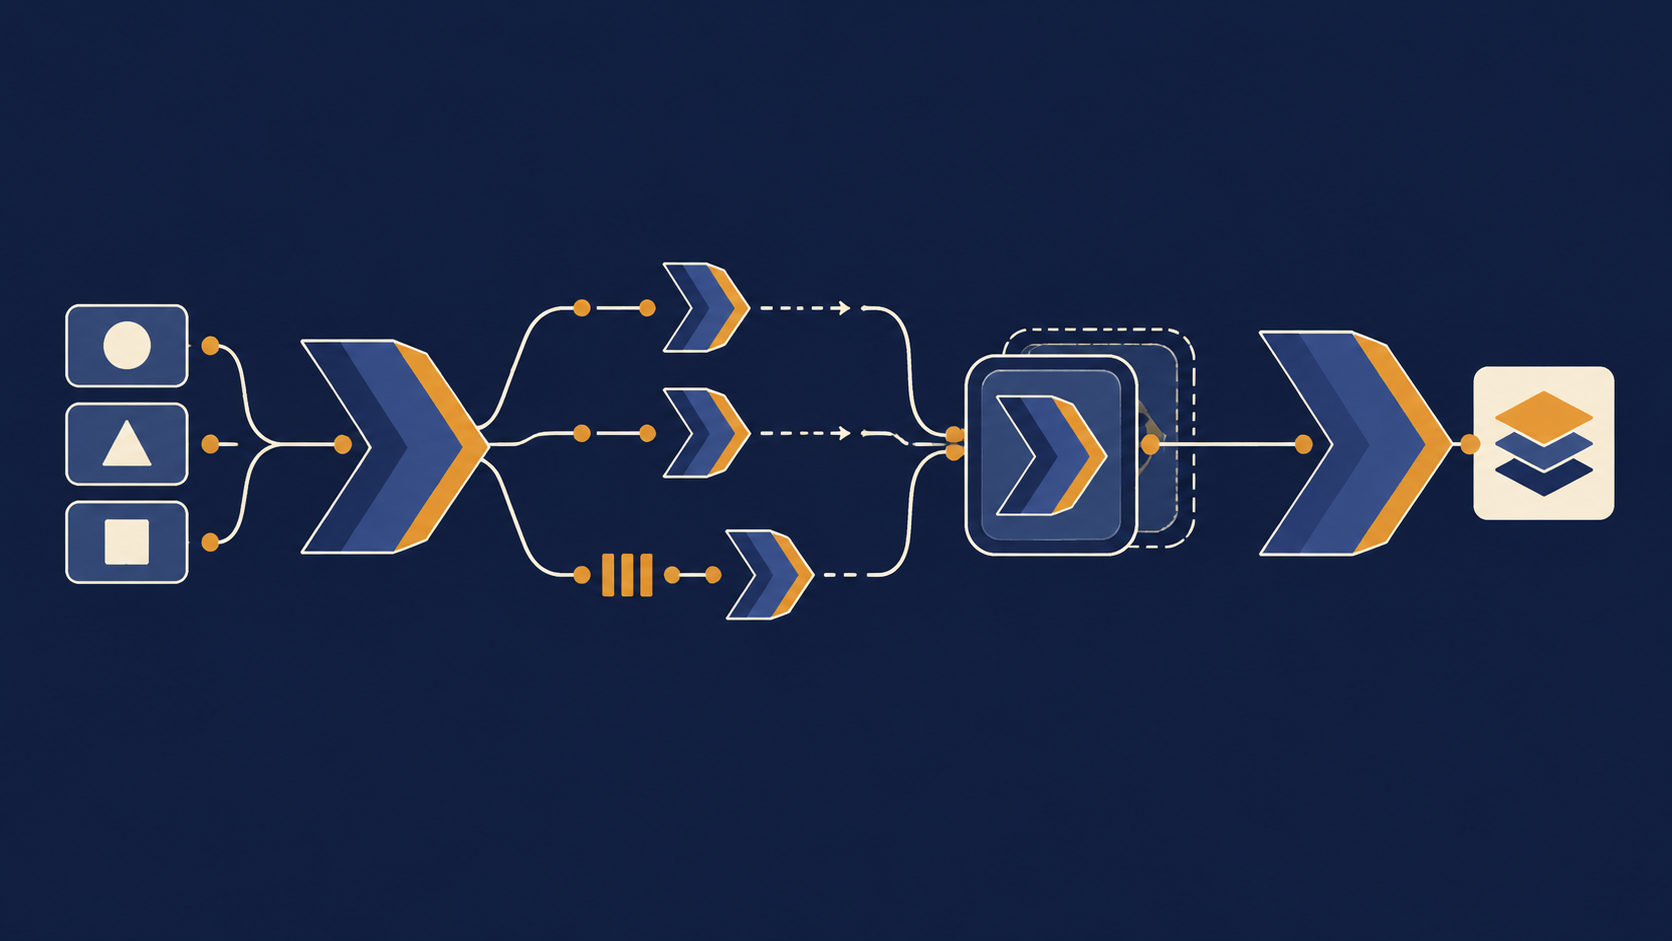
La forma correcta es añadir una capa de mapeo entre el evento y el modelo: el evento del juego solo lleva una etiqueta semántica (por ejemplo, «choque metálico-breve»), y la capa de mapeo se encarga de consultar la tabla para obtener el activo de audio. Solo cuando no se encuentra se recurre a la generación por el modelo, y el resultado se rellena en la tabla de activos. Así la gran mayoría de las interacciones consisten en cargar recursos locales o de CDN, no en peticiones de generación por red.
Por qué no se puede llamar en cada interacción
La generación de audio es asíncrona por naturaleza y su latencia supera con creces el presupuesto de frames de un juego; además, la expectativa del jugador respecto al efecto de sonido es una respuesta en milisegundos. Por lo tanto, la capa de caché no es una optimización, sino una condición de corrección. Pregenerar los efectos de sonido habituales, empaquetarlos por escena y precalentarlos en la fase de carga es la práctica estándar en este tipo de productos.
El límite de valor de la generación bajo demanda
La generación bajo demanda sigue teniendo valor, pero se concentra en dos tipos: primero, eventos de cola larga (habilidades combinadas, objetos raros), con baja frecuencia de activación y que no merecen pregenerarse; segundo, variantes dinámicas (tono y duración ajustados ligeramente según el estado), que requieren cierta diferenciación. Para estos dos tipos hay que fijar un presupuesto de generación y un tiempo de enfriamiento, para evitar que las operaciones de alta frecuencia del jugador disparen los segundos.
Restricciones de ingeniería
Añadir prioridad y degradación a las tareas de generación: los eventos de alta prioridad pueden bloquear en espera, mientras que los de baja prioridad se degradan silenciosamente a silencio o sonido de relleno tras el timeout. Todos los resultados de generación deben registrarse en la tabla de activos con número de versión para facilitar el rollback.
Escenario 3: material de audio para contenido hablado y pódcasts
El audio largo es una necesidad básica del contenido hablado, los pódcasts y el audio de cursos, y también el escenario donde el coste bajo facturación por segundos requiere mayor precisión. El principio central es: no intentes generar todo el audio largo de una sola vez.
Generación por segmentos
Dividir el audio largo en varios segmentos según la semántica o el tiempo (por ejemplo, por capítulos, por párrafos, por un límite fijo de segundos), y enviar cada segmento como una tarea de generación independiente. La segmentación aporta tres ventajas: la duración de cada tarea es controlable, el reintento por fallo solo afecta a un segmento y el paralelismo es ajustable. Los límites de segmento deben alinearse lo más posible con los puntos de corte semánticos para reducir la sensación de brusquedad en las uniones.
Unión y consistencia
Tras la generación por segmentos hay que unir. La unión no es solo una fusión binaria; también hay que tratar la consistencia de frecuencia de muestreo, canales y sonoridad, así como el relleno de silencio entre segmentos. Se recomienda hacer un control de calidad antes y después de la unión: comprobar que cada segmento esté completo, que la duración cumpla lo esperado y que no haya chasquidos ni cortes en las uniones.
Flujo de verificación de calidad
El coste de rehacer contenido largo es alto, por lo que la verificación debe adelantarse. Un flujo viable: generar primero unos pocos segmentos de muestra para escuchar y confirmar el estilo y los parámetros, y después generar por lotes; en la fase por lotes, hacer comprobaciones automáticas (desviación de duración, detección de silencio, integridad del archivo), y que la revisión manual sea solo por muestreo.
Control de costes
El total de segundos de audio largo es grande, y cualquier desperdicio se amplifica. Tres medidas: primero, fijar una duración máxima por segmento para evitar que algún segmento se alargue de forma anómala; segundo, reanudación desde punto de interrupción, para no regenerar los segmentos ya completados; tercero, incluir en caché tanto el producto final como los productos por segmento, de modo que las revisiones posteriores solo regeneren los segmentos modificados. Así el escenario de contenido largo es sostenible.
Escenario 4: complemento de efectos de sonido para materiales educativos y de presentación
La pregunta más frecuente en equipos pequeños es: ¿este modelo nos sirve realmente? En escenarios de baja frecuencia como educación, formación y materiales de presentación, la respuesta no debe obtenerse mediante discusión, sino mediante una validación de prototipo de bajo coste.
Los tres pasos de la validación de prototipo
Primer paso: delimitar una necesidad real y pequeña, por ejemplo, los sonidos de cambio de página, avisos y retroalimentación de acierto/error en un conjunto de materiales de curso. Segundo paso: generar solo unas pocas muestras, cada una con una duración muy corta, cubriendo todos los tipos de efecto. Tercer paso: que los usuarios reales las prueben y den su valoración: si son suficientes, si el estilo encaja y si son mejores que la biblioteca de materiales existente.
Por qué este escenario es adecuado para probar primero
La baja frecuencia y la corta duración implican que el total de segundos es pequeño y el coste de prueba y error es controlable; además, este tipo de materiales no exige un alto grado de «perfección», sino que valora más la consistencia y la usabilidad, que es precisamente el punto fuerte del modelo de audio. Validar con muestras permite responder rápidamente a la pregunta de decisión «¿merece la pena seguir invirtiendo?».
Recomendaciones de ingeniería para pruebas a pequeña escala
Incluso para una prueba, se recomienda seguir la vía formal de integración: enviar tareas a través de la interfaz unificada, obtener los productos de forma asíncrona, guardar las muestras en el directorio de materiales y registrar los parámetros. Así el código de prueba puede evolucionar directamente a código de producción, evitando «un demo por un lado y una reescritura para el lanzamiento por otro».
Criterios de decisión
Definir de antemano las condiciones para escalar, por ejemplo: que la tasa de usabilidad de las muestras alcance lo esperado, que el tiempo de sustitución manual por material disminuya notablemente y que el total de segundos esté dentro del presupuesto. Si se cumplen, ampliar a todos los materiales del curso; si no, quedarse en la fase de muestras. Esto es mucho más racional que generar todo de una vez y luego recortar el presupuesto.
Escenario 5: experimentación rápida con materiales de marketing y operaciones
Los materiales de marketing se caracterizan por tener muchas versiones, un ciclo de vida corto y la necesidad de probar rápido. El valor del modelo de audio aquí no es «producir el mejor sonido», sino «producir suficientes candidatos con un coste aceptable».
Generación de variantes en paralelo
Dividir una iteración de material en varias variantes: prompts de distintos estilos, versiones de distinta duración, distintos tonos emocionales. Enviar las tareas de generación en paralelo, obtener un conjunto de pistas candidatas y pasar a la fase de evaluación. Cuidado: el número de variantes debe tener un límite, de lo contrario los segundos crecen de forma lineal con el número de variantes.
Evaluación y filtrado
Una vez generados los candidatos, hay que filtrarlos rápido. Una práctica viable: hacer primero comprobaciones que la máquina pueda juzgar (duración, formato, tramos de silencio), y después que un grupo reducido de usuarios o compañeros de operaciones las escuchen y puntúen; conservar solo las pocas versiones con mejor rendimiento para la publicación oficial. Separar «generación» y «publicación» evita que materiales sin filtrar se publiquen directamente.
Equilibrio entre velocidad de iteración y coste
La idea de control de costes en escenarios experimentales es distinta de las anteriores: no se trata de comprimir la duración de cada pieza, sino de comprimir las variantes inválidas. Se recomienda registrar el total de segundos generados y la tasa de adopción final de cada ronda de experimentos, y medir el retorno con la «tasa de adopción». Si durante varias rondas consecutivas la tasa de adopción es muy baja, significa que hay un problema en la estrategia de prompts o en la definición de la necesidad; primero hay que cambiar la estrategia y luego seguir generando.
Acumulación de activos
La gran cantidad de candidatos que produce la experimentación no debe descartarse directamente. Archivar en la biblioteca de materiales, con etiquetas, las pistas no adoptadas pero con calidad suficiente permite reutilizarlas directamente en campañas posteriores y reducir generaciones repetidas. Este mecanismo de acumulación es la clave para ahorrar a largo plazo en escenarios de marketing.
Del prototipo al lanzamiento: lista de verificación de integración y errores comunes
Extrayendo los puntos comunes de los cinco escenarios anteriores, las capacidades de ingeniería que hay que completar antes del lanzamiento se dividen aproximadamente en cuatro capas.
Capa de procesamiento de peticiones
Confirmar el uso del modo de tarea asíncrona: enviar la tarea y obtener el ID, obtener el resultado mediante polling o callback, y establecer timeouts razonables. Todas las peticiones llevan clave de idempotencia para evitar envíos duplicados. Limitar la duración máxima de audio por tarea y rechazar directamente lo que la supere, en lugar de dejar que el modelo termine y luego truncar.
Capa de caché y activos
Establecer una caché cuya clave sea «semántica + duración + parámetros», reutilizando directamente en caso de acierto. Guardar los productos en el almacenamiento de objetos, conservar los parámetros de generación y el número de versión, y permitir sustitución y rollback. La capa de caché es la primera compuerta de ahorro en escenarios de audio.
Capa de monitorización y costes
Monitorizar tres indicadores: tasa de éxito de tareas, duración media de generación y total acumulado de segundos generados en el mes. Alertar con la cuota de segundos, no solo con el número de llamadas. Contar por separado el número de reintentos: un aumento anómalo suele indicar inestabilidad aguas arriba o parámetros incorrectos.
Capa de degradación y tolerancia a fallos
Definir un plan de degradación para cada punto de llamada: devolver sonido de relleno o silencio al hacer timeout, omitir directamente en escenarios no críticos, y bloquear en espera solo en escenarios de alta prioridad. Limitar el número de reintentos y la estrategia de backoff para evitar que los fallos amplifiquen el coste.
Errores comunes
Primero, usar la generación de audio como interfaz síncrona, lo que provoca timeouts; segundo, regenerar el mismo efecto de sonido sin caché; tercero, ignorar la segmentación del audio largo, con una duración de tarea descontrolada; cuarto, contar solo el volumen de llamadas y no los segundos, y descubrir el exceso de presupuesto a posteriori; quinto, reintentar sin idempotencia, con el mismo audio facturado varias veces. Revisando cada punto, se pueden evitar la mayoría de los incidentes de lanzamiento. La dificultad de ingeniería de los modelos de audio no está en la llamada en sí, sino en todo el conjunto de restricciones construido alrededor de los «segundos».
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado