
チュートリアル
mirelo-sfx-2.0 実践:音声モデルの5つの高価値ユースケースと導入の要点
秒単位課金からビジネス実装まで:開発者視点によるユースケース分解と実装の要点
音声モデルをあえて単独で選定する価値がある理由
技術スタックにおいて、テキストモデルと画像モデルの導入パラダイムはすでに比較的成熟しています。プロンプトを入力し、トークンやピクセルを出力する。課金の軸は明確です。一方、音声出力型のモデルは「マルチモーダル」として一括りに扱われがちで、実際に効果音やナレーション、動的音声を作ろうとして初めて、チームはその導入制約がまったく異なることに気づきます。
最も本質的な違いは生成物の計量単位にあります。テキストはトークン単位、画像は枚数や解像度単位で課金されますが、音声の自然な計量単位は長さ(秒)です。つまり1回の呼び出しで生まれるのは「ひとつの結果」ではなく「長くも短くもなりうるタイムライン」であり、コストは呼び出し回数ではなく音声の長さに比例して線形に増加します。これは見積もり方針を根本から変えます。QPSだけを数えるのでは不十分で、「生成した総秒数」を数えなければなりません。
第二の違いは生成所要時間が長さに依存することです。数十秒の音声は、通常の同期リクエストのタイムアウト枠内に返せないことがよくあります。そのため音声モデルは本質的に非同期タスク方式に適しています。タスクを投入し、ポーリングまたはコールバックで結果を受け取り、生成物のURLを取得します。この点はプロトタイプ段階では見落とされがちで、本番公開後にタイムアウトとリトライの嵐として表面化します。
第三の違いは生成物に保存と再利用が必要なことです。音声ファイルはテキストよりはるかに大きく、しかも同じ効果音が業務で繰り返し使われることがよくあります。キャッシュとアセット管理がなければ、重複生成が秒単位課金のコストを直接増幅させます。
したがって音声モデルは、一度単独で選定する価値があります。それは「モダリティを一つ追加する」という気軽な作業ではなく、独立した非同期生成+アセット管理のパイプラインです。mirelo-sfx-2.0 を例にすると、出力タイプは音声、課金基準は出力秒数であり、これが後述するすべてのユースケースのエンジニアリング形態を決定づけます。技術スタックに含めるかどうかの判断基準もきわめて現実的です。あなたの業務に「再生可能な音声が必要」な工程が存在し、かつその音声の長さと呼び出し頻度が統計・制約可能であるかどうかです。
まずコストを明確に:秒単位課金の意味とは
秒単位課金の本質は、コスト関数を「呼び出し回数 × 単価」から「出力秒数 × 毎秒単価」に置き換えることです。この変換は単純に見えますが、予算モデルの形を大きく変えます。
コスト計算式
1回あたりのコスト ≈ 出力音声の秒数 × 毎秒単価。月間コスト ≈ 当月の生成総秒数 × 毎秒単価。注目すべきキーワードは出力です。請求額を決めるのは、最終的にどれだけ長い音声を得たかであり、何回リクエストを発行したかではありません。30秒の効果音1本と1秒の効果音30本は、秒数の次元では等価ですが、呼び出しオーバーヘッド、キャッシュヒット率、エンジニアリングの複雑さではまったく異なります。
制御不能になりやすい3つのポイント
第一に、リトライによる増幅。 非同期タスクの失敗リトライ、ユーザーの重複クリック、フロントエンドのポーリング誤発火は、いずれも同じ音声を複数回生成させます。失敗のたびに最初からやり直すと、請求額はリトライ回数分だけ倍増します。
第二に、長い音声の線形膨張。 音声の長さが倍になればコストも倍になり、限界費用の逓減はありません。ポッドキャストやオーディオブックのような長尺コンテンツのユースケースでは、全体の総時間を先に算出してから全量生成するかどうかを決める必要があります。
第三に、実験的呼び出しのロングテール。 A/Bテストや素材の試行錯誤では大量の短い断片を生成しがちです。1回あたりは安く見えても、バージョン数×断片数で総量は無視できません。
見積もりの考え方
導入前に簡単なコストモデルを構築することを勧めます。「1本あたりの平均音声長 × 想定日次生成本数 × 30」で月間総秒数を推算し、単価を掛けます。同時に2つの制約を設けます。一つは単一タスクの最大長の上限設定、もう一つは月間秒数クォータのアラート設定です。これにより予算の議論は「高いか安いかという感覚」から「総秒数を抑えられるか」へと変わります。コスト削減の手段も明確です。キャッシュの再利用、デフォルト長の短縮、必要な断片にのみモデルを呼び出すこと。具体的な単価はサイトの価格パネルを参照してください。エンジニアリング側が注視すべきは秒数という変数です。
ユースケース1:ショート動画と広告のバッチ効果音生成
コンテンツ制作パイプラインは、音声モデルが最もROIを見出しやすい実装ユースケースです。テンプレート化されたショート動画、フィード広告、ECのメイン画像動画は、「大量・同質・バッチ処理可能」な効果音を必要とします。
実装形態
音声生成を既存のレンダリングパイプラインに組み込みます。素材テンプレートが確定したら、カットやシーンごとに効果音の要件(トランジション、クリック、雰囲気の下敷き)を洗い出し、生成タスクをバッチ投入し、生成物をオブジェクトストレージに書き込んで素材ライブラリに記録し、最後にレンダリングサービスがIDで参照します。鍵となるのは音声生成と動画レンダリングの分離です。両者を並行させ、音声がパイプライン全体を遅らせないようにします。
並行制御
バッチ処理で最も犯しやすいミスは、数百のタスクを一気に投げることです。より安定した方法は、有界のタスクキューを維持し、並行上限に従って均等に投入し、失敗タスクは独立したリトライキューに入れてリトライ回数を制限することです。各タスクには業務IDと冪等キーを付け、重複生成を防ぎます。
キャッシュ再利用
効果音は再利用性の高いアセットです。「効果音のセマンティクス+長さ+パラメータ」でキャッシュキーを生成し、ヒットすれば既存の生成物URLを直接返すことを勧めます。同じ動画テンプレート群は同じ効果音セットを共有することが多く、キャッシュヒット率は非常に高くできます。これが秒単位課金下で最も効果的なコスト削減手段です。
納品の要点
生成物側ではフォーマットと命名規則を統一し、生成パラメータのメタデータを保持して、後からの差し替えや追跡を容易にします。バッチ処理では1本ごとの極端な創造性を追求せず、安定・再現可能・バッチ差し替え可能を追求します。音声モデルを創作ツールではなく、効果音素材の工場として扱うのです。
ユースケース2:ゲームとインタラクティブ製品の動的効果音
ゲームやインタラクティブ製品の効果音はイベント駆動です。アイテム取得、スキル発動、UIフィードバック、環境の雰囲気。各イベントに1つの音声が対応します。この種のユースケースで最も誤解しやすいのは、「イベント駆動」をそのまま「リアルタイムにモデルを呼び出す」と同一視することです。
イベントから音声へのマッピング層
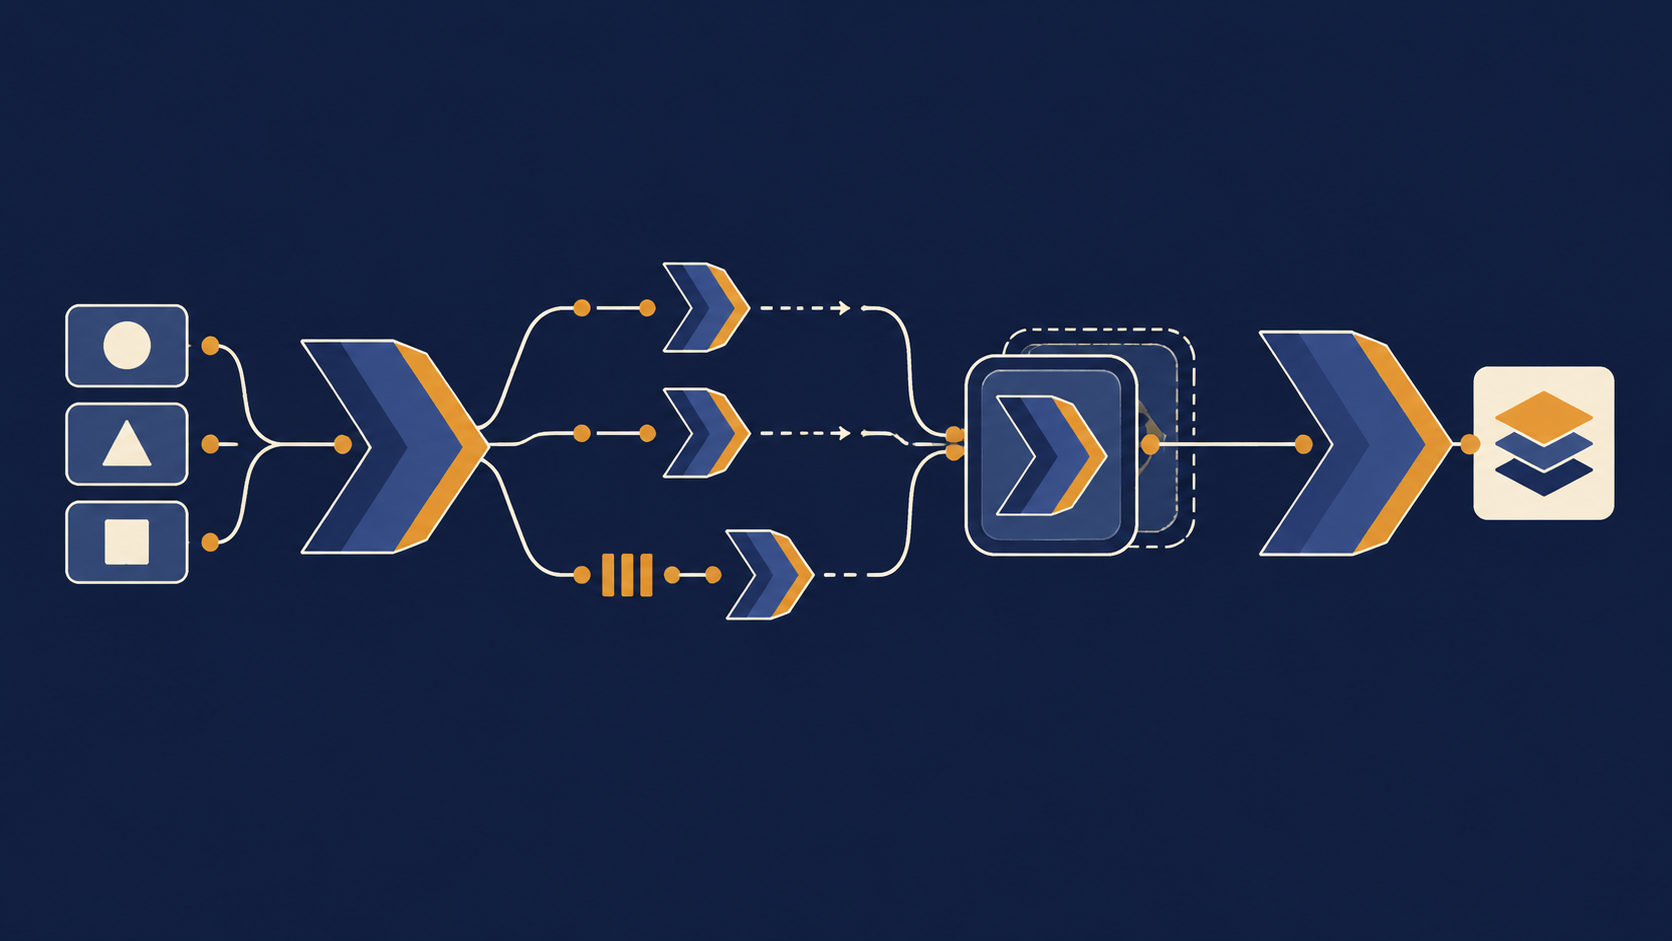
正しい形態は、イベントとモデルの間にマッピング層を設けることです。ゲームイベントはセマンティックタグ(例:「金属衝突-短促」)のみを運び、マッピング層がテーブルを引いて音声アセットを取得します。見つからない場合のみモデル生成を行い、結果をアセットテーブルに書き戻します。これにより、大多数のインタラクションはネットワーク生成リクエストではなく、ローカルまたはCDNからのリソース読み込みになります。
インタラクションごとに呼び出せない理由
音声生成は本質的に非同期で、レイテンシはゲームのフレーム予算を大きく超えます。一方、プレイヤーが効果音に期待するのはミリ秒単位の応答です。したがってキャッシュ層は最適化項目ではなく、正しさの前提です。よく使う効果音の事前生成、シーンごとのパッケージ化、ロード段階でのウォームアップが、この種の製品の標準的な手法です。
オンデマンド生成の価値の境界
オンデマンド生成にも価値はありますが、集中するのは2種類です。一つはロングテールなイベント(複合スキル、レアイテム)で、発動頻度が低く事前生成に値しません。もう一つは動的バリアント(ピッチや長さを状態に応じて微調整)で、一定の差別化が必要です。これら2種類には生成予算とクールダウンを設け、プレイヤーの高頻度操作で秒数が急増するのを防ぎます。
エンジニアリング制約
生成タスクに優先度とフォールバックを設けます。高優先度イベントはブロッキングで待機でき、低優先度イベントはタイムアウト後にサイレントまたはプレースホルダー音へ静かにフォールバックします。すべての生成結果はバージョン番号付きでアセットテーブルに記録し、ロールバックを容易にします。
ユースケース3:オーディオコンテンツとポッドキャストの音声素材
長尺音声はオーディオコンテンツ、ポッドキャスト、講座音声の必須要件であり、秒単位課金下で最もコストを精算すべきユースケースでもあります。核心原則は長い音声を一度に生成しようとしないことです。
分割生成
長い音声をセマンティクスまたは時間で複数のセグメントに分割します(章ごと、段落ごと、固定秒数上限ごとなど)。各セグメントは独立して生成タスクを投入します。分割の利点は3つあります。単一タスクの長さを制御でき、失敗リトライが1セグメントだけに影響し、並行度を調整できます。セグメント境界はできるだけセマンティックな区切りに合わせ、結合箇所の不自然さを減らします。
結合と一貫性
分割生成後は結合が必要です。結合はバイナリのマージだけではなく、サンプルレート、チャンネル、ラウドネスの一貫性、セグメント間の無音パディングも処理します。結合の前後でそれぞれ品質チェックを行うことを勧めます。各セグメントが完全か、長さが想定どおりか、結合箇所にノイズや断裂がないかを確認します。
品質検証フロー
長尺コンテンツは手戻りコストが高いため、検証は前倒しで行う必要があります。実行可能なフローは、まず少量のサンプルセグメントを生成して試聴し、スタイルとパラメータを確認してからバッチ生成する。バッチ段階では自動チェック(長さの偏差、無音検出、ファイルの完全性)を行い、人手は抜き取り検査のみとします。
コスト管理
長い音声は総秒数が大きく、あらゆる無駄が増幅されます。3つの手段があります。一つはセグメントごとの最大長を設定し、特定セグメントが異常に長くなるのを防ぐ。二つは中断からの再開で、完了済みセグメントを再生成しない。三つは最終生成物とセグメント生成物の両方をキャッシュに含め、後の修正では変更セグメントのみ再生成する。これにより長尺コンテンツのユースケースが持続可能になります。
ユースケース4:教育・プレゼン資料の効果音補完
小規模チームが最もよく尋ねるのは「このモデルは我々にとって本当に役立つのか」という вопросです。教育、研修、プレゼン資料のような低頻度のユースケースでは、答えは議論で導くのではなく、低コストのプロトタイプ検証で導くべきです。
プロトタイプ検証の3ステップ
第一步は、実際の小さなニーズを一つ特定すること。例えば、ある講座のスライド資料のページめくり音、通知音、正解/不正解のフィードバック音。第二步は、少量のサンプルのみを生成すること。各サンプルはごく短い長さに抑え、すべての効果音タイプをカバーする。第三步は、実際の利用者に試用してもらい判断をもらう。十分か、スタイルは合うか、既存の素材ライブラリより良いか。
このユースケースがまず試すのに適している理由
低頻度・短時間は総秒数が小さく、試行錯誤のコストを制御できます。同時にこの種の素材は「完璧さ」への要求が高くなく、一貫性と可用性をより重視します。まさに音声モデルの得意分野です。小さなサンプルで検証すれば、「今後も投資する価値があるか」という意思決定の問いに素早く答えられます。
小規模試用のエンジニアリング推奨
試用であっても、正式な導入経路を通ることを勧めます。統一インターフェースでタスクを投入し、非同期で生成物を取得し、サンプルを素材ディレクトリに保存してパラメータを記録します。これにより試用コードがそのまま本番コードへ進化でき、「デモ用と本番用を書き直す」事態を避けられます。
判断基準
事前に拡大条件を決めておきます。例えば、サンプルの可用率が想定に達する、1素材あたりの人手による差し替え時間が明らかに減少する、総秒数が予算内に収まる、など。条件を満たせば全量の講座資料へ拡大し、満たさなければサンプル段階で止めます。一度全量生成してから予算を削るより、はるかに理性的です。
ユースケース5:マーケティング・運用素材の迅速な実験
マーケティング素材の特徴は、バージョンが多く、ライフサイクルが短く、迅速な試行錯誤が必要なことです。ここでの音声モデルの価値は「最高の音を作る」ことではなく、「許容できるコストで十分な数の候補を作る」ことです。
並行バリアント生成
1回の素材イテレーションを複数のバリアントに分解します。異なるスタイルのプロンプト、異なる長さのバージョン、異なる感情の基調。生成タスクを並行投入し、候補音声のセットを得てから評価段階に入ります。バリアント数には上限を設けてください。そうでなければ秒数はバリアント数に比例して線形に膨張します。
評価と選別
候補生成後は迅速な選別が必要です。実行可能な方法は、まず機械判定可能なチェック(長さ、フォーマット、無音区間)を行い、次に小範囲のユーザーや運用担当者に試聴・採点してもらい、成績の良い少数バージョンのみを正式配信に進めます。「生成」と「配信」を分離し、未選別の素材が直接公開されるのを防ぎます。
イテレーション速度とコストのバランス
実験ユースケースのコスト管理の考え方は前述と異なります。1本あたりの長さを圧縮するのではなく、無効なバリアントを圧縮するのです。各実験ラウンドの生成総秒数と最終採用率を記録し、「採用率」で投資対効果を測ることを勧めます。数ラウンド連続で採用率が低ければ、プロンプト戦略か要件定義に問題がある証拠であり、生成を続ける前に戦略を改めるべきです。
アセットの蓄積
実験で生じた大量の候補はそのまま捨てるべきではありません。採用されなかったが品質が合格の音声をタグ付きで素材ライブラリにアーカイブすれば、後続のキャンペーンで直接再利用でき、重複生成を減らせます。この蓄積メカニズムがマーケティングユースケースで長期的にコストを抑える鍵です。
プロトタイプから本番へ:導入チェックリストとよくある落とし穴
前述の5つのユースケースの共通点を抽出すると、本番前に補完すべきエンジニアリング能力は大きく4層に分かれます。
リクエスト処理層
非同期タスク方式の採用を確認します。タスクを投入してIDを取得し、ポーリングまたはコールバックで結果を取得し、適切なタイムアウトを設定します。すべてのリクエストに冪等キーを付け、重複投入を防ぎます。単一タスクの最大音声長を制限し、超過時はモデルを走らせてから切り詰めるのではなく即座に拒否します。
キャッシュとアセット層
「セマンティクス+長さ+パラメータ」をキーとするキャッシュを構築し、ヒット時は直接再利用します。生成物はオブジェクトストレージに保存し、生成パラメータとバージョン番号を保持して差し替えとロールバックをサポートします。キャッシュ層は音声ユースケースでコストを抑える第一の関門です。
監視とコスト層
3つの指標を監視します。タスク成功率、平均生成時間、当月累計生成秒数。呼び出し回数だけを見るのではなく、秒数クォータでアラートを出します。リトライ回数は別途カウントし、異常な上昇は通常、上流の不安定さかパラメータの誤りを意味します。
フォールバックと耐障害層
各呼び出し箇所にフォールバック方案を定義します。タイムアウト時はプレースホルダー音や無音を返す、非クリティカルなシーンは直接スキップする、高優先度シーンのみブロッキングで待機する。リトライ回数とバックオフ戦略を制限し、失敗によるコスト増幅を防ぎます。
よくある落とし穴
一つは音声生成を同期インターフェースとして使うことによるタイムアウト。二つはキャッシュなしで同じ効果音を繰り返し生成すること。三つは長い音声の分割を無視し、単一タスクの長さが制御不能になること。四つは呼び出し量だけを数え秒数を数えず、予算超過に事後で気づくこと。五つはリトライに冪等性がなく、同じ音声が複数回課金されること。項目ごとに照合チェックすれば、本番事故の大部分は回避できます。音声モデルのエンジニアリングの難所は呼び出しそのものではなく、「秒数」を中心に構築される一連の制約にあります。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする