
Guide d'utilisation
Guide complet des prompts OmniHuman 1.5 : 5 scénarios à copier-coller pour générer directement
Présentation à l'écran en format paysage, présentateur animal, mouvement du corps entier, présentation en anglais, masque multi-personnes, avec de vraies vidéos générées.
Chaque exemple ci-dessous est une vraie vidéo générée avec OmniHuman 1.5 ; ce qui est dit et pendant combien de temps est entièrement déterminé par l'audio de pilotage.
1. Présentation à l'écran en format paysage : explication produit
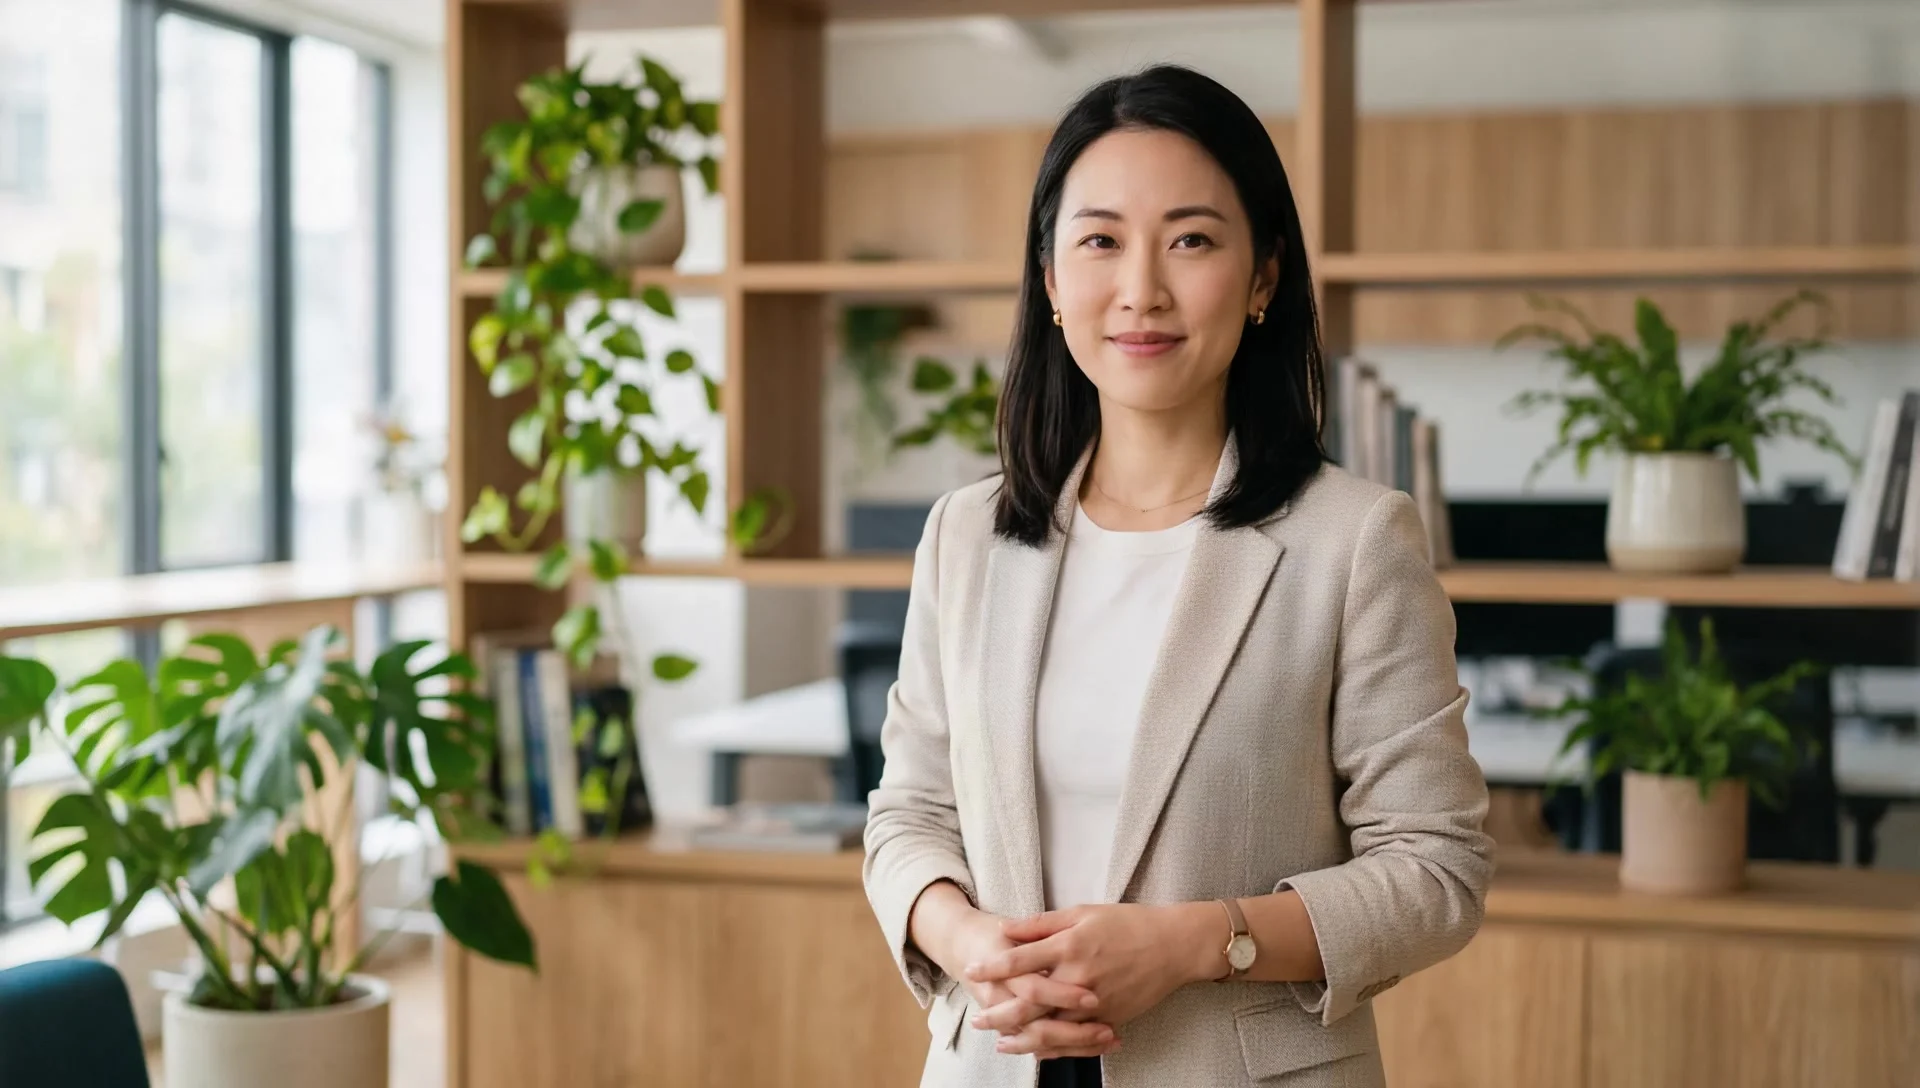
Paramètres : photo en buste 16:9 paysage · 1080p · 8 secondes · $1.544 · Voir le MP4 →
Notez que les deux mains s'ouvrent sur les points fonctionnels, et que le hochement de tête tombe entre les phrases, et non sur chaque mot.
Parlez en souriant naturellement, ouvrez légèrement les deux mains en geste lorsque vous évoquez les fonctionnalités, hochez la tête de temps en temps
Trois phrases décrivent trois niveaux : l'expression, un geste lié à la réplique, et un petit mouvement « occasionnel ». Inutile de décrire la partie vocale, l'audio s'en charge déjà.
2. Présentateur animal : image d'actualités 1:1
Paramètres : image de chat présentateur 1:1 · 720p · 8 secondes · $1.544 · Voir le MP4 → Ressources : portrait de chat
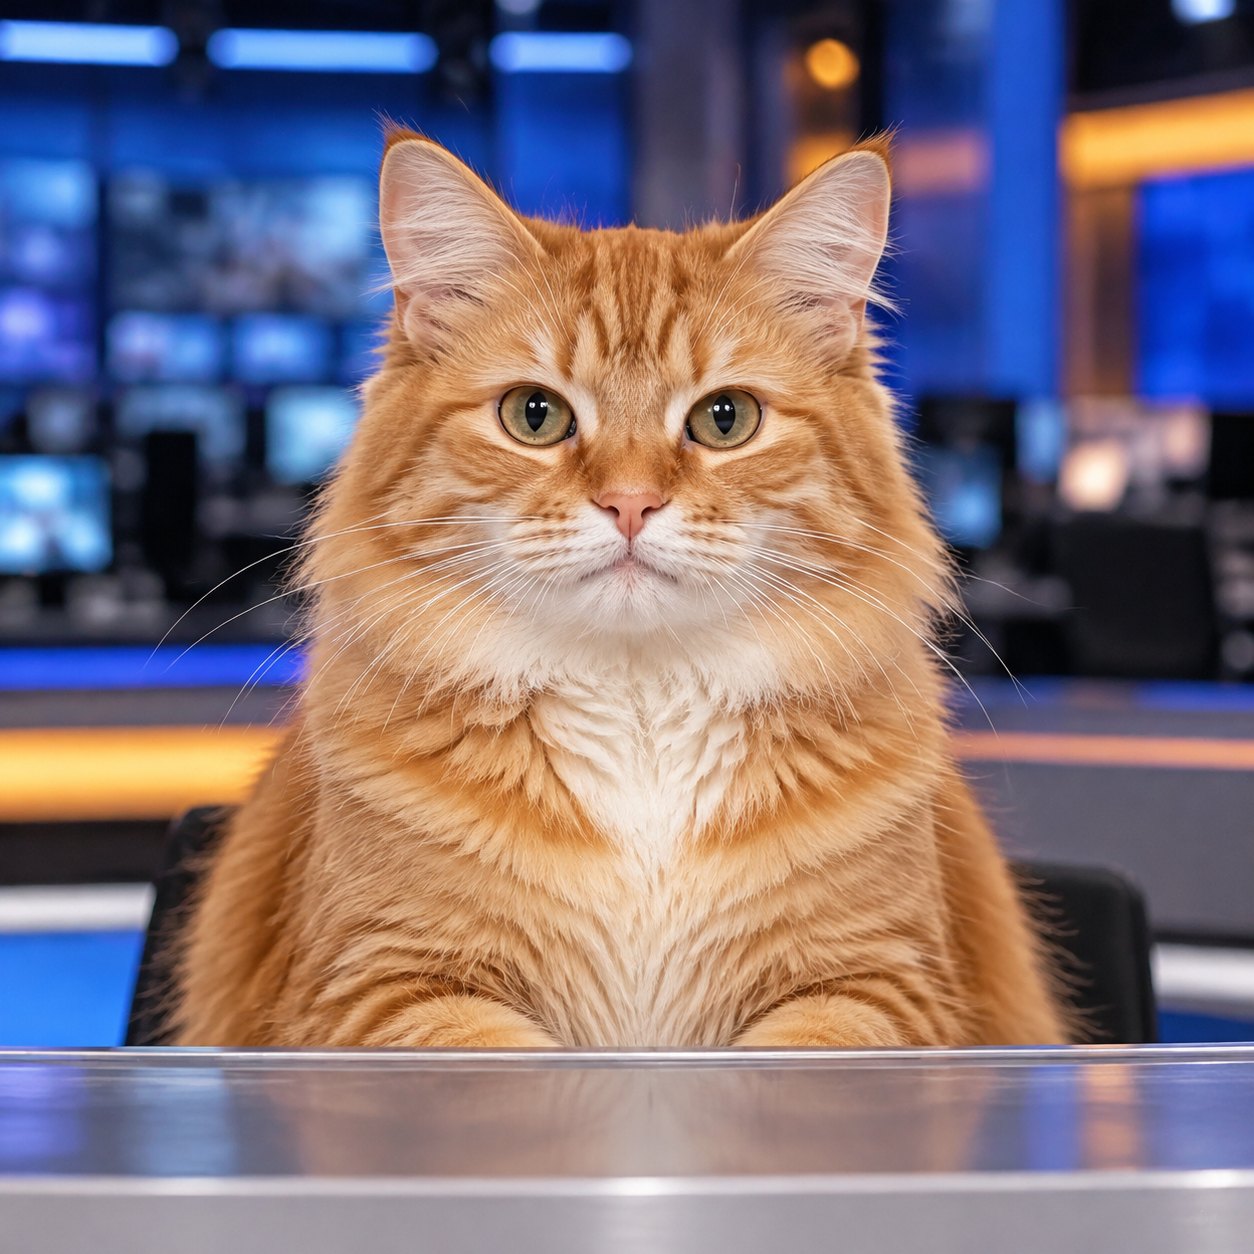
Le chat regarde la caméra du début à la fin, et tous les mouvements se concentrent sur le visage : oreilles qui bougent légèrement et clignements des yeux ; il n'a pas de mains pour gesticuler.
Présentez naturellement les actualités face à la caméra, les oreilles bougent légèrement en parlant, clignez des yeux de temps en temps
La structure de phrase reprend celle d'un présentateur humain, en remplaçant simplement les gestes par des mouvements qu'un chat peut faire. « Face à la caméra » verrouille le regard, « naturellement » évite un rythme de présentation figé.
3. Mouvement du corps entier : explication 9:16
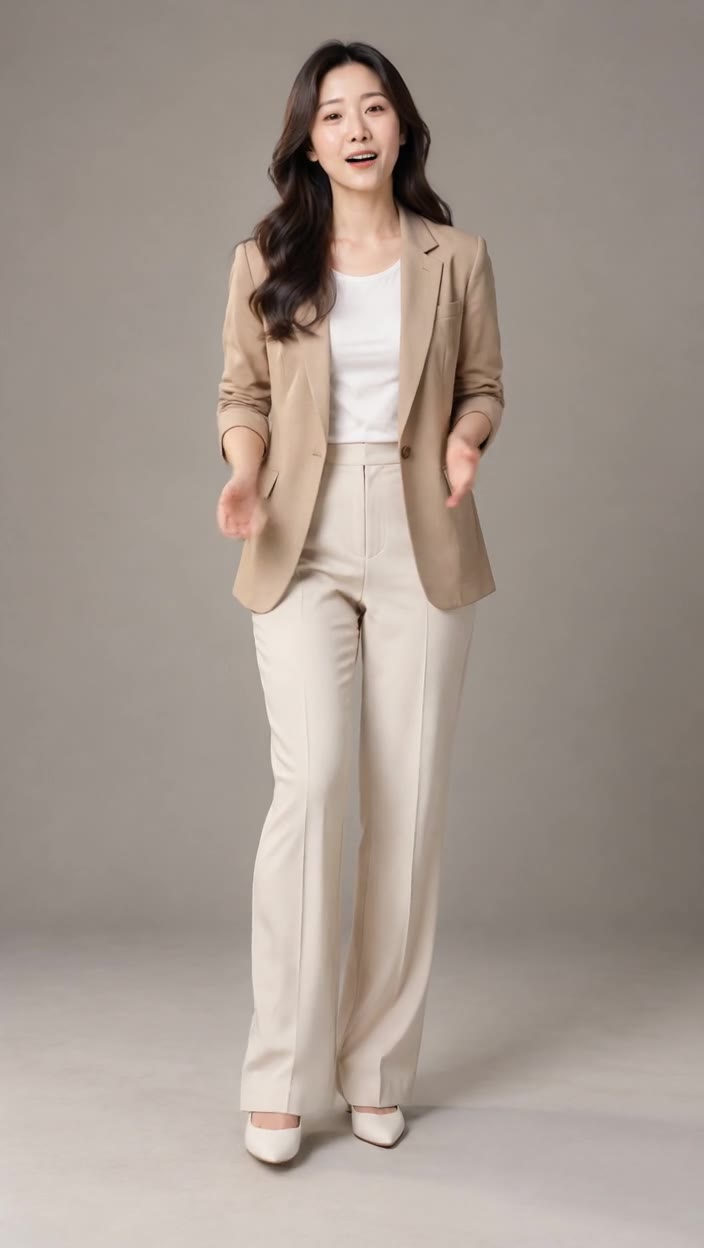
Paramètres : photo en pied 9:16 · 720p · 8 secondes · $1.544 · Voir le MP4 →
Dans une image en pied, les mains ont de l'espace pour bouger ; avec les mêmes trois phrases, la vidéo ressemble davantage à une explication qu'à un avatar qui ne remue que la bouche.
Parlez en souriant naturellement, ouvrez légèrement les deux mains en geste au fil de l'explication, hochez la tête de temps en temps
« Au fil de l'explication » rattache les gestes au rythme de l'explication, sans boucle fixe ; « hochez la tête de temps en temps » ajoute un mouvement secondaire de la tête légèrement décalé, pour que le haut du corps ne se fige pas.
4. Présentation en anglais : même portrait, autre langue
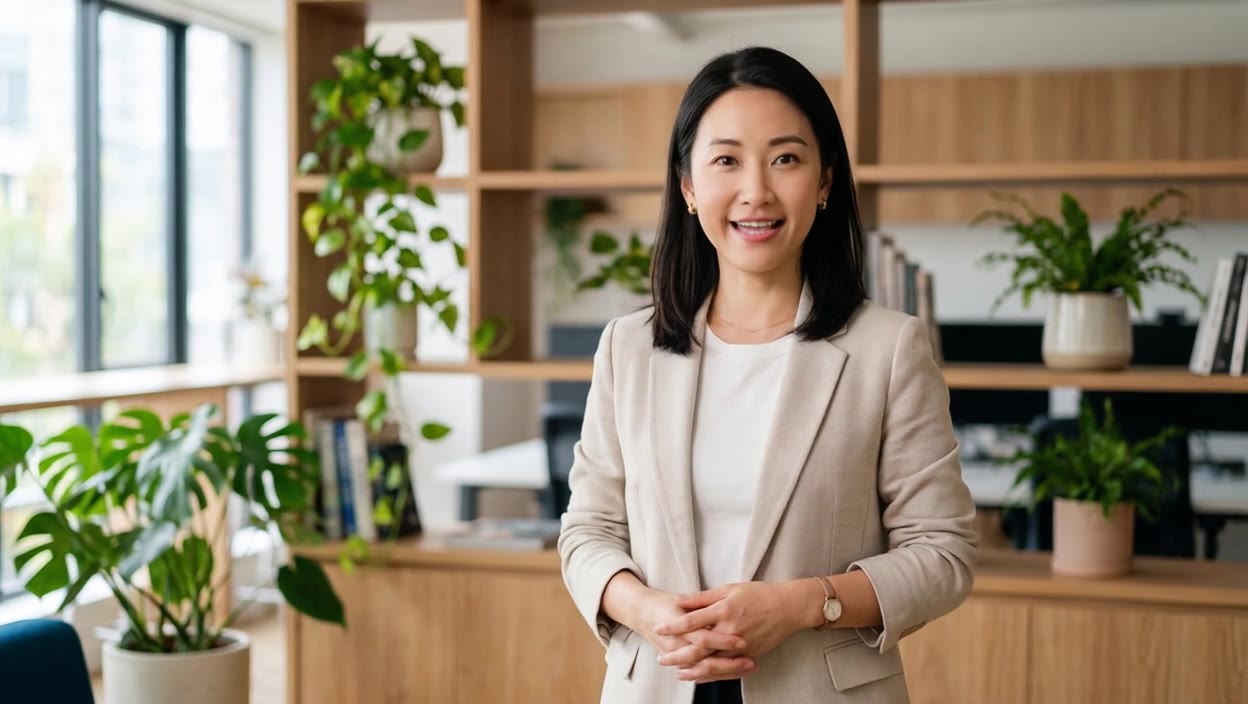
Paramètres : portrait 16:9 paysage (le même que l'exemple 1) · 720p · audio de 7,5 secondes, facturé sur 8 secondes · $1.544 · Voir le MP4 →
Le débit anglais est plus rapide que le chinois, mais les trois actions tombent toujours au bon endroit : léger sourire, ouverture des mains sur les points clés, hochement de tête occasionnel.
Speak naturally to camera with a slight smile, open your hands when making a point, and nod occasionally.
Le prompt ne mentionne pas la langue, seulement les actions. Avec le même portrait, en passant d'un enregistrement chinois à un enregistrement anglais, ces trois consignes fonctionnent tout autant.
5. Masque multi-personnes : désigner une personne qui parle dans une scène à trois
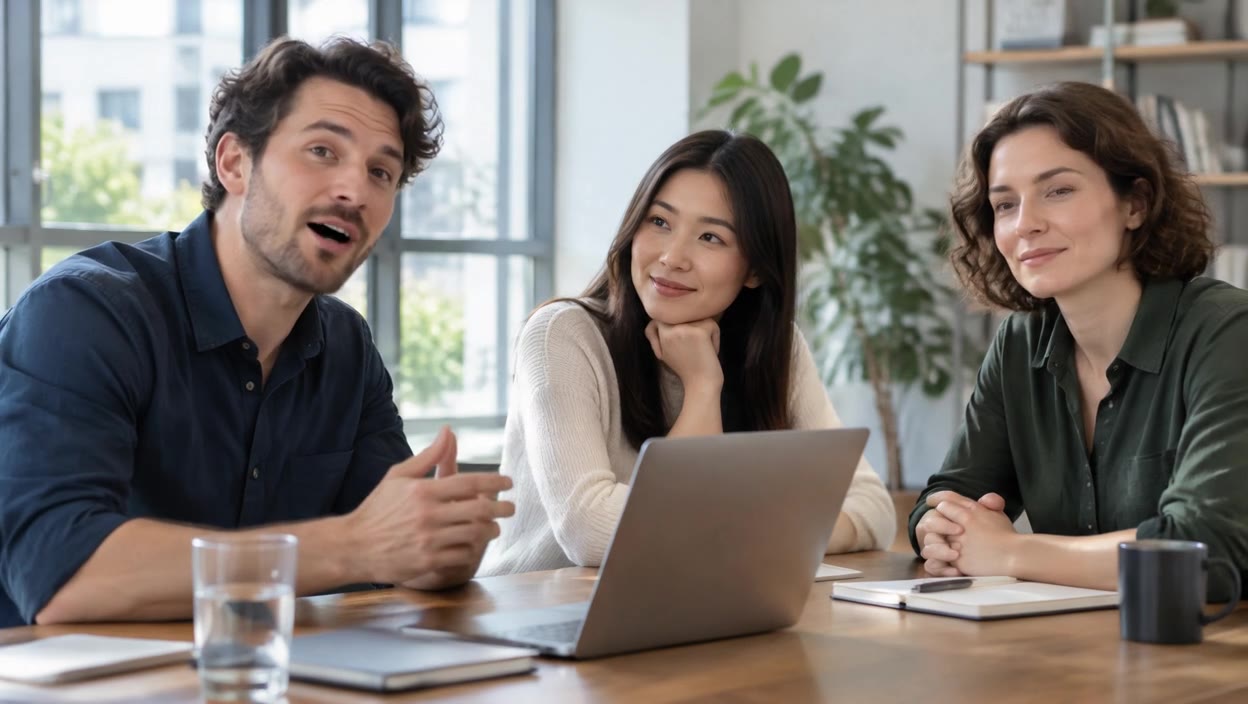
Paramètres : image de réunion à trois 16:9 · masque de même taille (l'homme de gauche en blanc) · 720p · 8 secondes · $1.544 · Voir le MP4 → Ressources : portrait de réunion · masque
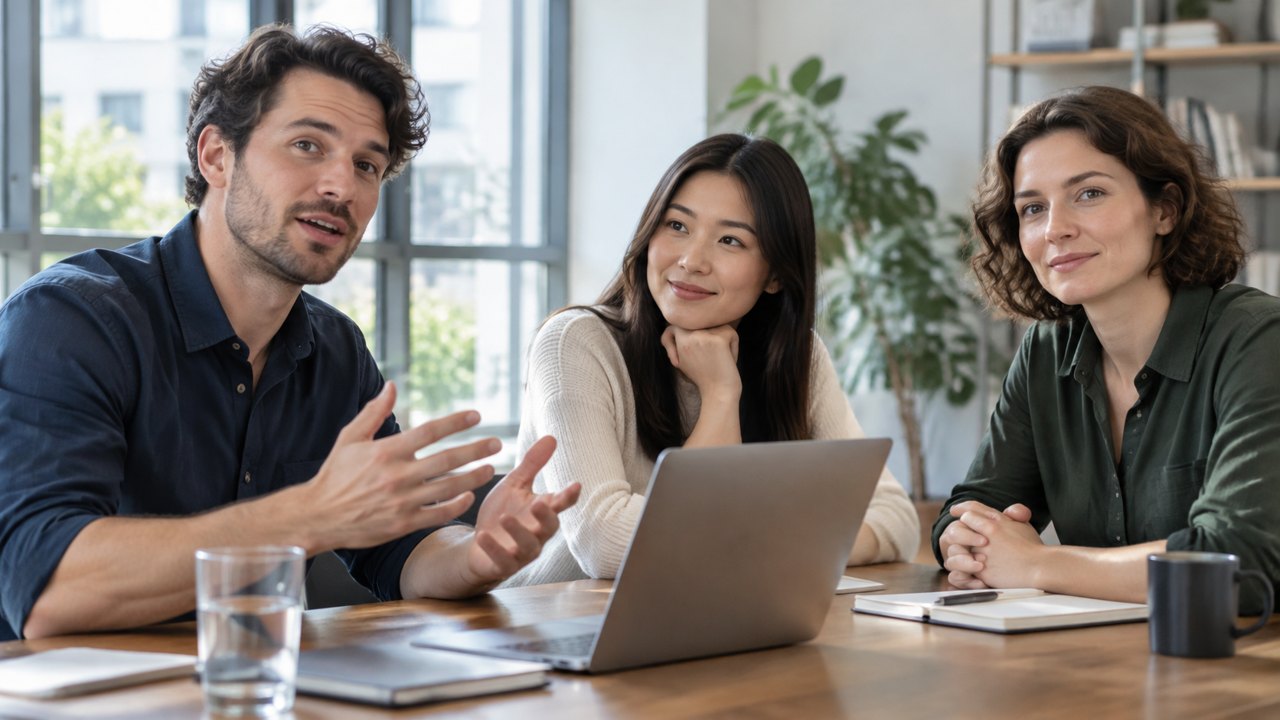
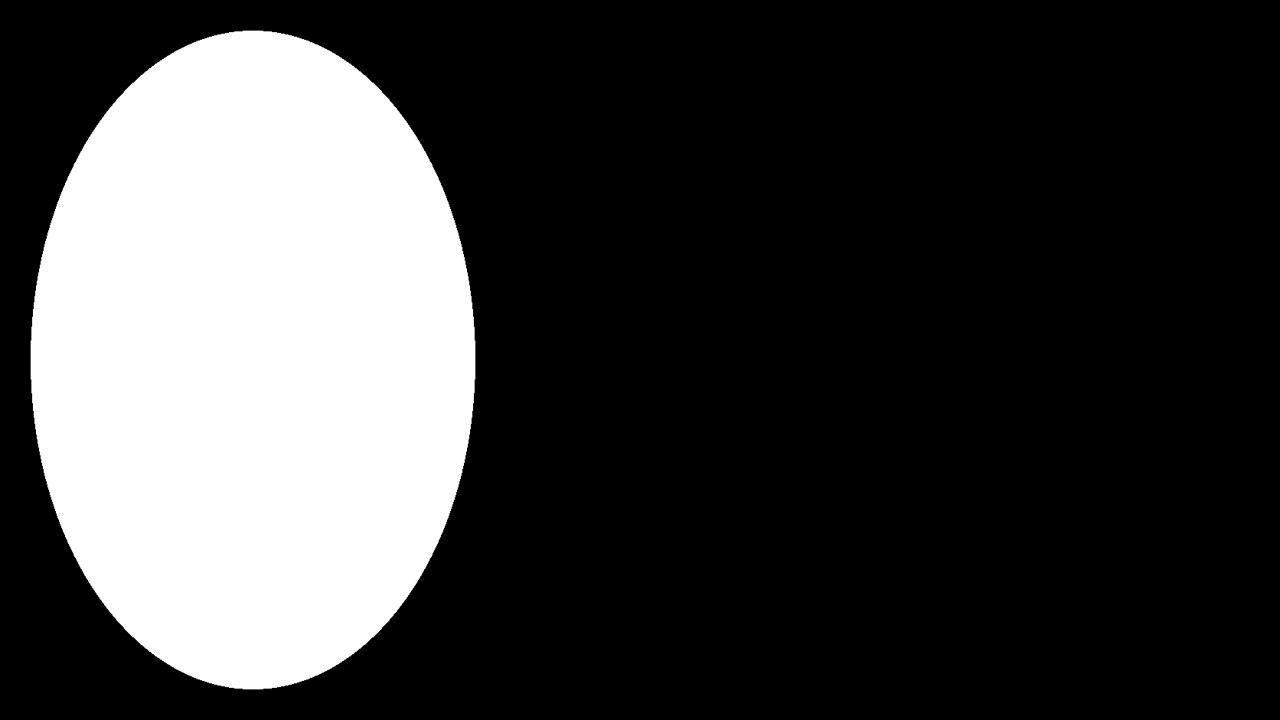
Le masque détermine qui peut prendre la parole ; le prompt se charge d'indiquer quelles réactions doivent apparaître sur le visage des deux autres personnes.
Seul l'homme de gauche parle, les deux personnes au centre et à droite gardent le sourire et écoutent, leur corps bouge légèrement et naturellement
La première moitié reprend le masque en texte : seul l'homme de gauche parle ; la seconde moitié attribue des tâches aux personnes du centre et de droite — sourire, écoute, léger mouvement naturel du corps. L'image ne se retrouve pas avec une seule personne qui bouge, et personne ne coupe la parole.
Comment écrire ses propres prompts
- Écrivez selon l'ordre « expression → gestes → caméra », une phrase par élément suffit.
- Restez sous 300 caractères ; le chinois, l'anglais, le japonais, le coréen, l'espagnol et l'indonésien sont acceptés ; l'audio détermine la durée, montez donc d'abord l'audio avant de décider de la longueur à générer.
- Pour les scènes multi-personnes, créez d'abord le masque, puis écrivez le prompt : précisez qui parle et ce que font les autres.
Choisissez un portrait proche de vos propres ressources, ajoutez un enregistrement de moins de 15 secondes et collez-y l'un des prompts ci-dessus.Ouvrir la page du modèle OmniHuman 1.5 →
À lire aussi : Tarifs d'OmniHuman 1.5 · vs HeyGen Avatar IV · Tutoriel d'intégration API
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Qu'est-ce que GPT Image 2.6 ? L'édition par markup et les spécifications connues
Toutes les informations sur GPT Image 2.6 dans la spécification de l'API OpenAI, comment utiliser le nouveau paramètre d'édition markup, et ce qui n'a pas encore été annoncé.
-

Guide d'utilisation
Combien coûte l'API Vidu Q4 Preview ? 540p à 0,0515 $ par seconde
Les deux modes au même prix, comment est facturée chaque résolution sur cinq niveaux et de 3 à 16 secondes, combien de vidéos produire avec 10 $, et le comparatif de prix avec les autres modèles vidéo de la plateforme.
-

Guide d'utilisation
Recraft V4.1 Flash pour photos produit e-commerce : des visuels de catalogue en série à 0,01 $ pièce
Un véritable lot parallèle sur recraft-v4.1-flash/text-to-image : photos de fiche produit et mises en situation, blancheur du fond mesurée, temps d'exécution et script par lots.