
Guia de uso
Guia completo de prompts do OmniHuman 1.5: 5 cenários para copiar e gerar vídeos
Narração horizontal, apresentador pet, movimento de corpo inteiro, apresentação em inglês e máscara com várias pessoas, com vídeos reais.
Cada um dos exemplos abaixo é um vídeo real gerado pelo OmniHuman 1.5; o que é dito e por quanto tempo é totalmente determinado pelo áudio de condução.
1. Narração em formato horizontal: apresentação de produto
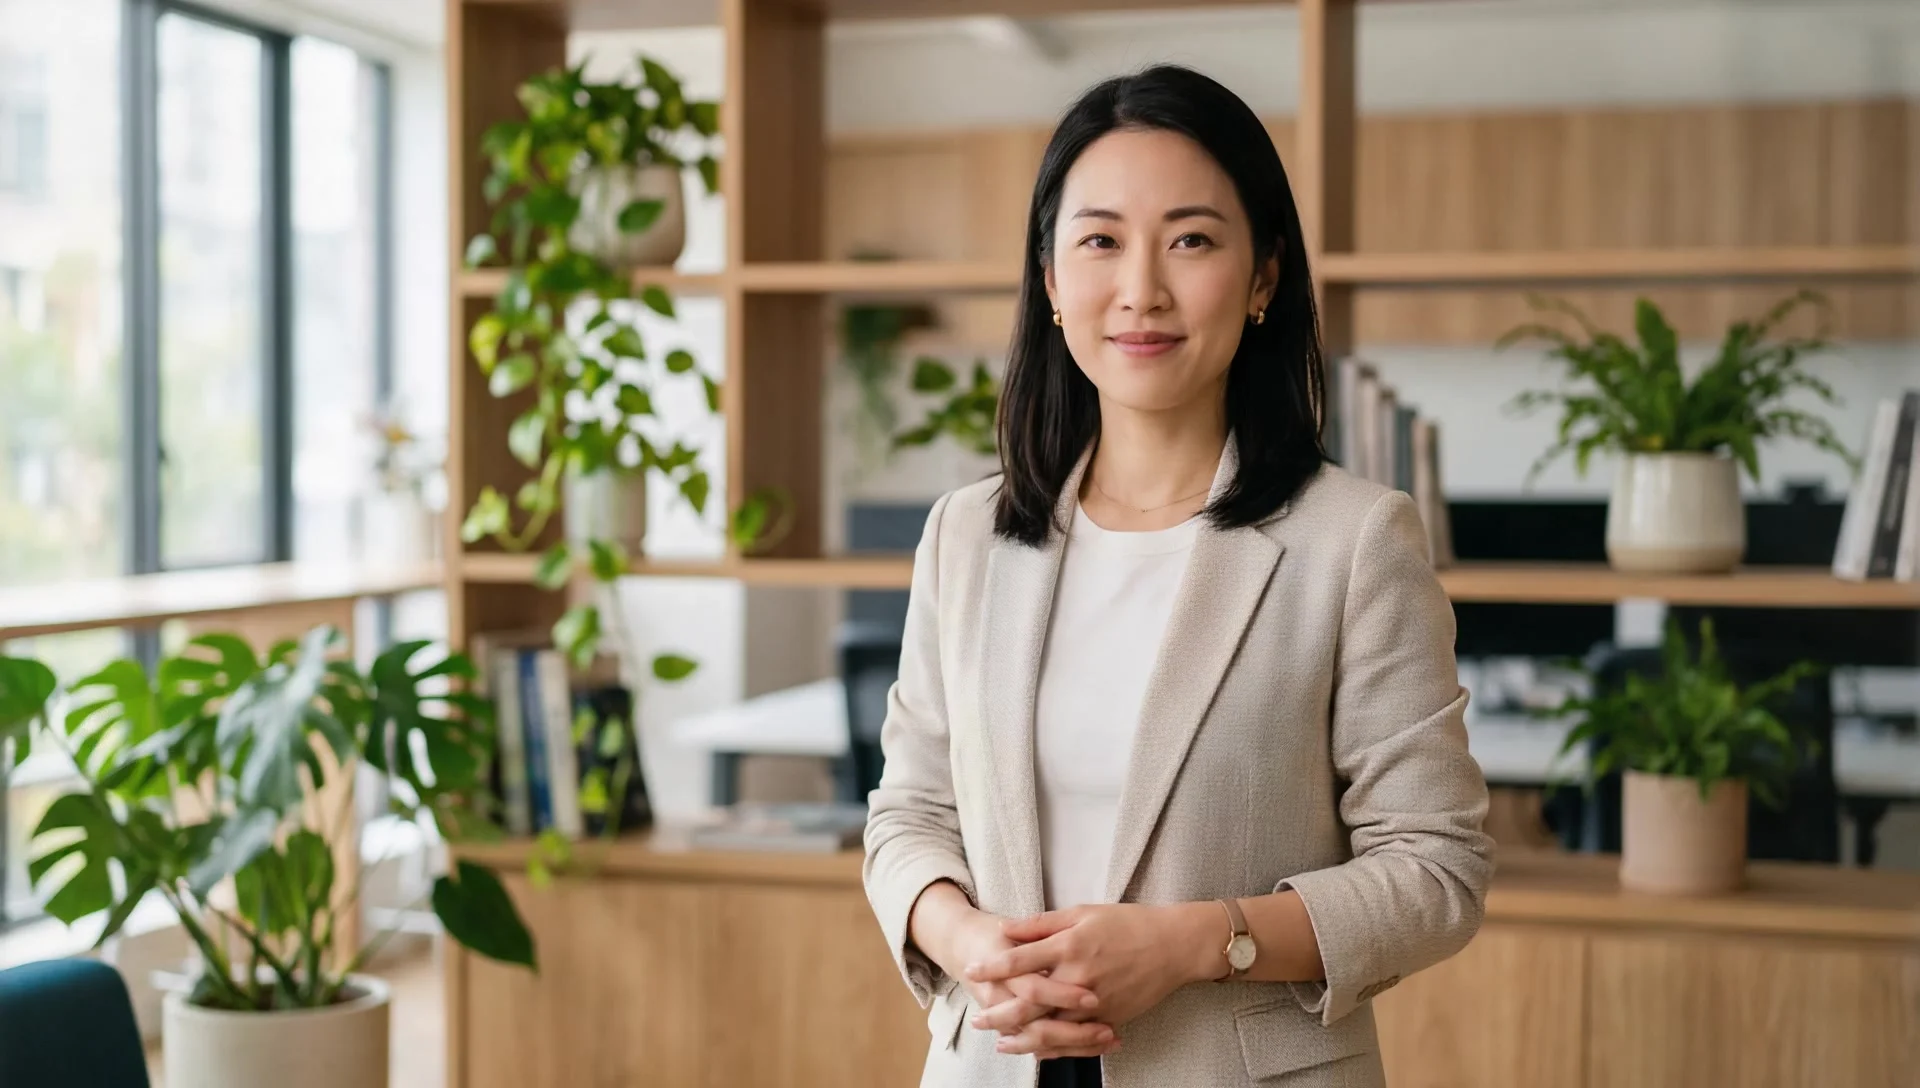
Parâmetros: foto de meio corpo em horizontal 16:9 · 1080p · 8 segundos · $1.544 · Ver MP4 →
Observe que as mãos se abrem nos pontos de funcionalidade e o aceno de cabeça acontece entre as frases, em vez de acenar a cada palavra.
Fale sorrindo naturalmente, abra levemente as mãos em gestos ao mencionar as funcionalidades e acene com a cabeça de vez em quando
Três frases definem três camadas: expressão, um gesto vinculado à fala e um pequeno movimento "ocasional". A parte do som não precisa ser escrita, pois já está no áudio.
2. Apresentador pet: imagem de notícias 1:1
Parâmetros: imagem de gato apresentador 1:1 · 720p · 8 segundos · $1.544 · Ver MP4 → Materiais: retrato do gato
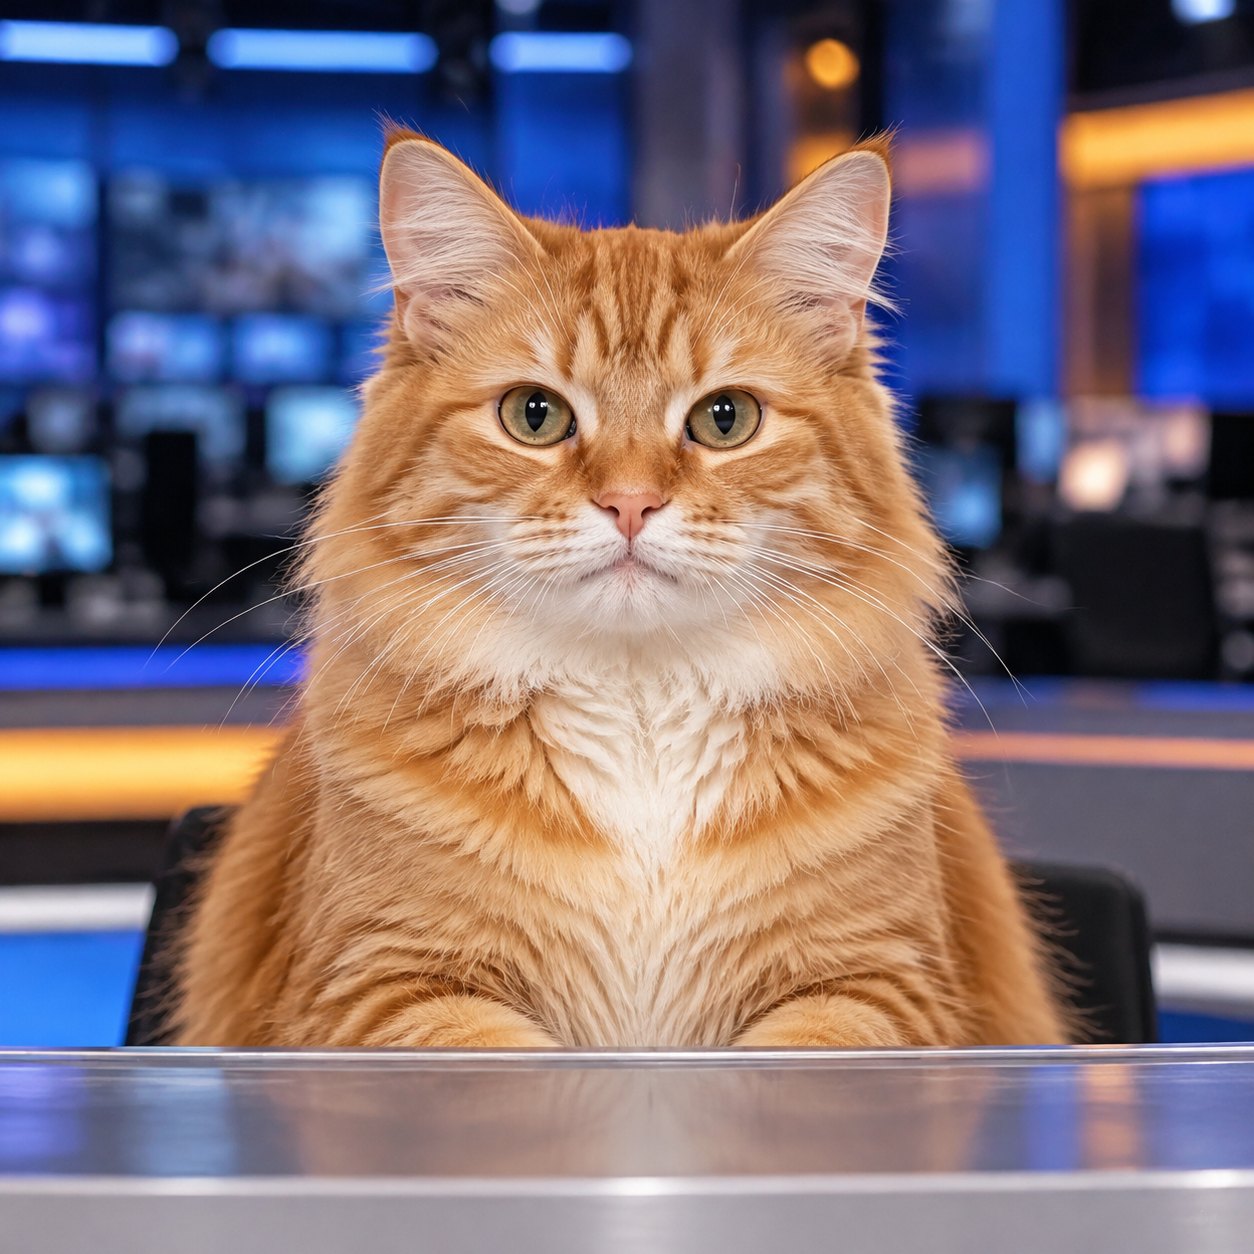
O gato olha para a câmera do começo ao fim, e as ações ficam todas no rosto: orelhas se movendo levemente e piscadas, sem mãos para gesticular.
Apresente notícias naturalmente olhando para a câmera, mova levemente as orelhas enquanto fala e pisque de vez em quando
A estrutura da frase imita a de um apresentador humano, apenas trocando os gestos por ações que um gato consegue fazer. "Olhando para a câmera" fixa o olhar, e "naturalmente" evita que o ritmo da apresentação fique rígido.
3. Movimento de corpo inteiro: apresentação 9:16
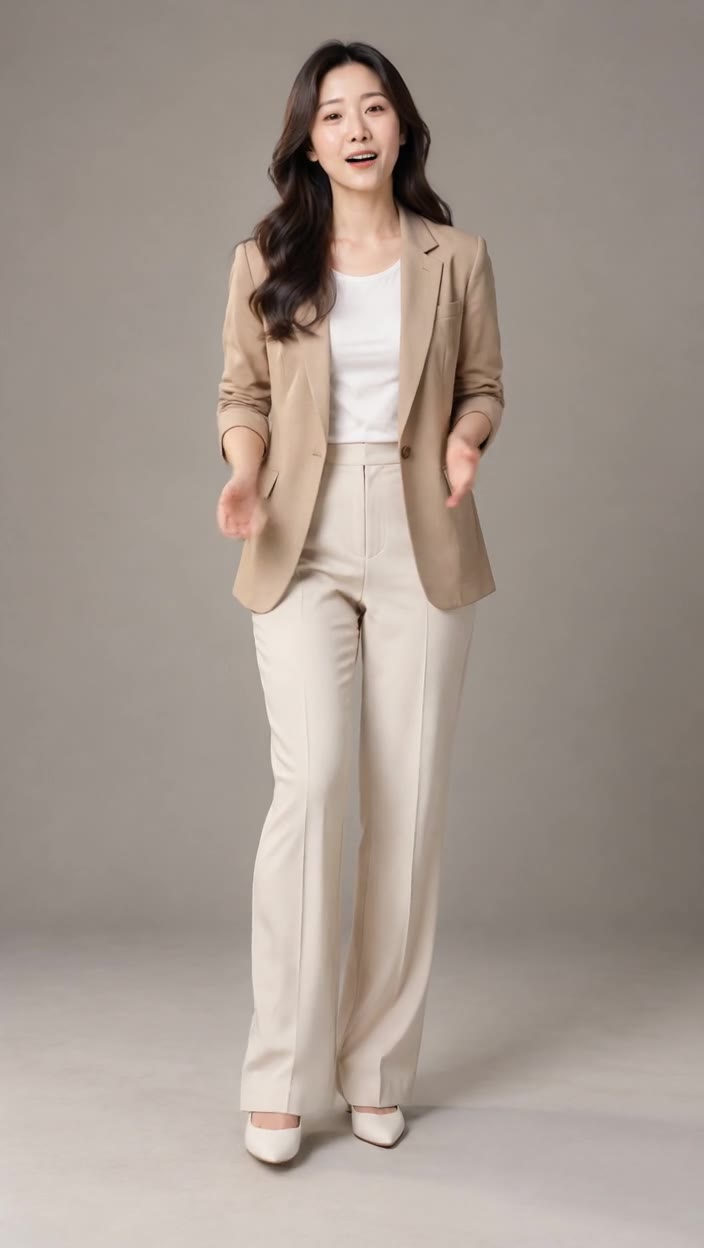
Parâmetros: foto de corpo inteiro 9:16 · 720p · 8 segundos · $1.544 · Ver MP4 →
Na imagem de corpo inteiro, as mãos têm espaço para se movimentar; com as mesmas três frases, o vídeo parece mais uma apresentação e menos um avatar que só mexe a boca.
Fale sorrindo naturalmente, abra levemente as mãos em gestos conforme a apresentação avança e acene com a cabeça de vez em quando
"Conforme a apresentação avança" vincula os gestos ao ritmo da fala, em vez de um ciclo fixo; "acene com a cabeça de vez em quando" dá à cabeça um movimento secundário levemente atrasado, evitando que a parte superior do corpo fique rígida.
4. Apresentação em inglês: o mesmo retrato, outro idioma
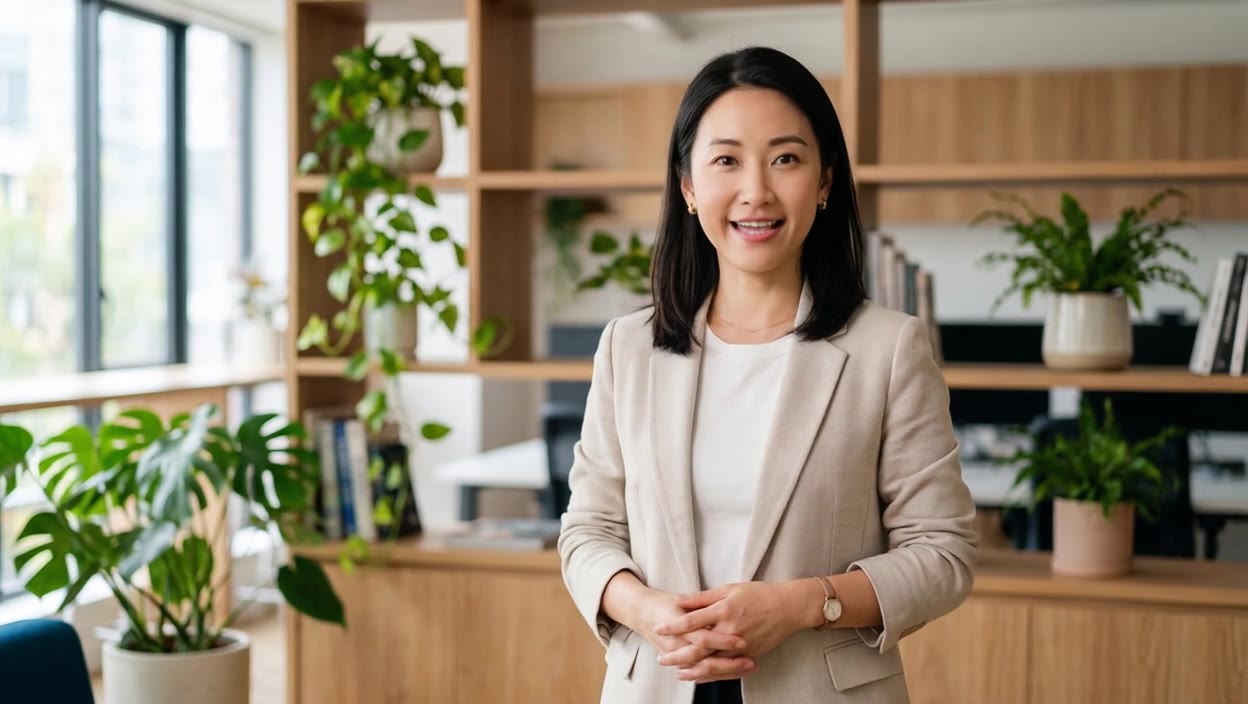
Parâmetros: retrato horizontal 16:9 (o mesmo do exemplo 1) · 720p · áudio de 7,5 segundos, cobrado como 8 segundos · $1.544 · Ver MP4 →
O inglês é falado mais rápido que o chinês, e os três movimentos continuam nos lugares certos: sorriso leve, mãos abertas ao destacar um ponto e aceno ocasional de cabeça.
Speak naturally to camera with a slight smile, open your hands when making a point, and nod occasionally.
O prompt não menciona idioma, apenas movimentos. Com o mesmo retrato, trocando a gravação em chinês pela em inglês, esses três movimentos continuam funcionando.
5. Máscara com várias pessoas: designar quem fala em uma cena com três pessoas
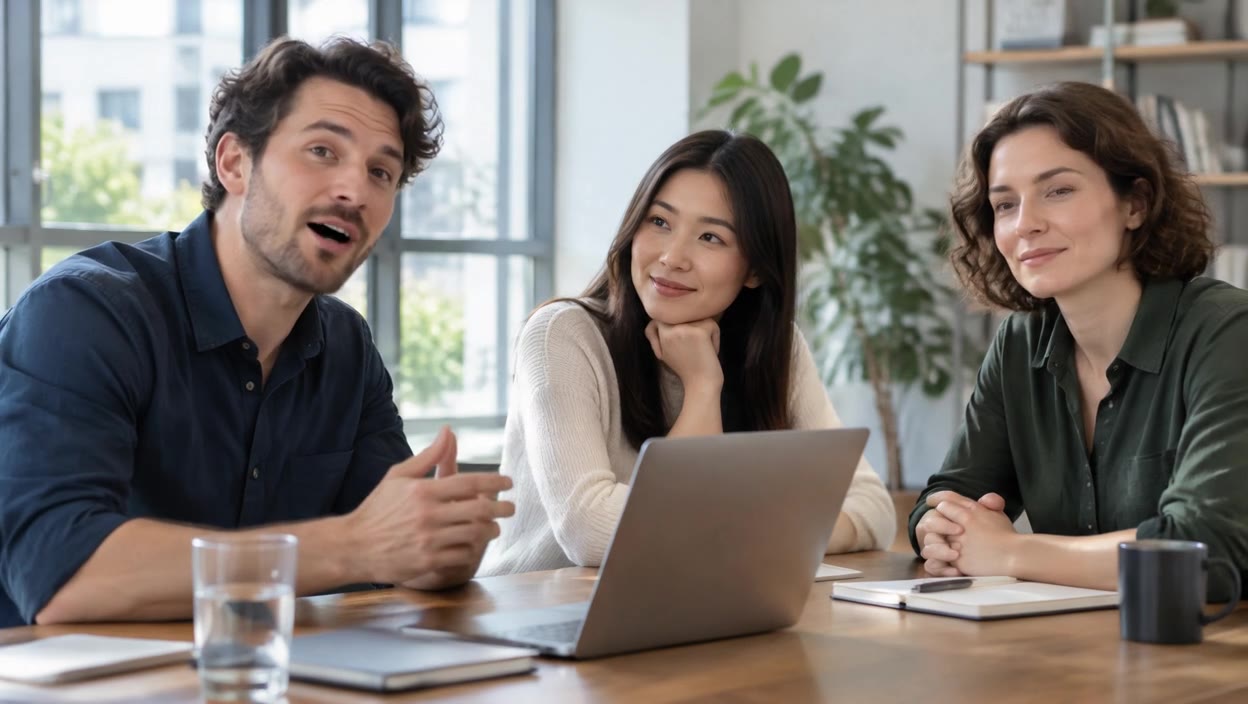
Parâmetros: imagem de reunião com três pessoas 16:9 · máscara do mesmo tamanho (homem à esquerda em branco) · 720p · 8 segundos · $1.544 · Ver MP4 → Materiais: retrato da reunião · máscara
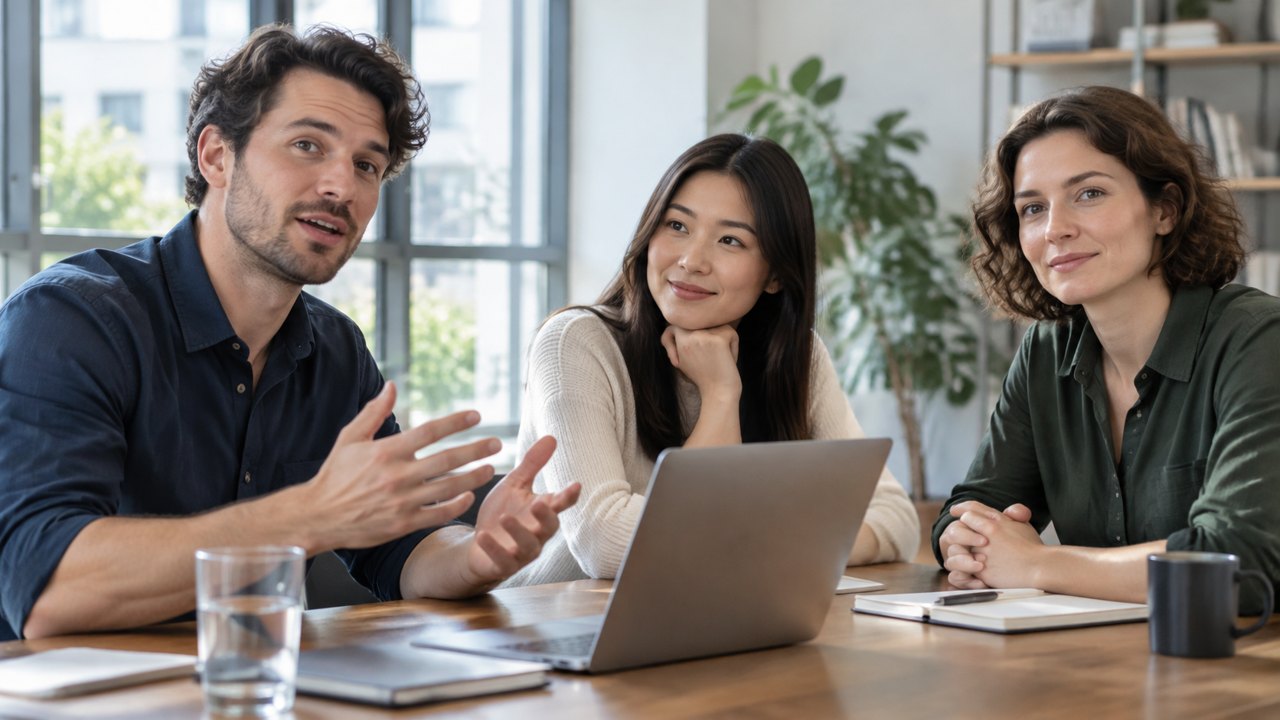
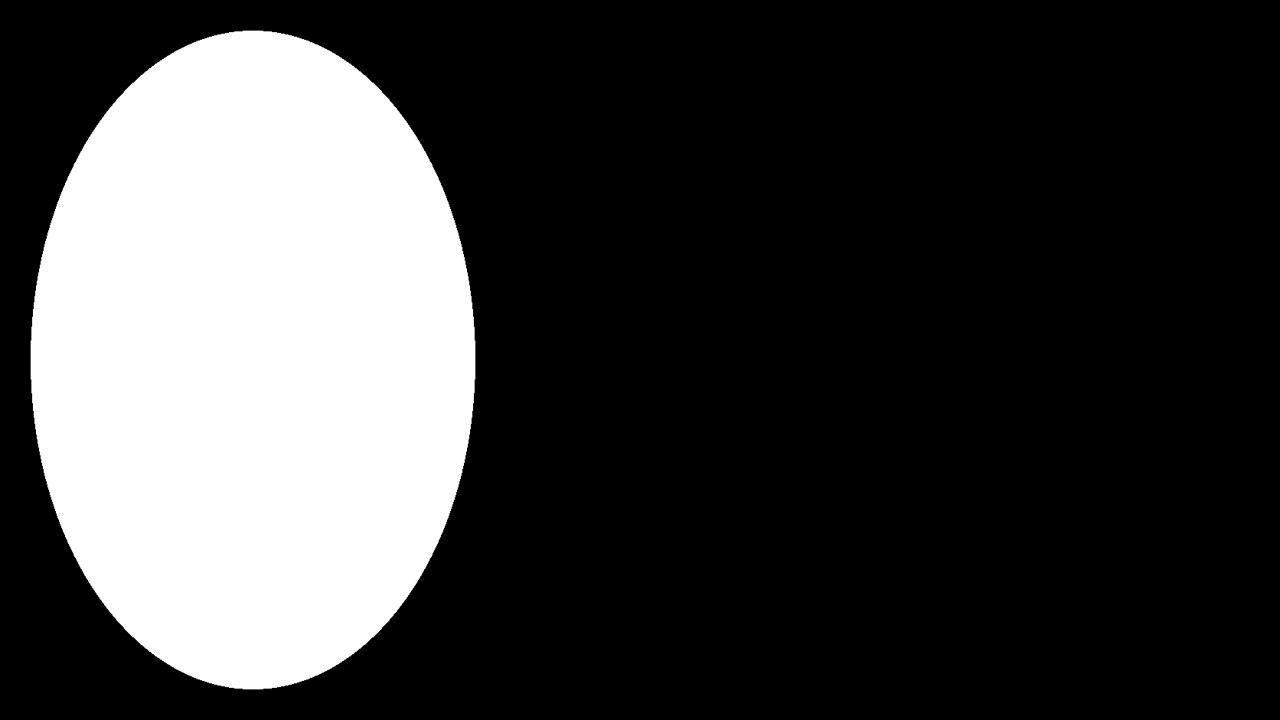
A máscara determina quem pode falar, e o prompt informa quais reações as outras duas pessoas devem ter no rosto.
Apenas o homem à esquerda fala, enquanto os dois do meio e da direita mantêm um sorriso de escuta e se movem levemente de forma natural
A primeira parte repete a máscara por escrito: apenas o homem à esquerda fala; a segunda parte atribui tarefas aos do meio e da direita — sorrir, escutar e se mover levemente. Assim, não fica apenas uma pessoa se movendo na imagem, nem alguém tenta falar por cima do outro.
Como escrever seus próprios prompts
- Escreva na ordem "expressão → gesto → câmera", uma frase para cada item já basta.
- Mantenha em até 300 caracteres; é possível escrever em chinês, inglês, japonês, coreano, espanhol e indonésio; o áudio determina a duração, então edite o áudio antes de decidir o tempo de geração.
- Em cenas com várias pessoas, faça a máscara primeiro e depois escreva o prompt: deixe claro quem fala e o que as outras pessoas estão fazendo.
Escolha um retrato próximo do seu material, combine com uma gravação de até 15 segundos e cole qualquer um dos prompts acima.Abrir a página do modelo OmniHuman 1.5 →
Leitura relacionada: Preços do OmniHuman 1.5 · vs HeyGen Avatar IV · Tutorial de integração via API
Artigos relacionados
Ver todos os artigos →-

Guia de uso
O que é o GPT Image 2.6? Edição com markup e especificações conhecidas
Todas as informações sobre o GPT Image 2.6 na especificação da API da OpenAI, como usar o novo parâmetro de edição markup e o que ainda não foi divulgado.
-

Guia de uso
Quanto custa a API Vidu Q4 Preview? 540p a $0.0515 por segundo
Os dois modos têm o mesmo preço; saiba como é a cobrança nas cinco resoluções e de 3 a 16 segundos, quantos clipes $10 geram e confira a comparação de preços com outros modelos de vídeo do site.
-

Guia de uso
Imagens de produtos de e-commerce com Recraft V4.1 Flash: $0,01 por imagem para catálogos em lote
Um lote paralelo real no recraft-v4.1-flash/text-to-image: imagens de listagem e de ambientação, brancura de fundo medida, tempos e script em lote.