
Guida all'uso
Guida completa ai prompt di OmniHuman 1.5: 5 scenari pronti da copiare per creare il video
Presentazione orizzontale, conduttore animale, movimento a figura intera, presentazione in inglese, maschera multi-persona, con video reali.
Ogni voce qui sotto è un video reale prodotto con OmniHuman 1.5; cosa viene detto e per quanto tempo è determinato interamente dall'audio di guida.
1. Presentazione orizzontale: spiegazione di un prodotto
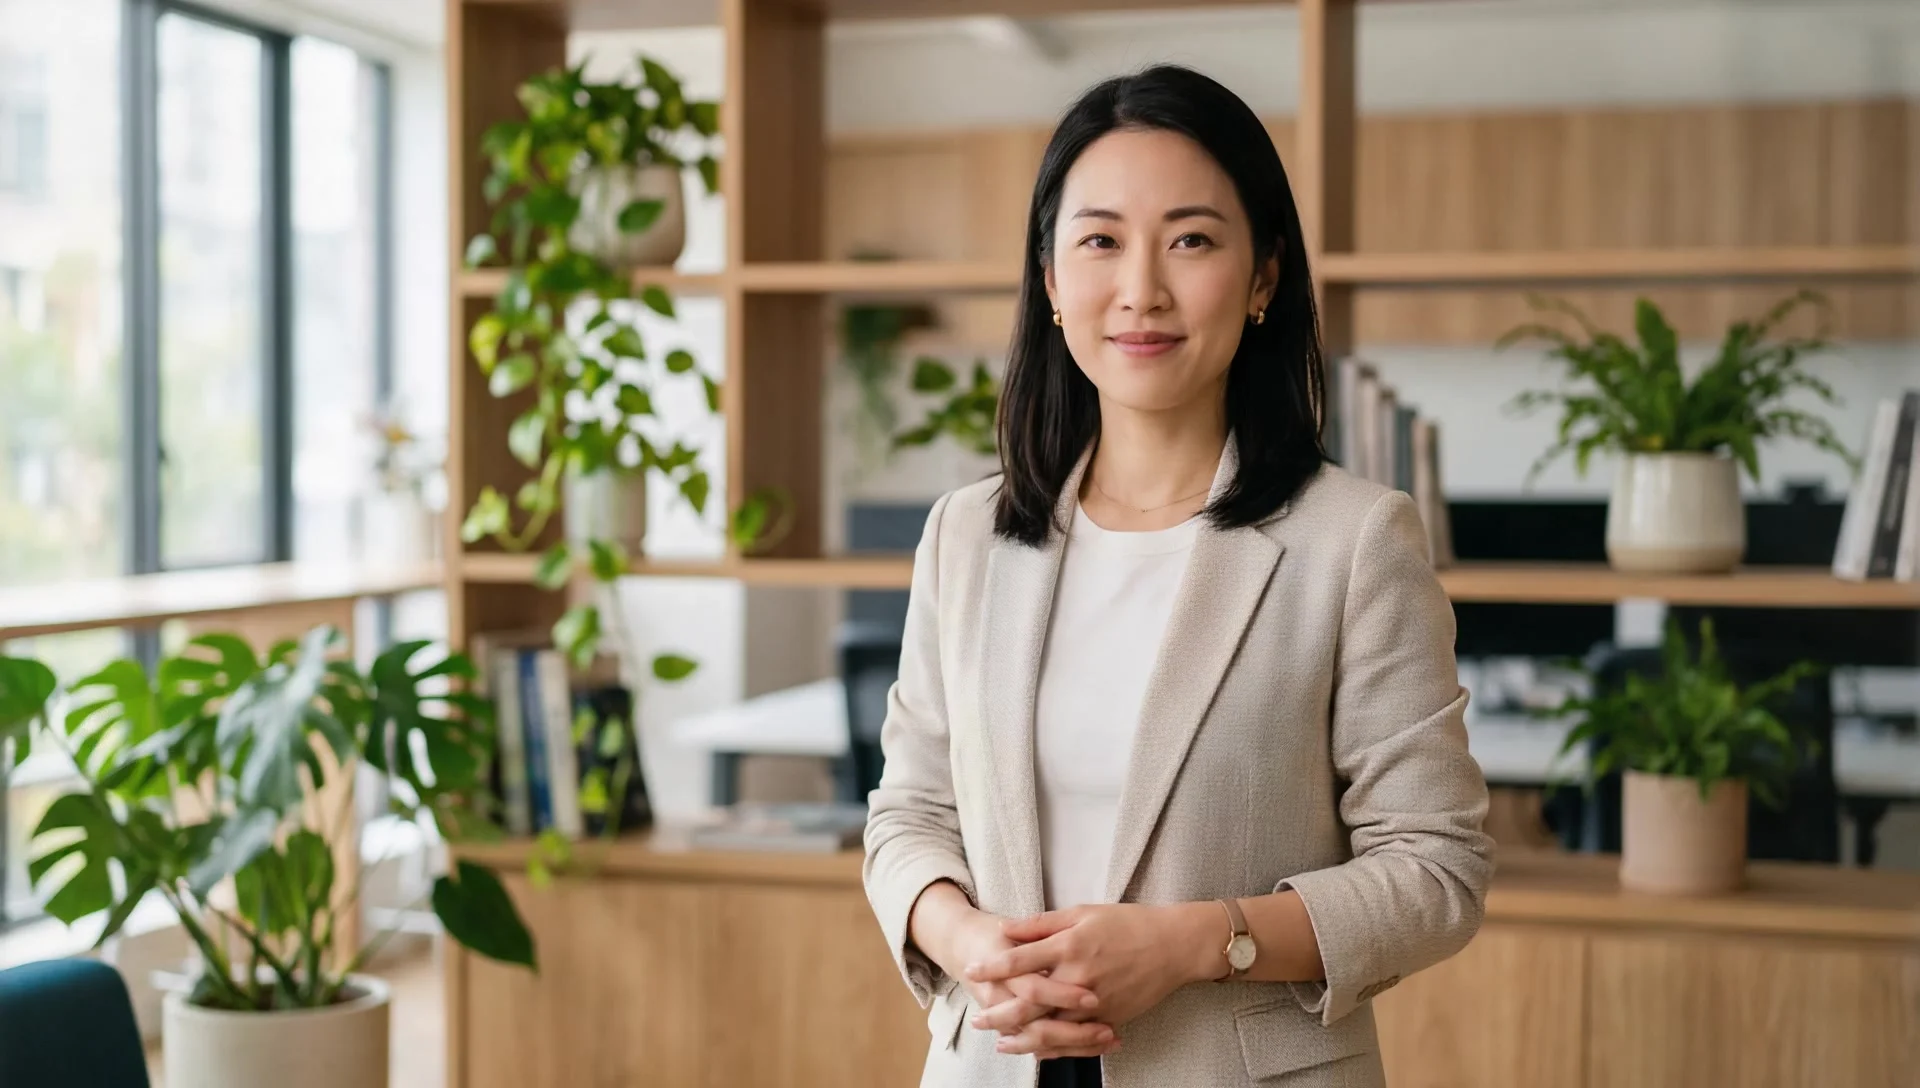
Parametri: ritratto a mezzo busto orizzontale 16:9 · 1080p · 8 secondi · $1.544 · Guarda l'MP4 →
Nota che le mani si aprono nei punti dedicati alle funzionalità e che il cenno del capo cade tra le frasi, non su ogni parola.
Parla sorridendo in modo naturale, apri leggermente le mani con un gesto quando parli delle funzionalità, annuisci ogni tanto
Tre frasi che definiscono tre livelli: espressione, un gesto legato alla battuta e un piccolo movimento «ogni tanto». La parte vocale non serve scriverla, è già presente nell'audio.
2. Conduttore animale: inquadratura da notiziario 1:1
Parametri: immagine di un gatto conduttore 1:1 · 720p · 8 secondi · $1.544 · Guarda l'MP4 → Materiali: ritratto del gatto
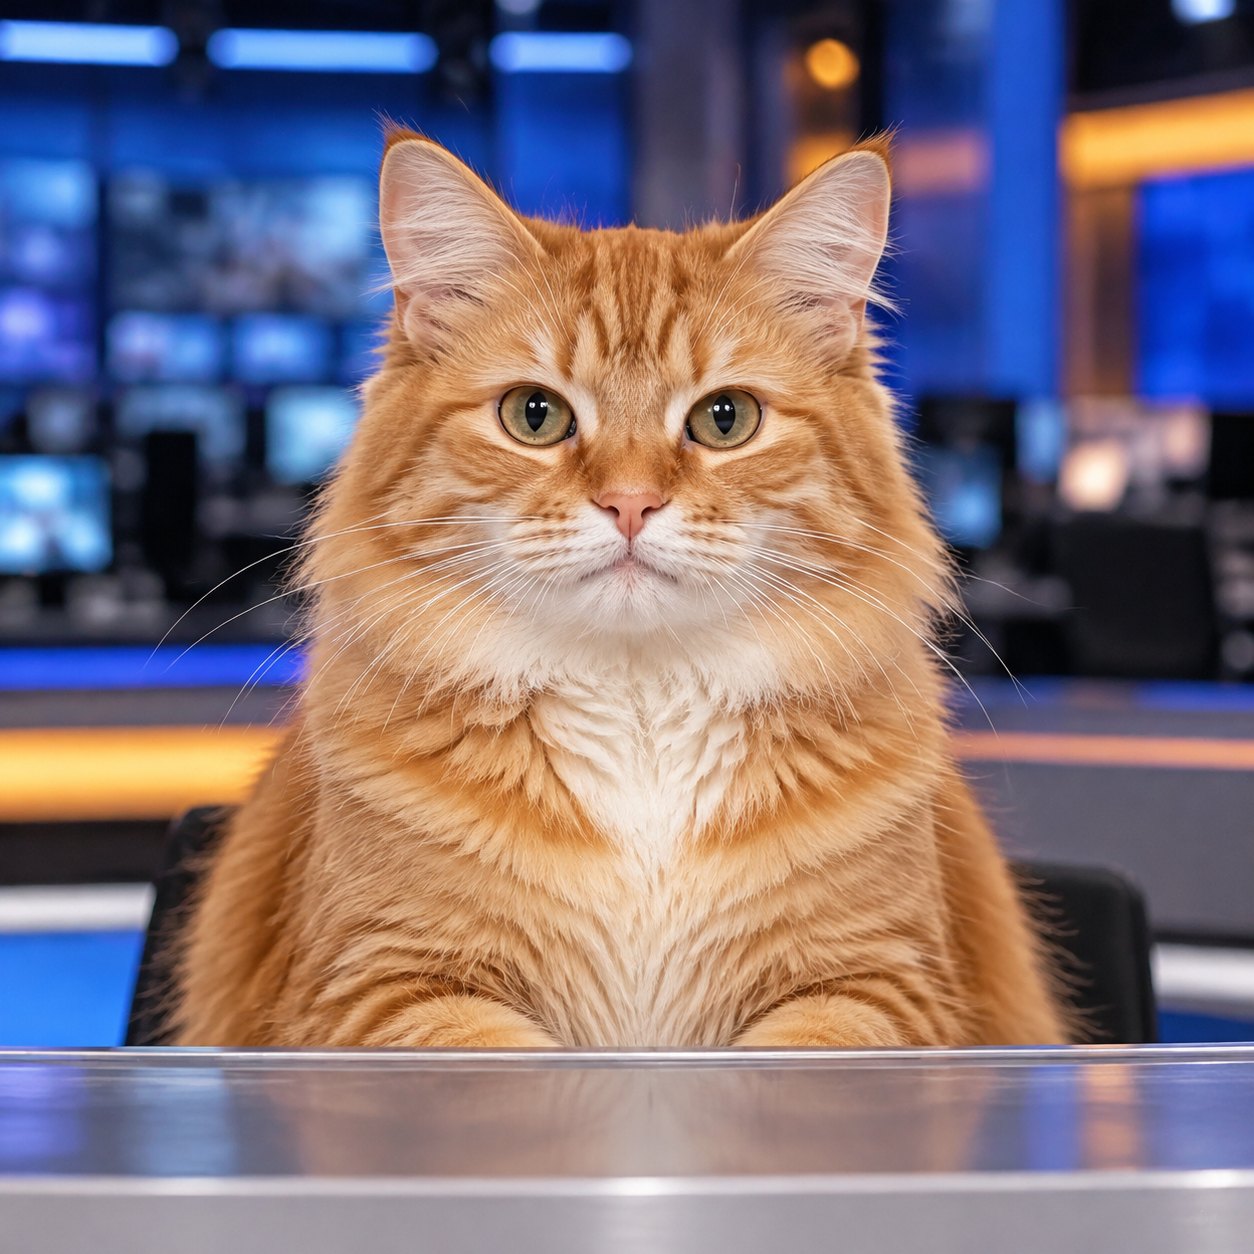
Il gatto guarda la camera dall'inizio alla fine e i movimenti si concentrano sul viso: orecchie che si muovono leggermente e battito di ciglia, non ci sono mani per gesticolare.
Leggi le notizie in modo naturale guardando verso la camera, muovi leggermente le orecchie mentre parli, sbatti le palpebre ogni tanto
La struttura della frase copia quella di un conduttore umano, sostituendo solo i gesti con azioni che un gatto può fare. «Guardando verso la camera» blocca lo sguardo, «in modo naturale» evita che il ritmo della lettura risulti rigido.
3. Movimento a figura intera: presentazione 9:16
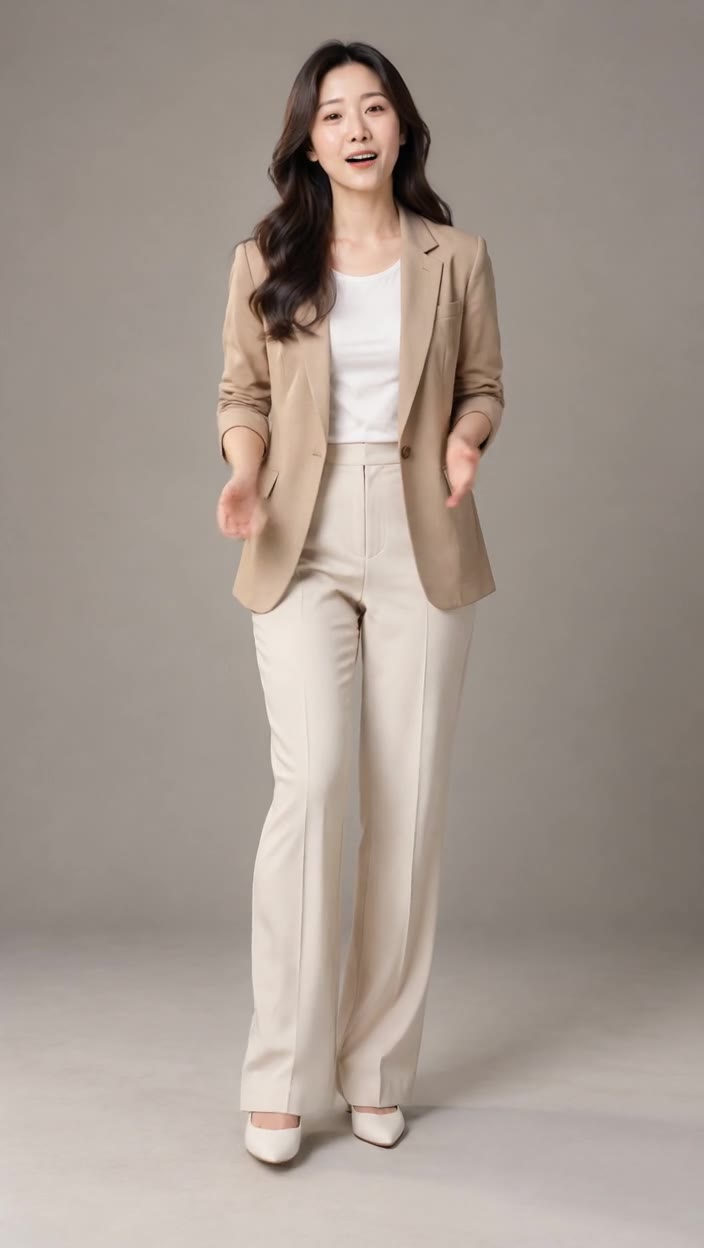
Parametri: foto a figura intera 9:16 · 720p · 8 secondi · $1.544 · Guarda l'MP4 →
Nell'inquadratura a figura intera le mani hanno spazio per muoversi; con le stesse tre frasi il video sembra più una spiegazione e meno un avatar che muove solo la bocca.
Parla sorridendo in modo naturale, apri leggermente le mani con un gesto seguendo la spiegazione, annuisci ogni tanto
«Seguendo la spiegazione» lega i gesti al ritmo dell'esposizione, non a un ciclo fisso; «annuisci ogni tanto» dà alla testa un movimento secondario leggermente in ritardo, così la parte superiore del corpo non resta rigida.
4. Presentazione in inglese: stesso ritratto, un'altra lingua
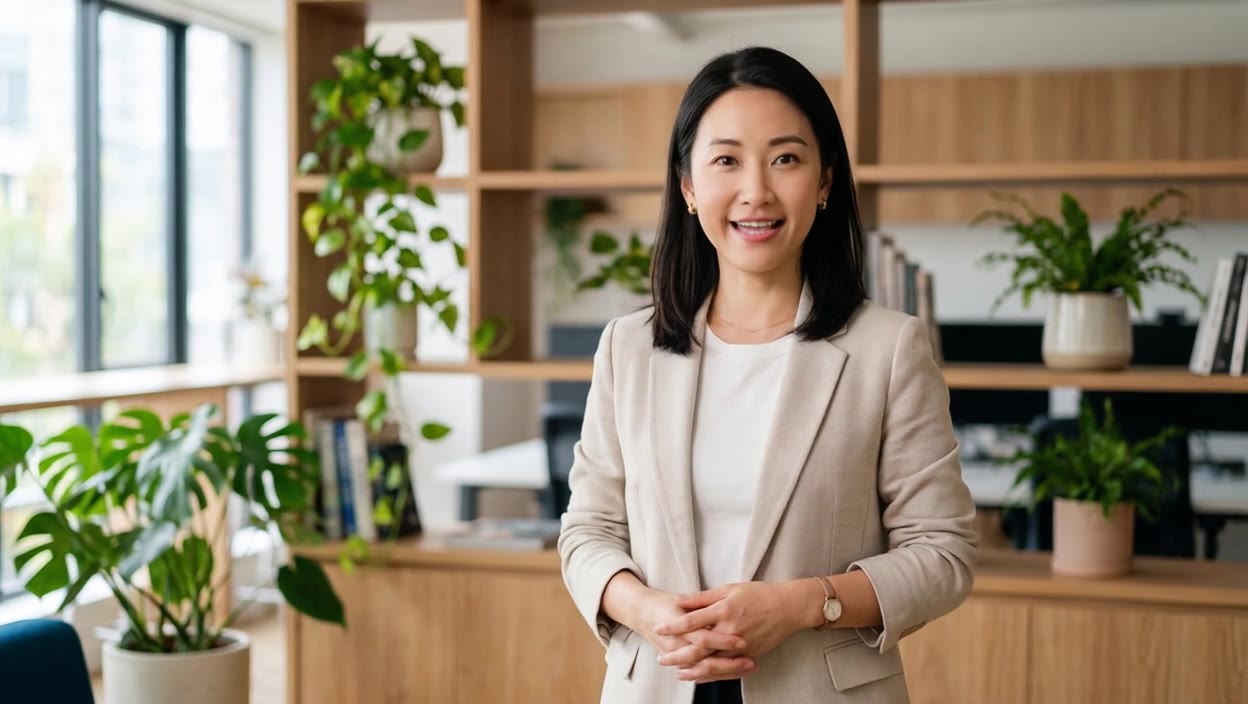
Parametri: ritratto orizzontale 16:9 (lo stesso del caso 1) · 720p · audio di 7,5 secondi, fatturato come 8 secondi · $1.544 · Guarda l'MP4 →
L'inglese è più veloce del cinese, ma i tre movimenti cadono comunque al posto giusto: sorriso leggero, mani aperte nei punti chiave, cenno del capo ogni tanto.
Speak naturally to camera with a slight smile, open your hands when making a point, and nod occasionally.
Il prompt non menziona la lingua, descrive solo i movimenti. Con lo stesso ritratto, passando da una registrazione in cinese a una in inglese, queste tre indicazioni continuano a funzionare.
5. Maschera multi-persona: indicare chi parla in una scena con tre persone
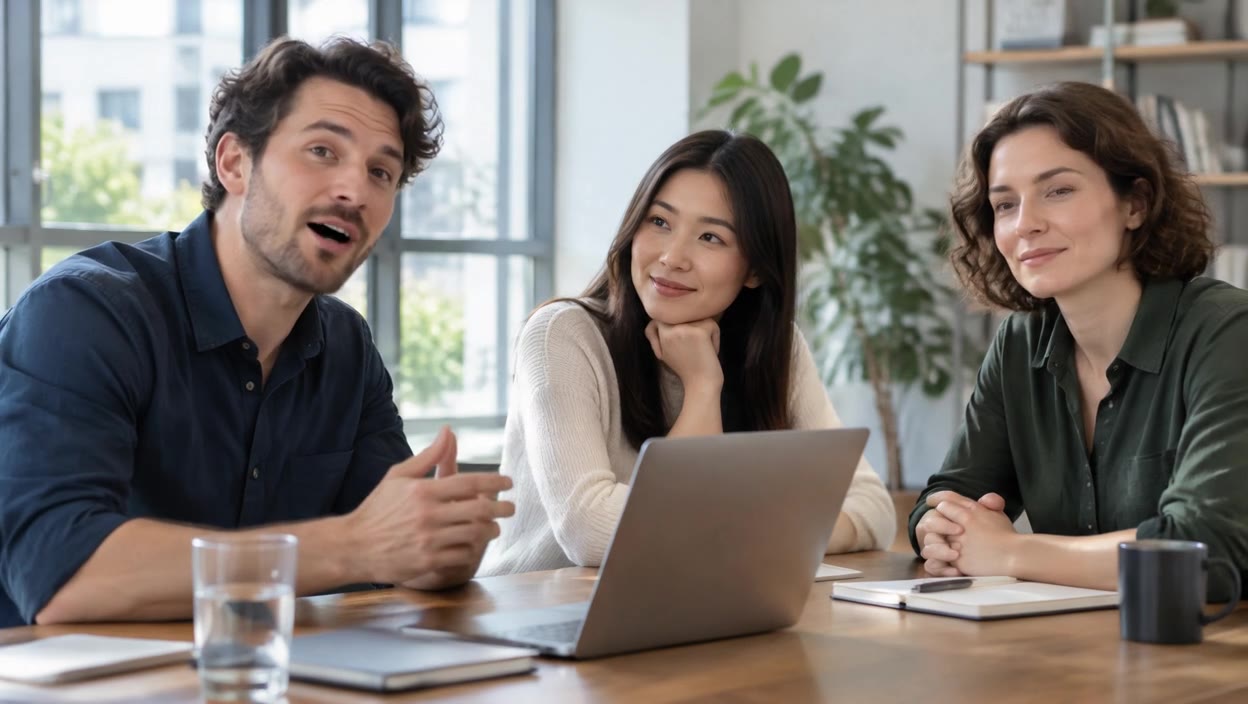
Parametri: immagine di una riunione a tre persone 16:9 · maschera delle stesse dimensioni (l'uomo a sinistra in bianco) · 720p · 8 secondi · $1.544 · Guarda l'MP4 → Materiali: ritratto della riunione · maschera
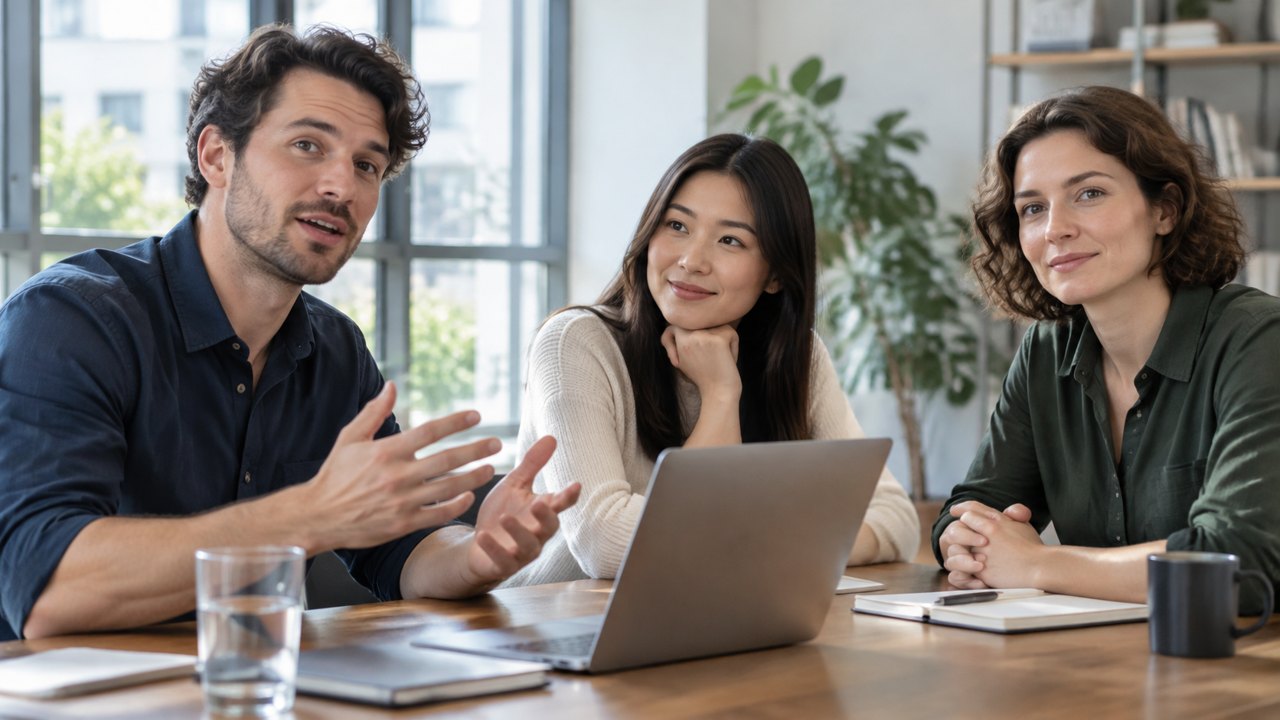
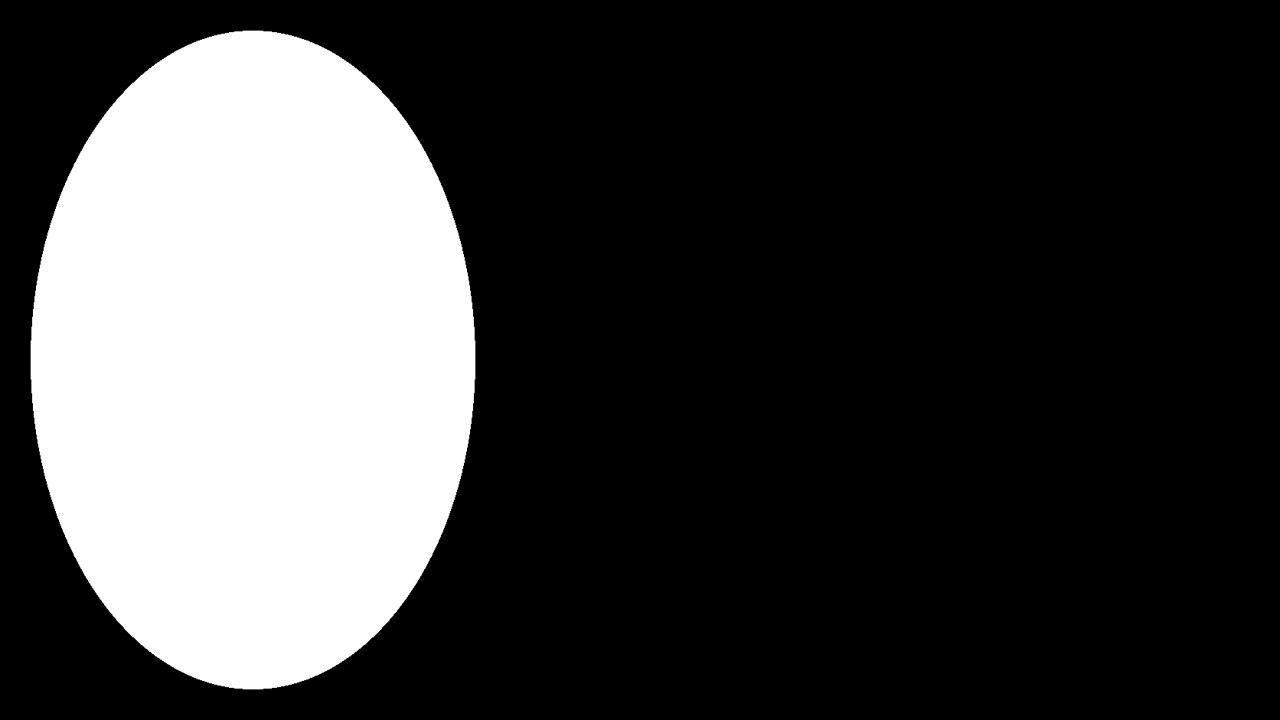
La maschera stabilisce chi può parlare, mentre il prompt indica che espressioni devono avere sul volto le altre due persone.
Solo l'uomo a sinistra parla, le due persone al centro e a destra restano sorridenti in ascolto, con leggeri movimenti naturali del corpo
La prima parte ripete a parole la maschera: solo l'uomo a sinistra parla; la seconda assegna un compito alle persone al centro e a destra: sorridere, ascoltare, muovere leggermente il corpo. Così nella scena non si muove una sola persona, ma nessuno ruba la parola.
Come scrivere i propri prompt
- Scrivi seguendo l'ordine «espressione → gesti → inquadratura», basta una frase per elemento.
- Resta entro 300 caratteri; puoi scrivere in cinese, inglese, giapponese, coreano, spagnolo e indonesiano; l'audio determina la durata, quindi monta prima l'audio e poi decidi quanto lungo generare il video.
- Per le scene con più persone crea prima la maschera e poi scrivi il prompt: indica chi parla e cosa fanno gli altri.
Scegli un ritratto simile ai tuoi materiali, abbinalo a una registrazione entro i 15 secondi e incolla uno qualsiasi dei prompt qui sopra.Apri la pagina del modello OmniHuman 1.5 →
Letture correlate: Prezzi di OmniHuman 1.5 · vs HeyGen Avatar IV · Tutorial per integrare l'API
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Cos'è GPT Image 2.6? Modifica markup e specifiche note
Tutte le informazioni su GPT Image 2.6 nella specifica dell'API OpenAI, come usare il nuovo parametro di modifica markup, e cosa non è ancora stato annunciato.
-

Guida all'uso
Quanto costa l'API di Vidu Q4 Preview? $0,0515 al secondo a 540p
Stesso prezzo per le due modalità, come viene fatturato con cinque livelli di risoluzione e durata da 3 a 16 secondi, quanti video si possono fare con $10 e il confronto prezzi con gli altri modelli video della piattaforma.
-

Guida all'uso
Immagini prodotto e-commerce con Recraft V4.1 Flash: immagini catalogo in batch a $0,01 ciascuna
Un vero batch parallelo su recraft-v4.1-flash/text-to-image: immagini di listino e di scena, bianco dello sfondo misurato, tempi e script batch.