
Guide d'utilisation
Guide de prise en main de Vidu Q3 Mix reference-to-video : limites de capacité, paramètres API et points clés de facturation
Décision d'intégration et point de vue pratique pour les développeurs
Sur cette page
Quel problème ce modèle résout-il
La forme d'entrée d'un modèle de génération vidéo détermine si vous gardez ou non le « contrôle » en main. Le texte-vers-vidéo (text-to-video) ne fournit qu'un prompt : le déroulement de l'image est laissé à la libre interprétation du modèle ; l'image-vers-vidéo (image-to-video) fournit une première image, que le modèle se charge de « mettre en mouvement ». Le reference-to-video (vidéo à partir de références) emprunte une troisième voie : vous fournissez un matériel de référence, et le modèle s'y réfère en continu pendant la génération, au lieu de le traiter uniquement comme première image.
C'est dans cette branche que se situe vidu-q3-mix/reference-to-video. Il convient aux besoins suivants :
- Un personnage ou un sujet doit rester cohérent d'un plan à l'autre : vous n'avez pas de séquences vidéo existantes, mais une ou plusieurs images de référence représentant l'apparence du sujet, et vous souhaitez que le sujet « ressemble toujours à lui-même » dans la vidéo finale.
- Le style et la tonalité doivent être ancrés : le matériel de référence porte la lumière, les matières, les tendances de composition ; la vidéo finale reprend ce langage visuel, ce qui est plus contrôlable qu'une simple description textuelle.
- Produire du contenu animé à partir d'actifs statiques : produits e-commerce, mascottes d'IP, concept arts, etc. — des images existantes à convertir en courtes vidéos.
Autrement dit, si votre besoin est « donnez-moi une vidéo qui correspond à la description », le texte-vers-vidéo est plus direct ; si votre besoin est « cette vidéo doit ressembler à ce que j'ai fourni », le reference-to-video est l'outil adapté. Au moment du choix, posez-vous d'abord une question : ai-je un point d'ancrage visuel qui doit absolument être conservé ? Si oui, utilisez-le.
Sur HiAPI.ai, ce modèle partage le même contexte d'appel que les autres modèles vidéo : vous n'avez pas à construire une logique d'intégration dédiée. Lorsque vous changez de modèle, ce sont principalement les paramètres de capacité qui changent, pas la structure d'ingénierie.
Différence clé avec l'image-vers-vidéo
Dans l'image-vers-vidéo, l'image d'entrée est un « point de départ » ; dans le reference-to-video, l'entrée est une « contrainte ». La première impose au modèle une image à reprendre, la seconde lui fournit un ensemble de caractéristiques à respecter. Une fois ce point compris, tous les jugements ultérieurs sur la préparation du matériel et l'optimisation des paramètres deviennent logiques.
Limites de capacité et cas d'usage inadaptés
Délimiter clairement le périmètre de capacités du modèle est plus important que de mémoriser ce qu'il prend en charge. Sur la base de la définition de capacité reference-to-video, les limites suivantes peuvent être établies :
Ce qu'il couvre
- Générer une vidéo à partir d'un matériel de référence comme base visuelle : les caractéristiques de l'image de référence sont introduites dans le processus de génération.
- Cohérence du sujet et continuité du style : maintien d'une expression d'apparence relativement stable sur plusieurs segments générés.
- Contrôler le déroulement du contenu via le prompt : le matériel de référence gère le « à quoi ça ressemble », le prompt gère le « ce qui se passe ».
Ce qu'il ne couvre pas
- Ce n'est pas un substitut au texte-vers-vidéo : sans matériel de référence, il ne faut pas écrire un prompt extrêmement long pour « simuler » une image de référence ; c'est un mauvais usage de l'outil, tant en efficacité qu'en coût.
- Ce n'est pas un outil de reproduction stricte image par image : le reference-to-video ne consiste pas à animer précisément une image de référence, et il ne faut pas attendre de lui qu'il soit responsable de chaque pixel de l'image de référence. Si votre besoin est « cette image doit s'animer telle quelle », l'image-vers-vidéo est plus proche.
- Aucune promesse de durée illimitée : la limite de durée d'une génération unique dépend des paramètres disponibles de l'interface et du panneau de la plateforme ; ne concevez pas votre flux produit sur le principe « je génère aussi longtemps que je veux ».
- Ne remplace pas la post-production : sous-titres, montage, assemblage de segments, mixage audio restent de la responsabilité de votre pipeline.
Le mauvais usage le plus courant lors du choix
Le mauvais usage le plus typique consiste à prendre le reference-to-video pour un « image-vers-vidéo moins cher ». Les sémantiques d'entrée diffèrent, tout comme les attentes de résultat : lorsque vous avez réellement besoin d'un alignement strict sur la première image, le reference-to-video produit souvent un résultat « ressemblant mais différent », et les tentatives répétées ne font qu'amplifier les coûts. Inversement, lorsque vous avez besoin d'un sujet stable entre plusieurs plans, alimenter l'image-vers-vidéo segment par segment fait plus facilement dériver l'apparence.
La règle de décision peut se résumer en une phrase : besoin d'un point de départ, choisissez l'image-vers-vidéo ; besoin d'une contrainte, choisissez le reference-to-video.
Paramètres API et points clés du flux d'appel
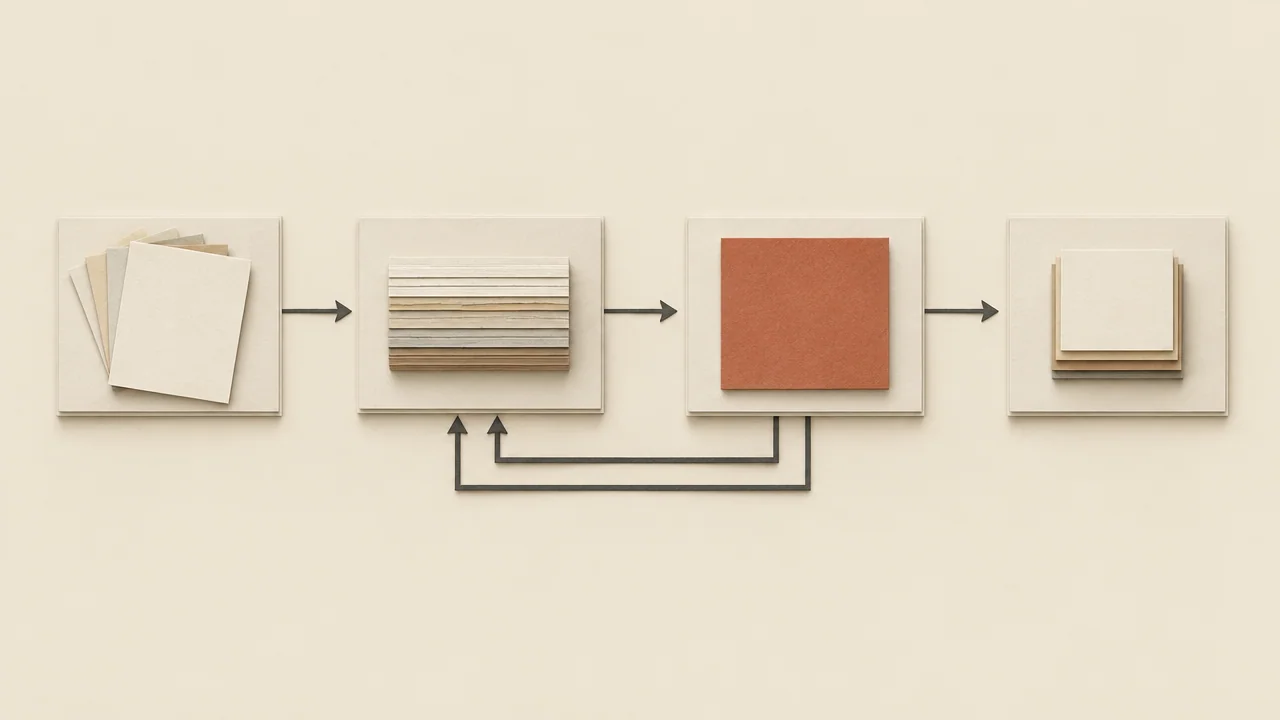
La complexité d'ingénierie de l'intégration de ce type de modèle ne réside pas principalement dans « l'envoi de la requête », mais dans « la préparation des entrées » et « l'organisation du flux ». La chaîne globale peut être découpée en quatre étapes :
1. Préparation du matériel de référence
Avant de lancer l'appel, normalisez le matériel de référence : uniformisez les dimensions et le ratio, supprimez les filigranes et les éléments d'arrière-plan superflus, assurez-vous que le sujet est net et que l'éclairage est cohérent. C'est seulement si cette étape est bien faite que les ajustements de paramètres ultérieurs auront du sens.
2. Construction de la requête
Un appel typique doit organiser trois types d'informations dans la requête :
- Identifiant de capacité : spécifier l'utilisation de
vidu-q3-mix/reference-to-videopour que la requête atteigne la bonne branche de capacité. - Matériel de référence : emplacement ou handle de téléversement des images de référence ; les noms de champs exacts et les formats acceptés sont définis par la documentation de l'interface.
- Description de génération : le prompt, qui décrit l'action, les mouvements de caméra, le rythme et l'ambiance, sans répéter l'apparence déjà présente dans l'image de référence.
Les noms de champs exacts, les champs obligatoires et les plages de valeurs sont définis par la documentation de l'interface et la page de détails du modèle sur HiAPI.ai. Cet article n'invente aucun champ ; lors de l'intégration, assemblez la requête conformément à la documentation.
3. Tâche de génération
La génération vidéo est intrinsèquement asynchrone : après soumission de la requête, un identifiant de tâche est renvoyé, et l'inférence côté modèle prend du temps. Votre serveur doit découpler la « soumission » et la « récupération du résultat », en interrogeant ou en recevant un callback via l'identifiant de tâche, plutôt que d'attendre dans une requête synchrone.
4. Récupération du résultat et nouvelle tentative
Une fois le résultat obtenu, effectuez d'abord une vérification de disponibilité (le fichier se décode-t-il correctement, la durée correspond-elle aux attentes), puis décidez s'il faut réessayer. La branche de nouvelle tentative doit avoir une limite et consigner la cause de chaque échec — c'est essentiel pour estimer les coûts.
Comment rédiger le prompt
Le prompt d'un reference-to-video doit se concentrer sur « les informations hors de l'image de référence » : ce que le sujet doit faire dans l'image, comment la caméra se déplace, comment l'environnement évolue. Consacrer de la place à répéter ce qui figure déjà dans l'image de référence est un gaspillage courant. Plus la description est concrète et proche d'une instruction visuelle exécutable, plus le résultat est stable.
Estimer les coûts à 0,1865 $/seconde
La tarification de ce modèle est basée sur le nombre de secondes de la vidéo de sortie, au prix unitaire de 0,1865 $ par seconde. Une fois ce point compris, l'estimation des coûts devient une simple multiplication.
Formule de coût unitaire
coût unitaire = durée de sortie (secondes) × 0,1865 $
Une vidéo finale de 5 secondes coûte 5 × 0,1865 ; 10 secondes coûtent 10 × 0,1865. La durée double, le coût double linéairement — pas de palier, ni de remise cachée du type « générer en une fois est plus avantageux » ; le budget de durée doit donc être intégré à la conception du produit dès le départ.
Intégrer les nouvelles tentatives
Le coût réel n'est jamais « le prix d'une vidéo ». La génération est incertaine, il faut prévoir un budget de nouvelles tentatives pour les échecs et les résultats insatisfaisants :
coût total attendu = coût unitaire × nombre de tentatives attendu
nombre de tentatives attendu ≈ 1 + taux de nouvelle tentative
Par exemple, si une tâche de génération de 8 secondes nécessite en moyenne une nouvelle tentative pour obtenir un résultat exploitable, le coût réel est de 8 × 0,1865 × 2, et non 8 × 0,1865. Pour les équipes dont le taux de nouvelle tentative est élevé, les coûts sont multipliés — c'est un coût caché que beaucoup d'intégrateurs ne découvrent qu'après la montée en charge.
Trois leviers de contrôle budgétaire
- Court d'abord, long ensuite : en phase de mise au point, utilisez la durée la plus courte pour vérifier l'alignement du prompt et du matériel, puis allongez une fois la validité confirmée. Le coût d'essai-erreur d'une vidéo courte est bien plus faible.
- Fixer une limite de nouvelles tentatives : donnez à chaque tâche un nombre maximal de tentatives ; au-delà, intervention manuelle ou changement de matériel, pour éviter que les nouvelles tentatives automatiques ne consomment le budget.
- Consigner chaque appel : remontez la durée, la présence ou non d'une nouvelle tentative, la cause de l'échec. Sans ces données, impossible de déterminer si le dépassement budgétaire provient du prompt ou du matériel.
Les prix en temps réel et les règles de facturation détaillées sont définis par le panneau tarifaire du site HiAPI.ai ; cet article ne traite que des méthodes d'estimation.
Préparation du matériel de référence et démarche d'optimisation
Sur cette chaîne reference-to-video, l'impact de la qualité du matériel sur la vidéo finale est généralement supérieur à celui des réglages de paramètres. La raison : les paramètres ajustent la « tendance » du modèle, tandis que le matériel détermine sa « base ». Si la base n'est pas claire, la meilleure des tendances ne peut s'appliquer.
Qu'est-ce qu'un bon matériel de référence
- Sujet explicite : le spectateur doit pouvoir identifier en une demi-seconde « ce qui doit être conservé » dans l'image. Un arrière-plan encombré et un sujet de petite taille affaiblissent l'effet de référence.
- Caractéristiques stables : l'apparence du même sujet doit être cohérente entre les différentes images de référence. Si plusieurs images de référence se contredisent (couleur, forme, matière incohérentes), le modèle ne peut qu'osciller entre les versions.
- Éclairage et angle raisonnables : un éclairage extrême ou un angle fortement distordu transmet au modèle des indices visuels erronés.
- Propreté : retirez filigranes, autocollants et textes superflus. Ces éléments risquent d'être repris comme caractéristiques du sujet.
Priorités d'optimisation
Lorsque le résultat n'est pas satisfaisant, il est conseillé de vérifier dans cet ordre, plutôt que de commencer par régler les paramètres :
- Changer d'abord le matériel : remplacer l'image de référence par une version plus nette et à sujet plus unique est souvent le moyen d'amélioration le plus rapide.
- Modifier ensuite le prompt : préciser l'action et l'environnement, supprimer les descriptions redondantes avec l'image de référence.
- Ne toucher aux paramètres qu'en dernier : envisager un réglage fin uniquement après stabilisation des deux premières étapes, et ne modifier qu'une variable à la fois pour faciliter l'attribution.
Cohérence entre plusieurs images de référence
Si vous fournissez plusieurs matériels de référence, assurez-vous qu'il s'agit bien du « même sujet ». L'introduction d'individus différents ou d'images de styles différents est l'une des causes les plus fréquentes de dérive du résultat. Mieux vaut fournir une image de moins qu'une image contradictoire.
Établir une base de référence
Il est conseillé de constituer un ensemble fixe de matériels de référence pour votre sujet principal, qui servira de base à toutes les générations ultérieures. Chaque génération part de cette base en ne modifiant que le prompt : vous pouvez ainsi distinguer proprement « problème de matériel » et « problème de description », et unifier plus facilement le style entre plusieurs segments vidéo.
Échecs courants et pistes de dépannage
La plupart des problèmes de la phase d'intégration entrent dans quelques schémas fixes. Vérifier dans l'ordre ci-dessous est généralement plus rapide que de réessayer à l'aveugle.
1. Requête refusée ou erreur de paramètre
Vérifiez d'abord si l'identifiant de capacité est correct, si les champs obligatoires du matériel de référence sont présents, si le format du matériel est accepté par l'interface. Les noms de champs sont définis par la documentation ; ne les devinez pas par expérience.
2. Tâche sans résultat pendant longtemps
La génération vidéo est une tâche asynchrone : vérifiez d'abord que vous récupérez le résultat via l'identifiant de tâche, et non en attendant dans une requête synchrone. Si un délai d'attente se produit réellement, vérifiez si le volume du matériel est excessif.
3. Le résultat ne « ressemble pas » au matériel de référence
C'est le problème le plus fréquent. Ordre de vérification : le matériel est-il net → des images de référence contradictoires ont-elles été fournies → le prompt décrit-il des éléments en conflit avec l'image de référence. Dans la plupart des cas, le modèle n'est pas en cause : c'est le matériel qui n'est pas adéquat.
4. Dérive du sujet entre plusieurs segments
La cause est généralement l'utilisation de matériels de référence différents pour chaque segment, ou des descriptions du sujet incohérentes d'un prompt à l'autre. Fixer un ensemble de matériels de base et une description unifiée du sujet améliore nettement la situation.
5. Action à l'écran non conforme aux attentes
Le prompt manque d'instructions explicites sur l'action et la caméra ; le modèle ne peut que faire à sa guise. Écrivez clairement « quoi faire, comment bouger, où est la caméra ».
6. Coût supérieur aux attentes
Consultez les journaux d'appel : la durée est-elle trop longue, ou le taux de nouvelle tentative est-il élevé ? Pour le premier cas, ajustez la stratégie de durée côté produit ; pour le second, revenez au matériel et au prompt pour chercher la cause.
Principe fondamental du dépannage
Ne modifiez qu'une variable à la fois, et conservez les journaux. Si vous modifiez simultanément le matériel et le prompt, même si le résultat s'améliore, vous ne saurez pas lequel a agi, et la prochaine fois que le même problème se posera, il faudra recommencer depuis le début.
Liste de vérification avant intégration et étapes suivantes
Avant la montée en charge définitive, il est conseillé de valider point par point la liste ci-dessous, afin de contenir les risques en phase de faible trafic.
Liste de vérification avant mise en production
- Capacité adaptée : confirmez que votre scénario nécessite bien le reference-to-video, et non le texte-vers-vidéo ou l'image-vers-vidéo.
- Base de matériel prête : le sujet principal dispose d'un ensemble fixe et propre de matériels de référence.
- Prompt modélisé : les descriptions de l'action, de la caméra et de l'environnement suivent une structure réutilisable, plutôt qu'une improvisation à chaque fois.
- Chaîne asynchrone opérationnelle : soumission, interrogation ou callback, validation du résultat, nouvelle tentative en cas d'échec — les quatre étapes sont codées et testées en charge.
- Nouvelles tentatives limitées : un nombre maximal est défini pour les tentatives automatiques, au-delà desquelles la tâche passe en file manuelle.
- Tableau de bord des coûts : les journaux d'appel enregistrent la durée et le nombre de tentatives, permettant de calculer à tout moment la dépense réelle.
- Stratégie de durée explicite : le produit impose des contraintes sur les durées générables, pour éviter que l'utilisateur n'allonge arbitrairement et ne fasse exploser les coûts.
Du faible trafic à la montée en charge
Le parcours recommandé est le suivant : valider de bout en bout avec une requête construite manuellement pour vérifier l'efficacité du matériel et du prompt ; puis lancer un petit lot de tests avec la durée la plus courte, en mesurant le taux de nouvelle tentative et le taux de disponibilité ; une fois les indicateurs stabilisés, augmenter progressivement la concurrence et la durée. Chaque étape doit conserver une capacité de retour arrière.
Indicateurs clés
En phase de montée en charge, les indicateurs à surveiller réellement sont le taux de disponibilité au premier essai et le nombre moyen de tentatives. Le premier détermine l'expérience utilisateur, le second détermine directement le coût. Une fois ces deux indicateurs stabilisés, l'extension de la durée et de la concurrence devient envisageable.
Si vous n'avez pas encore commencé, consultez d'abord sur HiAPI.ai la page de détails du modèle et le prix en temps réel de vidu-q3-mix/reference-to-video, puis décidez de la durée de votre première vidéo générée.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage avec gpt-6.2-sol : limites de capacité, intégration API et tarification par token
Points de décision et de pratique pour l'intégration par les équipes d'ingénierie
-

Guide d'utilisation
Guide de prise en main de gpt-6.2-astra : limites de capacités du modèle texte, points d'intégration et maîtrise des coûts
-

Guide d'utilisation
Guide de prise en main de Tripo H3.1 : trois modes d'entrée, paramètres et choix tarifaires
Décision d'intégration et maîtrise des coûts de la génération 3D pour les développeurs