
Guida all'uso
Come utilizzare gpt-image-2-beta tramite l'API hiapi: parametri, codice ed esempi eseguibili
gpt-image-2-beta è la via minimale a prezzo fisso per accedere a GPT Image 2 su hiapi: due campi di input, un prezzo, nessuna regolazione di proporzioni o qualità. Questa guida mostra l'esempio minimo eseguibile, la struttura esatta dei parametri (confermata interrogando l'endpoint in produzione) e come si confronta con la via predefinita gpt-image-2/text-to-image, così puoi capire quando usare l'una o l'altra.
Prerequisiti
Devi ottenere una chiave API dalla pagina API Keys della dashboard di hiapi — la chiave inizia con sk-. Il prezzo attuale per singola immagine è indicato nella pagina del modello gpt-image-2-beta e nella pagina dei prezzi.
Come ogni modello di immagini su hiapi, questo modello gira sull'endpoint unificato per attività asincrone:
POST https://api.hiapi.ai/v1/tasks—— crea un'attività di generazioneGET https://api.hiapi.ai/v1/tasks/{taskId}—— interroga lo stato dell'attività
In cosa si differenzia la via beta
gpt-image-2/text-to-image (la via predefinita) accetta aspect_ratio + resolution e applica un prezzo per fascia di risoluzione ($0.03 per 1K, fino a $0.06 per 4K). gpt-image-2-beta comprime tutto questo in un prezzo fisso unificato di $0.02 per immagine e un campo opzionale size — una stringa di dimensioni in pixel letterali, come "1024x1024" o "1600x900", non una proporzione. Se ometti completamente size, il modello ricade sulle proprie dimensioni di output predefinite.
Il compromesso: rinunci al controllo granulare di proporzioni e risoluzione in cambio di un prezzo più basso e più semplice. È adatto quando vuoi solo "generare un'immagine a basso costo" senza preoccuparti della composizione precisa.
Esempio minimo eseguibile (curl)
# 1. Create the task
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2-beta",
    "input": {
      "prompt": "a paper airplane launching off a stack of documents, flat vector illustration",
      "size": "1024x1024"
    }
  }'
# => {"code":200,"data":{"taskId":"tk-hiapi-01..."},"message":"success"}

# 2. Poll until status == "success"
TASK_ID="tk-hiapi-01..."
curl -s "https://api.hiapi.ai/v1/tasks/$TASK_ID" \
  -H "Authorization: Bearer sk-YOUR_KEY"
# => {"code":200,"data":{"status":"success","output":[{"url":"https://..."}], ...}}
L'immagine completata si trova in data.output[0].url. Tale URL ha una validità breve indicata da expireAt — scaricala subito e riallocala sul tuo storage; non collegarla direttamente nei contenuti di produzione.
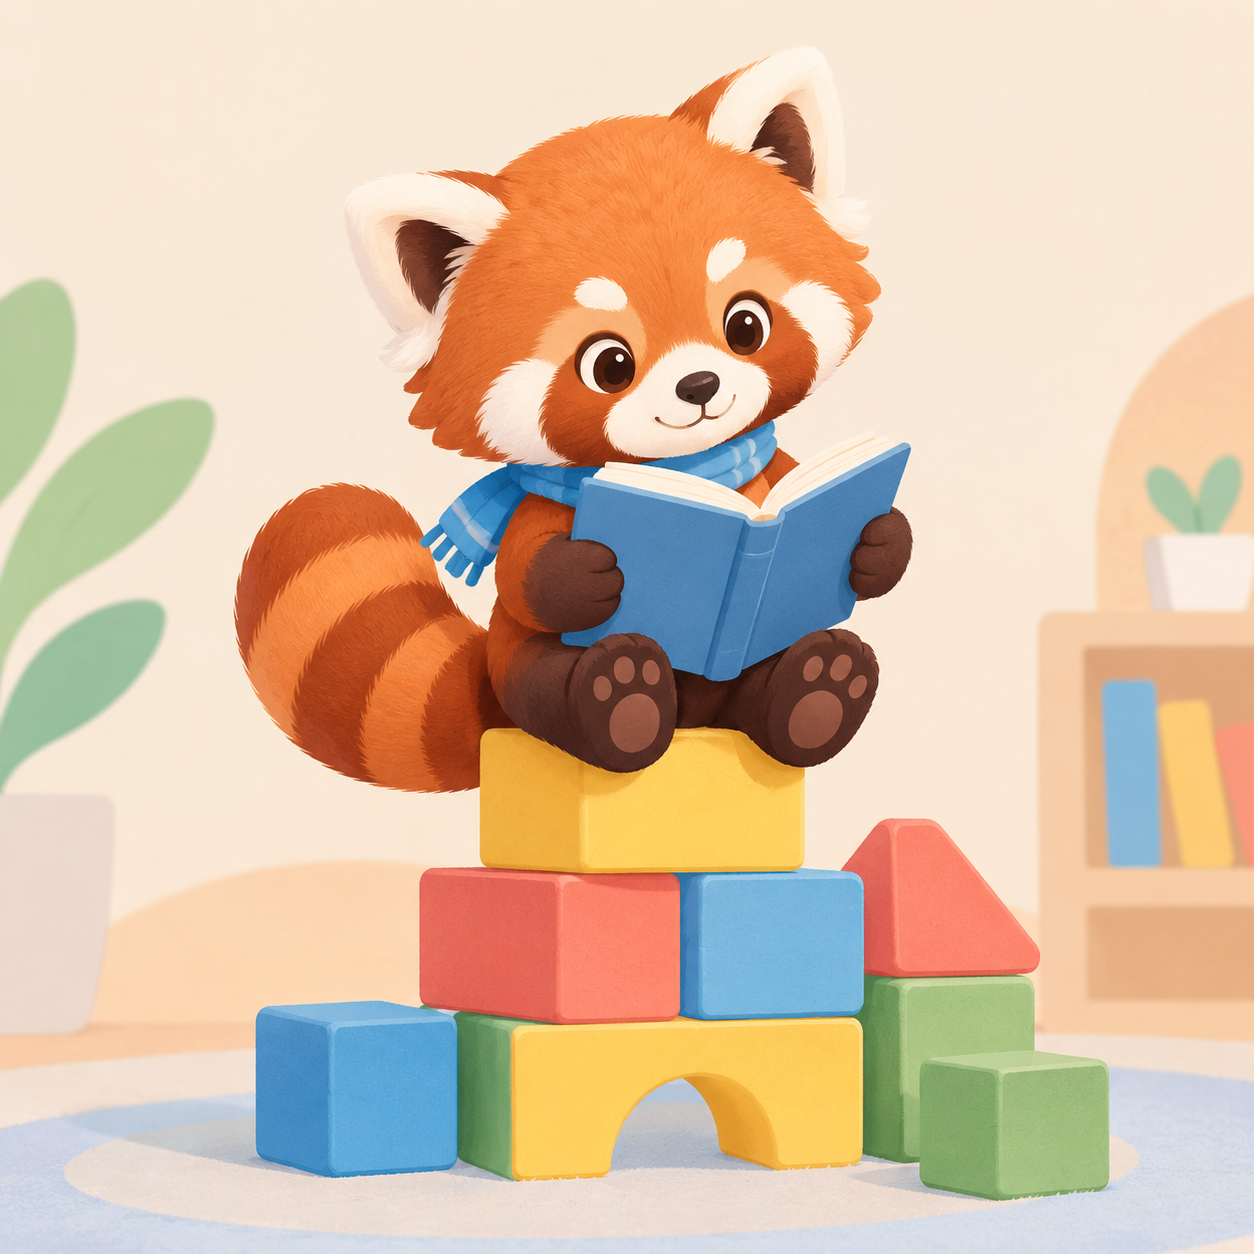
Immagine di esempio generata dalla chiamata curl sopra (con un prompt diverso), usando size: "1024x1024".
Python: creazione + polling + salvataggio su disco
import os
import time
import requests  # pip install requests

API_BASE = "https://api.hiapi.ai/v1/tasks"
TOKEN = os.environ["HIAPI_API_KEY"]  # sk-...

def create_task(prompt: str, size: str | None = None) -> str:
    input_fields = {"prompt": prompt}
    if size:
        input_fields["size"] = size  # e.g. "1024x1024", "1600x900"
    r = requests.post(
        API_BASE,
        json={"model": "gpt-image-2-beta", "input": input_fields},
        headers={"Authorization": f"Bearer {TOKEN}"},
        timeout=60,
    )
    r.raise_for_status()
    body = r.json()
    if body.get("code") != 200:
        raise RuntimeError(f"create failed: {body}")
    return body["data"]["taskId"]

def wait_task(task_id: str, timeout_s: int = 300, poll_s: int = 5) -> dict:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        r = requests.get(f"{API_BASE}/{task_id}",
                          headers={"Authorization": f"Bearer {TOKEN}"}, timeout=30)
        r.raise_for_status()
        task = r.json()["data"]
        if task["status"] == "success":
            return task
        if task["status"] == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
        time.sleep(poll_s)
    raise TimeoutError(f"task {task_id} did not finish in {timeout_s}s")

def save_image(url: str, path: str) -> None:
    resp = requests.get(url, timeout=60)
    resp.raise_for_status()
    with open(path, "wb") as f:
        f.write(resp.content)

if __name__ == "__main__":
    tid = create_task("a red panda mascot reading a book, flat pastel illustration", size="1024x1024")
    task = wait_task(tid)
    save_image(task["output"][0]["url"], "output.jpg")
    print("saved output.jpg")
Riferimento dei parametri
L'oggetto input di gpt-image-2-beta accetta solo due campi — la struttura è additionalProperties: false, quindi qualsiasi altro contenuto viene rifiutato direttamente, senza essere ignorato silenziosamente.
| Campo | Tipo | Obbligatorio | Descrizione |
|---|---|---|---|
prompt |
string | Sì | Descrizione testuale dell'immagine da generare. |
size |
string | No | Dimensioni in pixel letterali, ad esempio "1024x1024", "1600x900". Non è una parola chiave di proporzione. Se omesso, usa le dimensioni di output predefinite del modello. |
Contenuti non supportati (e gli errori che riceverai)
La struttura beta non accetta nessuno dei campi usati dalla via predefinita gpt-image-2/text-to-image o dall'OpenAI Images API — aspect_ratio, resolution, quality, background, moderation, output_format, output_compression, n, user o style. Inviarne uno qualsiasi restituisce immediatamente HTTP 400, ad esempio:
{
  "code": 400,
  "data": null,
  "error_code": "INVALID_REQUEST",
  "message": "invalid input: <root>: additional properties 'quality', 'aspect_ratio' not allowed"
}
Se stai migrando codice dalla via predefinita o dall'Images API di OpenAI, riducilo prima a prompt + size, poi punta a gpt-image-2-beta.
Prezzi: beta vs predefinita vs @ext
| Via | Prezzo | Controlli |
|---|---|---|
gpt-image-2-beta |
$0.02/immagine fisso | Solo size (dimensioni in pixel) |
gpt-image-2/text-to-image (predefinita) |
$0.03 (1K) / $0.04 (2K) / $0.06 (4K) | aspect_ratio + resolution |
gpt-image-2/text-to-image@ext |
$0.007–$0.76, in base a qualità × risoluzione | 16 proporzioni, livelli di qualità |
Prima di decidere la via in produzione, consulta la pagina dei prezzi — i prezzi di qualsiasi modello possono cambiare.
Consigli per costruire sulla via beta
- Considera l'elenco dei campi sopra come una convenzione attuale, non permanente. La struttura o i prezzi della via beta hanno più probabilità di essere modificati rispetto alla via predefinita — se la usi in produzione, ricontrolla periodicamente la pagina del modello.
- Poiché
sizeè opzionale, se il tuo layout dipende da dimensioni specifiche passalo sempre esplicitamente — non fare affidamento sul fatto che i valori predefiniti attuali rimangano invariati. - Gestisci
status: "fail"come faresti con qualsiasi altro modello di immagini hiapi: leggitask.error.code/task.error.messagee riprova con backoff, invece di presumere che ogni fallimento sia temporaneo.
Domande frequenti
gpt-image-2-beta e gpt-image-2/text-to-image sono lo stesso modello? Alla base c'è lo stesso modello GPT Image 2, ma le vie API sono diverse — la via beta scambia il controllo dei parametri con un prezzo fisso più basso.
Posso richiedere una proporzione specifica? Non direttamente. Scegli una stringa size con il rapporto larghezza:altezza desiderato (ad esempio "1600x900" per 16:9), invece di usare l'enumerazione aspect_ratio.
Cosa succede se non passo affatto size? L'attività riesce comunque — il modello usa le proprie dimensioni di output predefinite.
Letture correlate
Per la via completa con controllo esplicito di proporzioni e risoluzione, consulta Come utilizzare gpt-image-2/text-to-image tramite l'API hiapi. Pronto a provarlo? Ottieni una chiave dalla pagina API Keys ed esegui l'esempio curl sopra.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori