
Tutoriale
Tutorial API MiniMax H3 in cinese: text-to-video, primo/ultimo frame e riferimenti multimodali
Dal text-to-video ai primi/ultimi frame e ai riferimenti multimodali: comprendere i tre flussi di lavoro di MiniMax H3, i limiti dei materiali e le modalità di integrazione in produzione.
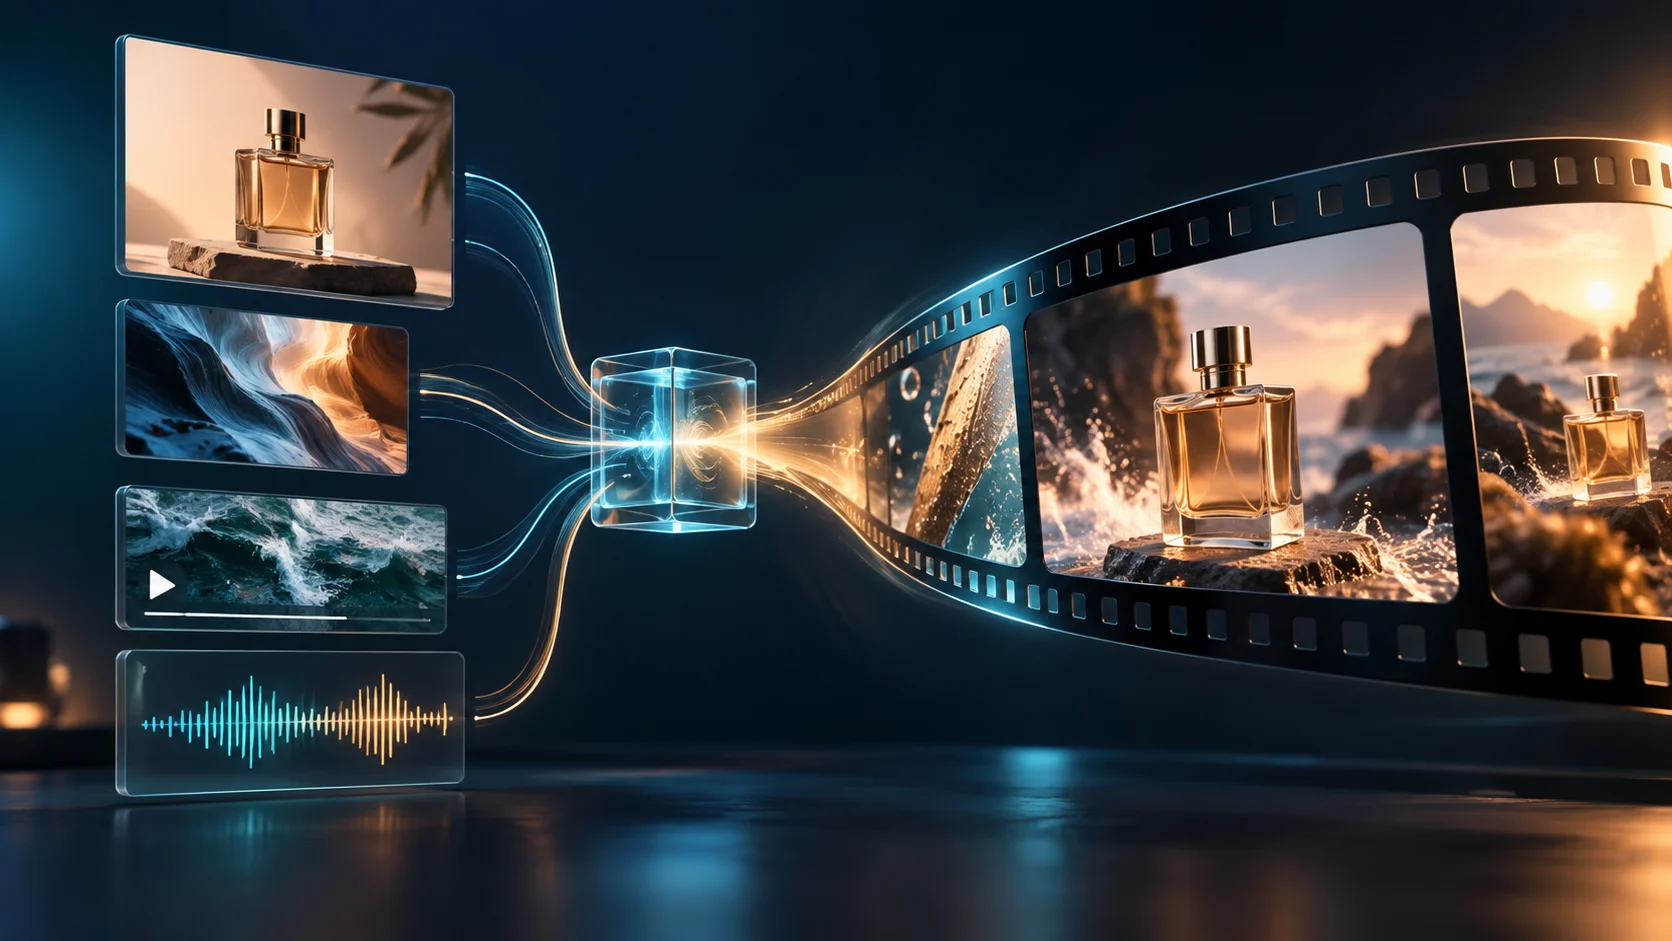
MiniMax H3 è il modello di generazione video multimodale general-purpose di MiniMax. È in grado di comprendere materiali testuali, immagini, video e audio e di generare brevi video con audio nativo. Quando lo si integra tramite HiAPI, l'ID del modello è fisso: minimax-h3; i modelli per immagini, video e audio utilizzano tutti la stessa interfaccia di task asincroni.
Se devi solo creare un breve video a partire da un prompt, puoi passare unicamente prompt. Se invece contano di più l'aspetto del prodotto, le immagini del brand o l'inizio e la fine dell'inquadratura, vale la pena usare le modalità primo/ultimo frame e riferimenti multimodali di H3. Il modello supporta attualmente output da 4 a 15 secondi, 2K nativo e formati come 21:9, 16:9, 4:3, 1:1, 3:4, 9:16. Le opzioni effettivamente disponibili sono quelle indicate nella pagina del modello MiniMax H3 e nella documentazione dei parametri API.
Quali problemi risolve MiniMax H3
È particolarmente adatto a task video brevi in cui è necessario controllare contemporaneamente la relazione tra immagine, movimento e suono. Ad esempio, realizzare un video dimostrativo con movimento di camera per una pagina prodotto, mantenere la stessa identità visiva per i materiali del brand, oppure portare in una nuova inquadratura il ritmo di un video di riferimento, il soggetto di un'immagine di riferimento e un audio di riferimento insieme.
Per team di e-commerce, pubblicità e prodotto, il valore di H3 non è solo "far muovere un'immagine". Quando ci sono materiali di riferimento, l'aspetto importante è descrivere chiaramente ciò che non deve cambiare, ad esempio la forma del prodotto, la posizione del logo, l'identità del soggetto, l'angolazione della camera e la luce; e descrivere separatamente ciò che deve cambiare, ad esempio azioni, sfondo, avanzamento della camera o dialoghi. In questo modo, in fase di verifica, si saprà quale parte è andata fuori strada.
Un modello, tre flussi di lavoro comuni
| Flusso di lavoro | Scenari adatti | Input chiave |
|---|---|---|
| Text-to-video | Generare nuove immagini da script, storyboard o un'idea | prompt |
| Controllo primo/ultimo frame | Controllare lo stato del prodotto o i cambiamenti di scena all'inizio e alla fine dell'inquadratura | first_frame_image, opzionale last_frame_image |
| Video con riferimenti multimodali | Fare riferimento contemporaneamente a prodotto, persona, ritmo dell'inquadratura o materiali audio | image_urls, video_urls, audio_urls |
Il controllo primo/ultimo frame e i riferimenti multimodali sono due modalità diverse e non possono essere combinati in una singola richiesta. Quando si usa il frame finale, è necessario fornire anche il frame iniziale. Con i riferimenti multimodali si possono inviare al massimo 5 immagini, 3 video e 3 audio; l'audio non può essere usato da solo come input, ma deve essere accompagnato almeno da un'immagine o un video di riferimento. Ogni video e audio di riferimento deve durare da 2 a 15 secondi, per un totale non superiore a 15 secondi.
Iniziare con un task minimo di text-to-video
Quello che segue è un esempio di inquadratura prodotto di 5 secondi in 16:9. La creazione riuscita del task indica solo che il server ha ricevuto la richiesta; il campo data.taskId nella risposta serve a interrogare lo stato successivo.
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-h3",
    "input": {
      "prompt": "Una tazza da caffè blu scuro opaca su un tavolo di pietra grigio chiaro. La camera avanza lentamente da un piano medio, la luce del mattino entra da sinistra, il corpo della tazza resta fermo, lo sfondo è sfocato, nessun testo.",
      "duration": 5,
      "resolution": "2K",
      "aspect_ratio": "16:9",
      "watermark": false
    }
  }'
Per il debug locale si può usare GET /v1/tasks/{taskId} per interrogare il risultato. In produzione è preferibile impostare callback.url a livello superiore della richiesta e fare in modo che il proprio servizio gestisca l'idempotenza in base a taskId. Dopo che il task è passato allo stato finale, valutare status: in caso di success scaricare output[].url; in caso di fail correggere l'input in base al messaggio di errore, senza ripetere ciecamente la stessa richiesta non valida.
Come usare i materiali di riferimento in modo sensato
I primi/ultimi frame sono adatti a task in cui "l'inquadratura va da A a B". Ad esempio, un video di lancio di un nuovo prodotto che inizia con una lampada da tavolo spenta e termina con la luce calda che illumina la scrivania. In questo caso il primo frame blocca il punto di partenza, il frame finale blocca il punto di arrivo, e il prompt deve solo spiegare le azioni, i movimenti di camera e i cambiamenti di luce che avvengono nel mezzo.
I riferimenti multimodali sono più adatti al controllo continuativo di brand o personaggi. L'immagine principale del prodotto può essere inserita in image_urls, il riferimento del ritmo dell'inquadratura in video_urls, il riferimento musicale o atmosferico in audio_urls. Il prompt deve indicare chiaramente il ruolo di ciascun tipo di materiale, ad esempio: "Mantieni l'aspetto della borsa e la posizione della chiusura metallica dell'immagine di riferimento, segui il ritmo di carrellata orizzontale del video di riferimento e genera un video dimostrativo silenzioso del prodotto".
Non accumulare tutti i materiali insieme. Ogni riferimento aggiunto aumenta i vincoli che il modello deve comprendere. Conviene prima verificare la conservazione dell'aspetto con una sola immagine del soggetto, poi aggiungere riferimenti di inquadratura o audio: è più facile individuare i problemi.
Quali informazioni inserire nel prompt
Un prompt video riutilizzabile di solito comprende quattro parti: soggetto, azione, inquadratura, suono o ambiente. Il soggetto deve chiarire le informazioni visive che non possono cambiare, l'azione deve descrivere l'evento che accade, l'inquadratura deve descrivere la posizione della camera e il movimento, e il suono deve indicare se ci sono dialoghi, suoni ambientali o atmosfera musicale.
Ad esempio, per una pubblicità di prodotto si può scrivere: "Mantieni invariati la custodia bianca delle cuffie, il guscio arancione e il marchio NOMA dell'immagine di riferimento. La camera avanza lentamente da un piano medio sul tavolo, la custodia si apre, le due cuffie restano al loro posto. Luce naturale dalla finestra, suono ambientale a basso volume, nessuna voce fuori campo, nessun testo aggiuntivo." Questo è molto più facile da verificare rispetto a scrivere solo "fai una bella pubblicità di cuffie".
Prima di inserire H3 nel flusso di lavoro produttivo
Si consiglia di effettuare prima una verifica su piccola scala con tre casi: un video puramente text-to-video, uno con controllo primo/ultimo frame e uno con riferimenti multimodali. Registrare separatamente i materiali di input, la durata dell'output, la transizione di stato, i messaggi di errore, gli URL dei prodotti e la fatturazione finale. Dopo aver confermato che tutte le modalità funzionano in modo stabile nel proprio prodotto, estendere alla generazione in batch.
Il prezzo è calcolato in base ai secondi di output e al livello corrente; la pagina non fissa un prezzo unitario. Prima dell'invio, consultare il prezzo attuale nella pagina del modello MiniMax H3 in tempo reale; dopo il lancio, fare riferimento ai record dei task e alla fatturazione dell'account. Per ulteriori informazioni su task asincroni, callback e risoluzione degli errori, continuare a leggere il tutorial di integrazione di MiniMax H3.
Domande frequenti
Quali input supporta MiniMax H3?
Può generare video solo da testo oppure essere controllato tramite primo frame, primo/ultimo frame o immagini, video e audio di riferimento. I campi del primo/ultimo frame e dei riferimenti multimodali non possono essere combinati.
MiniMax H3 può generare audio?
MiniMax H3 supporta la generazione di video con audio nativo e, in modalità riferimento multimodale, può utilizzare materiali audio. Il riferimento audio deve essere accompagnato da un'immagine o un video di riferimento.
Qual è la durata massima di un video?
La durata attuale dell'output è da 4 a 15 secondi. I video lunghi dovrebbero di solito essere generati in più inquadrature, per poi essere montati e uniti nel proprio flusso di lavoro.
Devo usare il polling o un callback?
Per il debug locale e i task a bassa frequenza si può usare il polling. In produzione è consigliabile usare callback.url per ricevere le notifiche di stato finale, mantenendo l'interrogazione dei dettagli del task come meccanismo di compensazione in caso di fallimento del callback.
Scopri MiniMax H3, leggi la documentazione dei parametri API oppure ottieni la API Key.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato