
Guida all'uso
Guida completa ai prompt di Runway Gen-4.5: 6 scene per generare video copiando e incollando
Riprese aeree, ballo verticale, sfondo per sito web, ritratti, inseguimento di veicoli e conversione di un'immagine orizzontale in verticale: per ogni scena ci sono il video reale e il prompt completo.
TL;DR
- 6 scene, ognuna con un video reale di Runway Gen-4.5 e il prompt completo: riprese aeree, ballo verticale, sfondo per sito web, ritratti, inseguimento di veicoli, conversione di un'immagine orizzontale in verticale.
- Ogni video costa $0.8575 (5 secondi), $1.372 (8 secondi) o $1.715 (10 secondi). Clicca «Genera con questo prompt» e la pagina del modello compilerà automaticamente il prompt; per le scene image-to-video devi prima caricare il tuo primo fotogramma.
- È già disponibile su HiAPI: apri la pagina del modello e provalo; i nuovi utenti ricevono 200 crediti alla registrazione.
Scena 1: riprese aeree e inquadrature vuote di destinazione
Aerial glide over a misty rice-terrace valley at sunrise, camera slowly rises to reveal distant mountains
Genera con questo prompt → (seleziona 10 secondi, 16:9)
runway-gen-4.5/text-to-video, 16:9, 1280×720, 10 secondi, $1.715.
La camera parte sopra le risaie a terrazze, avanza e sale, e infine le montagne lontane emergono dalla foschia. Il prompt specifica cosa deve rivelare la camera alla fine (distant mountains), così la chiusura ha un punto d'arrivo; scrivendo solo «ripresa aerea», la camera non sa dove fermarsi.
Scena 2: ballo verticale e riprese di strada
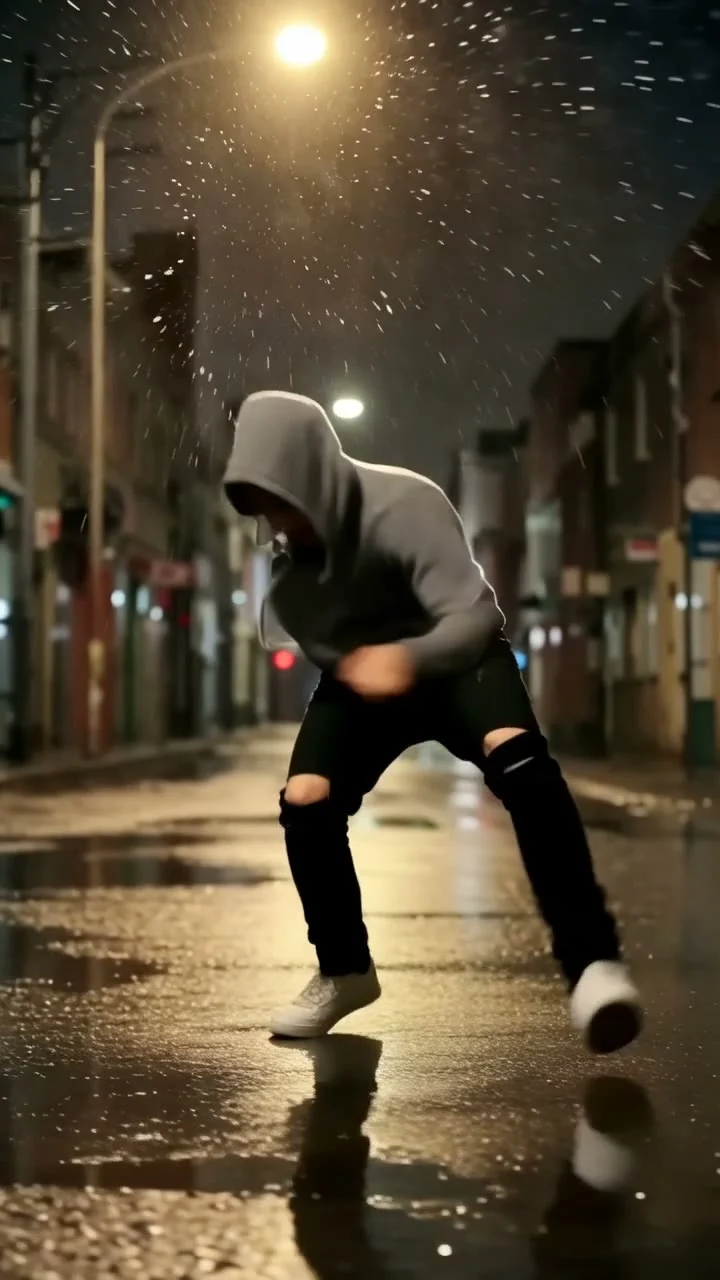
A street dancer spins under a single streetlight at night, light rain, camera slowly circles, cinematic
Genera con questo prompt → (seleziona 5 secondi, 9:16)
runway-gen-4.5/text-to-video, 9:16, 720×1280, 5 secondi, $0.8575.
La ballerina si alza da terra, gira su se stessa, il lampione illumina la pioggia sottile e il terreno bagnato riflette la scena; il formato 9:16 la mantiene interamente nel fotogramma, dalla testa ai piedi. Per le scene con movimenti rapidi, prova prima 5 secondi e, quando posa e inquadratura sono giuste, genera 10 secondi; per il text-to-video in verticale non esiste l'opzione da 8 secondi.
Scena 3: prima schermata del sito web e video di sfondo
The scene slowly comes alive: clouds drift, light shifts across the mountain lake, gentle forward camera move
Genera con questo prompt → (carica il primo fotogramma del paesaggio, seleziona 10 secondi, 16:9)
runway-gen-4.5/image-to-video, 16:9, 1280×720, 10 secondi, $1.715. Primo fotogramma: 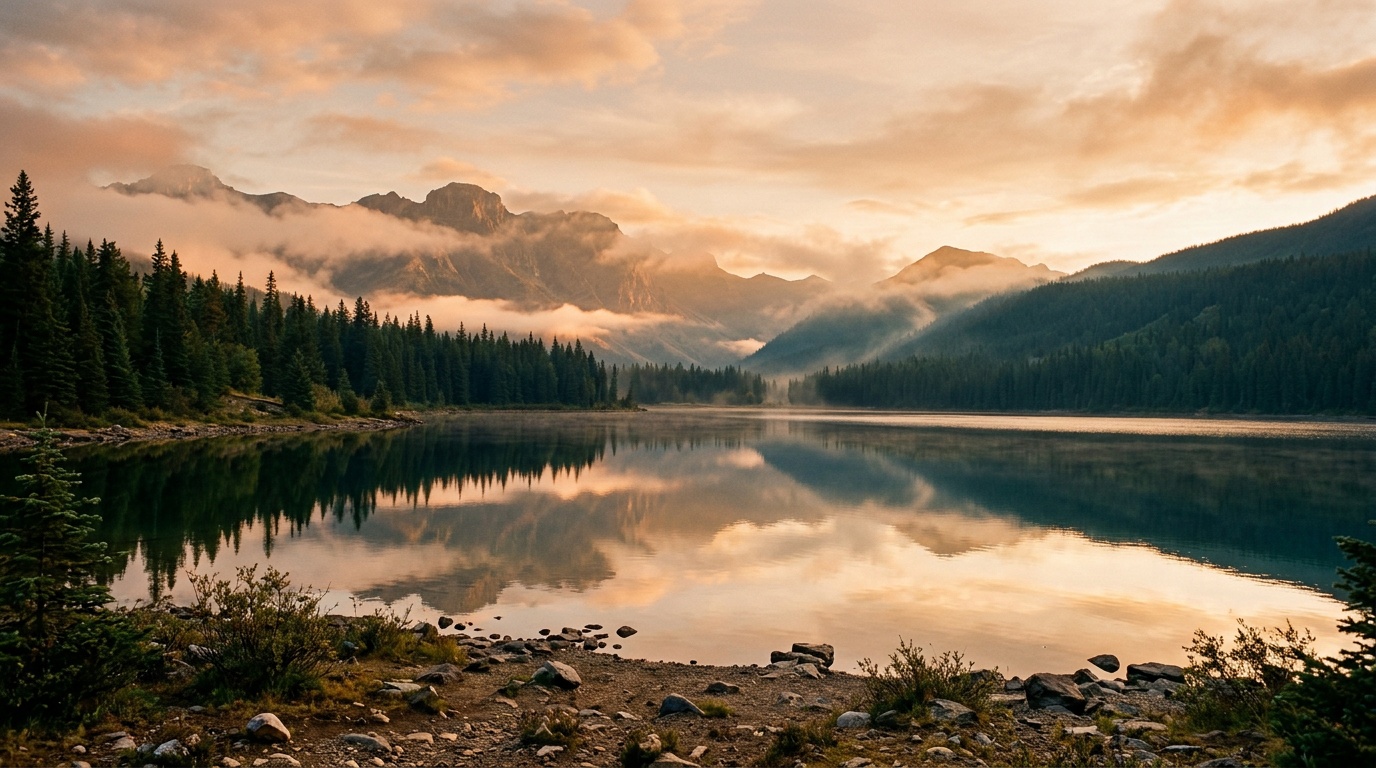 .
Il prompt descrive solo il cielo, la luce e la camera, senza ripetere la descrizione di montagne e lago: i toni e la composizione dell'immagine originale vengono preservati. Un'inquadratura lenta da 10 secondi è adatta per essere montata come sfondo in loop.
Scena 4: ritratti e abbigliamento
She turns her head toward the camera and smiles, hair moves in a light breeze, slow push-in
Genera con questo prompt → (carica il primo fotogramma del ritratto, seleziona 5 secondi, 3:4)
runway-gen-4.5/image-to-video, 3:4, 832×1104, 5 secondi, $0.8575. Primo fotogramma: 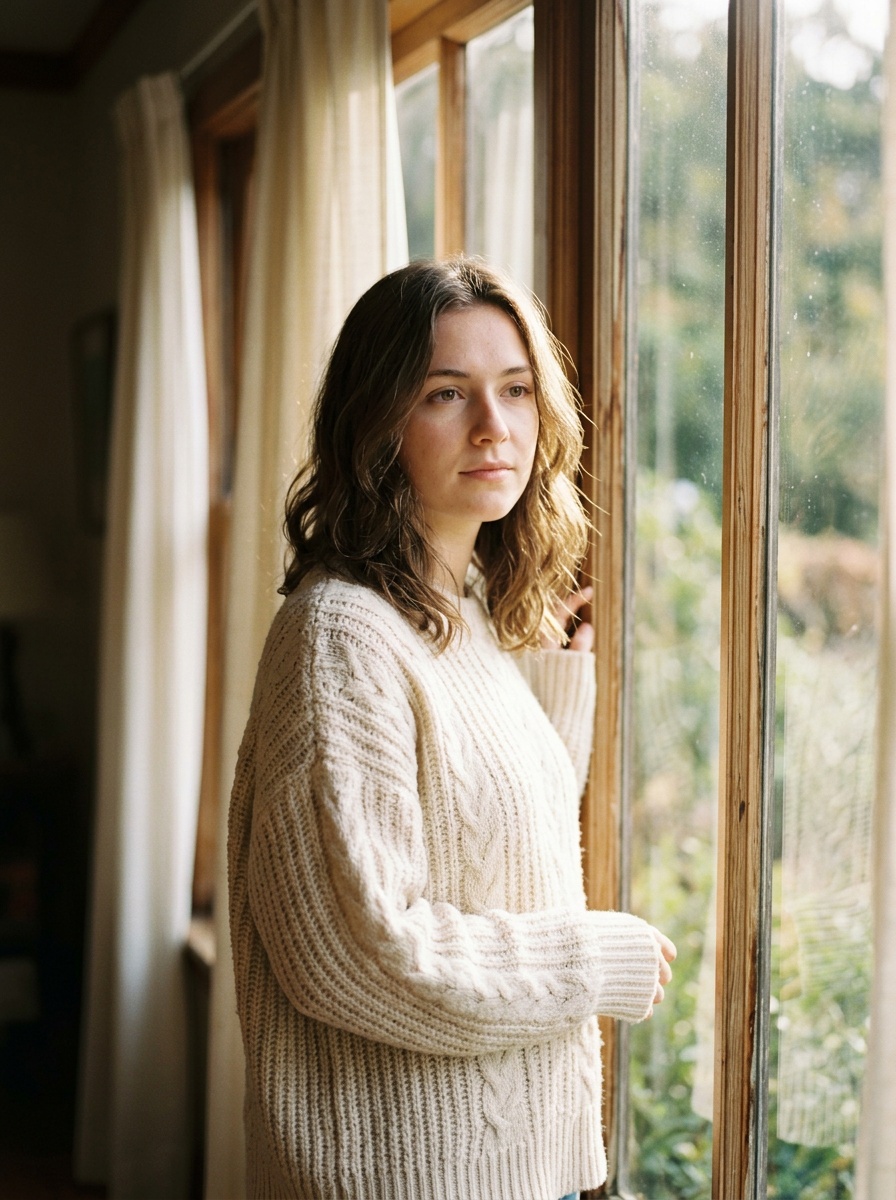 .
Alla persona vengono assegnati solo uno o due movimenti (girare la testa, sorridere) e alla camera un solo movimento (push-in). Alla fine dei 5 secondi la ripresa è già arrivata al primo piano del viso; se vuoi mantenere il busto, sostituisci «slow push-in» con «static camera».
Scena 5: inseguimento di veicoli
The steam locomotive thunders forward across the stone bridge, white steam streaming back from the chimney, wheels turning, the camera tracks smoothly alongside in warm golden hour light
Genera con questo prompt → (carica il primo fotogramma, seleziona 5 secondi, 16:9)
runway-gen-4.5/image-to-video, 16:9, 1280×720, 5 secondi, $0.8575. Primo fotogramma: 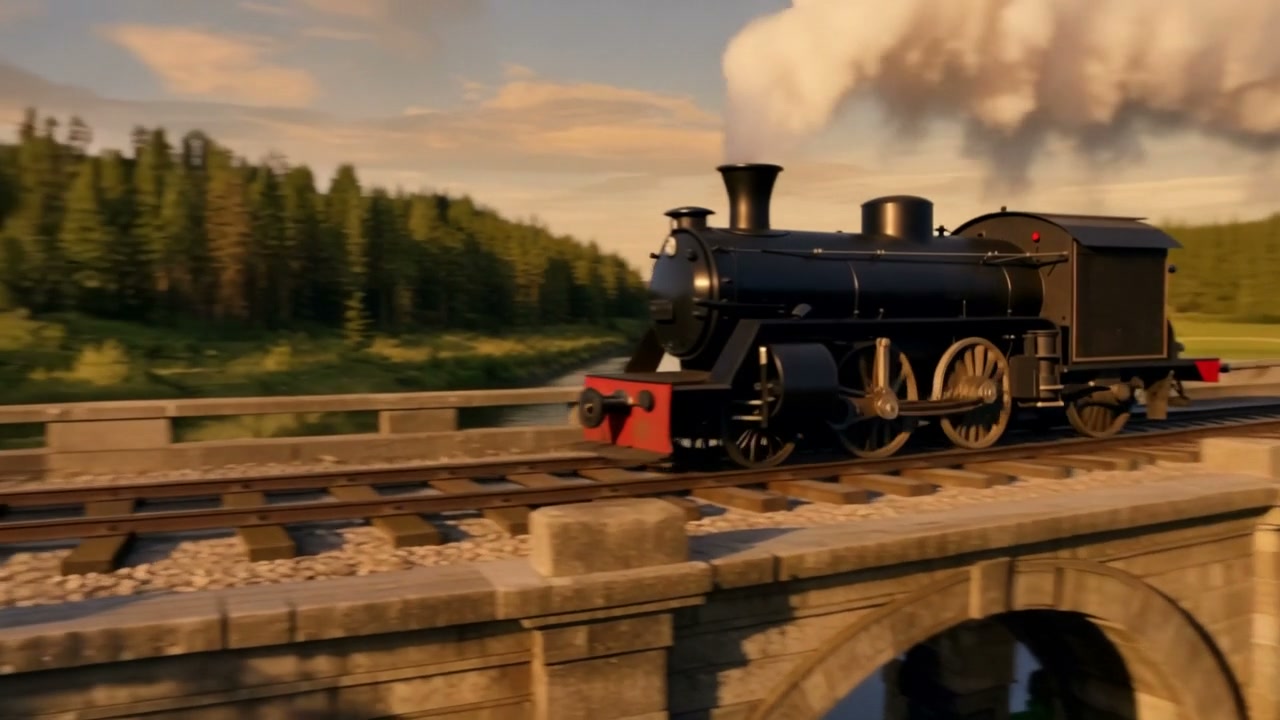 .
La locomotiva attraversa il ponte in pietra allontanandosi, mentre il vapore bianco esce dal camino e si disperde all'indietro. Ruote, vapore e camera sono descritti ciascuno in una frase, così il movimento ha una direzione.
Scena 6: da foto orizzontale a verticale, usando 8 secondi
the balloons drift upward as the camera slowly pans
Genera con questo prompt → (carica il primo fotogramma orizzontale, seleziona 8 secondi, 9:16)
runway-gen-4.5/image-to-video, 9:16, 720×1280, 8 secondi, $1.372. Primo fotogramma: 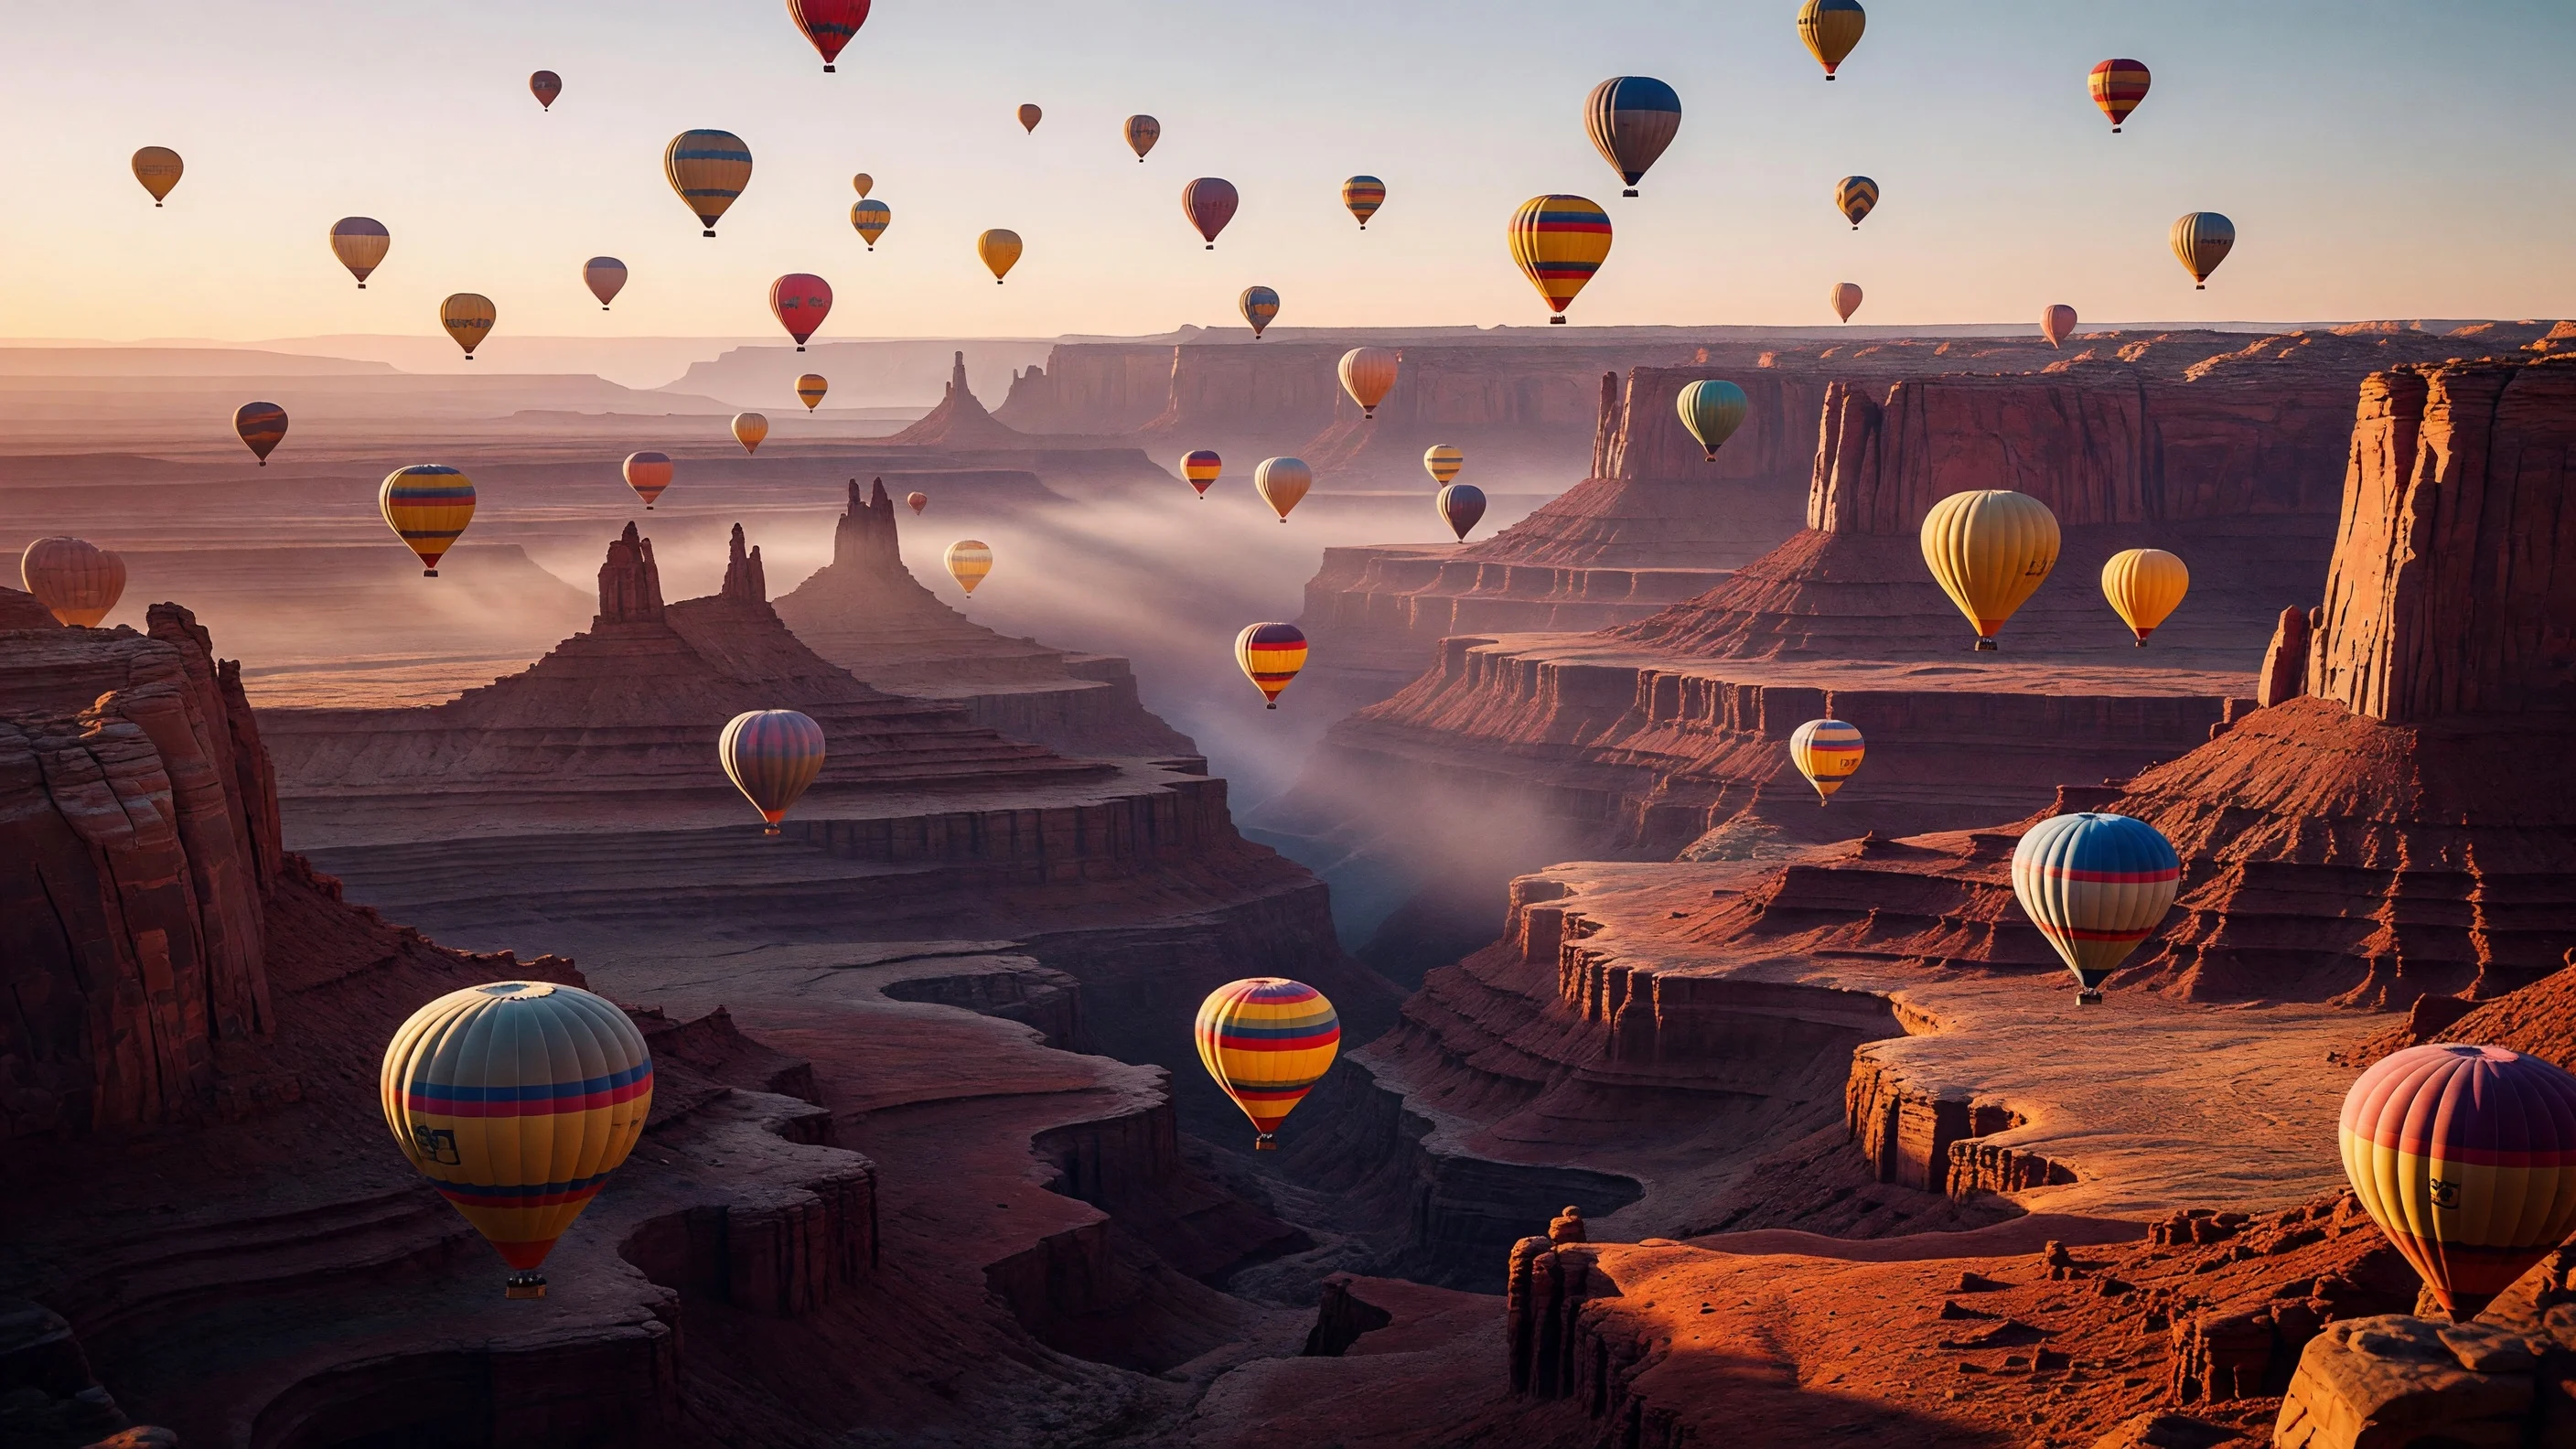 .
Anche un prompt molto breve è sufficiente: la scena è già nel primo fotogramma, quindi basta indicare che i palloncini salgono e che la camera panoramica lateralmente. Nell'image-to-video puoi scegliere 8 secondi per qualsiasi formato.
Come scrivere i prompt
- Text-to-video: una o due frasi per descrivere soggetto, scena, un'azione e un movimento di camera, poi aggiungi luce e meteo; massimo 1000 caratteri.
- Image-to-video: scrivi solo cosa si muove, in che direzione e come si muove la camera, senza ripetere la descrizione del primo fotogramma.
- Prima 5 secondi: con $0.8575 definisci azione e composizione; quando sei soddisfatto, genera 8 o 10 secondi.
Domande frequenti
Posso scrivere più azioni in un solo prompt?
Sì, ma se la persona si gira, corre e saluta allo stesso tempo le azioni tendono a confliggere. È più affidabile scrivere una sola azione principale per prompt.
Il video ha l'audio?
No, Runway Gen-4.5 produce solo immagini. Musica ed effetti sonori vanno aggiunti in montaggio.
Posso controllare la fine con un ultimo fotogramma?
No, l'image-to-video accetta solo un primo fotogramma. Per usare primo e ultimo fotogramma, usa Kling 2.5 Turbo; i parametri sono nella guida all'integrazione dell'API di Kling 2.5 Turbo.
Lo stesso prompt dà sempre lo stesso risultato?
No, e non c'è un seed per fissarlo. Salva il risultato che ti soddisfa di più.
Per i prezzi vedi Prezzi dell'API di Runway Gen-4.5, per il codice di integrazione vedi la guida all'integrazione dell'API di Runway Gen-4.5. Scegli la scena più vicina alle tue esigenze, copia il prompt e genera il tuo primo video dalla pagina del modello.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori