
Guida all'uso
Seedance 2.5 text-to-video: creare clip video brevi con l'API hiapi
Un prompt reale, una clip reale e il flusso di lavoro asincrono che lo trasforma in una pipeline ripetibile per video brevi.
I video brevi sono un gioco di quantità: TikTok, Reels e Shorts premiano la frequenza di pubblicazione, e girare a mano materiale B-roll per ogni post non è scalabile. L'endpoint text-to-video di Seedance 2.5 trasforma un singolo prompt in una clip verticale finita con audio sincronizzato in una sola chiamata API — niente telecamera, niente timeline di montaggio, niente voiceover separato.
Questa guida ripercorre dall'inizio alla fine una clip reale che abbiamo generato tramite l'API hiapi: il prompt esatto, il flusso di lavoro asincrono che l'ha prodotta, i prezzi verificati e un pattern pronto per la produzione in batch, da usare per realizzare una serie di video brevi anziché clip isolate. Per il riferimento completo dei parametri di tutti e tre gli endpoint seedance-2.5, consulta la guida completa all'API.
Perché i contenuti video brevi si prestano al text-to-video
Le piattaforme di video brevi non richiedono una durata da cinema — richiedono un flusso costante di clip da 6 a 15 secondi che si ripetano senza scatti e catturino lo spettatore entro un secondo. seedance-2.5/text-to-video è perfettamente adatto a questa esigenza:
- Fino a 30 secondi per clip, con sette formati di proporzioni, incluso il 9:16 per TikTok/Reels/Shorts.
- Sincronizzazione audio nativa — il modello genera suoni ambientali e segnali audio in base alle azioni nel prompt, invece di produrre una clip muta da doppiare in seguito.
- Prompt supportati in 11 lingue, utile se stai localizzando campagne di video brevi.
- Due livelli di risoluzione (480p e 720p), così puoi generare bozze a basso costo e pagare la tariffa 720p solo per le clip che pubblichi davvero.
Una clip reale, dall'inizio alla fine
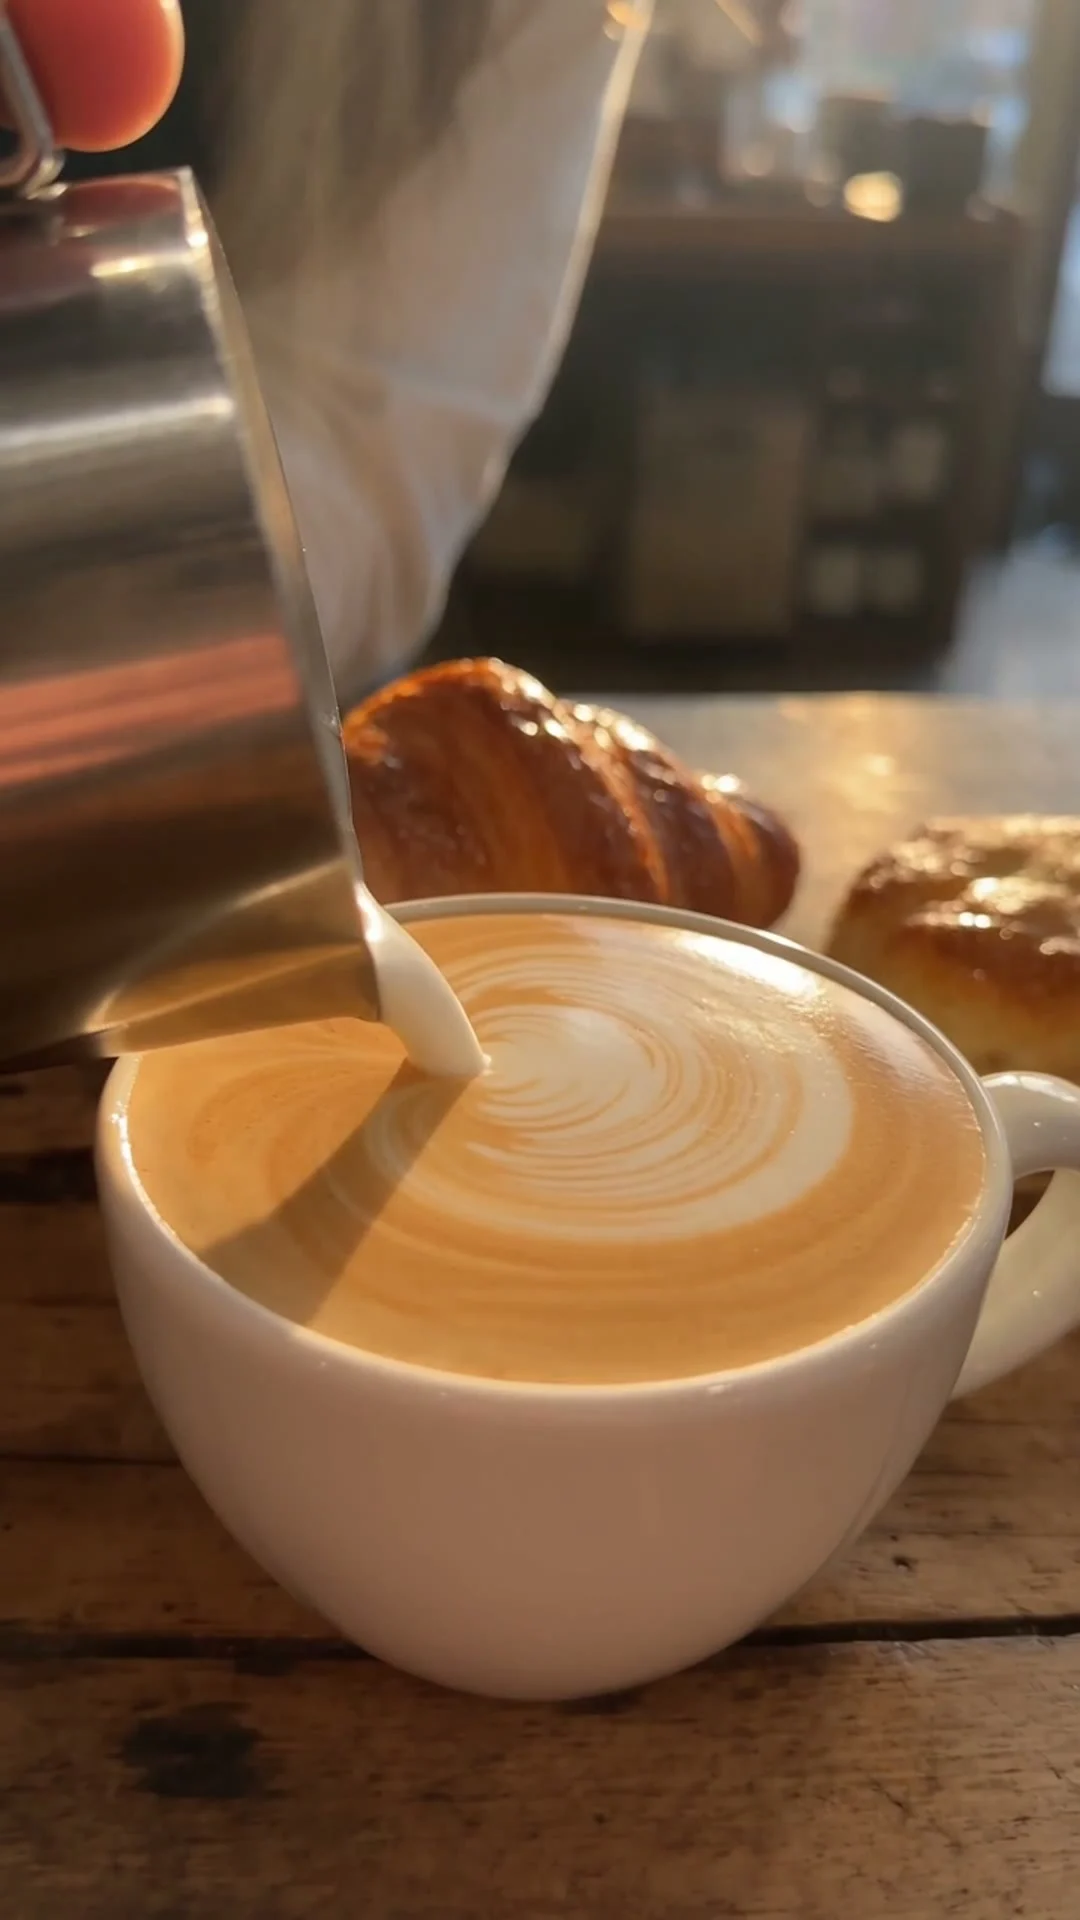
Questa è una clip che abbiamo generato per questa guida: un primo piano di latte versato in un caffè con latte art, inquadrato in verticale, per un video breve di una caffetteria.
Il prompt esatto che abbiamo inviato, senza modifiche:
La mano ferma del barista versa il latte montato da una lattiera in acciaio inox in una tazza da espresso in ceramica bianca, il flusso di latte si piega in un vortice di latte art a rosetta che prende forma in tempo reale, una calda luce dell'ora d'oro attraversa di sbieco il bancone, croissant e pasticcini sfocati sullo sfondo, inquadratura in primo piano verticale, vapore delicato, suoni ambientali di caffetteria.
Parametri: aspect_ratio: "9:16", resolution: "720p", duration: 8. L'output qui sopra è il risultato reale e non modificato del task — 8,06 secondi, con il suono del latte versato e il brusio ambientale della caffetteria generati direttamente dal modello, non aggiunti in post-produzione.
Il flusso di lavoro API
seedance-2.5/text-to-video funziona tramite l'API asincrona dei task di hiapi — invio, polling, download. Non esiste un endpoint video sincrono; ogni clip è un task in background.
import time
import requests

API_KEY = "YOUR_HIAPI_KEY"
BASE = "https://api.hiapi.ai/v1"

def generate_clip(prompt: str, aspect_ratio: str = "9:16",
                   resolution: str = "720p", duration: int = 8) -> str:
    submit = requests.post(
        f"{BASE}/tasks",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={
            "model": "seedance-2.5/text-to-video",
            "input": {
                "prompt": prompt,
                "aspect_ratio": aspect_ratio,
                "resolution": resolution,
                "duration": duration,
            },
        },
        timeout=30,
    )
    task_id = submit.json()["data"]["taskId"]

    while True:
        poll = requests.get(
            f"{BASE}/tasks/{task_id}",
            headers={"Authorization": f"Bearer {API_KEY}"},
            timeout=30,
        ).json()["data"]
        if poll["status"] == "success":
            return poll["output"][0]["url"]   # link temporaneo — scarica subito
        if poll["status"] == "fail":
            raise RuntimeError(poll)
        time.sleep(5)

clip_url = generate_clip(
    "La mano ferma del barista versa il latte montato da una lattiera "
    "in acciaio inox in una tazza da espresso in ceramica bianca, "
    "il flusso di latte si piega in un vortice di latte art a rosetta "
    "che prende forma in tempo reale, una calda luce dell'ora d'oro "
    "attraversa di sbieco il bancone, croissant e pasticcini sfocati "
    "sullo sfondo, inquadratura in primo piano verticale, "
    "vapore delicato, suoni ambientali di caffetteria."
)

# L'URL di output scade (ha un timestamp expireAt) — scaricalo subito e
# salvalo nel tuo storage, non conservarlo come hotlink
video_bytes = requests.get(clip_url, timeout=60).content
open("clip.mp4", "wb").write(video_bytes)
La risposta del task non restituisce mai il tuo prompt originale — restituisce solo model, status, output e i timestamp — quindi se in seguito devi riprodurre o variare una clip, registra da parte ciò che hai inviato.
Prezzi: due livelli, nessun 1080p
Verificato in tempo reale sull'endpoint dei prezzi di hiapi — seedance-2.5/text-to-video viene addebitato per secondi di output, con due livelli di risoluzione e nessuna opzione 1080p:
| Risoluzione | Prezzo al secondo | Clip da 8 secondi |
|---|---|---|
| 480p | $0,1395 | circa $1,12 |
| 720p | $0,3019 | circa $2,42 |
Il prezzo al secondo del 720p è circa 2,2 volte quello del 480p — vale la pena generare prima le bozze in 480p e pagare il 720p solo dopo aver perfezionato il prompt. I dettagli completi su parametri e prezzi sono nella pagina del modello seedance-2.5/text-to-video; le tariffe sono valide al 2026-08 e possono cambiare, quindi controlla quella pagina prima di fare budget per grandi volumi.
Produrre una serie di video brevi, non solo uno
Una singola clip è una demo; un calendario editoriale richiede produzione in batch. Tratta ogni clip come un task idempotente con chiave basata sul prompt, così una nuova esecuzione dopo un crash non comporta un doppio addebito:
import hashlib

PROMPTS = [
    "Il barista versa il latte montato in una tazza da espresso, la rosetta di latte art prende forma, luce dell'ora d'oro, inquadratura in primo piano verticale.",
    "Vapore che sale mentre un caffè filtrato appena preparato gocciola attraverso il filtro di carta, luce del mattino dalla finestra della caffetteria, inquadratura verticale.",
    "Una mano appoggia delicatamente un sacchetto di chicchi di caffè su una bilancia in legno, i chicchi si assestano, atmosfera morbida della caffetteria, inquadratura in primo piano verticale.",
]

def job_key(prompt: str) -> str:
    return hashlib.sha1(prompt.encode()).hexdigest()[:12]

results = {}
for prompt in PROMPTS:
    key = job_key(prompt)
    if key in results:          # già generato in questo ciclo
        continue
    results[key] = generate_clip(prompt, resolution="480p", duration=6)
    # salva subito ogni risultato — vedi il passaggio di download sopra
Genera l'intero set in 480p, valuta quali clip funzionano davvero per la campagna, poi rigenera solo quelle vincenti in 720p. Questa abitudine in due passaggi è la leva più importante sui costi quando devi produrre in batch anziché fare una tantum.
Confronto con Seedance 2.0
Se hai usato Seedance 2.0, il livello text-to-video di 2.5 mantiene la stessa forma di task invio-polling-download — nessun cambiamento lato integrazione. Le differenze pratiche da conoscere prima di migrare una pipeline: 2.5 aggiunge per impostazione predefinita la sincronizzazione audio nativa a ogni clip, e la sua scala di risoluzioni è più semplice (solo 480p/720p, mentre 2.0 ha livelli aggiuntivi). Se il tuo flusso di lavoro dipende da una risoluzione che 2.5 non offre, prima di dare per scontata l'equivalenza consulta la pagina del modello per le specifiche aggiornate.
Domande frequenti
seedance-2.5/text-to-video supporta il 1080p? No — al 2026-08 il modello offre solo 480p e 720p. Se hai bisogno di output in 1080p, cerca un modello che lo supporti nel catalogo dei modelli prima di costruire una pipeline attorno a questo endpoint.
L'audio è reale o va aggiunto separatamente? Viene generato dal modello come parte del task — il suono del latte versato e il brusio ambientale della caffetteria nella clip dimostrativa qui sopra non sono stati aggiunti in post-produzione. Se ti serve musica o voiceover specifici del brand, puoi comunque sovrapporre il tuo audio in seguito.
Quanto tempo serve per generare una clip? Il tempo di completamento del task varia con durata e risoluzione; in genere da uno a qualche minuto per clip, e fai sempre polling invece di presumere un tempo di attesa fisso.
Posso riutilizzare lo stesso prompt con proporzioni diverse su piattaforme diverse?
Sì — aspect_ratio è un parametro separato dal prompt, quindi lo stesso prompt può essere reinviato in 9:16 per TikTok/Reels e in 16:9 per YouTube senza riscrivere la descrizione della scena.
Cosa succede se l'URL di output scade prima che lo scarichi?
Devi reinviare il task — output[0].url è un link temporaneo legato a un timestamp expireAt, non uno storage permanente. Scarica e salva ogni clip immediatamente dopo che il task riporta success.
Punti chiave
seedance-2.5/text-to-videoè l'endpoint prompt-in, clip-out per i contenuti video brevi — 480p per bozze e contenuti social di riempimento, 720p quando la clip è l'asset finale.- Fai il budget in base alla durata, non al numero di clip: il costo al secondo del 720p è circa 2,2 volte quello del 480p, quindi una clip da 8 secondi in 720p costa già circa $2,42.
- Gli URL di output dei task scadono — dopo un polling riuscito, scarica e salva subito in uno storage permanente.
- La sincronizzazione audio nativa significa che per i contenuti video brevi di riempimento di solito non servono voiceover o effetti sonori separati.
- Il modello attualmente non ha un livello 1080p — prima di costruire una pipeline che lo presuppone, consulta la pagina del modello.
Pronto a provarlo? Vai alla pagina del modello seedance-2.5/text-to-video per il riferimento completo dei parametri, oppure esplora il catalogo completo dei modelli video di hiapi per confrontarlo con opzioni image-to-video come Kling 3.0 Turbo e preparare il tuo prossimo lotto di video brevi.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori